论文精读笔记:GS-Pose
1. 核心判断
GS-Pose 解决了 synthetic-only category pose 的一个结构性矛盾:
- 只用 depth geometry,synthetic-to-real gap 小,但近似几何部件容易混淆;
- 直接用 synthetic RGB,keyboard、screen 等语义有用,但 texture / lighting domain gap 大。
它的折中是不用 raw RGB matching,而用同一个预训练 DINOv2 把 synthetic / real RGB 映射到较稳定的 semantics,再把 semantics 绑定到 3D points,与真实 depth geometry 一起做 correspondence。方法最强的证据不是绝对 SOTA,而是每类仅 10 个 CAD 时明显优于同数据量的 geometry-only CPPF++。
2. “无真实标注”与“自监督”的准确边界
训练不使用:
- REAL275 / Wild6D / SUN RGB-D 的 pose labels;
- real RGB-D fine-tuning;
- real object scans。
训练使用:
- ShapeNet category labels 与 10 CADs / category;
- 已知 camera pose 的 40 RGB-D renderings / CAD;
- renderer 产生的 depth、visibility 与 exact 3D correspondences;
- 预训练 DINOv2;
- symmetry category convention。
因此它是 synthetic geometry-supervised correspondence learning,其“self-supervision”来自同一 CAD 的 full / rendered-partial pairs 自动生成 label。不能将其理解为从无标注真实视频自监督适配。
测试还需要外部 Mask R-CNN mask、category identity、intrinsics 与一个选定 synthetic reference CAD。它对未见实例泛化,不对未见类别泛化。
3. 从 2D DINO 到 3D semantic point cloud
对 CAD 点 pi,在 C=40 个 camera views 中计算 visibility Vi,j,投影到 DINO feature map:
p~ij=KTj−1pi,Fpi=∑jVi,j∑jVi,jFj2D(p~ij).
多视角平均有三个作用:
- 让每个表面点获得与其可见外观关联的 semantics;
- 平滑 view-dependent DINO variation;
- 将 image backbone 的 global context 变成可参与 3D registration 的 point descriptors。
但它也会稀释 view-dependent semantic differences;CAD texture / rendering 若与真实实例差异很大,DINO 的跨域稳定性仍是经验假设。论文没有对不同 renderer texture、无 texture CAD 或不同 DINO layers 做完整校准。
Geometric feature 并非手工 PPF / FPFH,而是 normalized point coordinates 经 positional encoding。由于 full prior 与 partial observation 来自不同实例,网络必须学习 category deformation 下的“近似语义对应”,不是严格 surface identity。
4. Matching network 与显式几何求解
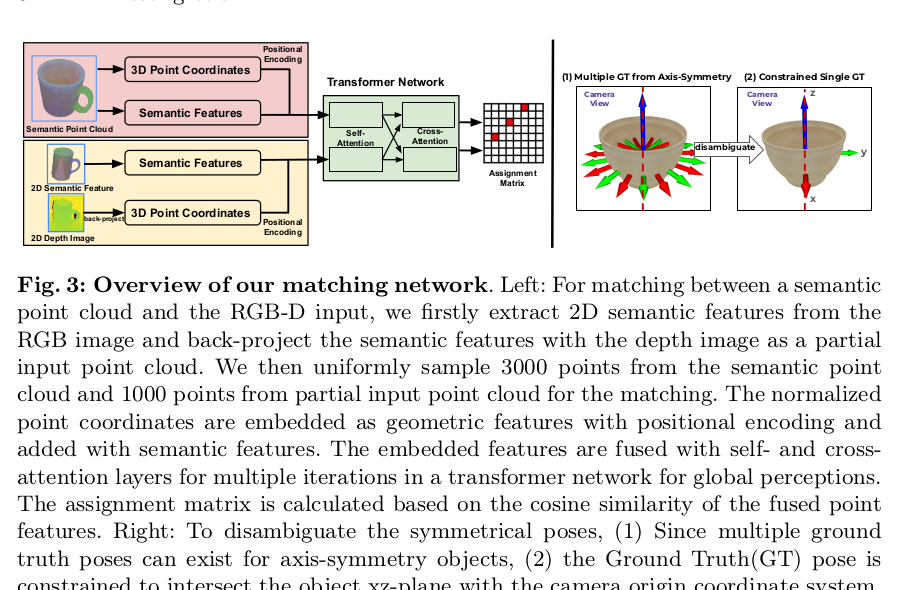 原论文 Figure 3。完整 prior 与 partial observation 在 3D 中匹配;semantic feature 提供部件身份,point coordinates 提供局部与全局 geometry,inlier head 抑制不可见或跨实例不存在的区域。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
完整 prior Ps 采 3,000 点,observation Qs 采 1,000 点。Transformer 交替 self / cross attention,输出 feature FP,FQ 和每点 inlier probabilities σP,σQ。
assignment score 可概括为:
A^ij=σiPσjQcos(FiP,FjQ).
训练由两端 inlier BCE 与 assignment focal loss 组成。inlier head 特别重要:完整 CAD 中大量背面 / 不可见区域,跨实例又可能没有等价几何;若所有点都强制匹配,assignment 容易被这些 outliers 占据。
推理不直接回归 pose,而是:
- 对 assignment threshold;
- 取高置信 3D prior ↔ 3D observed correspondences;
- RANSAC 剔除跨实例错误匹配;
- Umeyama 求 similarity transform;
- reference CAD box 经 scale 得到 metric 3D size。
显式 correspondence + robust solver 让 failure 可检查,也把网络从绝对 metric pose regression 中解耦。
5. 对称处理
轴对称对象有无限多个几何等价 yaw。作者把 GT pose 的 object xz-plane 约束为穿过 camera origin,从等价集合中选一个与视点相关的 canonical representative;mug handle 不可见时也视作轴对称。
优点是 correspondence label 单值,不会让相同 observation 对应冲突 targets。局限是:
- canonical representative 随 camera viewpoint 变化;
- mug handle visibility 判断依赖 mask / depth;
- 只覆盖预定义 axis symmetry;
- texture 打破几何 symmetry 时,该 canonicalization 不保证 appearance-consistent pose;
- 与 BOP 的 minimum-over-symmetry evaluation convention 不完全相同。
6. REAL275:数据效率强,不是全面超过强监督
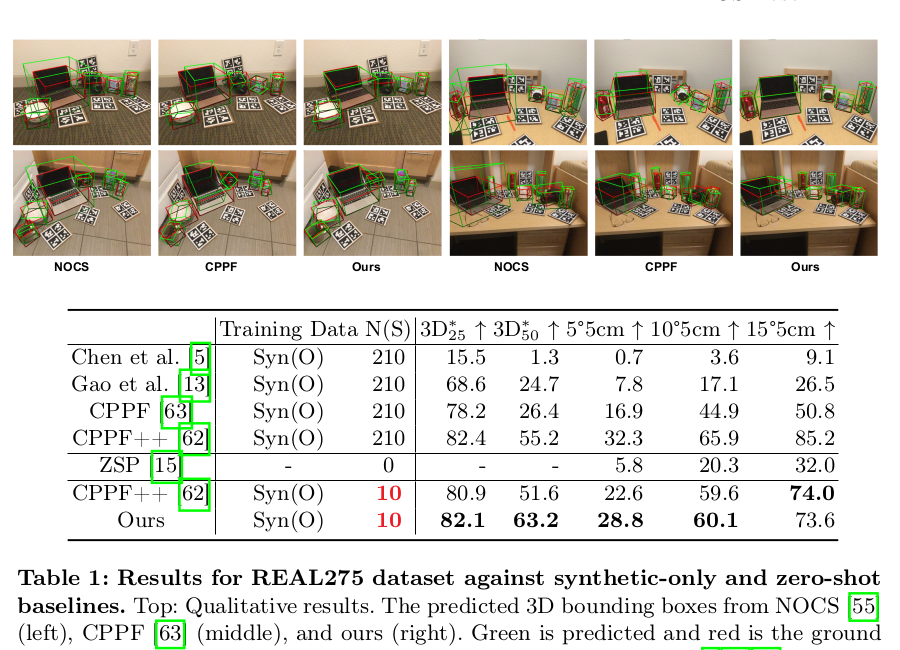 原论文 Table 1。3D* 表示 CPPF convex-hull intersection 实现;不要与 Table 2 的 3D+ 指标直接视为同一数值体系。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
Synthetic-only:
| 方法 | CAD / 类 | 3D*25 | 3D*50 | 5°5cm | 10°5cm | 15°5cm |
|---|
| CPPF | 210 | 78.2 | 26.4 | 16.9 | 44.9 | 50.8 |
| CPPF++ | 210 | 82.4 | 55.2 | 32.3 | 65.9 | 85.2 |
| CPPF++ | 10 | 80.9 | 51.6 | 22.6 | 59.6 | 74.0 |
| GS-Pose | 10 | 82.1 | 63.2 | 28.8 | 60.1 | 73.6 |
相同 10-CAD budget 下,GS-Pose 的 3D50 +11.6、5°5cm +6.2;这是公平且有意义的主结论。与 210-CAD CPPF++ 比,GS-Pose 3D50 更高,但三个 joint pose metrics 均更低或接近,不能概括成“全面超过 CPPF++”。
与 real-supervised methods 的 Table 2 使用 3D+ implementation:
- GS-Pose:3D+75 37.0、5°5cm 28.8、10°5cm 60.1;
- DualPoseNet:30.8、35.9、66.8;
- VI-Net:48.3、57.6、82.1。
GS-Pose 在 3D+75 超过 DualPoseNet,但严格 pose 明显落后 VI-Net。其卖点是 annotation efficiency 和 domain transfer,不是 real-supervised accuracy 上限。
7. Wild6D 与 SUN RGB-D
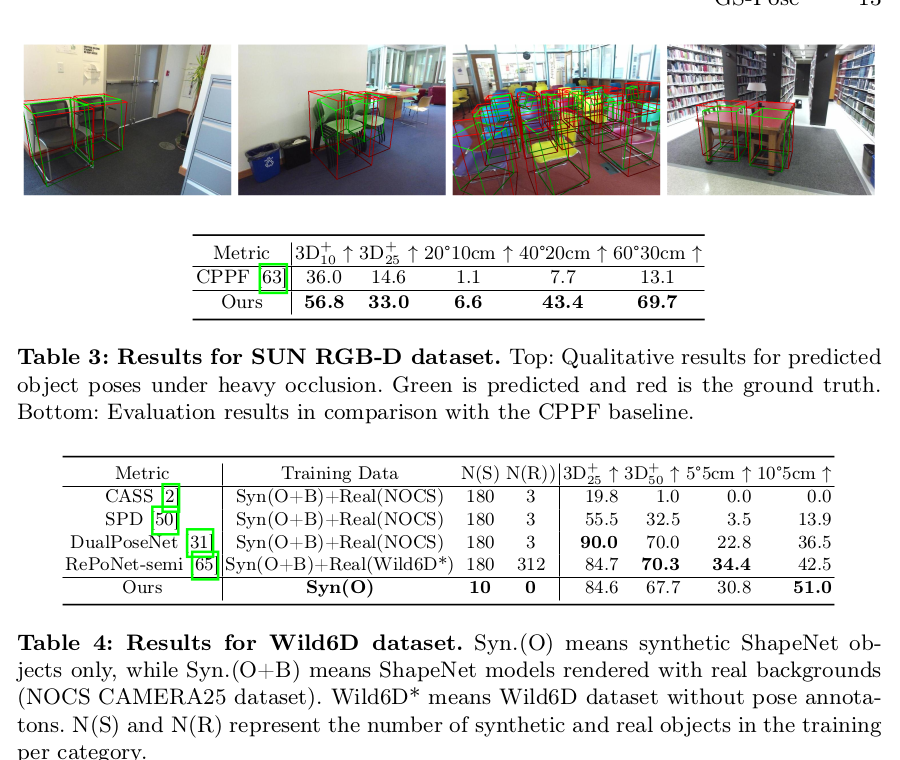 原论文 Table 3–4。SUN RGB-D 只评 chair 且使用较松 20°10cm–60°30cm;Wild6D 则覆盖 162 个测试对象。两表任务与指标不同,不能合成单一平均分。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
Wild6D:
| 方法 | real objects / 类 | 3D+25 | 3D+50 | 5°5cm | 10°5cm |
|---|
| DualPoseNet | 3 | 90.0 | 70.0 | 22.8 | 36.5 |
| RePoNet-semi | 312 | 84.7 | 70.3 | 34.4 | 42.5 |
| GS-Pose | 0 | 84.6 | 67.7 | 30.8 | 51.0 |
GS-Pose 仅在 10°5cm 最优;3D 和 5°5cm 略低。仍然说明不见真实训练数据时有较强 transfer。
SUN RGB-D 只训练 ShapeNet chairs,GS-Pose 相对 CPPF:
- 3D+10:56.8 vs 36.0;
- 3D+25:33.0 vs 14.6;
- 40°20cm:43.4 vs 7.7;
- 60°30cm:69.7 vs 13.1。
它验证遮挡室内 chair 的泛化,但 baseline 只有 CPPF、threshold 较宽,不足以说明普适室内 SOTA。
8. Ablation:inlier 与 symmetry 比 CAD 数量更重要
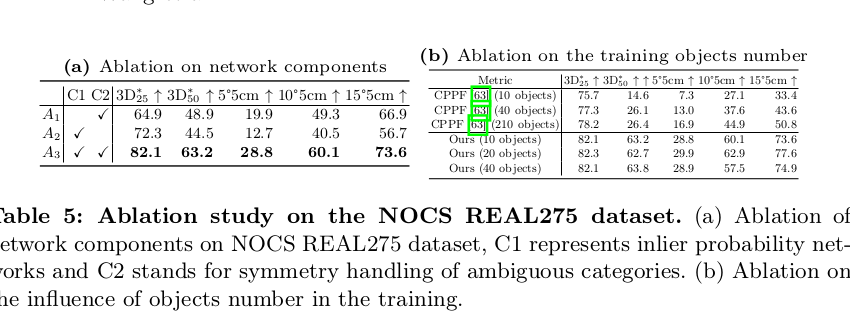 原论文 Table 5:inlier head 和 symmetry canonicalization 对严格 pose 都有大幅影响;10→20→40 CAD 的结果并非单调,说明“10 个即饱和”主要适用于 3D IoU。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
| 配置 | 3D*50 | 5°5cm | 10°5cm | 15°5cm |
|---|
| 无 inlier head | 48.9 | 19.9 | 49.3 | 66.9 |
| 无 symmetry handling | 44.5 | 12.7 | 40.5 | 56.7 |
| Full | 63.2 | 28.8 | 60.1 | 73.6 |
Symmetry 贡献比 inlier 更大,说明 noisy labels / equivalent poses 是 correspondence learning 的首要问题。
CAD 数量:
- 10:63.2 / 28.8 / 60.1 / 73.6;
- 20:62.7 / 29.9 / 62.9 / 77.6;
- 40:63.8 / 28.9 / 57.5 / 74.9。
3D IoU 在 10 个后近似饱和,strict pose 并不单调;随机 CAD selection 和单一 prior choice 的方差应报告多次 seeds。
9. 失败模式与局限
- transparent bottles 的 depth 缺失 / 错误直接破坏 observed 3D cloud;
- inaccurate 2D masks,尤其 camera 类,会污染对应;
- 每类需要已知 synthetic CADs、category 与一个 prior;
- 正文没有充分说明 inference reference prior 的选择 / 多 prior sensitivity;
- DINO semantic point cloud 依赖 synthetic texture / render;
- 3D* 与 3D+ 两种 IoU implementation 不一致;
- SUN RGB-D 只评 chair、baseline 单一;
- symmetry canonicalization 是手工类级规则;
- 51 ms 不含 external detector,且 RANSAC latency / iteration 未单列;
- “10 CAD 足够”的结论缺少 selection seeds 与跨类别方差。
10. 复现检查表
- ShapeNet 每类固定 10 CAD 与 40 views / CAD;
- DINOv2 ViT-S 384D、render / crop 480×480;
- full / partial 采样 3,000 / 1,000 points;
- 按 visibility 投影并多视角平均 DINO features;
- 训练 pair 的 correspondence 由已知 render pose 生成;
- inlier BCE + assignment focal loss 同时开启;
- symmetry GT canonicalization 与 mug visibility rule 固定;
- 记录 prior CAD 的选择方法与多 prior variance;
- RANSAC + Umeyama 参数完整披露;
- 使用相同 3D* / 3D+ evaluator 比较;
- 端到端计入 detection、DINO extraction、matching 与 solver。
11. 最终评价
GS-Pose 是“foundation semantics 如何真正进入几何求解”的一个清楚范例。它没有让 DINOv2 直接回归 pose,而是把 patch semantics 提升到 3D points、与 depth geometry 共同建立可检查的 correspondences,再由 RANSAC + Umeyama 求变换。相同 10-CAD budget 下的 63.2 3D*50 和 28.8 5°5cm 证明这种表示比纯几何更数据高效。
它的边界也很明确:RGB-D、mask、类别与 CAD prior 都不可缺,绝对准确率仍低于最强 real-supervised 方法,transparent depth 与 symmetry rules 也是薄弱点。其最值得迁移的不是某个榜单数字,而是“用 foundation model 提供全局部件语义、用显式 3D solver 保留几何约束”的系统结构。
