论文精读笔记:HiPose
1. 核心判断
HiPose 把 dense correspondence 中通常彼此独立的三件事——表面表示、pose estimation、outlier rejection——合并为一个 coarse-to-fine 几何过程。
传统 binary surface code 会把网络输出一次阈值化为某个 CAD vertex,再交给 PnP / RANSAC。问题是:
- 后面的 bit 对应更细表面,更难预测;
- 一次硬量化丢掉每一 bit 的置信度;
- 错误的细 bit 会直接把 correspondence 推到远处;
- RANSAC 与 render refinement 增加时延和随机性。
HiPose 只先相信较粗的 bits,把点对应到 surface region 而非单点;初始 pose 建立后,逐 bit 缩小区域,并在每轮以点到变换后表面的距离去掉 outlier。最终 LM-O ADD(-S) recall 为 89.6,完整 BOP mean score 84.6,且 pose 本身只需 0.075 s。它的主要贡献是 solver-aware decoding,不是一个新的 RGB-D backbone。
2. 任务、输入和监督边界
输入:
- 外部 detector 给出的 object ROI;
- RGB crop;
- ROI depth 反投影并采样得到的点云;
- camera intrinsics;
- 已知目标 CAD 与其 hierarchical binary surface code。
输出是对象在相机坐标系中的 absolute R,t。
HiPose 是 seen-object / instance-level 方法。论文只用 BOP PBR synthetic images 训练,但这些训练图仍针对 LM-O、YCB-V、T-LESS 的已知 CAD。这里的“only synthetic data”描述 sim-to-real 数据来源,不表示模型可零样本处理任意新 CAD。
3. 层级表面编码
给定含 L 个 vertices 的 CAD surface,作者递归使用 balanced k-means 二分表面。每个 vertex 获得长度为 d 的 binary code:
ci=(ci1,…,cid),cij∈{0,1}.
前几个 bit 表示大区域,后几个 bit 逐渐收缩到局部小面,最终可定位单个 vertex。相邻 prefix 表示嵌套区域,因此“预测对了一部分 bits”并非完全无效,而是提供一个 coarse point-to-surface correspondence。
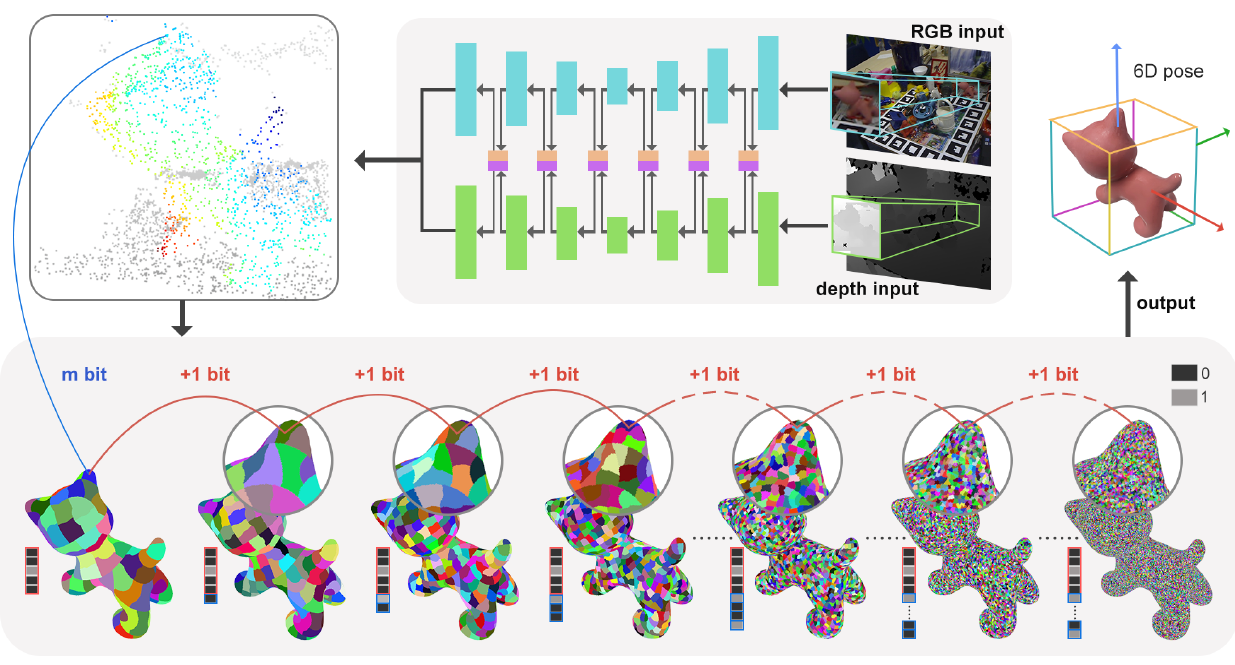 原论文 Figure 2。蓝线以可信 prefix 选择初始粗表面;红线逐 bit 二分,随着对应变细,pose 与 outlier 集合也被同步更新。来源:CVPR 2024 正式论文;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
网络以 FFB6D full-flow bidirectional fusion 为基础,RGB 与 point cloud 两个 branch 交换特征。对每个采样点,单一 output head 预测:
- visible mask;
- 长度 d=m+n 的 binary code;
- 每一 bit 的连续 logit。
mask 与 code 都用 L1 loss,权重 α=3。网络训练 380k iterations、batch 32,image backbone 使用 ConvNeXt。
4. 从 bit confidence 到初始表面
传统做法将预测 c^∈[0,1]d 按 0.5 二值化。HiPose额外定义 bit correctness probability:
pc=1−∣c^−c^∣,
其中 c^ 是量化 bit。越接近 0 或 1,置信越高;越接近 0.5,越不可信。
对每个点,最后一个超过 trust threshold 的 bit 决定其初始 surface prefix。全局 mdefault 限制初始表面不能过粗,避免几何约束弱、Kabsch 初值不稳定。论文默认从第 10 bit 附近开始,在精度与计算量间折中。
粗 surface Sm 的 centroid gm 与观测 3D 点 P 构成 point-to-surface correspondence;所有 correspondence 由 Kabsch 得到初始 (R^0,t^0)。
5. 层级 pruning 与确定性 pose solver
在第 it 轮,点 Pk 与其 candidate surface Sm+it 的距离为:
lk=vi∈Sm+itmin∥R^itvi+t^it−Pk∥.
作者以全体距离中位数区分 inlier / outlier;保留 inliers 后,用新一层更细 surface centroid 再做 Kabsch。迭代 n 次后,surface 收缩到单点,对从未被判为 outlier 的 point-to-point correspondences 做最后一次 Kabsch。
这一机制的特征:
- 不采样随机 minimal sets,因此 RANSAC-free;
- 每次只有表面划分和小规模 SVD,因此 render-free;
- 早期 coarse surface 对 bit error 容忍高;
- 当前 pose 反过来提供 outlier criterion,prediction 与 solver 构成闭环。
6. pruning 是否真的有效
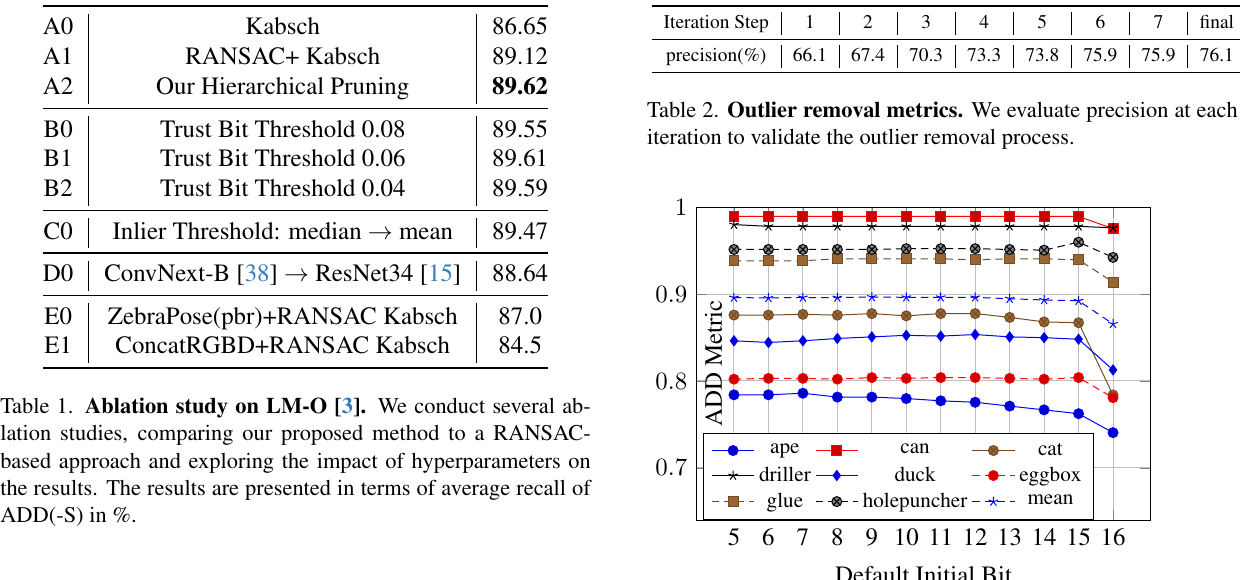 原论文 Table 1–2 与 Figure 4:hierarchical pruning 的 LM-O recall 为 89.62,高于直接 Kabsch 的 86.65 和调参后的 RANSAC+Kabsch 89.12;逐轮 inlier precision 从 66.1% 升到 76.1%。来源:CVPR 2024 正式论文;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
LM-O 消融:
| 版本 | ADD(-S) recall |
|---|
| 直接 Kabsch | 86.65 |
| RANSAC + Kabsch | 89.12 |
| Hierarchical pruning | 89.62 |
| inlier threshold median→mean | 89.47 |
| ConvNeXt-B→ResNet34 | 88.64 |
| ZebraPose RGB→3D + RANSAC | 87.0 |
| naive RGB-D concat + RANSAC | 84.5 |
提升不是巨大,但证据链完整:
- direct Kabsch→pruning +2.97,说明网络 correspondence 仍有不可忽略 outliers;
- RANSAC→pruning +0.50,说明确定性层级结构至少不逊于调参后的随机采样;
- inlier precision 66.1→76.1,证明被移除的确更多是低质量对应;
- naive RGB-D concat 84.5,表明直接学习 3D–3D correspondence 与 full-flow fusion 有价值。
Figure 4 显示从第 5–11 bit 起步相对稳定;第 12 bit 后开始下降,直接第 16 bit 最差。换言之,网络不能把最细 surface bit 当作完全可靠 label,层级 decoding 确有必要。
7. 主结果
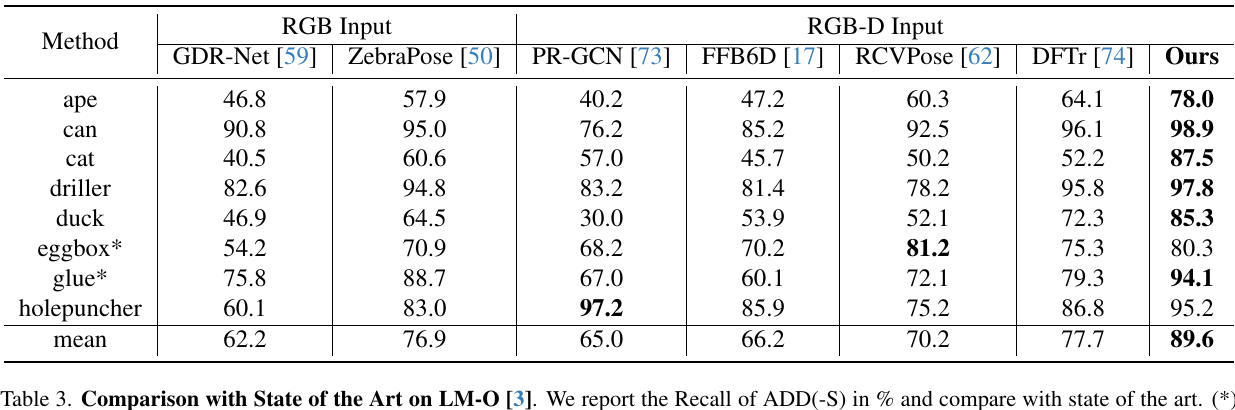 原论文 Table 3:HiPose 在 LM-O 的 mean ADD(-S) recall 为 89.6;相对 DFTr 77.7 提升 11.9 points。来源:CVPR 2024 正式论文;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
LM-O per-object mean:
- HiPose 89.6;
- DFTr 77.7;
- ZebraPose 76.9;
- RCVPose 70.2;
- FFB6D 66.2。
HiPose 在 ape / cat / duck 等对象提升明显,但 eggbox 为 80.3,略低于 RCVPose 81.2;holepuncher 95.2 也低于 PR-GCN 97.2。mean SOTA 不代表每类最优。
YCB-V:
- AUC ADD-S:97.6;
- AUC ADD(-S):95.5;
- DFTr 为 96.7 / 94.4。
增益小于 LM-O,因为 YCB-V 指标已接近饱和。
8. BOP score、速度和“实时”含义
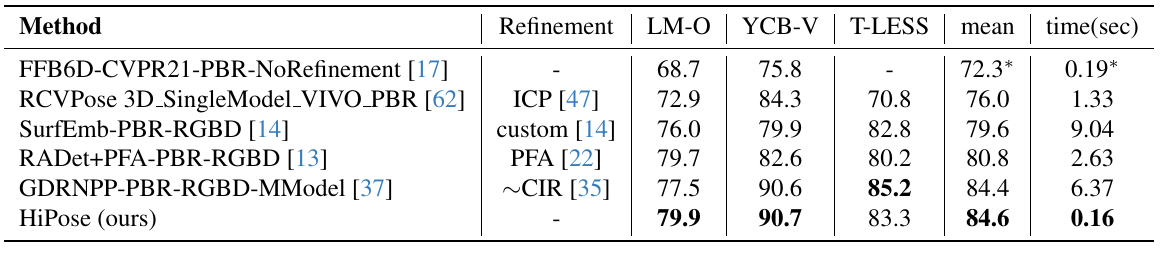 原论文 Table 5:HiPose 的 mean BOP score 84.6,完整时间 0.16 s;GDRNPP + refinement 为 84.4 / 6.37 s。来源:CVPR 2024 正式论文;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
PBR-only BOP score:
| 方法 | LM-O | YCB-V | T-LESS | Mean | 时间 |
|---|
| GDRNPP + refinement | 77.5 | 90.6 | 85.2 | 84.4 | 6.37 s |
| HiPose | 79.9 | 90.7 | 83.3 | 84.6 | 0.16 s |
运行时间拆分:
- pose estimation:0.075 s / image;
- YOLOX detection:0.081 s;
- 合计约 0.156 s,表中四舍五入为 0.16 s。
论文称 real-time critical applications,更准确的理解是约 6.4 FPS 的完整单对象 pipeline;它显著快于多秒 refinement,但未达到 30 FPS。
9. 与相邻方法的关系
- 对 ZebraPose:沿用了 hierarchical binary surface representation,但把 2D–3D PnP 改成 RGB-D 3D–3D Kabsch,并把 bit confidence 用于逐层 decoding。
- 对 FFB6D:借用 full-flow fusion backbone,但 HiPose 的提升重点来自 output representation 与 solver,不只是 backbone。
- 对 MatchU:MatchU 的 descriptors 跨对象共享、面向 unseen CAD;HiPose 的 surface code 对目标 CAD / 训练对象固定。
- 对 render-and-compare:HiPose 用 depth 几何直接求精确 pose,避免迭代 render refinement;代价是 depth 成为硬依赖。
10. 局限与复现检查
- 需要对象级 CAD 和 BOP PBR training,新增对象仍要生成 supervision 并训练;
- 外部 detector 的 object identity 必须已知;
- depth holes、反光 / 透明表面会直接损伤 3D–3D correspondence;
- balanced k-means 的 surface hierarchy 与 mesh sampling 需要一致;
- object symmetry 主要由 ADD(-S) / BOP metric 处理,binary codes 本身并不自动构造 symmetry equivalence class;
- Kabsch 只在 correspondence 质量足够时稳定,粗起始 bit 与 trust threshold 仍是超参数;
- 复现应分别核对 pose 0.075 s 与 detection 0.081 s,不能把二者混报;
- 比较 BOP 表时必须统一 detector、PBR-only 训练和 refinement 定义。
11. 最终评价
HiPose 的价值在于展示了一个很“几何”的设计原则:网络输出不必立刻被压成最细、最脆弱的 correspondence;可以把表示中的层级置信度显式交给 pose solver,让粗 pose 帮助细 correspondence 清洗。
89.62 对 89.12 的 pruning / RANSAC 差距不大,但确定性、低时延、无需 refinement 的工程收益明显;84.6 mean BOP score 与 0.16 s 完整时间也验证了这条路线。它不是通用新物体方法,却是已知 CAD、可靠 RGB-D、强调稳定吞吐场景中的高质量实例级 baseline。
