论文精读笔记:HIPPo
1. 核心判断
论文:arXiv 2502.10606
项目 / 发表:项目页 · RA-L 2025 / ICRA 2026。
核心问题:新对象第一次进入机器人视野时,既没有 CAD、也来不及采多视图扫描;纯 object SLAM 首帧只有残缺表面,纯 image-to-3D 又会在不可见区域产生幻觉。怎样既立即工作,又随真实观测变得更可信?
核心回答:以生成式完整 mesh 作为时间 t = 0 t=0 t = 0
我的判断:HIPPo 最值得借鉴的是“先验的生命周期”设计:foundation model 不是永恒真值,而是冷启动占位符。它的位姿 benchmark 很强,但系统仍依赖多项大型预训练组件,且 mesh update 的近 10 秒成本与严重遮挡限制必须一起陈述。
2. 一句话定位
HIPPo 是一个生成先验驱动的 object-centric digital twin:Wonder3D + MASt3R 在约 8 秒内造出完整、带尺度 mesh,FoundationPose 提供实时 pose,viewpoint-triggered RGB-D fusion 则逐步把“想象”替换为“测量”。
2.1 图表导读
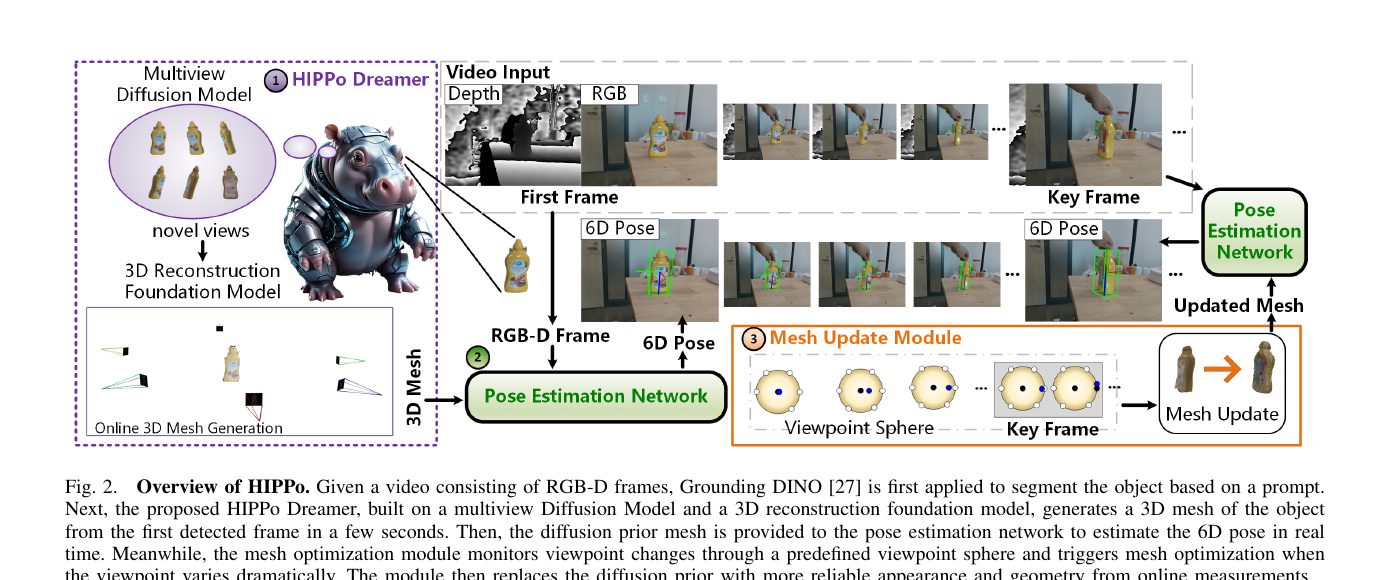
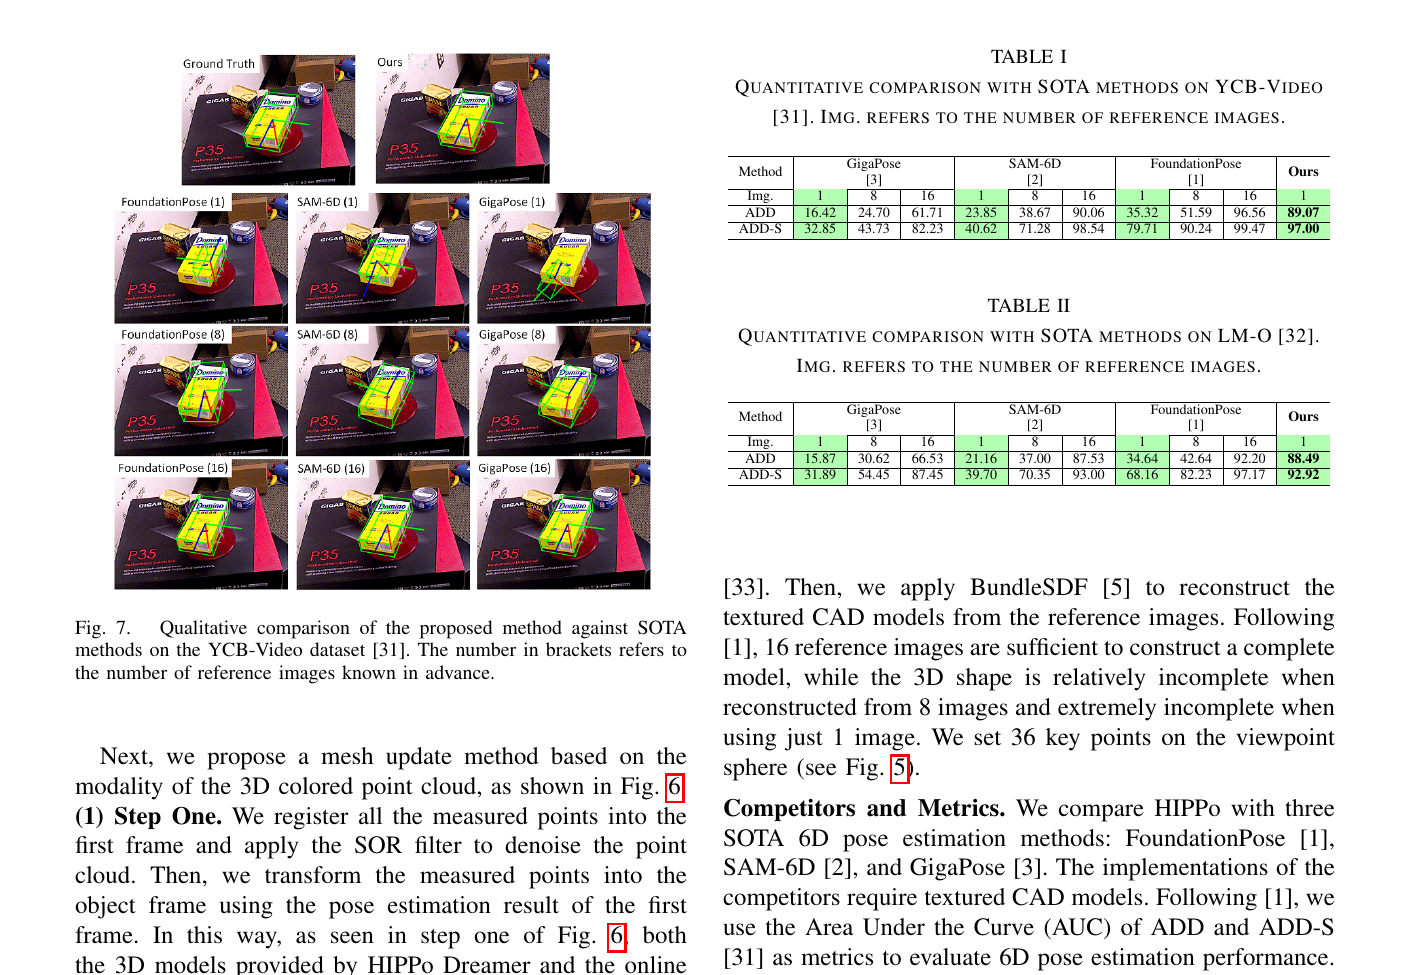
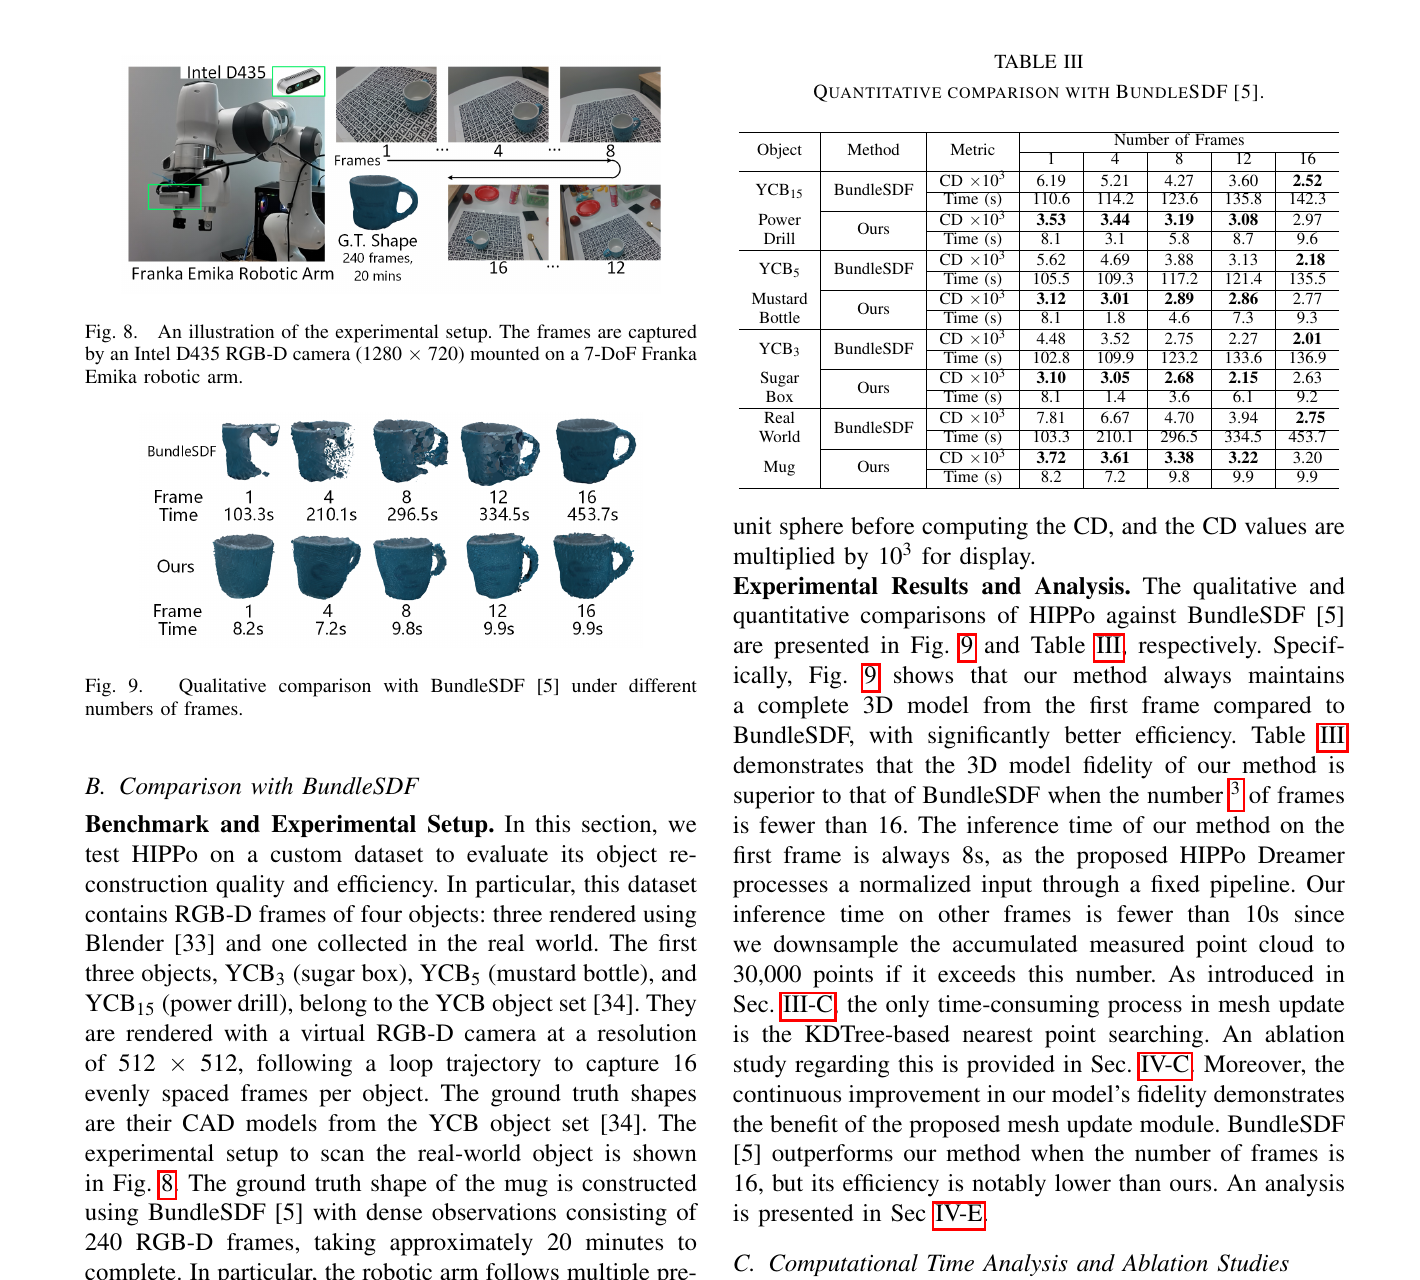
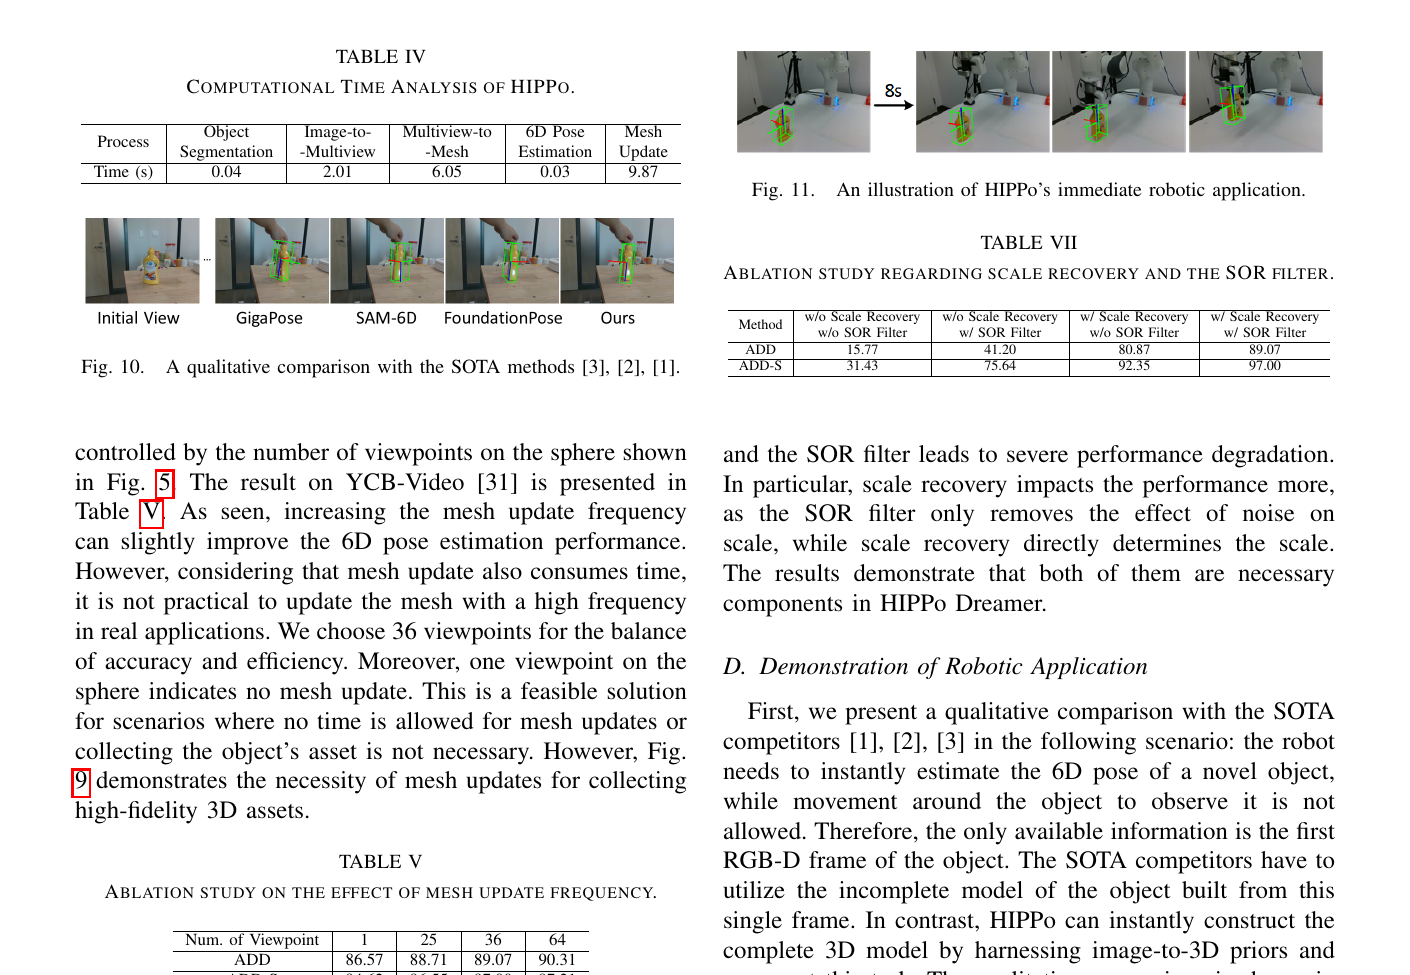
图表 应该看什么 Figure 2 Dreamer、pose network 和 mesh update 并非同频执行。 Table I–II 每个基线的 reference 数量不同;HIPPo 的卖点是 1-image regime。 Figure 9、Table III “首帧完整性”与“长期高保真”是两种不同重建目标。 Table IV 8 秒初始化、0.03 秒 pose、9.87 秒 update 必须拆开报告。 Table V–VII 视点数量、点数、scale recovery 和 SOR 的效率—质量取舍。
原论文 Figure 2:HIPPo Dreamer 只在初始化阶段生成 mesh,pose 网络逐帧运行,mesh update 由 viewpoint sphere 的新视角事件触发。来源:HIPPo 原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
3. 问题设定与 model-free 的边界
输入是一段 RGB-D 序列和用于开放词汇检测 / 分割的文本提示。测试对象没有人工 CAD,也没有提前采集的 posed references。输出包括:
每帧相机坐标中的实例级 6D pose;
从首帧就存在、随后在线更新的对象 textured mesh;
可供抓取 / OBB 规划使用的 metric-scale 对象资产。
“model-free”指不用对象专属人工模型 ,而不是系统没有模型。它依赖 Wonder3D、MASt3R、Grounded segmentation、FoundationPose 等预训练基础模型,还需要 query depth 与相机内参。
4. HIPPo Dreamer
4.1 首帧分割
Grounding DINO / Grounded SAM 根据 prompt 找到对象,并将同一 mask 应用于 RGB 和 depth。分割质量同时影响:
image-to-3D 的前景干净程度;
原始观测的 OBB / 尺度估计;
后续 FoundationPose crop;
mesh update 中哪些点被当成对象。
因此它是系统共享故障点,不只是无关紧要的预处理。
4.2 单图到多视图
Wonder3D 从首帧合成若干 canonical novel views。普通 image-to-3D 的不可见面由训练先验补全:优点是第一帧就有闭合模型,缺点是背面几何和纹理可能只是“合理”而非真实。
4.3 改造 MASt3R 重建
作者用 MASt3R 将生成视图注册为 3D。原版 background optimization 容易把不一致的生成背景 / mask 带入几何,论文修改背景 masking 与优化流程,使多视图 diffusion 之间的小矛盾不至于直接破坏 object mesh。
4.4 metric scale recovery
image-to-3D 输出只有任意尺度,而 6D pose 的 translation 和机器人抓取都需要米制大小。作者从首帧深度点云计算 oriented bounding box 最大边 r max r_{\max} r m a x g max g_{\max} g m a x
s = g max / r max s=g_{\max}/r_{\max} s = g m a x / r m a x 或其实现中的等价逆向因子将两者缩放到同一物理尺度。关键不是公式方向,而是把首帧深度的 metric cue 注入生成资产。
Table VII 说明 scale recovery 是不可替代的:无 scale / 无 SOR 时 ADD / ADD-S 仅 15.77 / 31.43;加 SOR 也只有 41.20 / 75.64;有 scale、无 SOR 已到 80.87 / 92.35,二者都有则 89.07 / 97.00。SOR 主要去噪,scale 直接决定 pose 几何是否处在正确量纲。
5. 位姿估计
生成 textured mesh 后,HIPPo直接调用 FoundationPose 的 refinement network。当前估计 pose 下渲染 mesh,与真实 crop 进入 Siamese feature encoder,网络预测相对修正。论文的创新不在这个网络内部,而在于为它快速准备了可用资产。
这也解释了 HIPPo 的性能边界:
mesh 的可见面、尺度和纹理越准确,FoundationPose 越容易 refinement;
首帧重遮挡或 mask 误差会让 Dreamer 生成错误模型,pose 后端并不会知道该表面是幻觉;
后续 update 需要 pose 足够准才能把深度点注册进 object frame,存在 pose–model 相互依赖。
6. measurement-guided mesh update
6.1 viewpoint sphere
作者在对象周围均匀放置 N N N
论文最终选 N = 36 N=36 N = 36
viewpoint 数 1(不更新) 25 36 64 ADD 86.57 88.71 89.07 90.31 ADD-S 94.62 96.55 97.00 97.21
频繁更新收益递减;64 比 36 的 ADD 仅高 1.24,而会更频繁触发约 10 秒操作。
6.2 用测量替换先验
所有 keyframe depth 点先经 SOR(statistical outlier removal)去噪,再利用估计 pose 变换到首帧 / object frame。对每个真实测量点,在 diffusion prior point cloud 上用 KDTree 找最近点,将其位置和颜色替换为测量值,最后用 Poisson surface reconstruction 重新生成 mesh。
这不是 NeRF / SDF 式联合 photometric optimization,而是务实的 point replacement。优点是简单、无需训练、几秒可更新;缺点是:
错 pose 会把真实点融合到错误位置;
最近邻难以处理拓扑改变、薄结构和先验中不存在的部件;
多次替换后的表面连续性依赖 Poisson reconstruction;
充分观测时,上限不如专门神经重建。
为控制 KDTree 成本,测量点超过 30,000 就 FPS downsample。Table VI 中 5k → 40k 点,时间从 1.73 → 14.34 s,CD 从 3.55 → 3.13;30k 的 9.87 s / 3.17 是折中。
7. 位姿主结果
原论文 Figure 7、Table I–II:HIPPo 固定只看第一帧;GigaPose、SAM-6D、FoundationPose 分别给 1 / 8 / 16 张 reference 以形成不同完整度的资产。来源:HIPPo 原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
YCB-Video:
方法 / reference 数 ADD ADD-S GigaPose / 1 16.42 32.85 SAM-6D / 1 23.85 40.62 FoundationPose / 1 35.32 79.71 HIPPo / 1 89.07 97.00 FoundationPose / 16 96.56 99.47
LM-O:
方法 / reference 数 ADD ADD-S GigaPose / 1 15.87 31.89 SAM-6D / 1 21.16 39.70 FoundationPose / 1 34.64 68.16 HIPPo / 1 88.49 92.92 FoundationPose / 16 92.20 97.17
结论很清楚:当所有方法只有第一眼时,直接从一张真实图重建的资产极不完整,HIPPo 的生成补全带来巨大收益;当基线已有 16 张 reference、可得到近完整模型,FoundationPose / SAM-6D 仍略高。因此论文不是证明生成 mesh 比真 CAD 更准,而是证明它能大幅降低冷启动信息预算。
8. 重建质量与时间
原论文 Figure 8–9、Table III:HIPPo 首帧就有完整先验,BundleSDF 从局部表面逐步生长;到 16 帧时后者可更精细,但时间高一个数量级以上。来源:HIPPo 原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
自建数据包括 3 个 YCB 渲染对象和 1 个真实 mug。BundleSDF 首帧只能重建可见面,HIPPo 首帧已有闭合形状。以 power drill 为例:
1 帧:BundleSDF CD 6.19 / 110.6 s,HIPPo 3.53 / 8.1 s;
16 帧:BundleSDF 2.52 / 142.3 s,HIPPo 2.97 / 9.6 s。
对真实 mug,BundleSDF 16 帧 CD 2.75、453.7 s;HIPPo 3.20、9.9 s。这里时间是对应帧数阶段的处理成本,真实 BundleSDF 还用 240 帧约 20 分钟构造评测用 ground-truth shape。
该结果展示了两个目标:
time-to-first-complete-model :HIPPo 显著更优;sufficient-observation fidelity :BundleSDF 在 16 帧可能更优。
机器人若需要立即抓取,第一项更关键;数字化归档若允许完整扫描,第二项更关键。
9. 计算口径与消融
原论文 Table IV / VII 与 Figure 10–11:首次 Dreamer 约 8 秒,逐帧 pose 约 0.03 秒,一次 mesh update 约 9.87 秒;scale recovery 是位姿成功的前提。来源:HIPPo 原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
Table IV 将成本拆得很清楚:
阶段 时间 object segmentation 0.04 s image-to-multiview 2.01 s multiview-to-mesh 6.05 s 6D pose estimation 0.03 s mesh update 9.87 s
所以“around 15 FPS”是 segmentation + pose(约 0.07 s)的稳态速度;从首次见到对象到可用 pose 要先等约 8 秒;进入关键新视角时还可能异步 / 阻塞执行近 10 秒更新。部署时应说明这三个时间尺度。
10. 作者声称与我的判断
作者声称 我的判断 无 CAD / 预采 reference 即时估 pose 资产要求确实降到首帧 RGB-D,但约 8 秒后才完成 Dreamer,“即时”是相对分钟级扫描。 少 reference 时大幅超过 SOTA Table I–II 证据强;16 reference / 完整模型时对照仍略优,论文也如实展示。 持续优化生成模型 真实点替换使 CD 逐步改善,成立;不是全局 joint neural optimization。 可立即用于抓取 有机器人定性 demo;缺少大规模抓取成功率统计。
11. 复现清单与局限
保存第一帧 mask、深度 OBB、Wonder3D 六视图、MASt3R 点云和 scale factor,逐步核查故障。
FoundationPose 与 mesh update 共用 object frame,必须锁定 mesh 每次 Poisson reconstruction 后的坐标和尺度。
viewpoint sphere 使用相对 rotation;若 tracking 漂移,会错误触发或漏触发 keyframe。
分别报告冷启动、稳态 pose、update 频率与 update 时间,不只给 15 FPS。
严重遮挡、透明 / 反光 depth、错误 prompt mask 会让首帧先验和尺度一起失真。
官方项目仓库提供组件链接与关键复现片段,但明确说明受 IP 政策限制,没有完整 click-and-run 实现;因此站内不标“完整开源”。
下一步可用 pose / reconstruction uncertainty 决定何时信先验、何时采新视角,而不只按离散 viewpoint occupancy 触发。
HIPPo 给出的方向比单个 benchmark 数字更重要:面向开放世界机器人,生成模型最合理的角色可能不是替代测量,而是缩短“什么都不知道”到“有一个可操作初值”的时间;随后必须让真实传感器逐步接管。