论文精读笔记:HouseCat6D
1. 核心判断
HouseCat6D 的主要价值不只是“更多数据”,而是同时改善了类别级 6D pose 数据的四个薄弱环节:
观测分布 :自由移动相机覆盖对象周围和下半球,不再只看桌面上方;材质 :glass、cutlery 等透明 / 强反光对象进入正式类别;标注质量 :外部红外跟踪、测量针、手眼标定、时间同步和 bundle adjustment 把点级误差控制到 1.35–1.73 mm;下游任务 :同一场景同时提供 dense parallel-jaw grasp labels。
基准也揭示了两个重要事实:首先,VI-Net 在新数据上的总体 3D50 只有 56.4,类别级真实场景远未饱和;其次,即使给 NOCS 真值坐标,传感器 depth 仍会在 glass / tube 上造成 lifting error。数据把“网络表征误差”和“传感器几何误差”同时暴露出来。
2. 数据规模与 split
项目 数量 / 设置 对象 194 类别 10 场景 41 总帧数 约 23.5k 对象 pose 约 160k 抓取 pose 约 10M Pose split 34 train / 2 val / 5 test scenes 帧 split 20k train / 1.4k val / 3k test 对象 split 124 train / 20 val / 50 test Grasp split 14 train / 1 val / 1 test scenes
10 类是 bottle、box、can、cup、cutlery、glass、remote、shoe、teapot、tube。测试场景中的对象实例不出现在训练中,因此主任务是 known category、unseen instance。
每帧可包含:
RGB;
active-stereo depth;
四个偏振角的 RGBP;
camera trajectory;
object masks、6D pose 与 CAD mesh;
部分序列的可行 / 不可行 grasp pose。
“RGBD+P”不是把 depth 与 polarization 合成一个网络输入的缩写,而是数据层面同时提供普通 RGB、深度与偏振图像。论文主 pose baseline 仍以 RGB-D 为主,没有证明 polarization 已显著改善 6D pose。
3. 采集硬件与坐标链
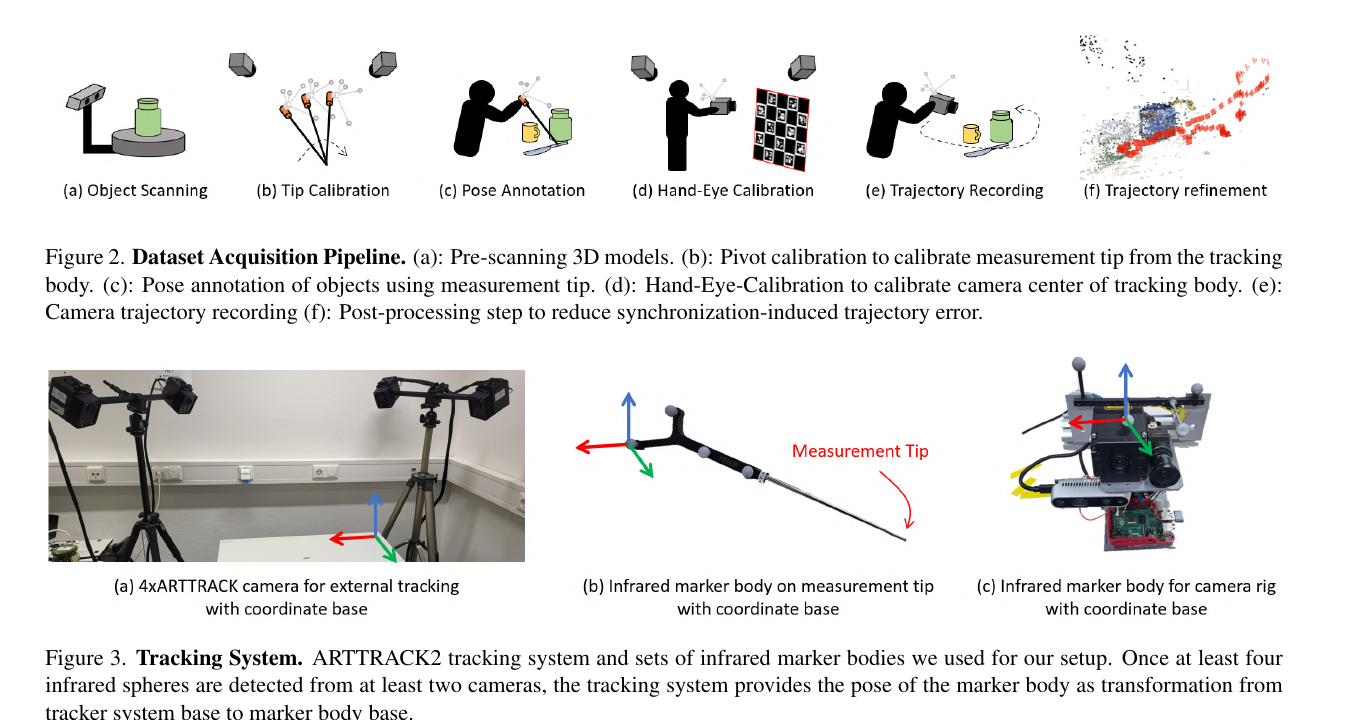
原论文 Figure 2–3。数据采集从 mesh scanning、测量针标定、对象 pose annotation、hand–eye calibration、轨迹记录到后处理;外部 ARTTRACK 系统跟踪测量针和手持相机 rig。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
核心坐标系包括:
tracker system base T B TB T B
infrared marker body M B MB M B
camera center C B CB C B
checkerboard base B B BB B B
object / measurement-tip coordinates。
与把 checkerboard 放在每幅图里的传统流程不同,HouseCat6D 由外部四相机红外系统提供 marker pose。只要至少两台红外相机看到 marker body 上的四个球,即可输出其相对 tracker base 的变换。
硬件层面:
普通 / 偏振 RGB 与 active-stereo depth 使用专门传感器;
硬件 trigger 尽可能同步各相机;
对象由结构光扫描仪预扫描;
glass / reflective surface 可用自消散喷雾辅助扫描;
相机 rig 可手持自由移动,扩大 workspace 和 viewpoint coverage。
4. 从测量针到对象 pose
4.1 Pivot calibration
测量针的物理尖端并不等于 marker body 原点。作者固定尖端、转动 marker body,通过多个观测最小化固定点位置方差,得到 tip offset。最终使用 18 个姿态,尖端位置方差约 0.040 mm。
4.2 对象 pose annotation
标注者用测量针在对象表面采集 3D points,以这些点和 mesh 对齐:
选择一组表面对应,给出初始变换;
用 ICP refinement;
覆盖多个表面,避免单侧 / 共面点退化。
作者模拟 pivot 与 tracking 误差,估计该步骤的平均 RMSE 约 0.32 mm / 0.43°。
4.3 Hand–eye calibration
作者没有只用一幅 checkerboard detection 的闭式解,而是从多个位置采集 camera 与 tracking-body trajectories,通过 Horn alignment 得到稳定 offset。报告 RMSE:
translation:0.27 mm;
rotation:0.42°。
4.4 时间同步与轨迹后处理
即使硬件触发,红外 tracker 与 camera 的频率和时间戳仍不同。作者以 ICP 对齐轨迹估计 offset,模拟误差约 0.03 s。快速相机运动时,这仍可形成明显 pose offset。
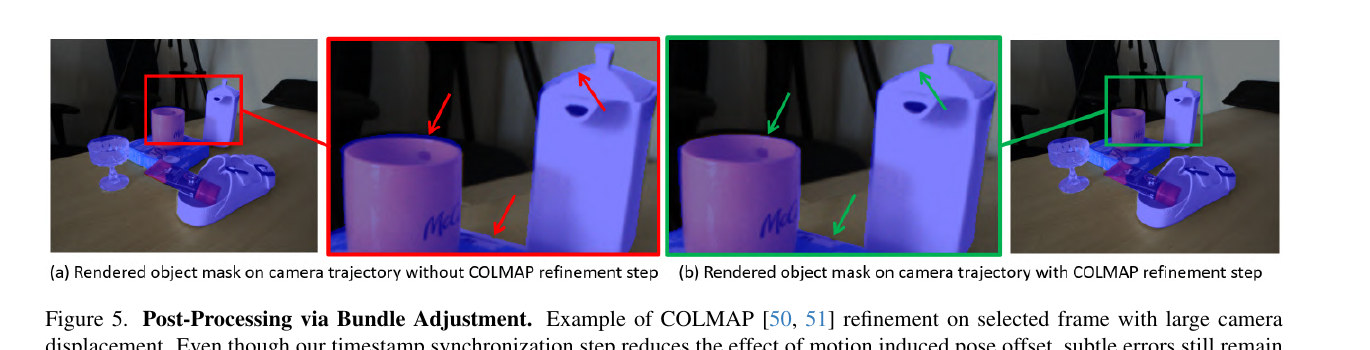
原论文 Figure 5。左侧初始轨迹投影在快速运动处出现 mask offset;右侧以选定固定帧和 COLMAP refinement 后,对象投影与 RGB 边界更一致。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
后处理不是从零做 SfM:
已有 tracking trajectory 作为初始化;
人工选择 render-mask 与 RGB 最一致的固定帧;
固定帧不参与后续自由漂移;
COLMAP feature matching、structure reconstruction 与 bundle adjustment 主要修正运动诱发 offset。
这种流程提高精度,但也引入人工选择 fixed frames 的成本。复现数据采集时不能只照搬网络代码而忽略标注工程。
5. 标注精度应怎样理解
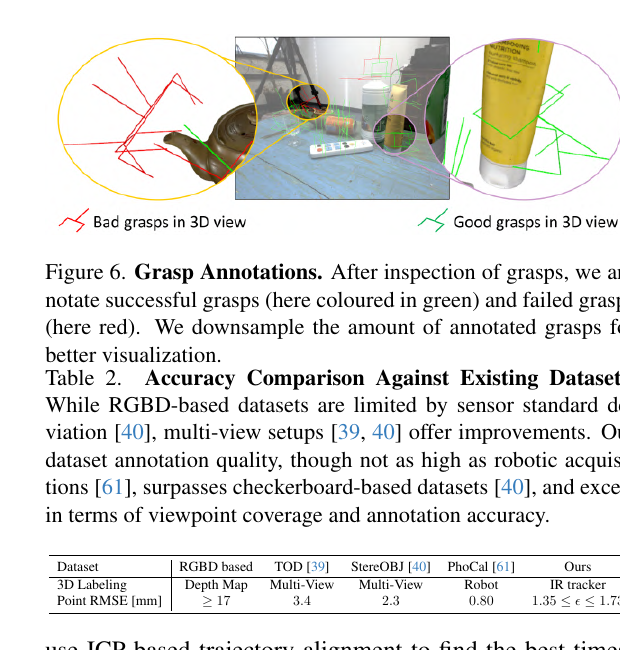
原论文 Figure 6 与 Table 2。抓取候选由 antipodal sampling 和 Isaac Gym 检验后分为成功 / 失败;点级 pose annotation RMSE 估计为 1.35–1.73 mm。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
Table 2 比较的是“对象模型点在综合系统误差下的 point RMSE”,不是单一传感器标称精度:
数据 / 方案 标注方式 Point RMSE 普通 RGB-D lifting depth map ≥17 mm TOD multi-view 3.4 mm StereoOBJ multi-view 2.3 mm PhoCaL robot 0.80 mm HouseCat6D IR tracker 1.35–1.73 mm
1.35 和 1.73 是考虑不同系统误差组合的上下界;SfM 后处理的实际收益无法被完整量化,所以不应把该范围当成每个像素的直接测量误差。
它比 robot-arm ground truth 略差,但用手持 rig 换来了:
更大工作空间;
更丰富背景;
更均匀的 camera pose;
不在图像中保留 checkerboard。
6. Viewpoint coverage
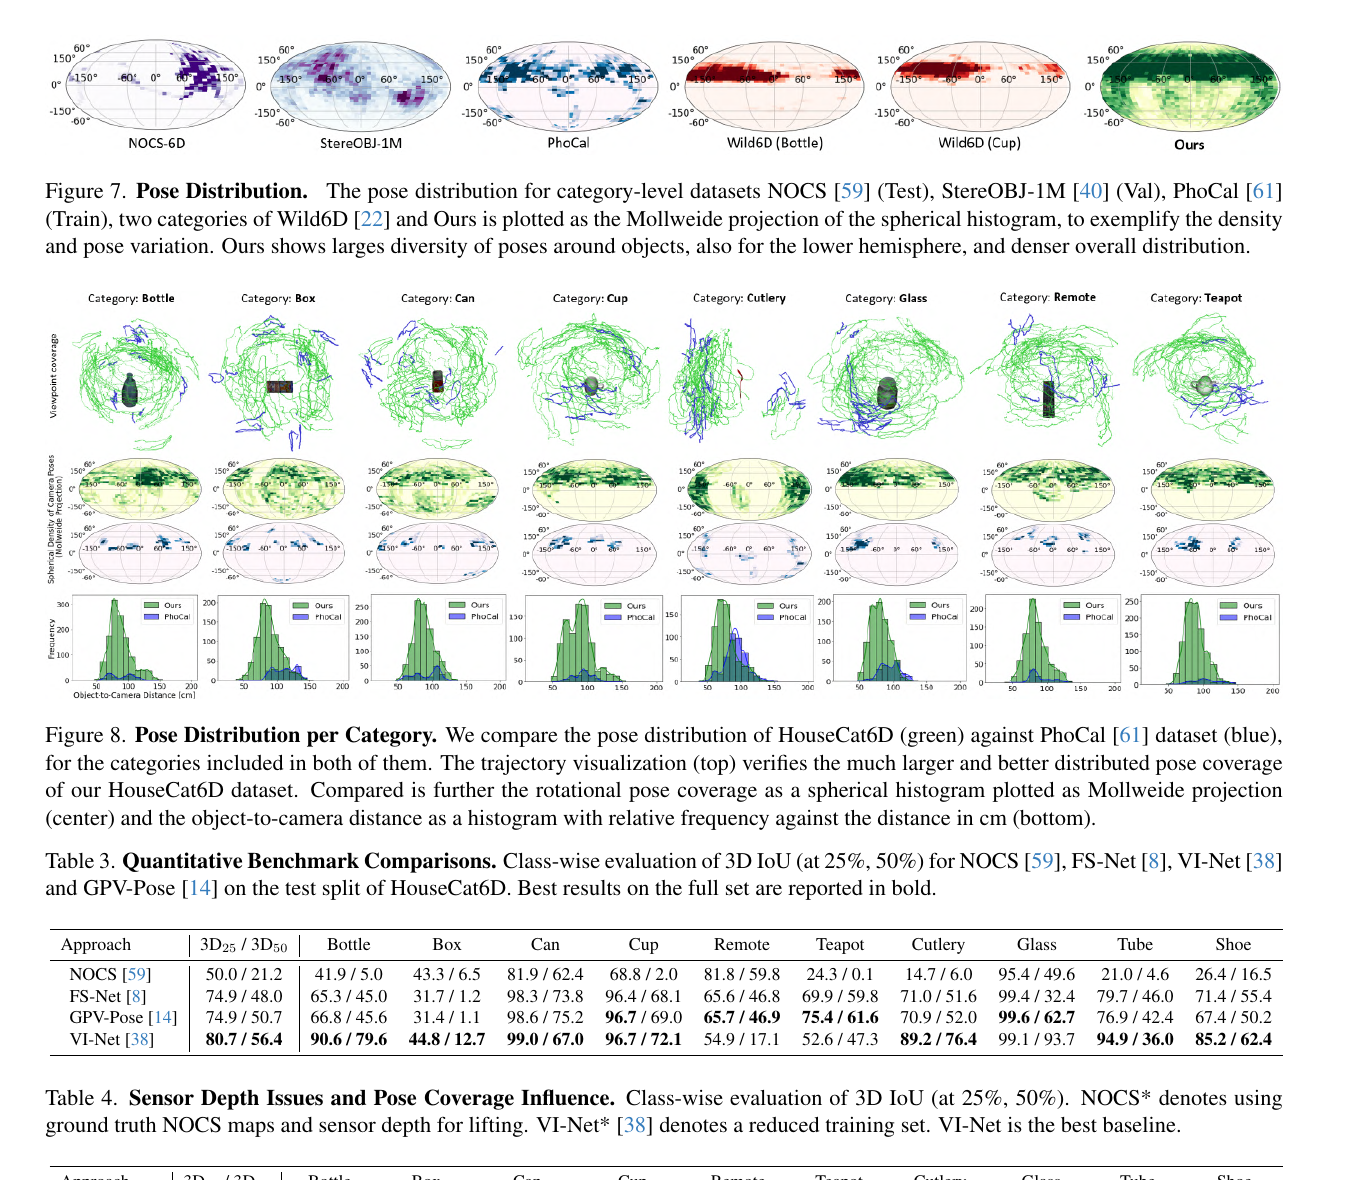
原论文 Figure 7–8 与 Table 3。Mollweide histogram 展示 HouseCat6D 对下半球和环绕视角的覆盖;下方为四种类别级 pose baseline 的 3D IoU。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
相较 NOCS、StereoOBJ-1M、PhoCaL 与 Wild6D,HouseCat6D 的 camera orientation 分布:
不只集中于上半球;
每类对象都有多方向轨迹;
object-to-camera distance 更宽;
真实场景内同时出现遮挡与近距离对象。
作者将 VI-Net 训练数据裁成类似 PhoCaL 的有限 coverage,得到:
训练 coverage 3D25 3D50 HouseCat6D full 80.7 56.4 reduced VI-Net* 68.4 31.3
3D50 下降 25.1 points,说明 pose coverage 不是数据集“看起来多样”的定性卖点,而是可量化的泛化变量。
7. 类别级 pose benchmark
总体:
方法 3D25 3D50 NOCS 50.0 21.2 FS-Net 74.9 48.0 GPV-Pose 74.9 50.7 VI-Net 80.7 56.4
VI-Net 分类别 3D25 / 3D50:
bottle:90.6 / 79.6;
box:44.8 / 12.7;
can:99.0 / 67.0;
cup:96.7 / 72.1;
remote:54.9 / 17.1;
teapot:52.6 / 47.3;
cutlery:89.2 / 76.4;
glass:99.1 / 93.7;
tube:94.9 / 36.0;
shoe:85.2 / 62.4。
glass 的 3D IoU 很高不代表 rotation 一定精确;3D IoU 对近似轴对称 / 尺寸和中心可能更宽容。box / remote 的低分则与类内外观、薄结构、遮挡和 NOCS canonicalization 共同相关。
8. Depth error 消融
作者以真值 NOCS map 替代网络预测、仍使用 sensor depth lifting:
总体 3D25 / 3D50 达 96.7 / 93.6;
说明大部分普通类别错误来自 2D NOCS prediction;
glass 的该设置为 80.0 / 68.0,显著低于 VI-Net 99.1 / 93.7;
tube 的严格性能也受 depth 影响。
这看似反直觉:真值 canonical coordinates + sensor depth 竟可能不如 learned 3D pipeline。原因是 transparent / reflective surface 的 depth points 并不对应真实表面,完美 2D coordinate 不能修正错误三维测量;VI-Net 等模型反而能通过数据 prior 绕过部分缺失。
论文还报告在 75% IoU 下,真值 NOCS + sensor depth 的 mean 只有 22.6%,比宽松 3D50 更能暴露 lifting error。
9. Grasp annotation 与真实实验
抓取生成:
对 mesh 做 antipodal sampling;
Isaac Gym 区分成功 / 失败候选;
由对象 pose 将 grasp 变换到 tracker frame;
重建背景并做 collision checking;
将剩余 grasp 投影到每一帧 camera frame。
基线 KGN 从 RGB-D 预测 gripper keypoints,再用 PnP 求 6D grasp pose。论文报告:
test set grasp coverage rate 与 object success rate;
Franka 7-DoF robot 的真实 grasp success;
每对象 15 次 trials。
真实结果(without / with keypoint refinement):
box:80.0 / 80.0;
cup:66.7 / 66.7;
glass:66.7 / 73.3;
remote:53.3 / 33.3;
unknown:53.3 / 60.0。
refinement 并非稳定增益;remote 明显下降。实验规模也不足以对类别成功率做高置信度统计,但证明该数据可用于完整感知—操作链路。
10. 局限与使用风险
只有 10 categories,不是 open-world household dataset;
主 pose benchmark 未系统使用 polarization,模态价值仍待后续工作证明;
active-stereo depth 在透明 / 反射表面仍错误;
bundle adjustment 依赖人工选 fixed frames;
1.35–1.73 mm 是系统误差估计,不是逐帧独立真值误差;
scene-level split 和 instance-level split必须同时保留,随机帧划分会泄漏;
3D IoU 宽阈值会掩盖 rotation / symmetry 问题;
抓取真实试验每对象 15 次,统计区间较宽;
复杂类别分布不平衡,每类约 19 objects 仍有限;
benchmark 的 detector / segmentation error 与 pose error 没有在主表完全拆开。
11. 复现与使用检查表
按官方 34 / 2 / 5 scene split,不要随机拆帧;
保证 train / val / test objects instance-disjoint;
明确使用 RGB、RGB-D、RGB-P 或全部模态;
depth 到 point cloud 的 intrinsics、单位和 invalid mask 一致;
使用官方 object origin、mesh scale 与 symmetry;
报总体与逐类别 3D25 / 3D50,最好补 rotation / translation metrics;
分离 detection、segmentation、lifting 和 pose solver 误差;
对 glass / cutlery / tube 单列 depth valid ratio;
比较 full 与 reduced viewpoint coverage;
抓取实验同时报告 GCR、OSR 和真实 GSR;
真实机器人至少记录每次 failure type,而非只给平均 success;
使用 polarization 时建立 RGB-D baseline,避免把数据存在等同于模态有效。
12. 最终评价
HouseCat6D 是 2024 年类别级 pose 数据工作中很强的一篇:它把硬件、标定、轨迹、材质、视角、pose benchmark 和 grasp downstream 全部接起来。VI-Net 的 80.7 / 56.4、reduced coverage 的 68.4 / 31.3,以及真值 NOCS + noisy depth 的类别差异,使数据论文不止停留在规模介绍,而是给出可解释的困难来源。
它仍不是最终 benchmark:类别有限,偏振模态尚未充分利用,透明对象深度依旧脆弱,grasp statistics 也偏小。更稳妥的定位是:HouseCat6D 为真实 household category-level pose 提供了高精度、宽视角、多材质的公共压力测试,并把 pose 与抓取操作放到了同一数据坐标链中。