论文精读笔记:iFusion: Inverting Diffusion for Pose-Free Reconstruction from Sparse Views
1. 基本信息
2. 一句话定位
iFusion 把预训练 novel-view diffusion model 转为 pose-free sparse-view reconstruction 的“评价器”:若某相对相机变换能让 diffusion 重建另一视图,它就更可能是正确的 view alignment;对齐后再用 LoRA 让生成器忠于这个具体对象。
2.1 论文图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 3 | pose optimization → LoRA adaptation → reconstruction | 三阶段并非一个端到端 pose network;后两阶段基于已估相对 pose |
| Table 1 | GSO / OO3D 两视图相对 pose | 这里的 rotation / translation 衡量相机间变换,不是 object-to-camera 6D pose |
| Table 2–3 | NVS 与重建 | 用来检验 alignment 是否真能改善下游,而不是只在 pose loss 上看起来好 |
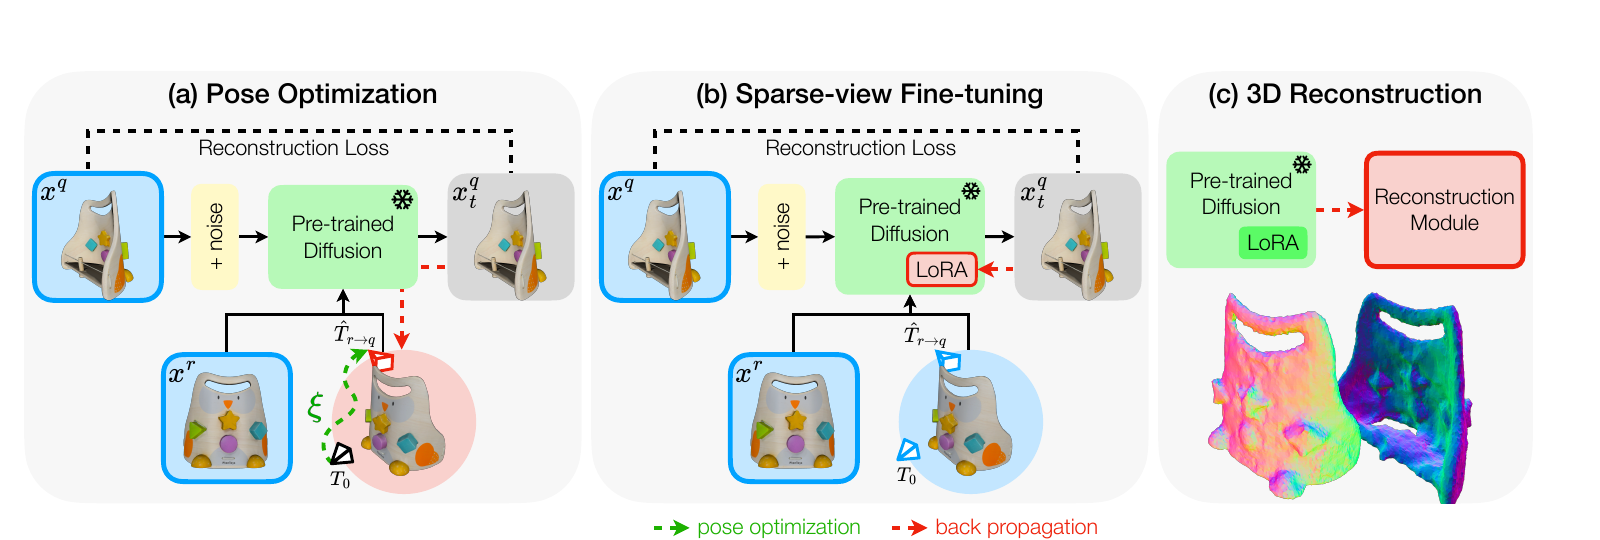 原论文 Figure 3:iFusion 的三阶段框架。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
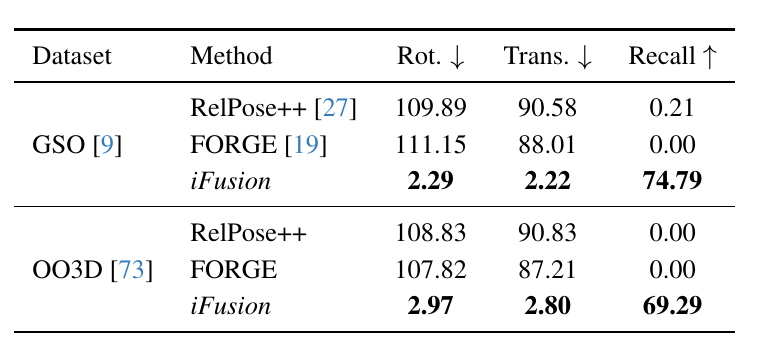 原论文 Table 1:两输入视图下的相对相机 pose 结果,旋转 / 平移误差越低、5° recall 越高越好。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定:它和 6D object pose 的关系
- 给定两张或少数几张物体图像 xr,xq,但相机相对变换 Tr→q 未知。
- 首先输出 T^r→q;随后输出目标对象的适配 NVS generator,并可连接 NeRF、NeuS、DreamGaussian 等 reconstruction backend。
- 本文使用的 “pose” 是相机 view pose / relative camera transform。对象本身可看作固定,因而该任务属于多视图注册;不能把 Table 1 当成 BOP 的 ADD 或 R,t object pose result。
- 作者用冻结的 Zero123 prior 作为优化信号,故假设 object-centric image、生成先验的分布覆盖与足够的内容一致性。
4. 核心想法与研究脉络
传统 SfM / COLMAP 需要较多视图和稳定匹配;两张物体图在低纹理、弱重叠时不可靠。iFusion 利用生成模型已学到的“给定参考视图与相对相机后,应生成什么外观”的先验:优化相机变换,使生成过程能重构真实 query。这是 test-time inversion,而非监督一个通用 relative-pose regressor。
我的分析:这是一种很强但风险也很明确的 objective。它在 target view 像训练分布时,可能比少样本匹配稳;但若 diffusion hallucinate 了看似合理但不真实的背面,优化会把相机变换也拉向假象。因此下游几何 metric 是必要交叉验证。
5. 方法详解
5.1 Diffusion inversion 上的 SE(3) 相对 pose
作者以 twist vector ξ∈se(3) 表示相对变换,令 T=T0exp(ξ)。对冻结 diffusion model 的 reconstruction loss 反传到 ξ,同时采用正反方向对称的约束,降低只解释单向生成的退化。
为降低局部最小值,优化从 reference view 周围的前、左、右、后四个 canonical pose T0 启动;还将 denoising timestep 从较粗到较细退火。这两个设计不是装饰:不同初始朝向对应明显不同的生成轨迹,直接从一个 T0 出发容易被对象对称性或弱重叠困住。
5.2 从已对齐的两张图到 target-specific generator
已得到 T^ 后,iFusion 不全量微调 Zero123,而是以 LoRA 只适配 attention 中的一小部分参数,并将多个已对齐视图以 stochastic multi-view conditioning 输入。这样生成器既保留预训练对象先验,也更忠于目标实例。最后,论文把生成视图或 SDS/reconstruction loss 输给不同 3D 后端;这部分刻意模块无关。
| 阶段 | 优化变量 | 冻结 / 使用条件 | 输出 |
|---|
| Pose inversion | ξ | Zero123 冻结,输入两张物体图 | T^r→q |
| Sparse-view fine-tuning | LoRA 参数 ϕ | 使用 T^ 与少量观测 | 更 identity-consistent 的 NVS generator |
| 3D reconstruction | 后端几何参数 | 使用生成视图或 SDS | 3D asset |
6. 实验分析
6.1 数据与评测协议
作者从 GSO、OO3D 各选 70 个对象,为 pose experiments 渲染每对象 5 视角,并在原文 §4.1 报告每数据集共 1400 views。三者不能按独立渲染帧直接相乘对应(70×5=350),因此 1400 仅作为原文报告值,具体采样 / 配对计数口径仍待核对,见原文 §4.1。重建实验从视差最大的两个视图起步。pose 以 rotation median、translation median 与同时满足 5° 的 recall 评估;NVS 用 PSNR、SSIM、LPIPS;3D reconstruction 用 Chamfer Distance、volumetric IoU。
这是一套受控 rendering protocol。它适合检验“相对 pose 是否可被 prior 反演”,但真实抓拍图的背景、曝光、物体遮挡、焦距不一致不在该主结果中。
6.2 主要结果
| 数据集 | iFusion rotation ↓ | translation ↓ | 5° recall ↑ | 对照观察 |
|---|
| GSO | 2.29 | 2.22 | 74.79 | RelPose++ 109.89 / 90.58 / 0.21;FORGE recall 0 |
| OO3D | 2.97 | 2.80 | 69.29 | RelPose++、FORGE 的 recall 都为 0 |
作者还报告 GSO 的 NVS 为 PSNR 18.73、SSIM 0.836、LPIPS 0.121;这些下游结果表明 pose inversion 并非只把数值 pose loss 压低,而确实帮助了视图合成。不过 NVS 仍会同时受 LoRA、生成模型和重建后端影响,不能把全部 gain 简化归因给 pose initializer。
6.3 消融与成本
- 四个 initial poses 的 pose recall 为 74.79,约 70.59 s;八个 initial poses 达到 78.21,但约 133.7 s。
- four-way initialization 的提升说明多模态相机解确实存在;运行时接近翻倍也说明该系统偏向资产离线制作。
- 作者采用 timestep annealing。合理解释是先利用 coarse denoising 的大 basin 找大致相机,再让细 timestep 修纹理对齐;论文展示其稳定性收益,但没有给出严格的 real-image calibration study。
7. 批判性分析与失败模式
作者主张与证据边界
- “强 diffusion prior 能在少视图下做 pose”:在合成 GSO / OO3D 的 Table 1 中被直接支持。
- “能带来更好的 3D reconstruction”:由 NVS、Chamfer、IoU 的后续实验支持,但结果也包含 backend 的贡献。
- “适用于 pose-free real captures”:这是合理方向,但本文主文的定量证据仍以 render protocol 为主;不可直接外推成随手拍即可 metric-accurate reconstruction。
可能失败处
- 同质纹理、近似旋转对称或两图 overlap 极小,可能产生多个等价视觉解释。
- 生成先验遇到域外对象时可能“补全”而非观测,导致 pose 与几何协同偏移。
- LoRA 与 reconstruction 都是 test-time process,累计时延和显存需要在真实应用中核算。
8. 对 pose 工作的启发
- 可以把生成式 rendering likelihood 当作 pose hypothesis verifier,而非把 diffusion 直接当最终几何真值。
- 有必要将 image prior 与显式的 epipolar、silhouette、known-calibration 或 3D consistency 约束组合,尤其是机器人抓取等要求 metric pose 的任务。
- 评测时应分别报告:相对相机 pose、生成质量、重建质量和真实物体 pose;不要让一个视觉分数替代全部结论。
