论文精读:IndustryShapes
1. 数据集想补哪一块空白
6D pose benchmark 的对象经常来自 household groceries、玩具或规则包装盒。工业装配中的 component / tool 却更常出现:
大面积无纹理金属或塑料;
镜面 / 半反光表面;
薄片、夹具与细长结构;
几何重复与旋转对称;
实际工位中的 tray、holder、多实例和遮挡;
新零件到站后,只能快速拍一段 onboarding video,不能重新训练大型实例网络。
IndustryShapes 选择 5 个工业相关对象,故意覆盖上述困难属性,并把 benchmark 分成 Classic 与 Extended :前者测已知实例训练 / 测试,后者测给定 CAD 或静态 onboarding sequence 的 novel / model-free pose estimation。
2. 五个对象与任务边界
论文没有用“大量类别”换规模,而是让每个对象代表一种 failure source:textureless、complex geometry、reflective surface、thin structure、symmetry。所有对象提供有尺度 CAD 和 photorealistic texture,可用于 rendering / synthetic augmentation。
这使 IndustryShapes 更像一个 curated stress test,而不是训练 foundation model 的大数据。对研究者而言,其价值在于逐对象分析“哪个几何 / 材质让方法失效”,不是依赖总体平均值。
3. Classic set
Classic 支持 instance-level pose estimator:
21 scenes:13 train,8 test;
训练:
1217 images / 4 lab scenes;
1122 images / 8 industrial scenes;
Object 3 的 1361 synthetic images;
合计 3700 frames;
测试:923 real industrial images;
总计 4623 images、约 6K annotated poses。
Classic 使用 Intel RealSense D455,640×480。对象—相机距离 200–1000 mm,多数在 400–800 mm,接近装配线机械臂常用工作距离。
训练数据多为单对象或较简单场景,测试包含遮挡、多对象、多实例、box / tray / holder 等布局。作者把这视为 generalization test,但这也意味着不同对象所经历的 train–test domain gap 不完全一致。
4. Extended set 与静态 onboarding
Extended 面向 model-based 和 model-free novel-object estimator:
10 条 static RGB-D onboarding sequences,每对象两条;
每条平均约 650 frames,总计约 6.3K;
3 个 test scenes,超过 2K images、约 10.3K annotated instances;
手持 RealSense D405,640×480,办公室环境、自然光照、distractors 与遮挡。
每个对象一条序列以自然 upright pose 放置,另一条改变 resting side 或翻转,以覆盖不同表面。所谓“static onboarding”指对象静止、相机环绕采集;这对 FoundationPose model-free 一类从视频建立 reference representation 的方法很实用。
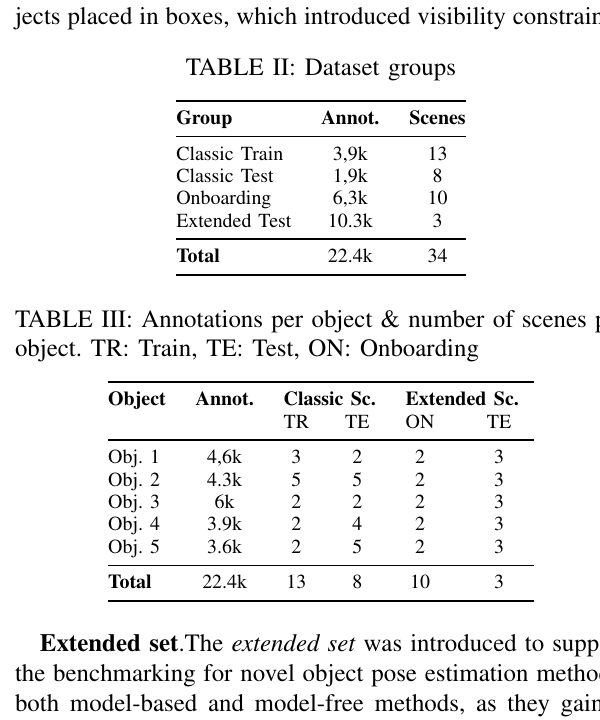
原论文 Tables II–III:Classic train/test、10 条 onboarding 与 Extended test 共 34 scenes、22.4K annotations;Object 3 数据量最多。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
两套数据合计:
Group annotations scenes Classic Train 3.9K 13 Classic Test 1.9K 8 Onboarding 6.3K 10 Extended Test 10.3K 3 Total 22.4K 34
注意,Extended Test 只有 3 个 physical scenes,却因五对象同场和密集视频产生 10.3K instances。不能把实例数直接视作环境独立性。
5. Pose / distance coverage
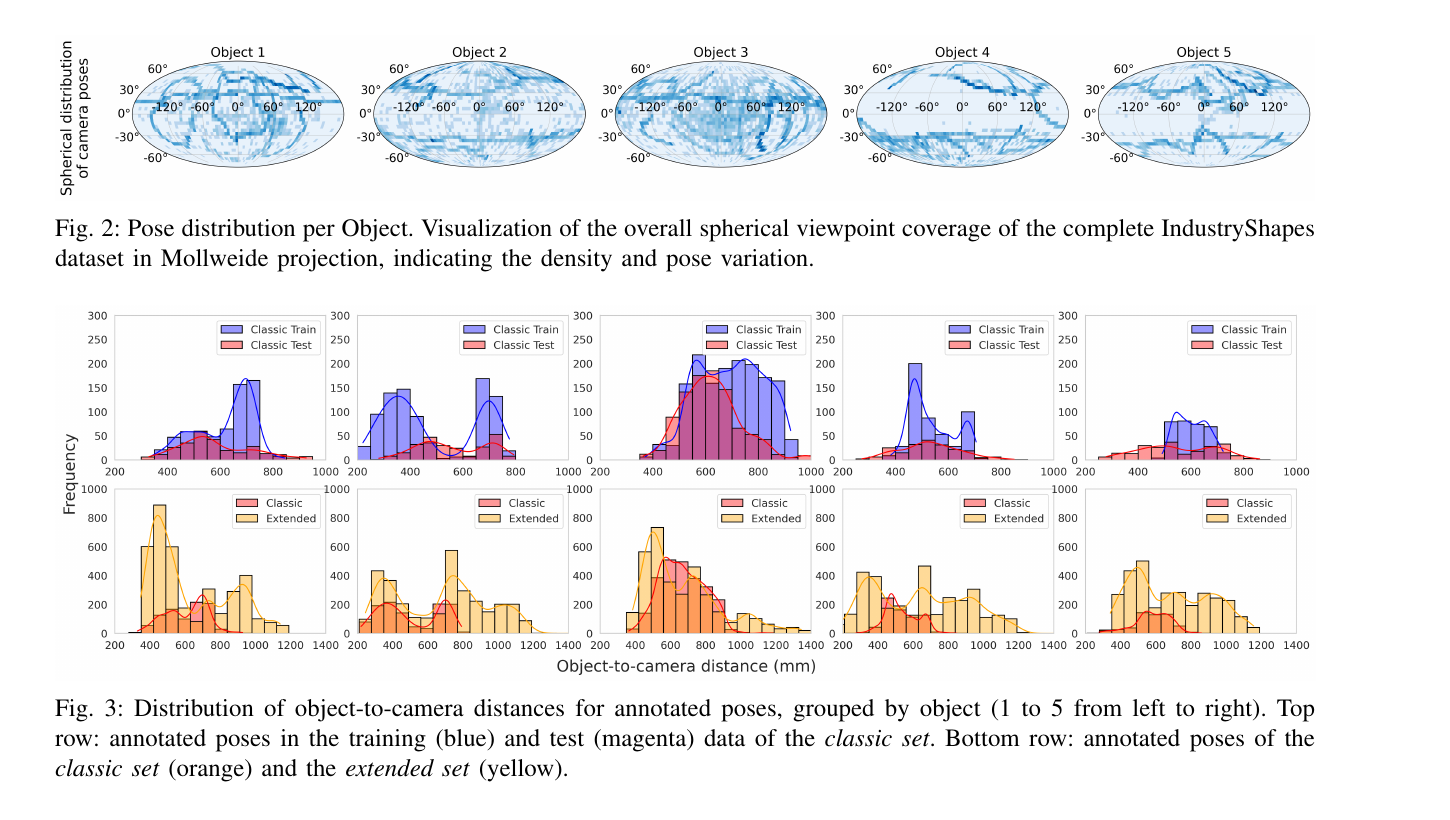
原论文 Figures 2–3:展示每对象 spherical viewpoint density,以及 Classic train/test、Classic/Extended 的 object-to-camera distance 分布。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
图中可以看到五对象的 spherical coverage 并不均匀,部分 object / orientation 受 resting pose、tray 与工位可见性限制。Extended 的手持 D405 带来更多近距离与更宽距离分布,但“帧多”仍可能集中在一条平滑 camera trajectory 上。
如果研究 pose distribution generalization,建议按球面 bin 或 viewpoint entropy 分层,不只报告随机帧平均。
6. 6D pose 标注
标注有两条路线:
6.1 Marker-based
实验室 turntable 数据以及工业现场可安装 marker 的场景,使用 ArUco estimate camera pose,再根据 object / marker calibration 得到 object pose。
6.2 SfM + 3D anchor + PnP
无法安装 marker 时:
使用 Agisoft Metashape 做 Structure-from-Motion,恢复 camera trajectory;
在 object CAD 上手工选已知 3D anchor points;
软件在图像序列中跟踪其 2D位置;
形成 2D–3D correspondences;
使用 PnP 求 object-to-camera pose。
这种方式比逐帧手工对齐省力,但质量依赖 SfM 在 textureless industrial environment 中是否稳定,也依赖少量 anchor 的几何分布。
7. 深度一致性与论文内部口径
作者通过 captured depth d c d_c d c d r d_r d r
δ = d c − d r . \delta=d_c-d_r. δ = d c − d r .
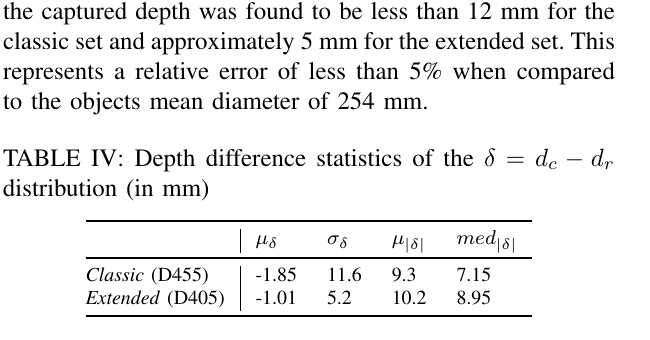
原论文 Table IV:Classic / Extended 的 mean absolute depth difference 分别为 9.3 / 10.2 mm;标准差为 11.6 / 5.2 mm。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
Split mean signed std mean absolute median absolute Classic D455 -1.85 mm 11.6 mm 9.3 mm 7.15 mm Extended D405 -1.01 mm 5.2 mm 10.2 mm 8.95 mm
正文随后写“absolute depth error <12 mm for Classic and approximately 5 mm for Extended”。其中 Extended 的“约 5 mm”与 Table IV 的 mean absolute 10.2 mm 不一致,更像误把 standard deviation 5.2 mm 当作 absolute error。本站采用表格列名对应的数值,并把该不一致作为数据文档需要澄清的地方。
此外,depth residual 同样混合了 pose、CAD、sensor、mask 与边界误差,不等于纯 translation error。
8. 评测协议
论文同时使用:
ADD:模型点在预测 / GT pose 下的平均距离;
VSD:只比较可见表面的 rendering discrepancy;
MSSD:考虑 symmetry 的最大表面距离;
MSPD:考虑 symmetry 的最大投影距离;
BOP AR:
A R = 1 3 ( A R VSD + A R MSSD + A R MSPD ) . AR=\frac{1}{3}(AR_{\text{VSD}}+AR_{\text{MSSD}}+AR_{\text{MSPD}}). A R = 3 1 ( A R VSD + A R MSSD + A R MSPD ) . ADD 未显式 symmetry-aware,适合作为直观补充;BOP AR 更能公平处理 Object 5 一类对称 / 近对称几何。
9. Baselines
Instance-level
Novel-object
FoundPose;
FoundationPose model-based(MB,给 CAD);
FoundationPose model-free(MF,使用 onboarding video)。
Detection / segmentation
论文没有覆盖所有 contemporary methods,例如 Gen6D / OnePose++,理由包括适配成本、平台限制和 per-object training time。因此 benchmark 是一组参考线,不是完整 leaderboard。
10. 总体 pose 结果
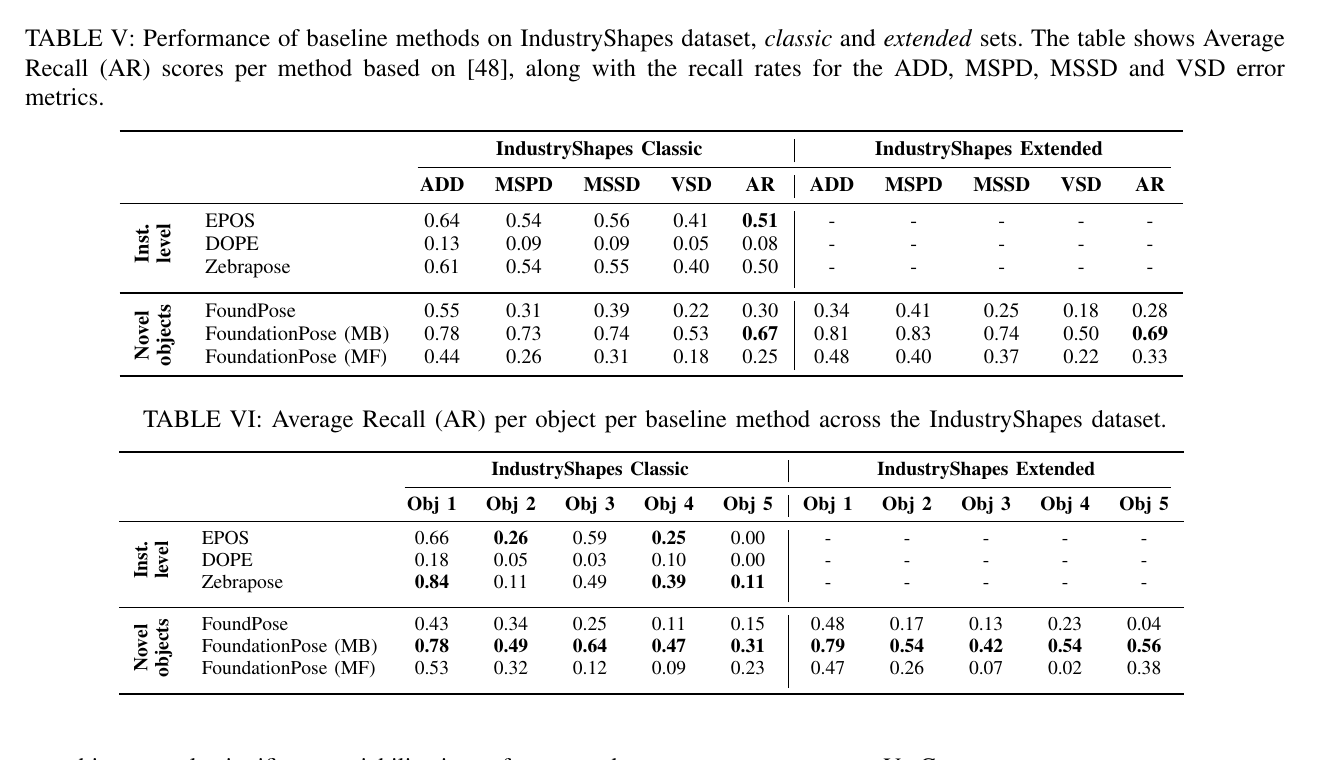
原论文 Tables V–VI:FoundationPose model-based 在 Classic / Extended 均最高;model-free 明显下降,且 Object 5 等对象形成稳定困难项。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
Classic
方法 ADD MSPD MSSD VSD AR EPOS 0.64 0.54 0.56 0.41 0.51 DOPE 0.13 0.09 0.09 0.05 0.08 ZebraPose 0.61 0.54 0.55 0.40 0.50 FoundPose 0.55 0.31 0.39 0.22 0.30 FoundationPose MB 0.78 0.73 0.74 0.53 0.67 FoundationPose MF 0.44 0.26 0.31 0.18 0.25
Extended
方法 ADD MSPD MSSD VSD AR FoundPose 0.34 0.41 0.25 0.18 0.28 FoundationPose MB 0.81 0.83 0.74 0.50 0.69 FoundationPose MF 0.48 0.40 0.37 0.22 0.33
两个结论很清楚:
给 CAD 的 FoundationPose MB 大幅领先 static onboarding 的 MF;仅靠 10 条视频建立对象表示还没有追平准确 model;
Extended 并非所有指标都更难。它的 office scenes 虽有 distractor / occlusion,但手持近距离、D405 和对象呈现方式与 Classic 工位不同,因此不能把两列看成同分布难度递增。
11. 逐对象结果
FoundationPose MB 的 AR:
Split Obj.1 Obj.2 Obj.3 Obj.4 Obj.5 Classic 0.78 0.49 0.64 0.47 0.31 Extended 0.79 0.54 0.42 0.54 0.56
Object 5 是反光、薄结构对象,在 Classic 中最难。FoundPose Extended Object 5 仅 0.04 AR,而 FoundationPose MB 为 0.56,显示 accurate CAD render / refine 对该物体非常关键。
逐对象差异也暴露训练条件混杂:Object 3 有额外 1361 synthetic training images,某些对象在 train scene 中已有 clutter,另一些主要是简单背景。若只报告总体 AR,会把“方法能力”和“对象所获训练覆盖”混合。
12. Detection / segmentation
论文 Table VII:
方法 BBox Classic BBox Extended Segm Classic Segm Extended CNOS 0.240 0.574 0.203 0.512 SAM6D 0.270 0.527 0.345 0.453
Extended 的 mAP 反而普遍高于 Classic,可能因为 office scene 虽 cluttered,但 viewpoint / object scale / mask visibility 更有利。这个结果提醒 pose failure 不能全归因于 detector;应分别报告 GT mask、predicted mask 和 full pipeline。
13. 主要局限
对象只有 5 个。 适合深入失败分析,不支持广泛类别统计结论。场景只有 34 个。 Extended Test 尤其只有 3 个 physical scenes,frame correlation 高。数据量不均衡。 Object 3 有 synthetic augmentation;逐对象 train/test scene 数也不同。train/test 复杂度混杂。 部分对象训练于 cluttered industrial scene,部分主要来自 lab single-object。标注质量文字与表格不一致。 Extended 的 5.2 与 10.2 mm 口径需修订。model-free benchmark 仍有限。 只有 FoundationPose MF 作为主要静态 onboarding baseline,尚不足以比较不同序列建模路线。材质传感问题。 反光 / 薄结构的 depth missing 与 pose error 相互耦合,单一 depth residual 无法拆解。
14. 推荐怎样使用
将其作为 T-LESS、ITODD、IPD 等工业 benchmark 的补充;
同时报告 overall、per-object 与 per-scene;
明确使用 Classic 训练、Extended onboarding 还是 CAD model;
分离 detection / segmentation 与 pose refinement;
frame split 改为 scene split;
对 Object 5 单独报告 symmetry-aware metric、depth validity 与 failure visualization;
引用 annotation quality 时采用 Table IV 明确列值,并说明正文口径差异。
15. 总体判断
IndustryShapes 的规模不追求“大”,而是把已知实例与 static onboarding、实验室与工业工位、CAD-based 与 model-free 放到一个 BOP-compatible package 里。它最适合回答:
一个在 household benchmark 上表现很好的 6D pose 系统,遇到反光薄结构工业件、单对象训练到 clutter test、或只给短 onboarding video 时,还剩多少能力?
FoundationPose MB 的 0.67 / 0.69 AR 给出较强参考线;MF 的 0.25 / 0.33 与 Object 5 的显著下降则说明,工业 novel-object pose 仍远未解决。