论文精读笔记:KeyPose: Category-Level 6D Object Pose Estimation with Self-Adaptive Keypoints
1. 基本信息
- 作者 / 机构:Sheng Yu、Di-Hua Zhai、Yuanqing Xia;北京理工大学、中原工学院。
- 年份 / 会议:2025 / AAAI。
- 论文页 · 官方 PDF
- 阅读模式:精读。
2. 一句话定位
KeyPose 属于 RGB-D 类别级 pose 的结构化路线:不再坚持固定 canonical keypoint,而是让 keypoint 依据当前对象点云自适应,再显式建模 keypoint 与局部几何之间的关系。
2.1 论文图表导读
| 图表 | 阅读重点 |
|---|
| Figure 2 | 先确认输入包含 RGB、depth、mask;方法不是 RGB-only |
| Table 1–2 | CAMERA25 / REAL275 与 HouseCat6D 的不同分布,避免只看一个合成基准 |
| Table 3 | keypoint detection、图聚合、voxelization 对最终 fitting 的贡献 |
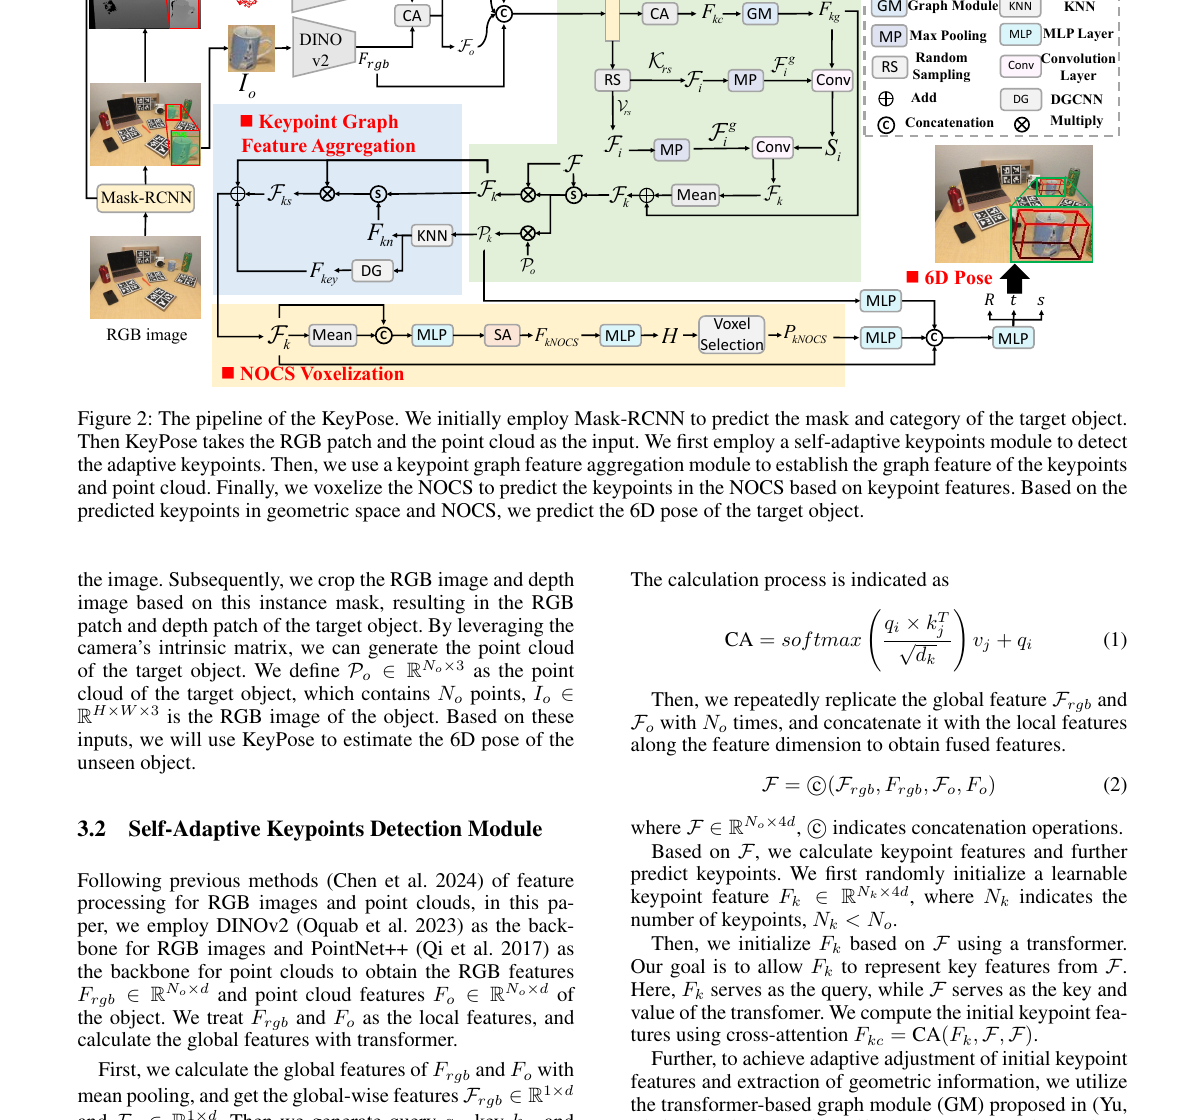 原论文 Figure 2 所在页面局部:KeyPose 的 RGB-D、关键点与图聚合流程。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
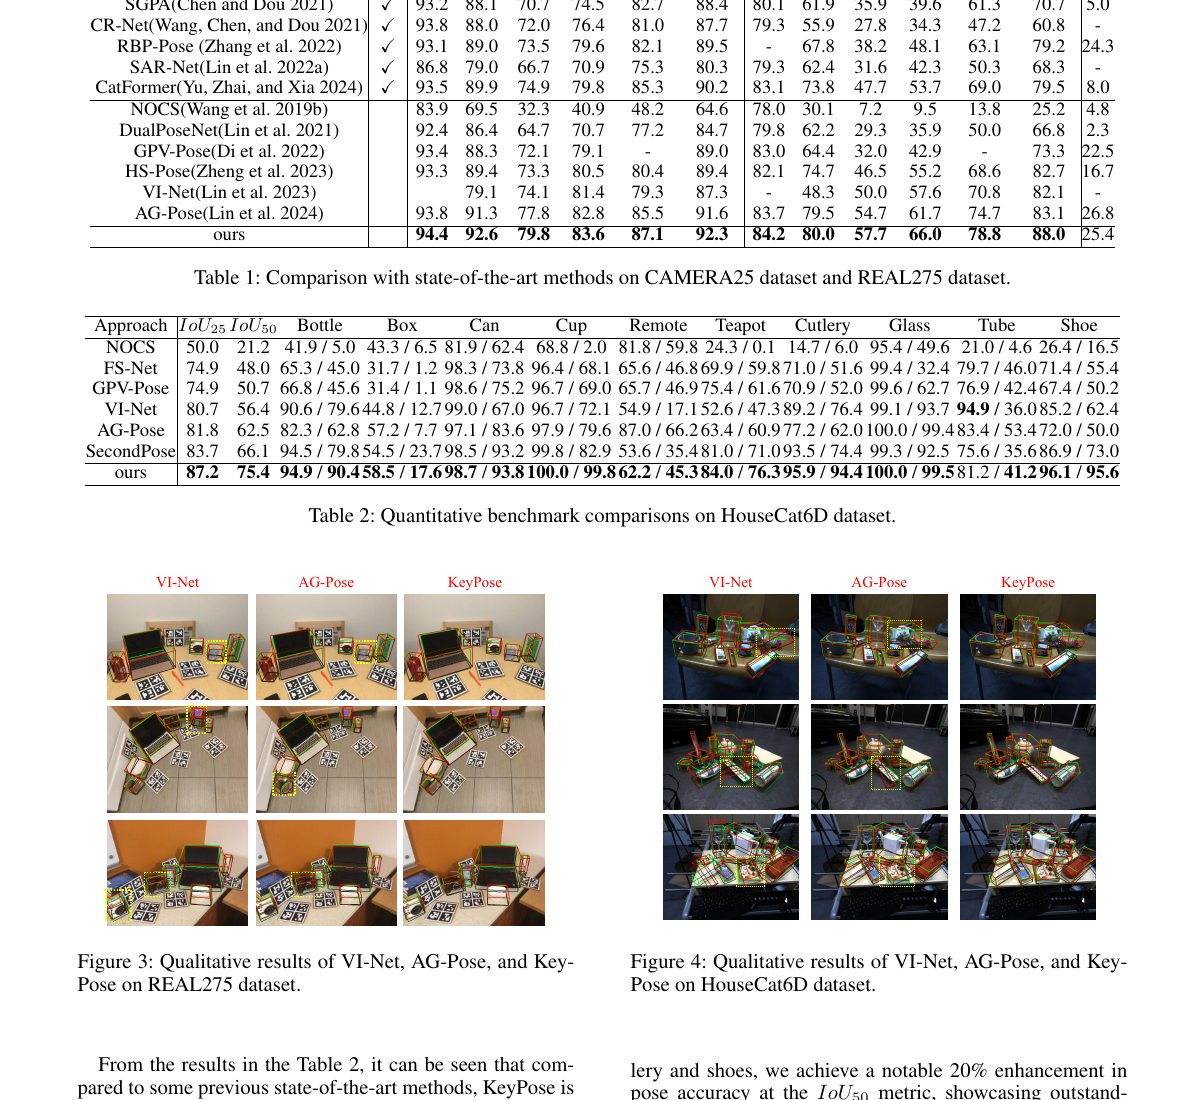 原论文定性实验页面局部:与 VI-Net、AG-Pose 的对比。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 任务与动机
- 类别内对象的局部形状和可见表面差别很大,固定 semantic keypoint 容易落在无意义或不可见的位置。
- 仅从点云或仅从 RGB 做 pose fitting 都会遗漏另一侧信息;论文选择在 keypoint 层进行 cross-modal、结构化融合。
- 输入需要检测 / 分割、深度和类别标签,输出面向已知类别内的未见实例,并非新类别 zero-shot。
4. Pipeline
- Mask R-CNN 预测 target mask 与类别,RGB 和 object point cloud 分支提取外观 / 几何特征。
- Keypoint Detection Module 根据实例几何预测 self-adaptive keypoints,而不是套用一组不变模板点。
- Graph Feature Aggregation 同时在 keypoint-to-keypoint、keypoint-to-cloud 关系上聚合,约束局部与全局结构。
- NOCS voxelization 把 canonical keypoint 预测离散化为更精细的空间定位,最终得到用于 pose fitting 的对应。
这里的真正创新不是“用了 keypoint”,而是把 keypoint 从类别定义的点转为实例条件化的几何锚点。这会提高类别内适配性,但其可解释性也取决于这些自适应点在不同实例间是否能保持足够一致的 canonical 对应。
5. 实验解读
| 基准 | 论文报告结果 | 解读 |
|---|
| CAMERA25 / REAL275 | 表 1 的总体 mAP 为 94.4 / 92.6(3D IoU 对应列) | 合成到真实的差距仍存在,不能只用 CAMERA25 判断泛化 |
| HouseCat6D | IoU25 87.2,IoU50 75.4 | 面对更广的家居类别,严格 IoU50 更值得关注 |
| HouseCat6D glass | 100.0 / 99.5(IoU25 / IoU50) | 透明物体的数字很高,但应结合类别样本量与 mask 质量理解 |
论文的讨论特别指出 cutlery、shoe 等在严格指标上改善明显;这符合其“自适应锚点处理细长 / 非均质结构”的动机。主表未把运行时间与不同 detector quality 的影响放在同等位置,是工程复现时需要补测的部分。
6. 批判性总结
优点:关键点、图关系与 canonical 空间各有清楚职责;同时覆盖 NOCS 与 HouseCat6D;对类别内变化的建模直觉强。
局限:深度、mask、类别预测是关键前置条件;动态关键点的跨实例一致性没有被单独作为可观测量报告;只要前端点云受遮挡或反光污染,图聚合也会传播错误。
启发:可把自适应 keypoint 的 confidence 显式传给 RANSAC / weighted fitting;对 foundation-feature pose,也可用“实例条件化锚点 + 几何置信度”替代全局 dense correspondence。
