论文精读笔记:LaPose
1. 核心判断
LaPose 把 RGB-only category pose 的两个问题拆开:
- shape ambiguity:同一像素的 NOCS 不应总是 deterministic point,用预测方差表达哪些对应不可信;
- metric scale ambiguity:同样成像大小可来自近处小物体或远处大物体,不让这个不可观测量的梯度污染 rotation / normalized translation。
真正有效的组合是“dual-stream supervised uncertainty + learned PnP + scale normalization”。DINOv2 单独并不强:其 NIoU50 只有 26.9,低于 ConvNet 的 39.7;通用 feature 必须与 NOCS 类别监督融合。
2. 输入、输出与监督
LaPose 对 NOCS 六类做 category-level 9DoF:
(R,t,s),R∈SO(3),t∈R3,s∈R3.
输入是 RGB crop、Mask R-CNN detection 与 intrinsics。训练监督包括:
- visible mask;
- per-pixel GT NOCS map;
- GT rotation / translation / metric size;
- category average normalized size。
因此它是监督式 category pose,不是只靠冻结 DINOv2 zero-shot。REAL275 实验按 NOCS 协议同时使用 CAMERA25 与 REAL train;不是 synthetic-only sim-to-real。
3. 双分支 Laplacian mixture
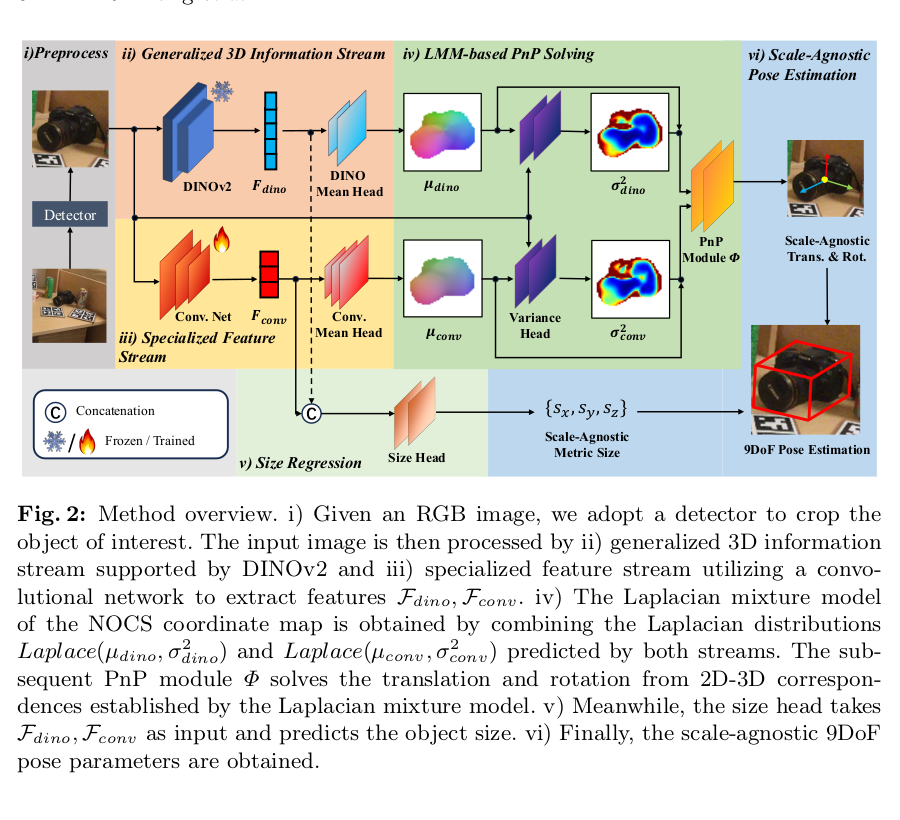 原论文 Figure 2。蓝色 DINOv2 冻结,橙色卷积分支与各 prediction heads 可训练;两者不是 feature-level concat 后只预测一张 NOCS,而是各自形成一套 Laplace 参数。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
DINOv2 被视作 generalized 3D information stream,提供跨实例、跨姿态较一致的 patch semantics;ConvNet 则专门学习 NOCS 六类的局部形状 convention。
每个 stream 对每个可见像素预测 NOCS mean μ 与 variance σ2,使用 Laplace aleatoric loss:
L3D=σ2λ∥Mvis⊙(Cgt3D−μ)∥1+Mvis⊙logσ2.
当 residual 大,增大 variance 可降低第一项;但 log term 防止 variance 无界增长。论文称方差“self-supervised”,更准确的说法是 无 variance label 的 supervised heteroscedastic learning:它仍依赖 GT NOCS residual。
两套 distributions 构成 LMM,但论文没有学习 mixture weights,也没有在 inference 时显式 sampling / marginalization。实际 solver 直接接收:
(μdino,σdino2,μconv,σconv2,C2D).
所以 LMM 更像两位异方差专家的参数化证据,而不是完整求解可解释 mixture posterior。
4. “PnP”实际上是 learned approximation
理论目标写成 NOCS distribution 下的期望 L1 reprojection:
P∗=argP∈SE(3)minN1i∑Exi∼ηi∥π(KPxi)−ui∥1.
作者认为直接优化困难,于是采用类似 prior work 的 convolutional network Φ:
(Rout,tout)=Φ(μd,σd2,μc,σc2,C2D).
它没有在推理时运行 EPnP / RANSAC,也没有显式最小化上式;“LMM-based PnP”应理解为被对应分布条件化的 pose regression network。优势是端到端和快速,代价是:
- 不保证几何最优 / projection consistency;
- solver 可能利用 category appearance shortcut;
- 换相机、crop convention 或类别时需重训;
- predicted variance 是否真以 inverse-uncertainty weighting 起作用,只能靠消融和可视化间接判断。
Rotation 预测矩阵前两列 rx,ry,再正交化;bowl / can 等轴对称类别只监督 ry,避免对不可辨 yaw 强行单值回归。
5. Scale-Agnostic Pose
设真实 3D box size 为 s=(sx,sy,sz),对角线:
d=sx2+sy2+sz2.
LaPose 使用:
snorm=s/d,tnorm=t/d.
size head 回归 snorm−savg。Translation 又分为 projected center (ox,oy) 与 normalized depth tz/d,并转为与检测 crop 平移 / 尺度相对不变的 (δx,δy,δz),最后用 intrinsics back-project。
这种表示让相同图像的“近小 / 远大”案例得到同一个 normalized answer,训练目标可辨;但机器人需要 metric translation 时,仍必须预测 d。论文另训 MobileNet 猜 box diagonal,再:
t=dtnorm,s=dsnorm.
所以 SAP 是良好的 factorization,不是解决单目尺度的物理信息。Normalized 指标测 shape ratio / orientation / relative translation,absolute 指标才测系统真正 metric 输出。
6. REAL275 主结果
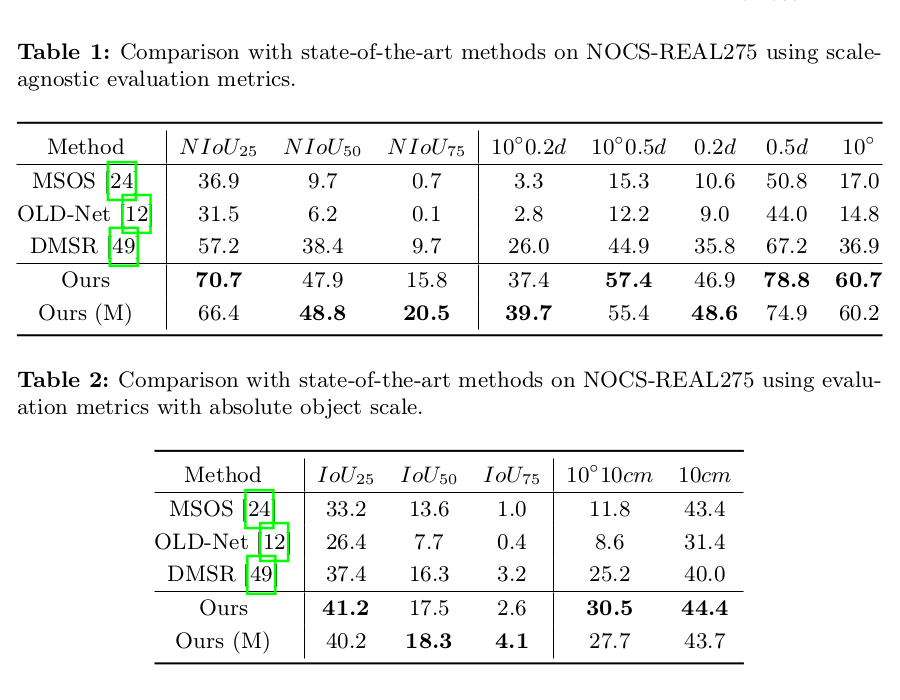 原论文 Table 1–2。Ours 是六类共享单模型,Ours (M) 是每类单独训练;比较时不能只从两行分别挑最优数字而忽略模型容量差异。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
Scale-agnostic:
| 方法 | NIoU25 | NIoU50 | NIoU75 | 10°0.2d | 10°0.5d | 10° |
|---|
| DMSR | 57.2 | 38.4 | 9.7 | 26.0 | 44.9 | 36.9 |
| LaPose | 70.7 | 47.9 | 15.8 | 37.4 | 57.4 | 60.7 |
| LaPose (M) | 66.4 | 48.8 | 20.5 | 39.7 | 55.4 | 60.2 |
单模型在 NIoU25 / 10°0.5d 比 DMSR +13.5 / +12.5 points;per-category model 在严格 NIoU75 +10.8。LaPose rotation-only 10° 从 36.9 提到 60.7,是最明显增益。
Absolute-scale:
| 方法 | IoU25 | IoU50 | IoU75 | 10°10cm | 10cm |
|---|
| DMSR | 37.4 | 16.3 | 3.2 | 25.2 | 40.0 |
| LaPose | 41.2 | 17.5 | 2.6 | 30.5 | 44.4 |
| LaPose (M) | 40.2 | 18.3 | 4.1 | 27.7 | 43.7 |
绝对尺度优势明显缩小,且单模型 IoU75 低于 DMSR。这准确反映独立 diagonal predictor 仍是 bottleneck。论文重新用修正后的 NOCS evaluation script 计算所有 baseline;这些数值也不宜与未修正脚本的旧论文表直接拼接。
7. 不确定性是否有校准证据
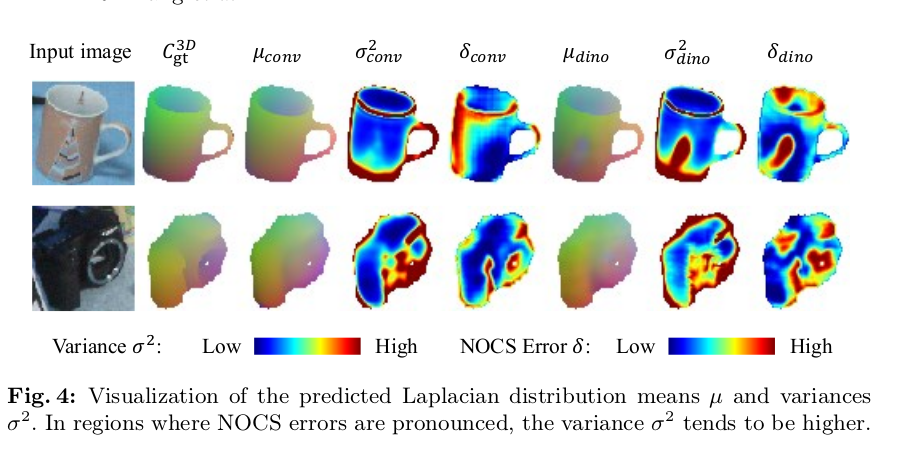 原论文 Figure 4:camera 镜头、mug handle 等难推断区域往往同时出现高 NOCS residual 与高 variance,支持方差作为局部错误提示。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
可视化说明 variance 与 error 在空间上相关,但论文没有报告:
- NLL;
- expected calibration error;
- sparsification / risk-coverage curve;
- 方差分位与 NOCS error 的定量相关;
- OOD / detection error 下 calibration。
因此可以说 variance 对 pose 有用,不能进一步断言它是概率校准良好的 uncertainty。
8. 消融拆解
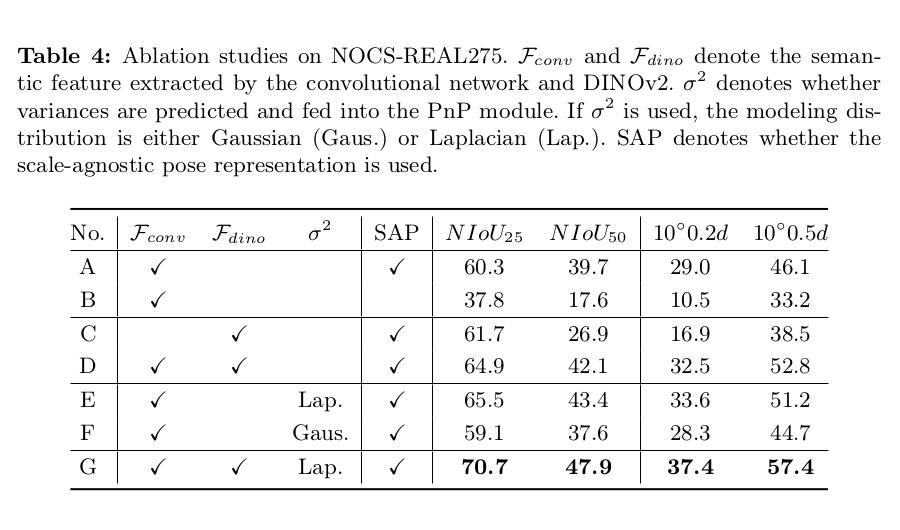 原论文 Table 4:SAP、双分支与 Laplace variance 都有独立收益;Gaussian uncertainty 反而低于 deterministic ConvNet。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
| 配置 | NIoU25 | NIoU50 | 10°0.2d | 10°0.5d |
|---|
| Conv + SAP | 60.3 | 39.7 | 29.0 | 46.1 |
| Conv,无 SAP | 37.8 | 17.6 | 10.5 | 33.2 |
| DINO + SAP | 61.7 | 26.9 | 16.9 | 38.5 |
| Conv + DINO + SAP | 64.9 | 42.1 | 32.5 | 52.8 |
| Conv + Laplace + SAP | 65.5 | 43.4 | 33.6 | 51.2 |
| Conv + Gaussian + SAP | 59.1 | 37.6 | 28.3 | 44.7 |
| Dual-stream LMM + SAP | 70.7 | 47.9 | 37.4 | 57.4 |
SAP 是最大单项变化,但它同时改变 target parameterization 与评测空间;不能把 +22.5 NIoU25 全解释为网络能力。
Dual deterministic 比 Conv-only +4.6 NIoU25 / +6.7 10°0.5d;加入 dual Laplace 再 +5.8 / +4.6。Gaussian 的负效果说明“加 uncertainty head”不自动有效,heavy-tail Laplace 与 L1 NOCS residual 更匹配。
9. 局限与容易误读之处
- scale-agnostic metric 主动移除 metric-scale error,不等于完整 9DoF;
- absolute scale 仍由单目 MobileNet appearance prior 估计;
- learned PnP 没有解析几何保证,也不是 RANSAC-PnP;
- 方差由 GT NOCS residual 监督,不是无监督 uncertainty;
- 只有六个 NOCS 类别,且 REAL275 test 仅 2.7K images;
- REAL275 训练使用真实 train + CAMERA,不是 zero-shot real transfer;
- detector 由外部 Mask R-CNN / prior detections 提供;
- symmetry 采用类级轴约定,未覆盖实例纹理破坏几何对称;
- 约 10 FPS 没有端到端模块分解;
- multi-model 行每类独立网络,容量 / 部署代价高于单模型。
10. 复现检查表
- 使用作者修正后的 NOCS evaluator;
- 单模型与 per-category model 分开报告;
- 明确 CAMERA-only 与 CAMERA+REAL training protocol;
- 使用同一 external detection results;
- DINOv2 frozen 与 ConvNet trainable 状态固定;
- visible mask 内分别训练两套 μ,σ2;
- 把 learned PnP 与解析 EPnP / uncertainty-weighted RANSAC 做对照;
- normalized 与 absolute metrics 成对报告;
- 单独评估 diagonal d 的 relative error;
- 对 uncertainty 增加 calibration / risk-coverage;
- runtime 包含 detector、DINO、PnP 和 MobileNet scale head。
11. 最终评价
LaPose 对 RGB-only category pose 做了合理的统计与几何分解:不强迫所有 NOCS pixels 同样可靠,也不让本质不可观测的绝对尺度主导 pose training。其 REAL275 normalized rotation 与 joint thresholds 提升明显,双分支 Laplace 消融也相对完整。
最重要的阅读边界是:LMM 最终由 learned network 消化而非显式概率 PnP,SAP 则把 metric scale 转交给独立网络。它解决的是更稳定地学习“除尺度外的 pose”,而不是从单张 RGB 恢复唯一真实大小。把 normalized / absolute 两组表一起看,才能准确评价这篇论文。
