论文精读笔记:MegaPose: 6D Pose Estimation of Novel Objects via Render & Compare
1. 基本信息
方法:MegaPose
作者:Yann Labbé、Lucas Manuelli、Arsalan Mousavian、Stephen Tyree、Stan Birchfield、Jonathan Tremblay、Justin Carpentier、Mathieu Aubry、Dieter Fox、Josef Sivic
机构:ENS / Inria、NVIDIA、LIGM / Ecole des Ponts、University of Washington、CIIRC CTU
年份 / 会议:2022 / CoRL
论文:arXiv:2212.06870
PDF:arXiv PDF
项目:MegaPose
代码:megapose6d/megapose6d
阅读模式:精读
2. 一句话定位
MegaPose 通过“候选 CAD rendering 与真实观测是否匹配、且是否可被局部 refiner 纠正”这一统一接口,把 shape、texture、object coordinate system 和 metric scale 都作为 test-time visual evidence 输入共享网络;因此同一 coarse scorer 与 iterative refiner 可在不针对目标实例重训的前提下估计任意已知 CAD 新对象的 6D pose。
方法输入与输出
项目 内容(本站整理) 推理输入 观测 RGB、内参、目标 CAD 和 bbox / ROI;可选观测 depth。coarse 阶段比较候选 renderings,refiner 比较观测与当前候选周围的多视角 RGB / normal 等渲染。 最终输出 精修后的物体到相机变换 T C O ∈ S E ( 3 ) T_{CO}\in SE(3) T C O ∈ S E ( 3 ) 训练输入 大量训练对象 CAD 渲染的合成观测、GT pose、候选或扰动 pose,以及相应渲染;RGB-D 训练配置还读取深度。 训练目标 coarse network 判断候选是否可被 refiner 修正;refiner 预测旋转更新与图像平面位移 / 相对深度更新,再恢复新 pose。 输出细节 T C O T_{CO} T C O 3 × 3 3\times3 3 × 3 4 × 4 4\times4 4 × 4 x C = R C O x O + t C O x_C=R_{CO}x_O+t_{CO} x C = R C O x O + t C O 必要条件 目标实例可以未见,但 CAD、标定、ROI 和 renderer 必需;核心算法不要求目标 mask 或真实多视角参考图。新对象不微调 pose 网络,不代表 detector 也自动 zero-shot。
2.1 论文图表导读
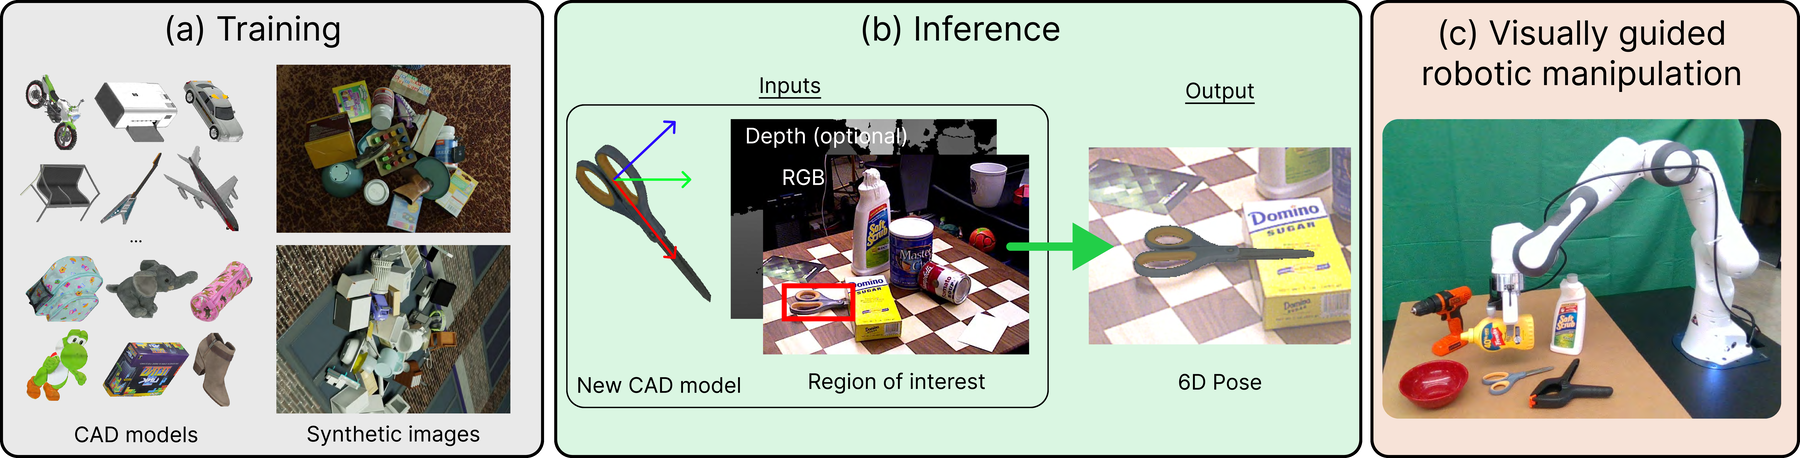
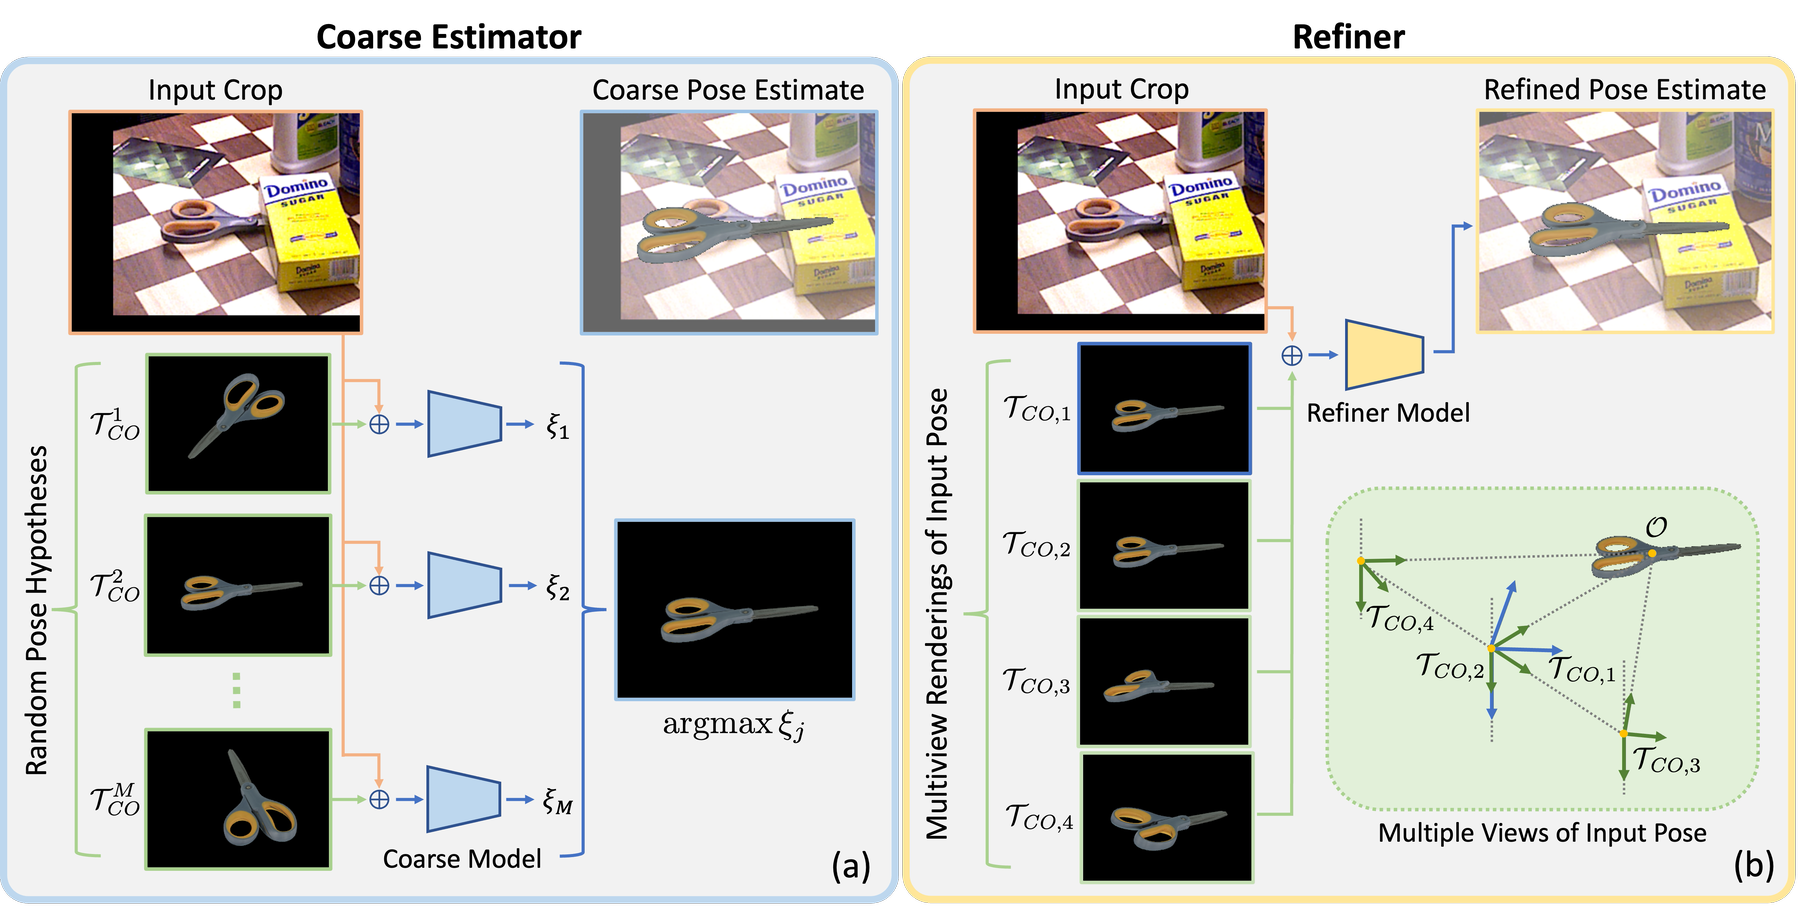
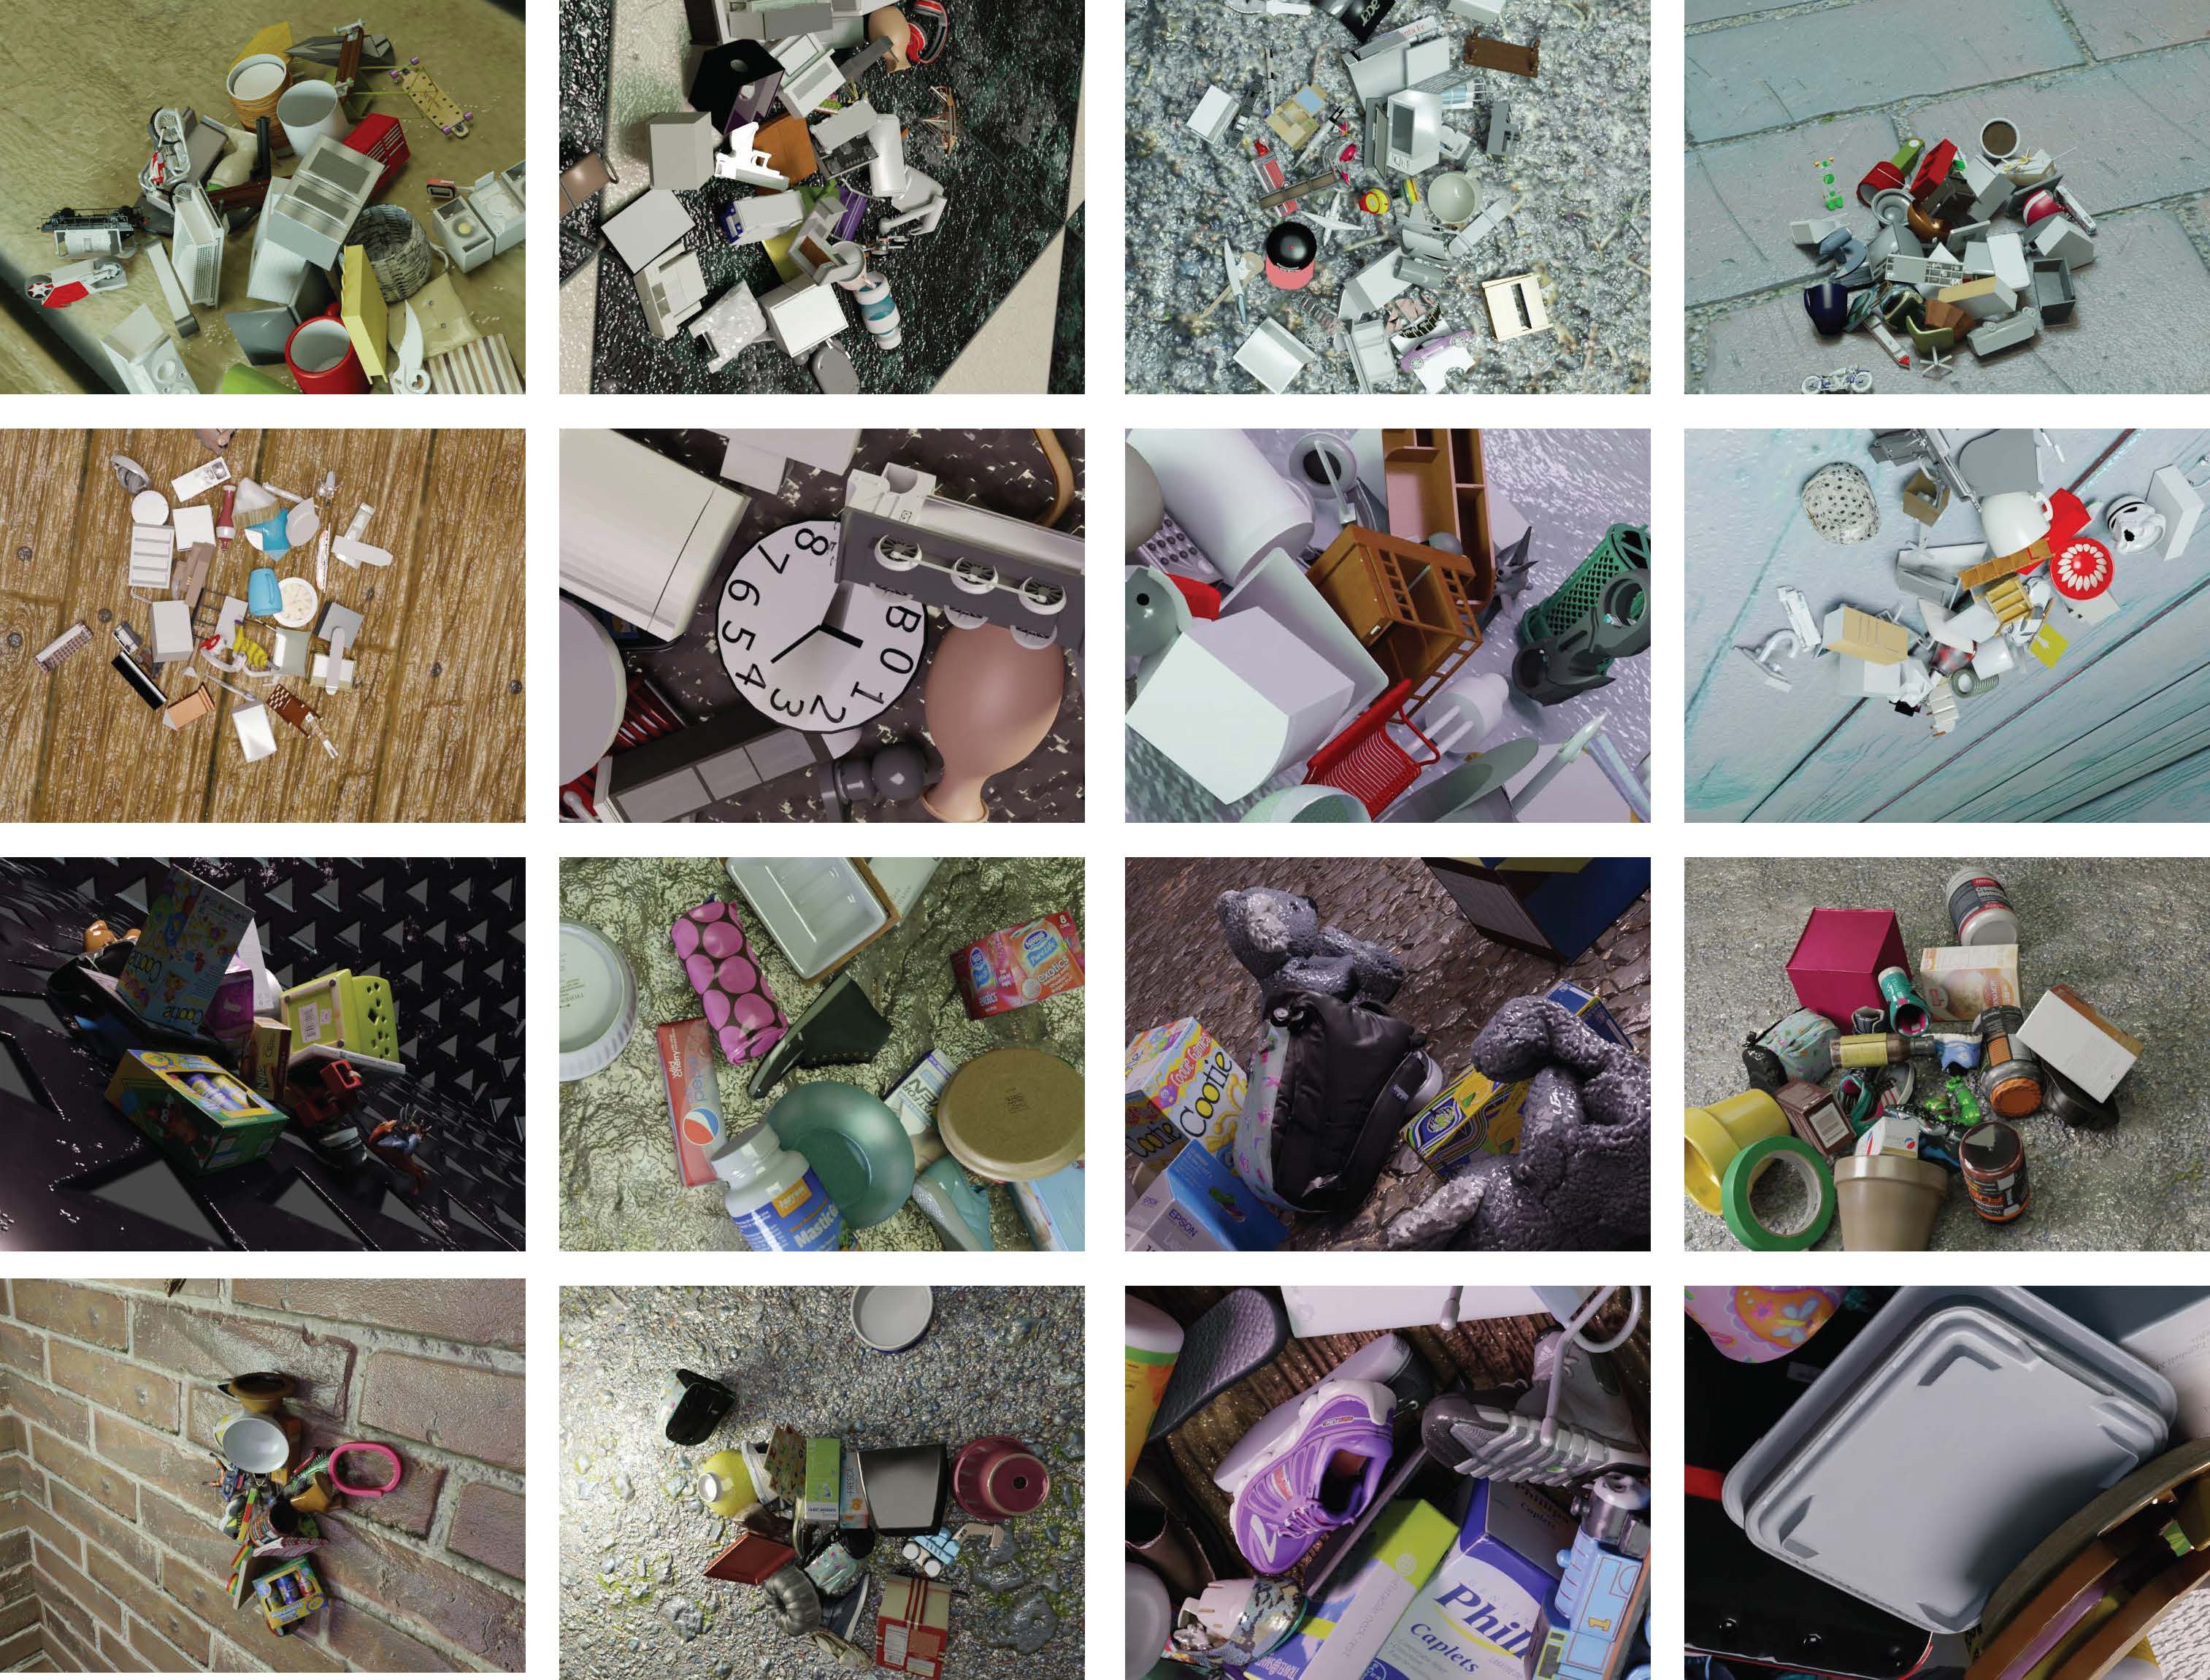
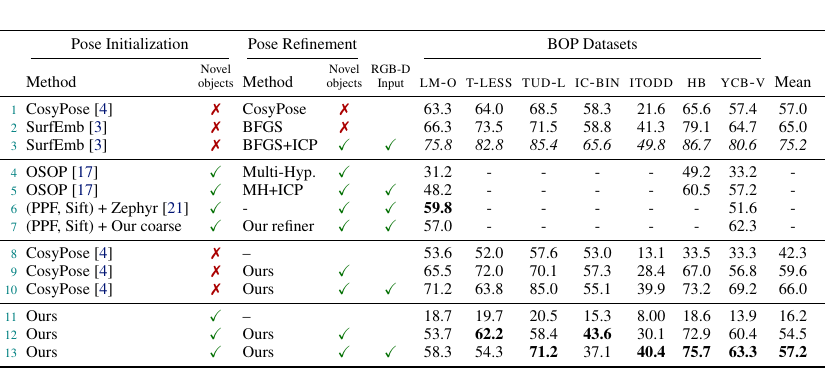
图表 内容 阅读重点 Figure 1 从合成训练到 novel-object inference “novel”发生在 pose network 的训练对象集合,不代表无 CAD 或无 detector Figure 2 coarse 与 refinement 架构 coarse 预测候选可修正性;四个 renderings 为 refiner 编码 anchor point 与对象几何 Figure 4 BlenderProc 合成训练图 sim-to-real 依靠对象数量、真实扫描纹理、物理摆放与强 augmentation 共同实现 Table 1 BOP 七数据集主结果 需同时比较 novel-object、RGB/RGB-D、初始化来源和 detector 协议 Table 2 ModelNet refiner 仅测试局部 refinement,不应与完整 coarse + refiner 成功率混读 Figure 3 coarse / refined 定性结果 多次 refinement 能显著收紧轮廓,但效果依赖 coarse 落入收敛域 Table 3 结构与数据消融 4 views、normal maps 和大规模 CAD diversity 都是关键变量 Figure 7 失败案例 图像轮廓匹配不是 pose 正确的充分条件
原论文 Figure 1:共享网络在大量合成对象上训练,推理时由新对象 CAD 和目标 ROI 提供实例信息;depth 为可选输入。来源:官方项目页 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
原论文 Figure 2:coarse network 对候选 rendering 打分;refiner 使用当前 pose 和三个附加视角的 rendering,与观测 crop 一起预测新的 6D pose。四个虚拟相机均指向对象 anchor point。来源:官方项目页 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
目标是预测对象坐标系 O O O C C C
T C O = [ R C O t C O 0 1 ] ∈ S E ( 3 ) . T_{CO} =
\begin{bmatrix}
R_{CO} & t_{CO}\\
0 & 1
\end{bmatrix}\in SE(3). T C O = [ R C O 0 t C O 1 ] ∈ S E ( 3 ) . 推理输入
输入 是否必需 用途 RGB image 是 与 CAD renderings 做外观 / 几何比较 camera intrinsics 是 crop 虚拟相机、投影、由 bbox 估计初始 translation object CAD / mesh 是 定义对象坐标、metric scale、shape、texture 和 renderer object bbox / ROI 是 指定对象位置并初始化候选平移 depth 否 拼接 RGB-D refiner,增强几何与尺度约束 object mask 否 论文核心输入不是 mask;detector 可只给 bbox
Novel-object 的准确含义
目标实例与目标类别都可以在训练时未见。
测试时已知“这是哪个对象”,并有该实例 CAD。
coarse / refiner 权重不对目标对象 fine-tune。
不是 category-level pose,也不是无模型、one-reference 或 open-vocabulary detection。
检测协议
论文明确把 novel-object detection 排除在范围外。完整 BOP 实验使用官方提供的 Mask R-CNN detections,这些 detector 针对每个 BOP 数据集、由目标对象的 PBR synthetic data 训练。因而:
作者声称 :MegaPose pose estimator 对目标对象是 novel-object。我的分析 :BOP 表中的完整系统并不是 detection + pose 全链路 zero-shot;真正部署新 CAD 时还需模板检测、zero-shot detector、人工 ROI 或其他前端。
4. 研究脉络与核心切口
DeepIM、CosyPose 等 render-and-compare 方法能迭代精修,但网络训练与测试围绕同一批对象;对象的形状、纹理、坐标系甚至 anchor point 可被隐式记入权重。换成训练未见 CAD 后,单张 rendering 不足以告诉网络完整 3D 几何和坐标定义。
MegaPose 的切口有三层:
用多个 CAD views 显式提供 object-specific geometry;
把 coarse pose 从直接 regression 改成 candidate classification;
用 2M synthetic images、超过 20K CAD 学习跨对象的共享比较能力。
它仍保留“detect → coarse → refine”的 CosyPose 系统结构,但把对象专属知识从 weights 移到了 renderings。
5. Coarse pose estimation
5.1 学的不是最小误差,而是可修正性
对观测 crop I o I_o I o { T C O j } j = 1 M \{T_{CO}^j\}_{j=1}^{M} { T C O j } j = 1 M I r ( T C O j ) I_r(T_{CO}^j) I r ( T C O j )
ξ j = s ( I o , I r ( T C O j ) ) . \xi_j = s\left(I_o, I_r(T_{CO}^j)\right). ξ j = s ( I o , I r ( T C O j ) ) . 标签表示候选是否落入 refiner 的 basin of attraction。最终初值为:
j ⋆ = arg max j ξ j , T C O , c o a r s e = T C O j ⋆ . j^\star=\arg\max_j \xi_j,\qquad
T_{CO,\mathrm{coarse}}=T_{CO}^{j^\star}. j ⋆ = arg j max ξ j , T C O , coarse = T C O j ⋆ . 这个目标比“旋转误差最小”更贴近系统需求:一个候选的数值误差稍大,但若外观残差方向容易被 refiner 识别,可能比另一个局部歧义候选更适合作初值。
5.2 为什么 classification 有助于 symmetry
直接回归 canonical rotation 需要事先知道 symmetry,否则多个等价标签会制造冲突梯度。coarse classification 可把多个外观等价、且可被 refiner 接受的候选都判成正类,不要求训练数据为每个 ShapeNet / GSO 模型提供完整 symmetry annotation。
边界是:coarse 只隐式容纳“rendering 看起来等价”的候选;refiner loss 本身并没有显式做 symmetry minimization,BOP 评测则会用 VSD / MSSD / MSPD 处理对称等价。训练目标、视觉歧义和评测 symmetry 不是同一件事。
5.3 520 个测试候选
论文附录的候选生成方式是:
bbox 中心确定 anchor point 的投影中心;
先设一个深度猜测,把 CAD 按随机 rotation 投影;
比较 CAD projection bbox 与 detection bbox 尺寸,更新 depth;
围绕一个 seed orientation 布置 26 个 viewpoints,并加入 0°、90°、180°、270° in-plane rotations,得到 104 个候选;
重复 5 组随机 seed,共 M = 5 × 104 = 520 M=5\times104=520 M = 5 × 104 = 520
从 104 增加到 520,附录报告 BOP5 提升 11.4 AR;继续增到 4608 只增 0.9 AR。候选数是明显的速度—覆盖率旋钮。
6. Multi-view pose refiner
6.1 为什么需要 anchor point
refiner 沿用 DeepIM / CosyPose 的解耦 pose update,预测:
v x , v y v_x,v_y v x , v y v z v_z v z 两个 3-vectors,经正交化构成 rotation update。
同一个物体坐标旋转定义变化时,rotation correction 可以保持一致;但换一个 anchor point,x y xy x y
MegaPose 的解决方式是渲染 N = 4 N=4 N = 4
第一个是当前 estimated pose;
另外三个从不同虚拟相机观察;
每个相机的 optical axis 都穿过同一个 anchor;
anchor 在每张 rendering 中都位于中心。
多条虚拟 camera rays 的交点向网络揭示 anchor 的 3D 位置,同时多视角也提供更完整的 shape / coordinate-system 信息。
6.2 输入通道与网络
observed RGB crop;
可选 observed depth;
每个候选的 rendered RGB;
rendered depth 与 surface normal;
coarse 与 refiner 都使用 ResNet-34 + global spatial average pooling;
coarse head 输出一个 classification logit;
refiner head 输出 9 个 pose-update 参数。
depth 会按当前 anchor depth 归一化,以减少不同对象尺度和距离造成的绝对值偏移。normal maps 提供与材质无关的局部几何朝向。
6.3 迭代更新与 loss
对象表面均匀采样 2000 个点 X O X_O X O
D O ( T 1 , T 2 ) = 1 ∣ X O ∣ ∑ x ∈ X O ∥ T 1 x − T 2 x ∥ 1 . D_O(T_1,T_2)=\frac{1}{|X_O|}\sum_{x\in X_O}\|T_1x-T_2x\|_1. D O ( T 1 , T 2 ) = ∣ X O ∣ 1 x ∈ X O ∑ ∥ T 1 x − T 2 x ∥ 1 . loss 分别隔离 x y xy x y K = 3 K=3 K = 3
初始化扰动的标准差为平移 ( 0.02 , 0.02 , 0.05 ) (0.02,0.02,0.05) ( 0.02 , 0.02 , 0.05 )
7. 合成训练数据与 sim-to-real
原论文 Figure 4:由 ShapeNet 与 Google Scanned Objects CAD 通过 BlenderProc 生成的随机训练场景,包含物理堆叠、复杂遮挡、随机背景、材质、光照与相机。来源:官方项目页 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
总量:约 2M images。
对象:超过 20K models,主要来自 ShapeNet 和 GSO。
场景:物理仿真落体、clutter、遮挡、随机材质 / 背景 / 光照 / 相机。
RGB augmentation:blur、contrast、brightness、color、sharpness。
depth augmentation:blur、ellipse dropout、相关 / 非相关噪声。
训练成本:32 V100 GPUs;coarse 约 32 小时,refiner 约 48 小时。
这是“目标对象无需再训练”的成本来源:把每对象成本前移成一次昂贵、跨对象的 synthetic pretraining。真实部署并非 training-free,而是 target-specific fine-tuning-free。
8. 实验协议与 BOP 主结果
使用 7 个 BOP core datasets:LM-O、T-LESS、TUD-L、IC-BIN、ITODD、HB、YCB-V,共 132 个对象。指标是 BOP AR,即在 VSD、MSSD、MSPD 多阈值 recall 上聚合。
原论文 Table 1:不同初始化、refiner、novel-object 能力和 RGB-D 输入下的 BOP AR。红叉表示模块训练见过目标对象,绿勾表示可用于训练未见对象。来源:arXiv PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8.1 完整 MegaPose
Pipeline Input Mean AR 关键比较 MegaPose coarse only RGB 16.2 只是局部 refiner 的初值,不能单独作为最终结果 MegaPose coarse + refiner RGB 54.5 refiner 带来 +38.3 MegaPose coarse + refiner RGB-D 57.2 相比 coarse 增加 41.0 CosyPose known-object RGB 57.0 训练见过目标对象,数值接近 MegaPose RGB-D SurfEmb + BFGS + ICP RGB-D 75.2 更高,但训练见过目标对象且用 ICP
MegaPose RGB-D 的逐数据集 AR 为 LM-O 58.3、T-LESS 54.3、TUD-L 71.2、IC-BIN 37.1、ITODD 40.4、HB 75.7、YCB-V 63.3。不同数据集波动明显,工业无纹理 / 对称与检测质量仍会影响系统。
8.2 作为通用 refiner
把 CosyPose coarse poses 交给 MegaPose:
RGB refiner mean AR:59.6;
RGB-D refiner mean AR:66.0;
原 CosyPose coarse only:42.3;
CosyPose 自身完整 pipeline:57.0。
这比“完整 MegaPose 57.2”更直接证明 refiner 的价值:同一 initialization 下,共享 novel-object refiner 可以超过 object-specific CosyPose refiner。但比较仍受两者训练数据规模差异影响,不能只把收益归因于四视角结构。
8.3 PPF hypotheses 重排序
在相同 PPF hypotheses 上:
scorer YCB-V AR LM-O AR PPF 52.7 34.4 PPF + Zephyr 59.8 45.8 PPF + MegaPose coarse 61.6 52.1
这项实验隔离了候选生成,支持 coarse network 的 ranking / classification 确实优于 baseline scorer。
9. ModelNet refiner 结果
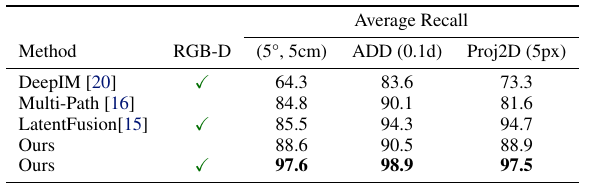
原论文 Table 2:在 DeepIM 的 ModelNet noisy-initialization 协议下,MegaPose RGB 与 RGB-D refiner 的 5°/5cm、ADD-0.1d 和 Proj2D-5px recall。来源:arXiv PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
方法 RGB-D 5°/5cm ADD-0.1d Proj2D-5px DeepIM 是 64.3 83.6 73.3 LatentFusion 是 85.5 94.3 94.7 MegaPose 否 88.6 90.5 88.9 MegaPose 是 97.6 98.9 97.5
作者移除了与 ModelNet 测试类别重叠的 ShapeNet 训练类别,以维持 novel-category 比较。这里的结果只回答“给定 noisy initial pose,refiner 能否收敛”,不包含检测和全局 coarse cost。
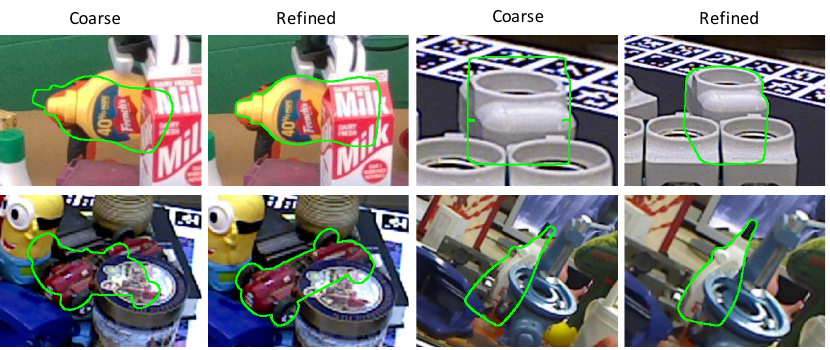
原论文 Figure 3:来自 YCB-V、LM-O、HB 和 T-LESS 的未见训练对象;每对左图为 coarse,右图为 5 次 refinement 后结果,展示遮挡和无纹理条件下的轮廓收紧。来源:arXiv PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
10. 消融:结构与数据规模
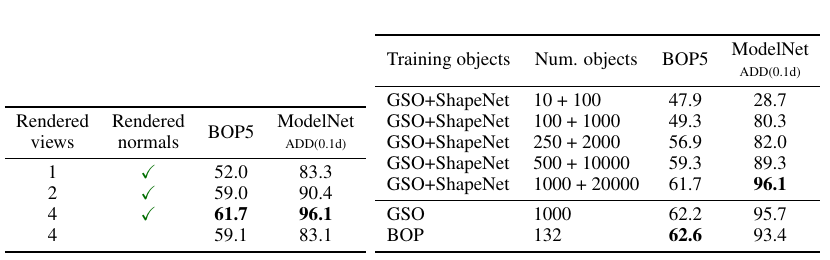
原论文 Table 3:左侧消融 rendered views 与 normal maps,右侧逐步增加 GSO / ShapeNet 训练对象数量,并和只用 GSO 或 BOP objects 比较。BOP5 为 LM-O、T-LESS、TUD-L、IC-BIN、YCB-V 的平均 AR。来源:arXiv PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
10.1 多视角与 normals
Rendered views Normals BOP5 ModelNet ADD-0.1d 1 是 52.0 83.3 2 是 59.0 90.4 4 是 61.7 96.1 4 否 59.1 83.1
四视角不仅告诉网络 anchor 位置,也扩大了可见 shape 范围。normal map 对 ModelNet 增益特别大,说明材质不可靠时,几何朝向通道能提供关键判别。
10.2 训练对象数量
从 10 GSO + 100 ShapeNet 增长到 1000 GSO + 20000 ShapeNet:
BOP5:47.9 → 61.7;
ModelNet ADD-0.1d:28.7 → 96.1。
只用 1000 个高质量 GSO objects 已有 BOP5 62.2 / ModelNet 95.7;只用 132 个 BOP target objects 为 62.6 / 93.4。由此更准确的结论是:
对象数量很重要,尤其决定跨类别覆盖;
真实扫描纹理和模型质量同样重要,1000 个 GSO 可接近 20K+ 的组合;
“训练见过 BOP 对象”带来的优势并不大于高质量多对象预训练,但这只是 refiner 消融,不涵盖 detector。
11. 速度与工程复杂度
coarse:主文报告 520 hypotheses 的渲染与评估约 2.5 s / object;附录提到后续代码优化为约 1.6 s。
refiner:RTX 2080 上约 50 ms / iteration。
完整单帧常用 5 iterations,refinement 约 250 ms,不含 detector / rendering 调度开销。
tracking:第一帧运行 detection + coarse + 多次 refinement;后续帧以此前 pose warm start,只做一次 refinement,约 20 Hz。
显存 / 吞吐:候选数和同时处理对象数直接影响 rendering 与 batch memory。
系统适合“昂贵初始化 + 快速局部 tracking”,不适合把每帧、每个对象都从 520 hypotheses 重新全局搜索。
12. 失败模式与证据边界
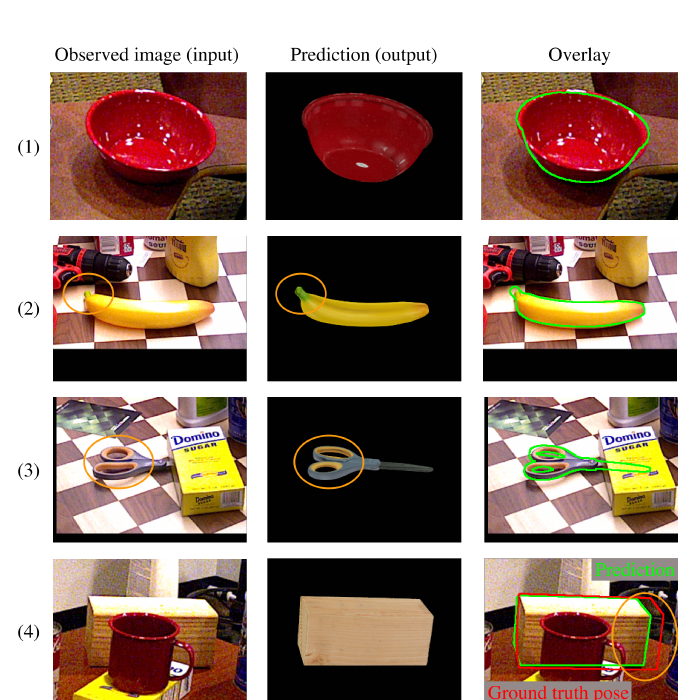
原论文 Figure 7:红碗与香蕉在不同方向外观相似;剪刀需依赖左右手柄细微差异;木块 CAD 尺度与真实物体不符,导致 prediction 轮廓合理却和 GT pose 不一致。来源:arXiv PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
12.1 外观等价但姿态不等价
红碗翻转后轮廓近似,香蕉从部分视角也高度相似。render-and-compare 只能利用可见证据;若粗候选选错模态,局部 refiner 会在错误 basin 中收敛。
12.2 细节分辨率
剪刀整体轮廓对齐,但左右手柄尺寸的微小差异决定方向。crop resolution、遮挡、合成纹理与真实纹理差异都会削弱这类证据。
12.3 CAD metric scale
RGB 单目中物体尺度与深度耦合。CAD 尺寸错误时,可通过错误 depth 让 projection 轮廓继续贴合,因此“rendering overlay 很准”并不保证 translation 或 benchmark GT 一致。
12.4 未充分覆盖的属性
透明 / 强反光物体;
大幅 non-rigid 或 articulated objects;
粗糙重建 mesh 的尺度漂移;
bbox 严重偏移或目标身份错误;
多个外观相同实例之间的 association;
长遮挡后的 tracking recovery。
论文展示了部分低质量 CAD 仍可成功,但没有把 mesh quality、texture quality 与 scale error 分开做系统定量曲线。
13. 贡献与证据是否匹配
作者主张 主要证据 判断 shared refiner 可泛化到 novel objects BOP 七数据集、ModelNet、CosyPose initialization + MegaPose refiner 充分;但 detection 不在 novel-object 协议内 coarse classification 不需 symmetry labels regression alternative 训练崩溃、PPF hypotheses 重排序 有支持;缺少更强 symmetry-aware regression baseline multi-view renderings 编码 shape / anchor Table 3(a) 1/2/4 views 消融 充分,且 ModelNet 增益显著 大规模对象多样性是泛化关键 Table 3(b) 对象数量曲线 充分;模型质量与数量存在混杂 可用于机器人操作与 tracking 官方视频、Franka 定性抓取、20 Hz refinement 只属定性 proof of concept,没有抓取成功率和失跟统计
14. 批判性分析
优点
接口选择正确 :CAD rendering 是天然的 object-specific prompt,比把每个对象写进网络权重更适合快速部署。coarse 与 refine 目标一致 :coarse 学 refiner 可达域,使多阶段 pipeline 的训练语义更连贯。数据规模证据清晰 :不仅宣布 20K models,还给出训练对象数量与性能曲线。RGB 仍有竞争力 :没有把 novel-object 泛化完全建立在 depth / ICP 上。后续影响大 :FoundationPose、SAM-6D、HRDexDB 标注与大量 novel-object pipeline 都复用或比较 MegaPose refinement 思路。
缺点
全局初始化慢,520 candidates 的计算量随对象数线性增长。
detector 与 pose backend 的 novelty 不一致,容易被宣传性表述掩盖。
refiner 的局部收敛域由训练扰动决定,coarse 一旦漏掉正确模态就难恢复。
refiner loss 没有显式 symmetry annotations,而视觉等价与评测等价并不完全相同。
RGB translation 对 CAD scale 极敏感;真实资产管理本身就是系统瓶颈。
真实机器人实验只做定性演示,不能证明端到端操作可靠性。
15. 复现与使用建议
先核验 mesh 单位、坐标原点、朝向、法线、纹理和 watertight 状态。
把 detector recall、bbox IoU 与 conditional pose AR 分开报告。
首次初始化保留多个 coarse hypotheses,而非只把 top-1 送入 refiner;歧义对象应延迟决策。
RGB-D 模式需复现论文 depth normalization,并模拟真实传感器缺失与噪声。
tracking 中设置重初始化触发器;单步 refinement 不能处理长期遮挡后的大位姿跳变。
对称对象使用 BOP symmetry-aware metrics,同时可在候选层保留多个等价 pose。
速度报告应拆分 detector、renderer、coarse scoring、每次 refinement 和多对象 batching。
16. 对后续研究的启发
retrieval / foundation features 替换 coarse backbone :用 DINOv2 / foundation matching 提高候选排序并减少 520 hypotheses。更大 basin 的 refiner :用多尺度特征、uncertainty 或 diffusion / flow matching 学多模态更新。CAD quality awareness :联合估计 mesh scale correction、几何偏差与 pose,不把 CAD 当绝对正确。open-vocabulary front end :把 CAD / renderings 直接用于检测与 segmentation,补上论文明确留下的缺口。多对象联合推理 :用 scene constraints、碰撞和相对位置消除单 ROI 的局部歧义。跨帧候选分布 :tracking 不只传递一个 pose,而是传递对称 / 遮挡下的多模态 posterior。
17. 总结
MegaPose 的核心不是简单“渲染 CAD 再比较”,而是把对象专属知识系统性地外置为 test-time renderings:
coarse network 判断候选是否进入 refiner 可修正域;
multi-view refiner 从四个共同 anchor 的视角恢复对象几何与坐标信息;
大规模合成对象训练让比较网络跨实例泛化。
它证明了 model-based novel-object pose 可以从“每对象训练”转向“共享 pose engine + 新 CAD prompt”。同时,MegaPose 的边界也非常明确:必须有 metric CAD、内参和 ROI,首次搜索较慢,refiner 只局部收敛,完整检测链路并不 zero-shot。理解这些条件,才能把它作为后续系统的可靠 baseline,而不是把“novel object”误读成无条件开放世界位姿估计。