论文精读笔记:MOTPose: Multi-Object 6D Pose Estimation for Dynamic Video Sequences Using Attention-Based Temporal Fusion
1. 基本信息
- 作者 / 机构:Arul Selvam Periyasamy、Sven Behnke;University of Bonn
- 年份 / 会议:2024 / ICRA
- 论文:arXiv / PDF
- 阅读模式:精读
2. 核心定位
单帧模型在料箱中会因瞬时遮挡漏检或输出离群 pose。MOTPose 不显式做 object tracking association,而把每帧的固定大小预测集合当作 temporal tokens,用 cross-attention 在 embedding、keypoint 和 pose 三个层面检索历史证据。
3. 任务设定
| 项目 | 设置 |
|---|
| 输入 | 单目 RGB video,最多使用当前帧加 7 帧历史 |
| 对象 | 21 个已知 YCB instances,可同场多实例 |
| 输出 | detection set + 6D pose |
| CAD | 训练 / pose loss 与评测需要 |
| 显式 track ID | 不以 tracking metric 为目标 |
| 数据 | 动态 SynPick 与 YCB-Video |
SynPick 是物体和 gripper 都会运动的合成 bin-picking 视频;YCB-Video 主要是 moving camera + static multi-object scene。两者共同验证时序融合,但动态性不同。
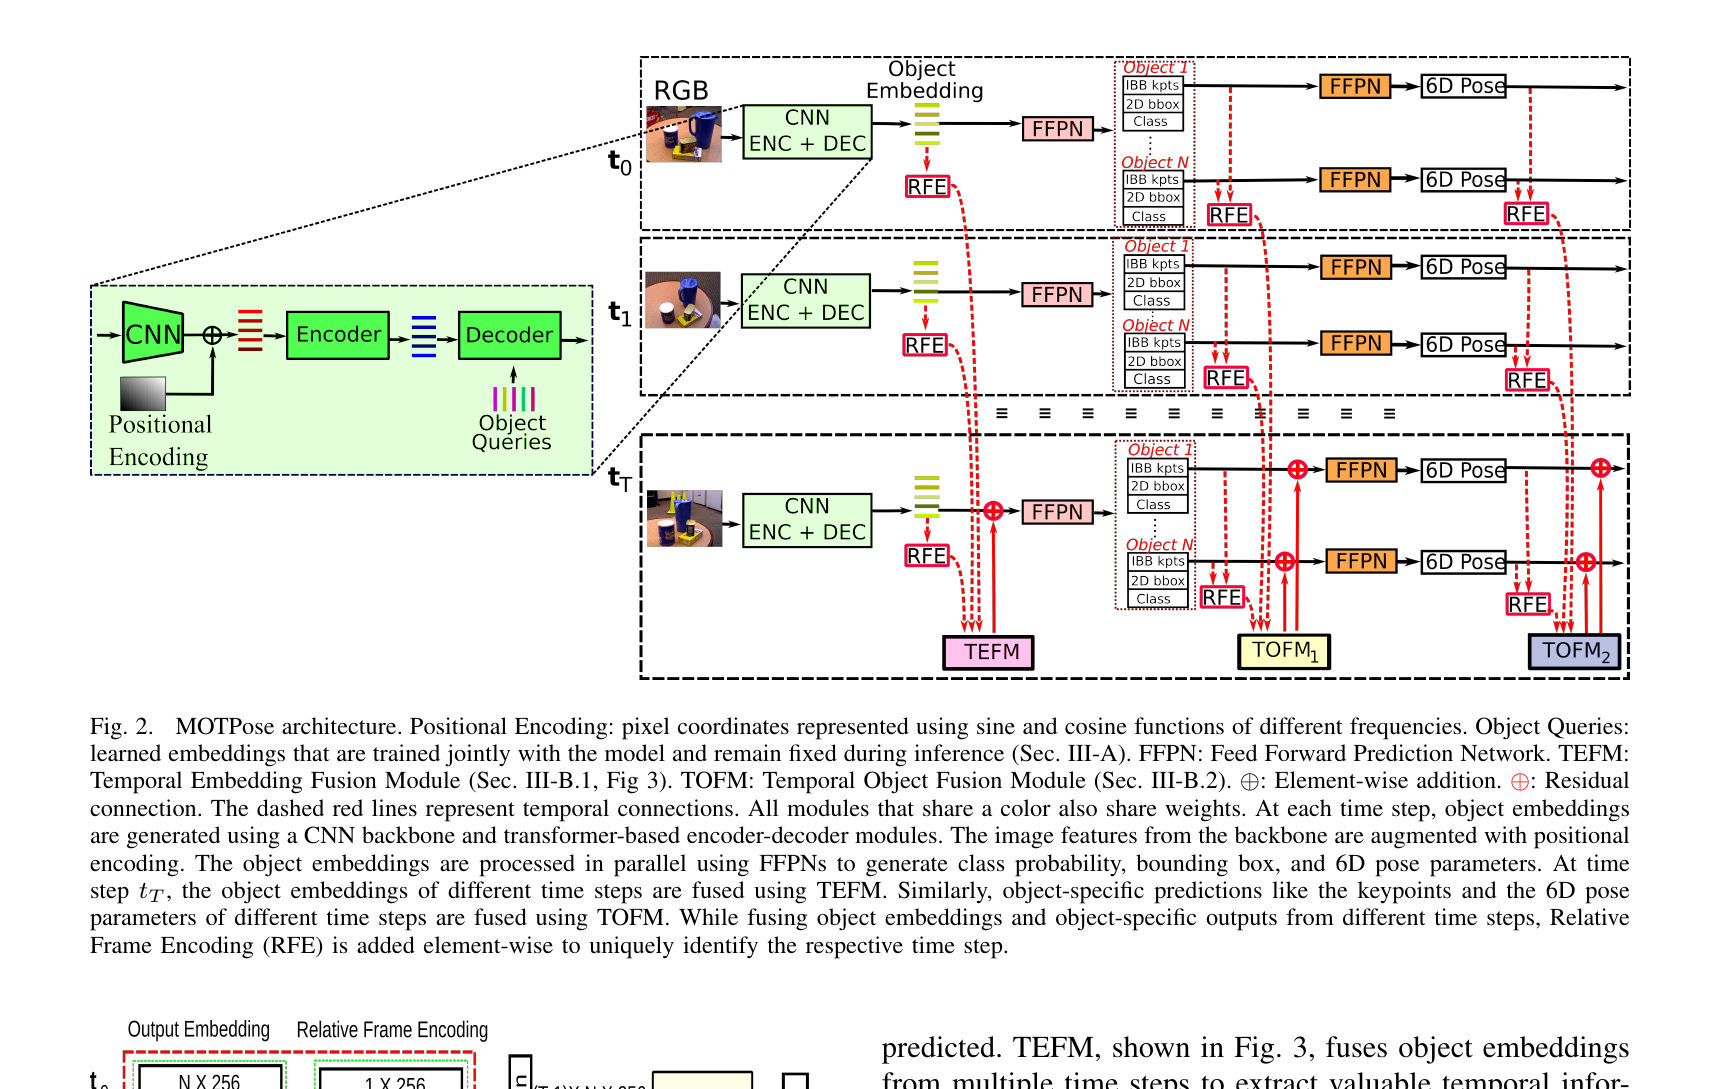 原论文 Figure 2:TEFM 聚合历史 object embeddings,TOFM 分别融合 keypoints 与 pose parameters;relative frame encoding 保留时间顺序。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
4. 方法详解
4.1 Set prediction 主干
网络采用 DETR-like encoder–decoder。每帧产生 N 个 256 维 object embeddings,N 按数据中最大对象数设置为 SynPick 30、YCB-Video 20。每个 token 预测 class、box、32 维 keypoint 表示、6D rotation 表示和 translation。训练时 Hungarian matching 只用类别和 box 匹配预测与 GT,避免早期不稳定 pose 破坏 assignment。
4.2 两级 temporal fusion
- TEFM:当前帧 embeddings 作 query,历史 T−1 帧 embeddings 作 key / value,解决遮挡下“当前 object token 应从哪些历史对象吸收信息”。
- TOFM:把 keypoints、rotation、translation 等低维预测先投影到 256 维,加 relative frame encoding 后 cross-attend,再投影回原参数空间。
- RFE:1D sinusoidal relative-frame encoding 显式标明时间距离,避免 attention 把多帧当无序集合。
这是 prediction-level fusion,而非 optical flow warp;优势是结构简洁,缺点是 correspondence 由 attention 隐式学习。
4.3 训练目标
总损失包含 class NLL、GIoU+ℓ1 box loss、keypoint ℓ1+cross-ratio consistency、translation ℓ2、symmetry-aware ShapeMatch rotation loss,以及相邻 object embeddings 的 temporal consistency。对称物体不会被强迫回归唯一旋转。
5. 实验结果
SynPick 每种 action 原有 240 train / 60 test videos,作者额外为 move、targeted-pick、untargeted-pick 各生成 300 条训练视频,称为 SynPick-Ext;评测剔除可见比例低于 30% 的对象。
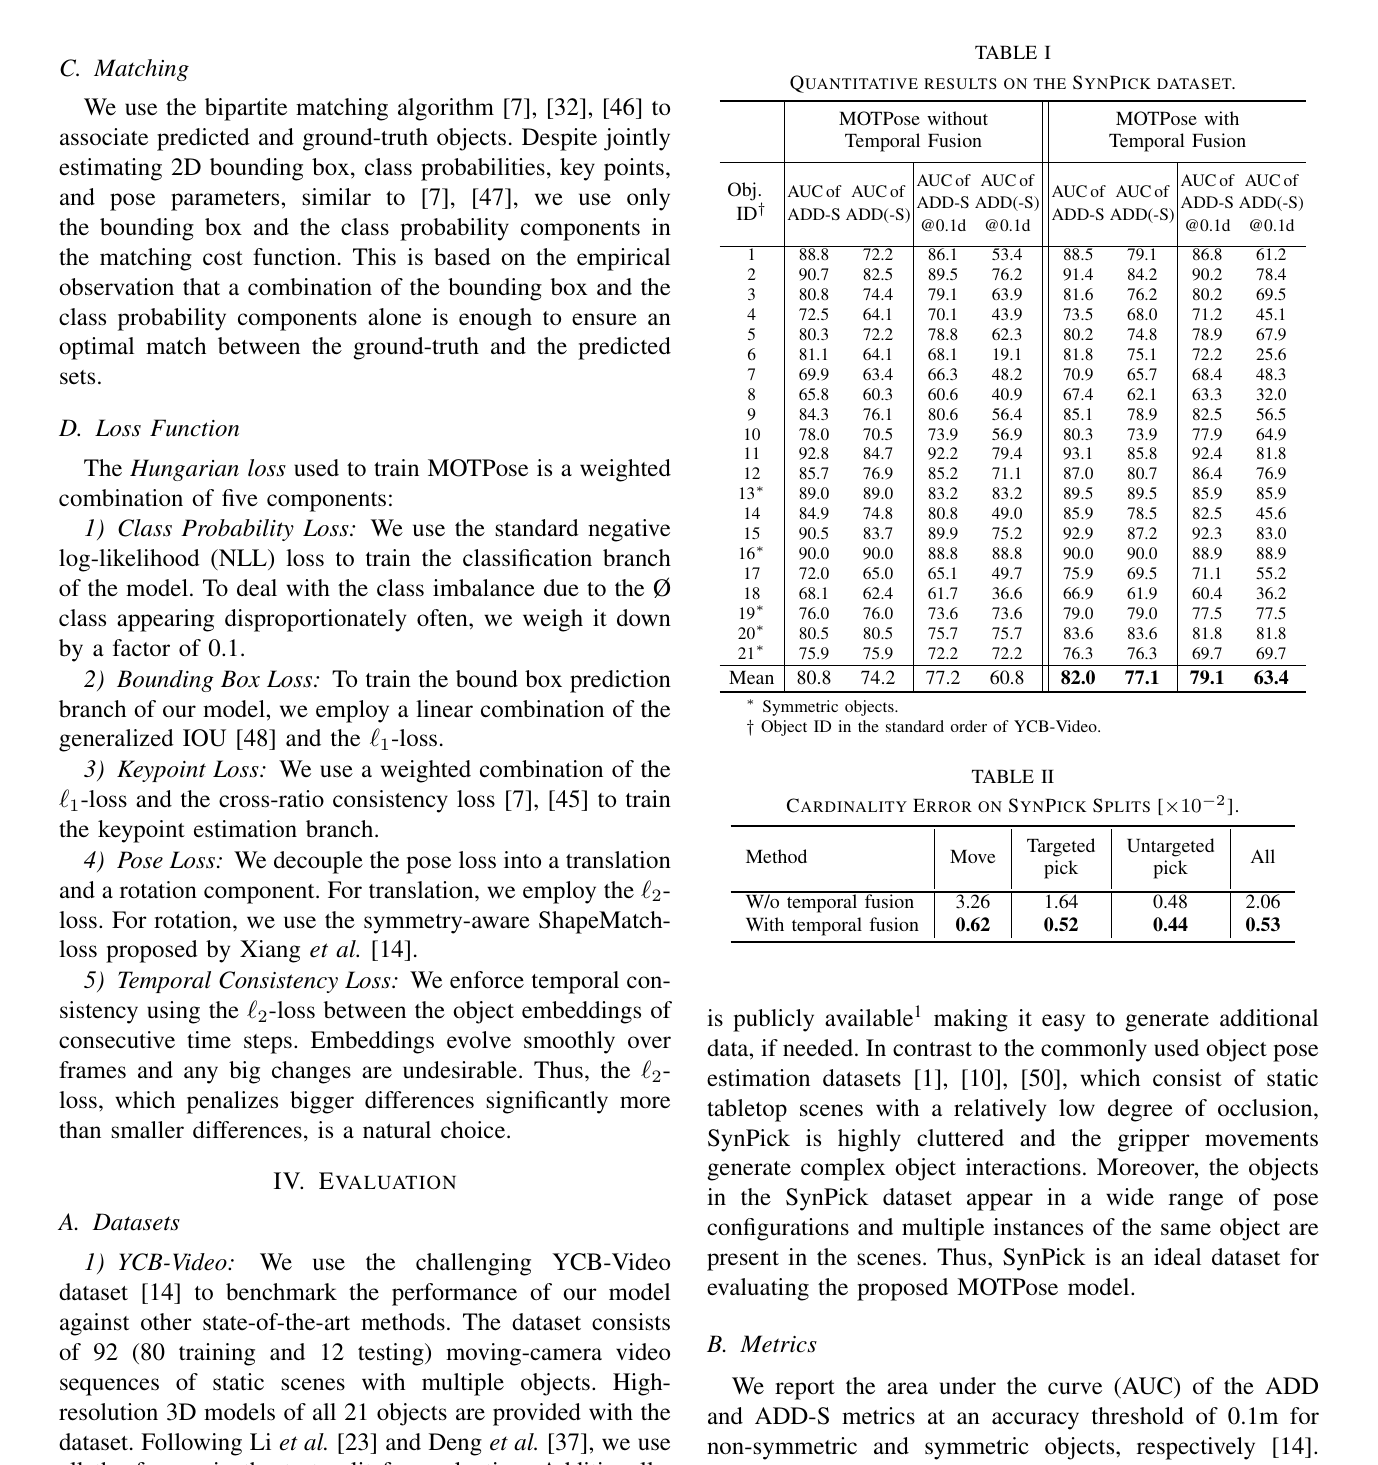 原论文 Table I–II:21 个 YCB 对象在 SynPick 上的 pose AUC,以及 temporal fusion 对对象集合 cardinality 的改善。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| SynPick 指标 | 无时序融合 | MOTPose |
|---|
| AUC ADD-S | 80.8 | 82.0 |
| AUC ADD(-S) | 74.2 | 77.1 |
| AUC ADD-S @0.1d | 77.2 | 79.1 |
| AUC ADD(-S) @0.1d | 60.8 | 63.4 |
| Cardinality error ×10−2 | 2.06 | 0.53 |
| False negative ×10−2 | 1.79 | 0.48 |
pose AUC 的绝对提升不算巨大,但漏检约降到原来的四分之一;这对 bin-picking 比只看已检测对象的 pose error 更重要。Figure 4 中 temporal model 也减少了孤立的严重 pose outliers。
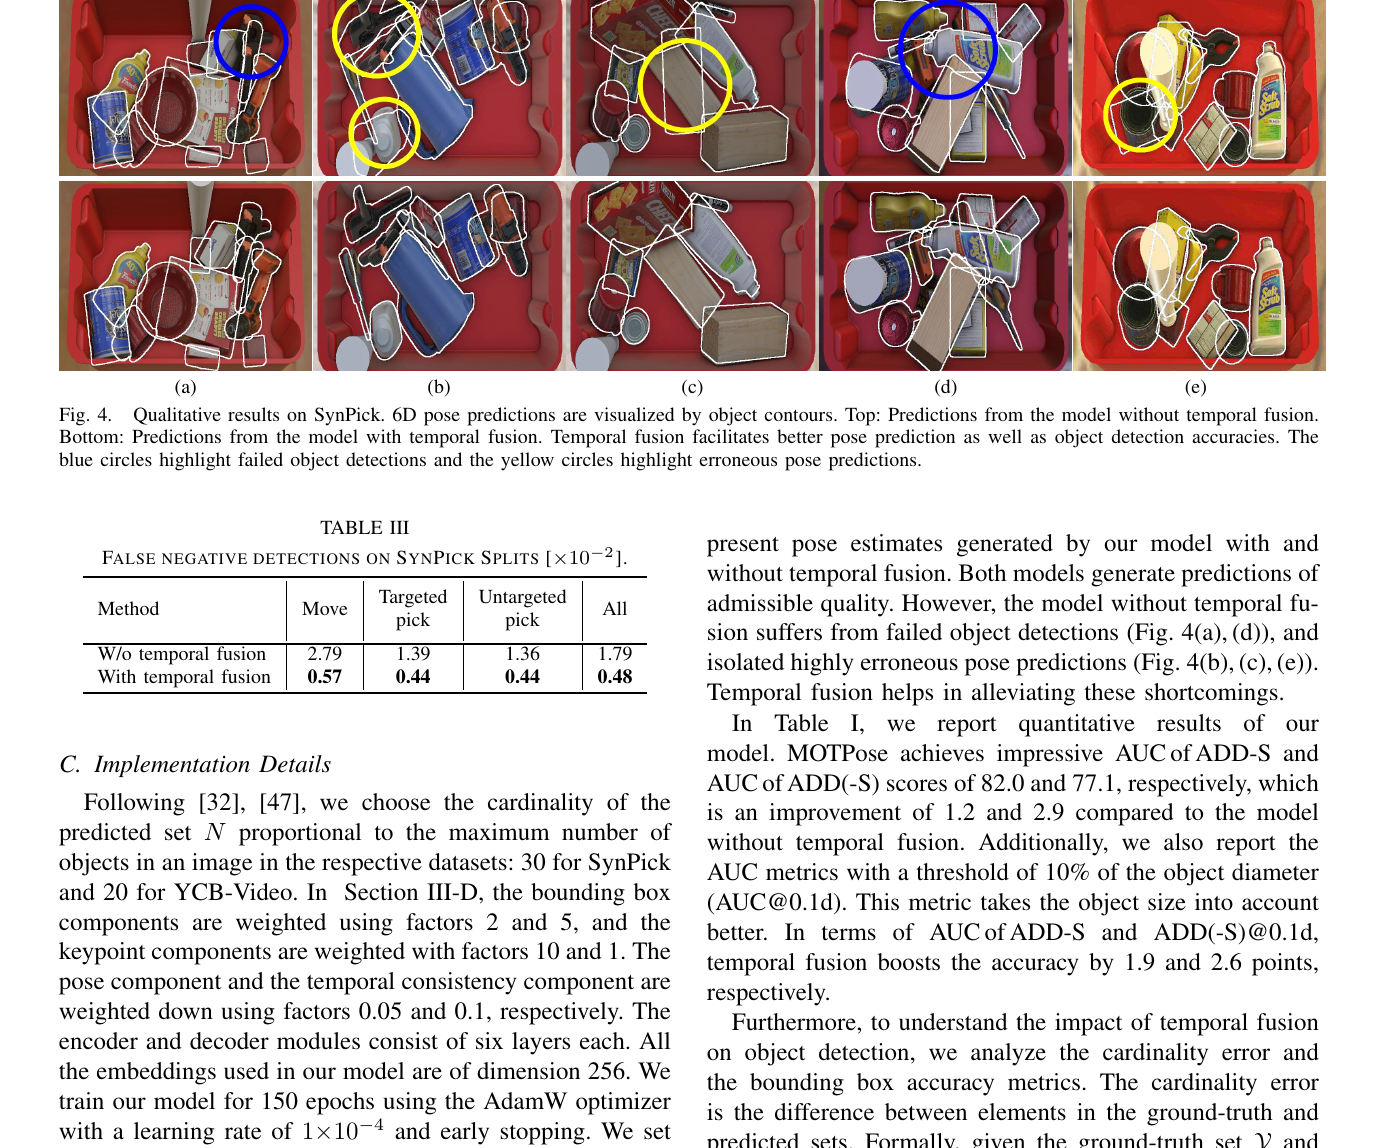 原论文 Figure 4 / Table III:无时序融合时的漏检和离群 pose,以及使用历史帧后的改善。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
消融中去掉 TEFM 时 AUC ADD(-S) 为 74.9,相比完整模型 77.1 降幅最大;去掉 TOFM 则分别降低约 1.8 ADD-S 和 0.9 ADD(-S)。说明高层 object representation 的时序一致性比直接平滑 pose 数值更关键。
6. 局限与启发
- 需要 dense video 6D annotations;这正是现实视频中最昂贵的数据。
- 固定历史窗口增加显存和首 T−1 帧 warm-up。
- 没有显式 motion / camera geometry,快速跳变可能超出 attention 学到的 temporal prior。
- SynPick 是 synthetic,真实动态 bin-picking 的材质、motion blur 与遮挡仍有域差。
- 输出集合关联不是正式 track identity,不能用 MOT metrics 评价长期身份保持。
后续可以引入 pose-aware memory、基于 SE(3) 的时间预测、visibility uncertainty,并用 synthetic-to-real video adaptation 降低连续 6D 标注需求。MOTPose 最重要的启发是:时序不仅能平滑 pose,更能恢复 detection set 本身。
