论文精读笔记:MRC-Net
1. 核心判断
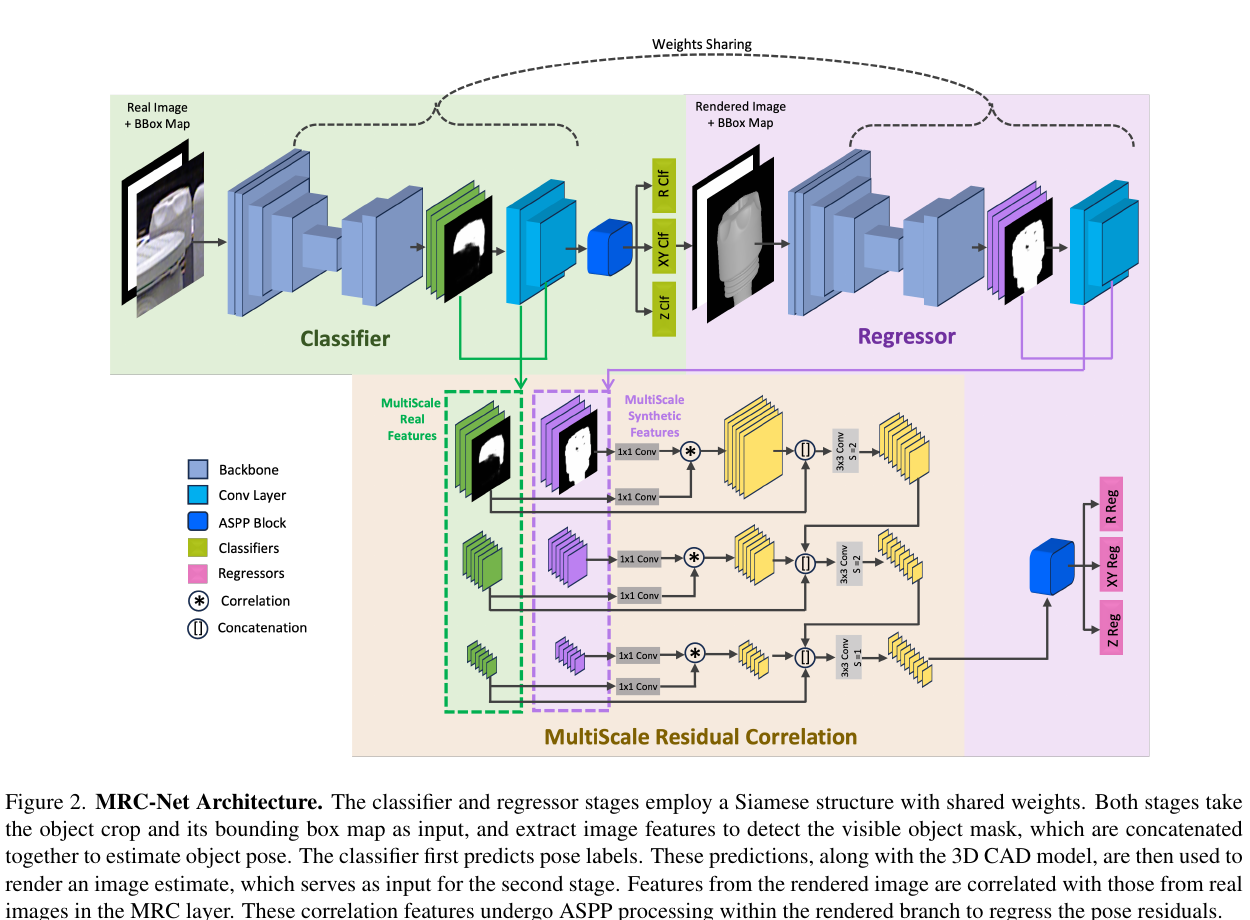
MRC-Net 的关键并非简单地把“分类”和“回归”放进同一网络,而是改变两者的因果关系:粗分类先产生一个可渲染的 pose,残差回归明确以这个分类结果为条件。其三尺度相关层进一步把真实图与粗姿态 render 之间的差异变成可学习的 residual evidence。
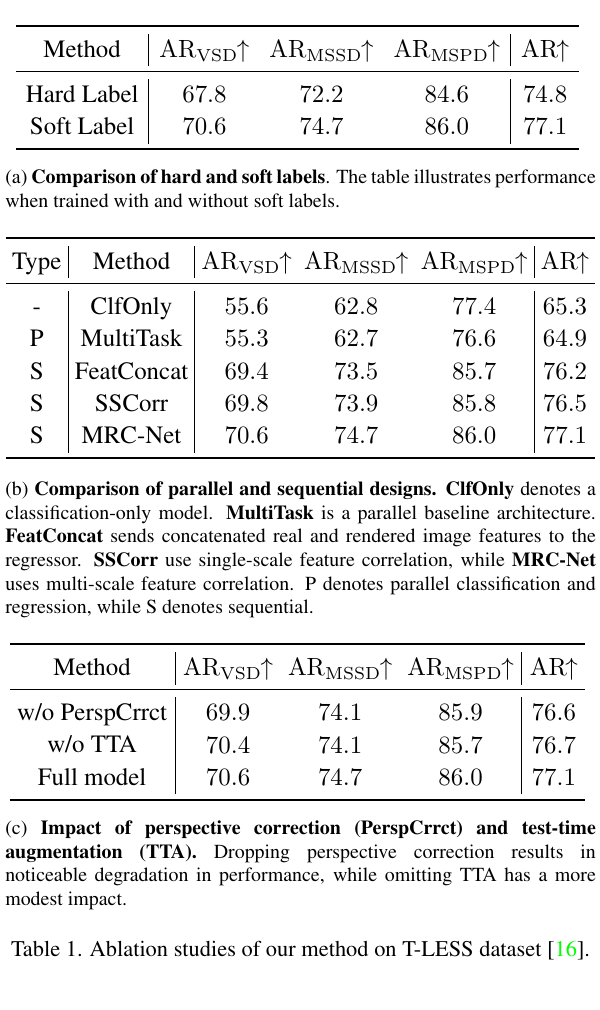
论文在 T-LESS 的消融很能说明主次:
仅分类:65.3 AR;
并行分类 + 回归:64.9,几乎没有帮助;
顺序分类 → 回归、仅拼接特征:76.2;
单尺度 correlation:76.5;
多尺度 correlation:77.1。
因此,大增益来自“让回归知道分类究竟选了哪个 pose”,多尺度相关是在这条正确主线上继续补 0.9。把所有提升笼统归因于 MRC layer,会掩盖论文最有价值的设计判断。
2. 任务边界与输入输出
输入包括:
检测得到的 RGB object crop;
检测框的 binary map,训练时会膨胀以模拟检测误差;
相机内参;
目标对象的 metric CAD 与 renderer。
输出是完整实例级 pose:
R ^ = Δ R R c , τ ^ i = τ i c + Δ τ i , i ∈ { x , y , z } . \hat R=\Delta R R_c,\qquad
\hat \tau_i=\tau_i^c+\Delta\tau_i,\quad i\in\{x,y,z\}. R ^ = Δ R R c , τ ^ i = τ i c + Δ τ i , i ∈ { x , y , z } . 其中 τ \tau τ seen-object、CAD-based、RGB-only 方法:训练和测试对象来自同一个数据集,不能据此宣称 novel-object 泛化。
3. 粗分类为什么不直接结束
旋转空间 S O ( 3 ) SO(3) S O ( 3 ) K = 4608 K=4608 K = 4608 { R k } \{R_k\} { R k } ( τ x , τ y ) (\tau_x,\tau_y) ( τ x , τ y ) 64 × 64 64\times64 64 × 64 τ z \tau_z τ z
传统并行 multi-task 只共享 backbone,回归头并不知道分类最终选择了哪一个桶。于是它面对的仍是全姿态空间,而不是局部残差。MRC-Net 则先取粗分类 R c , τ c R_c,\tau^c R c , τ c
原论文 Figure 2。分类器与回归器各自采用共享权重的真实 / 渲染 Siamese 分支;三尺度 real / synthetic features 在 MRC 中相关,输出经 ASPP 后回归 pose residual。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
4. 对称感知 soft labels
hard nearest-prototype 有两个问题:
GT 位于两个 Voronoi 桶边界时,两个原型几乎等价却只有一个正类;
对称对象可能有多个物理或视觉等价旋转。
论文按 symmetry-aware pose distance 定义第 k k k
l k R = exp ( − ρ pose_symm ( R \* , t \* ; R k , t \* ) σ ) , σ = 0.03 d diam . l_k^R=
\exp\left(
-\frac{\rho_{\text{pose\_symm}}(R^\*,t^\*;R_k,t^\*)}{\sigma}
\right),
\qquad
\sigma=0.03d_{\text{diam}}. l k R = exp ( − σ ρ pose_symm ( R \* , t \* ; R k , t \* ) ) , σ = 0.03 d diam . 它不是一个和为 1 的 categorical distribution,而是 pairwise binary membership:多个 rotation prototypes 可以同时有较高概率。作者用带正类权重 w + = 100 w^+=100 w + = 100
平移 soft labels 则在量化坐标中以 GT 为中心构造 Gaussian 权重。推理时三项仍各取最高置信 class,所以多模态只用于训练表征与决策边界平滑,最终并不输出 calibrated multi-hypothesis distribution。
原论文 Table 1:soft label 将 T-LESS AR 从 74.8 提至 77.1;并行 MultiTask 仅 64.9,顺序特征拼接已达 76.2,单尺度 / 多尺度相关进一步达到 76.5 / 77.1。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
5. MultiScale Residual Correlation
在每个尺度,真实特征 f r f_r f r f s f_s f s 1 × 1 1\times1 1 × 1 v v v
c ( v , x ) = 1 d f s ( x ) ⊤ f r ( x + v ) , ∥ v ∥ ∞ ≤ P . c(v,x)=\frac{1}{\sqrt d}f_s(x)^\top f_r(x+v),
\qquad \|v\|_\infty\le P. c ( v , x ) = d 1 f s ( x ) ⊤ f r ( x + v ) , ∥ v ∥ ∞ ≤ P . 输出 correlation volume 的形状为 P 2 × H × W P^2\times H\times W P 2 × H × W
高分辨率:边缘、轮廓、局部遮挡;
中尺度:部件级偏差;
低分辨率:整体朝向与全局形状。
与显式 optical flow 路线相比,MRC 不需要先监督 flow,再用 RANSAC / PnP 或 recurrent update 求 pose;correlation feature 直接进入回归头,整个链路端到端训练。但它也因此牺牲了可视化、可诊断的显式对应。
6. 训练与推理协议
backbone:ResNet34–UNet,分类与回归阶段分别为 Siamese shared-weight encoder;
输入:256×256 object crop 与 bounding-box map;
合成训练:PBR,batch 128,75 epochs,8×V100;
每个数据集单独训练一个模型;
T-LESS / YCB-V 可用真实图继续微调;ITODD / LM-O 只用合成图;
推理 TTA:将 crop 旋转 90°、180°、270°、360°,四次运行后取最高分类分数;
perspective correction:用真实 projected object center 而非 bbox center 构造 SITE target。
“single-shot”指没有 pose refinement loop、PnP 与后处理,不代表只做一次网络计算:报告配置含四方向 TTA,且网络本身包含分类、即时渲染和回归两阶段。
7. BOP 主结果
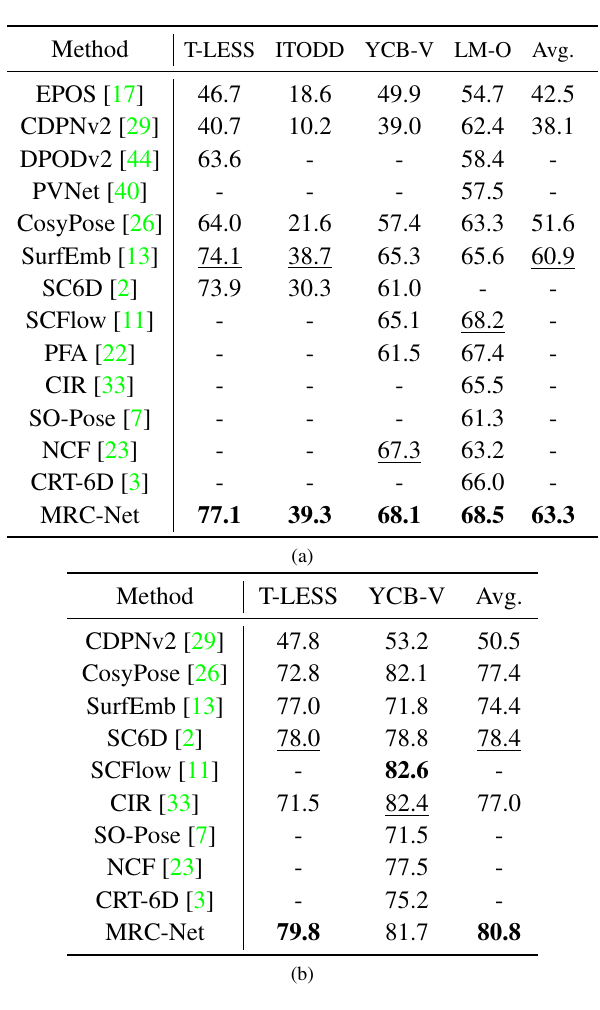
原论文 Table 2。上表是仅用 PBR 合成训练,下表是 T-LESS / YCB-V 再加入真实训练图。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
训练协议 T-LESS ITODD YCB-V LM-O 平均 纯 PBR 77.1 39.3 68.1 68.5 63.3 加真实图微调(可用库) 79.8 — 81.7 — 80.8
纯 PBR 条件下,SurfEmb 四库均值 60.9,MRC-Net 为 63.3;提升 2.4 点。T-LESS 的优势明显,说明 soft classification + local residual 对 textureless、对称对象有效。YCB-V 加真实图后为 81.7,低于 SCFlow 82.6 和 CIR 82.4:丰富纹理下,显式 dense correspondence 与迭代方法仍占优势。
YCB-V 非 BOP 指标:
配置 ADD(-S) AUC ADD-S AUC ADD(-S) MRC-Net 81.2 95.0 92.3 MRC-Net + FCOS detector 83.6 97.0 94.3
不同论文常用 CosyPose 或 FCOS detections,检测前端并不一致,因此这些数字不宜与只在 GT crop 上评测的方法直接混排。
8. 遮挡定性与效率
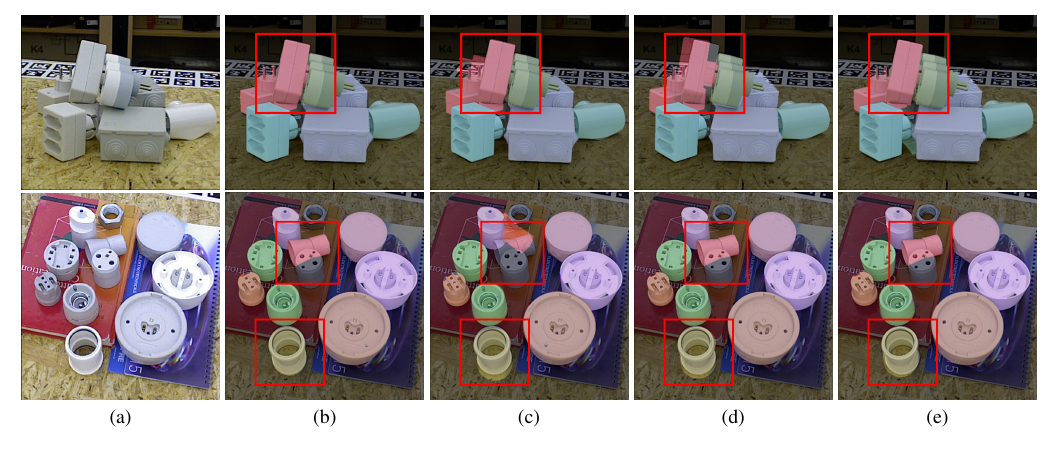
原论文 Figure 4 的主要图像区域:从左到右为原图、MRC-Net、PFA、SC6D、ZebraPose。红框标出重遮挡或邻近同实例下明显不同的 pose 投影。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
同一 AWS EC2 P3.2xlarge 上,单对象 256×256 crop:
CIR 2542 ms;
SurfEmb 1121 ms;
PFA 88 ms(不含初始化);
GDR-Net 26 ms;
SC6D 25 ms;
MRC-Net 61 ms。
MRC-Net 不是最快,但比迭代 render-and-compare 快很多,论文据此给出约 16 FPS。需注意该数字是单 crop,不含 detector;多对象场景整体吞吐还会随检测数量增长。
9. 局限与复现检查
需要准确 metric CAD;作者明确指出 CAD 误差会破坏 render-and-compare。
逐数据集训练,不具备 FoundationPose / MegaPose 式 novel-object onboarding。
四向 TTA 是主结果的一部分,禁用后 AR 从 77.1 降至 76.7。
4,608 rotation classes 和 1,000 depth bins 带来显存与分类不平衡压力。
最终只输出最高分类桶与单个 residual,soft labels 没有变成可校准的不确定性输出。
分类错误过大时,局部 correlation 窗口可能找不到正确对应,残差头无法跨桶救回。
论文的 runtime 包含 renderer 和两阶段网络,但不含检测初始化,比较时要保持口径一致。
10. 最终评价
MRC-Net 是一篇结构非常清楚的“粗到细直接 pose”论文。它的核心证据不是多尺度比单尺度多 0.6 AR,而是顺序条件化比并行 multi-task 高 12.2 AR:残差回归只有在明确知道当前粗解时,才真正变成局部修正问题。
对于需要已知 CAD、希望避开 PnP / RANSAC / iterative refinement 的 RGB 系统,这套设计兼顾精度和约 61 ms 的单对象速度。对于训练外对象、CAD 不准或需要显式多模态后验的场景,则应转向 FoundationPose、GenFlow 或 SE(3) distribution modeling 等不同路线。