论文精读笔记:MV-ROPE
1. 核心判断
MV-ROPE 的切入点是:移动相机已经提供连续多视图,却常被类别级 pose 方法压缩成彼此独立的 RGB-D 帧。论文用 scale-aware dense SLAM 产生相机位姿与 metric depth,再以对象 pose graph 融合关键帧估计;性能来源不是更大的单帧网络,而是将相机运动、对象静止和跨帧身份变成约束。
2. 系统设定
输入为连续 RGB 与尺度信息。尺度可以来自双目 baseline、硬件同步 IMU 或直接 depth;输出是全局参考系中的相机轨迹、对象 6D pose 与尺寸。
关键假设:
- 物体在序列中静止,运动来自相机;
- 类别和实例 mask 可由分割网络得到;
- SLAM 在纹理与运动条件下不失效;
- 尺度读数可用,否则单目 Sim(3) ambiguity 无法消除。
因此它不适合直接处理被人移动的物体,也不等同于单帧 RGB-only pose。
3. 三模块数据流
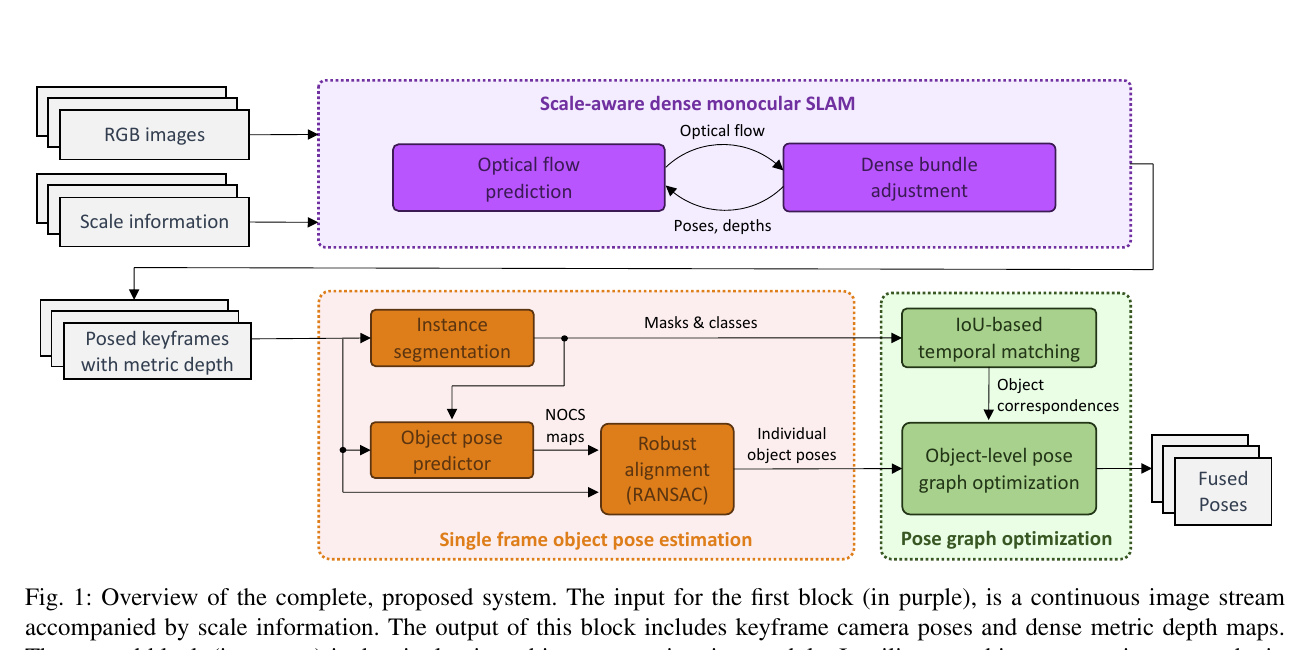 原论文 Figure 1。单帧 NOCS pose 只是中间观测,最终结果来自关键帧与对象图的联合优化。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
3.1 Scale-aware dense monocular SLAM
光流网络预测相邻关键帧稠密对应,dense bundle adjustment 联合优化相机 pose 与 depth。作者在目标函数中加入尺度约束,使深度和 translation 不再只有任意比例。多帧重投影比消费级 ToF 单帧 depth 更平滑,也能在局部无深度时恢复结构。
3.2 单帧对象估计
关键帧经过 instance segmentation 和轻量 NOCS predictor。对 mask 内像素:
- NOCS 给出类别规范坐标;
- SLAM depth 反投影为相机坐标;
- Umeyama 在 RANSAC 中求相似变换;
- 得到旋转、平移与对象尺度。
这里的 NOCS map 仍可能因类别内形状、纹理或对称性出错;多视图模块负责削弱而非完全消除这些误差。
3.3 对象关联与 pose graph
相邻关键帧以投影 IoU 建立对象对应。每个对象 pose 观测通过相机 pose 变换到全局参考系,在 object-level graph 中优化共享对象状态。
跨帧融合带来:
- 遮挡帧可借助其他视角;
- 单帧误检 / NOCS 离群被图优化抑制;
- 对象尺寸与姿态在全序列共享;
- 输出与 SLAM 世界坐标一致。
但只用 IoU 关联,在同类相邻对象、快速相机运动和长时间遮挡时容易 identity switch。
4. 实验
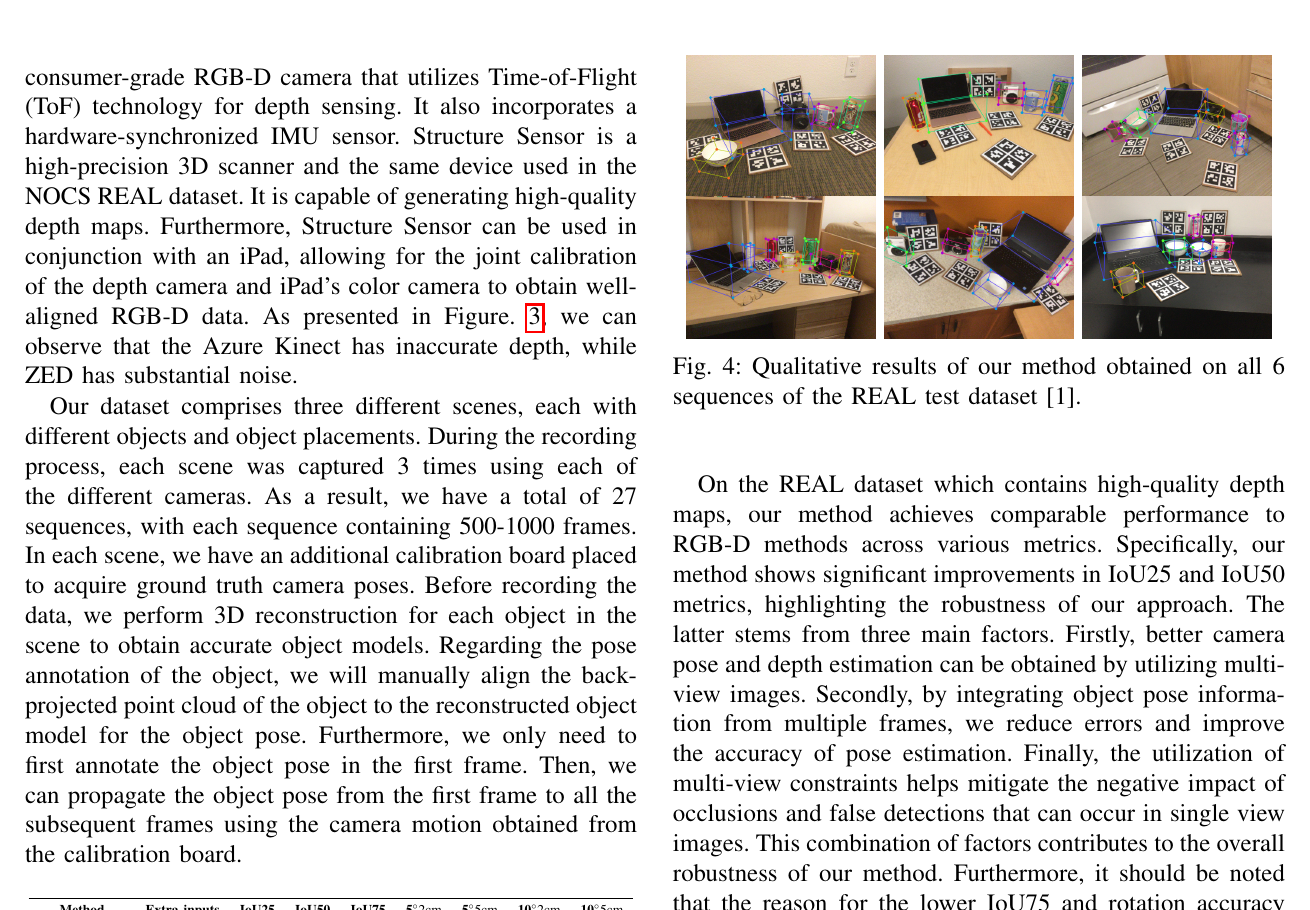 原论文结果页截取:右上展示 Figure 4 的 REAL 六条测试序列定性结果;左侧说明 MEREAL 的传感器、序列采集与对象标注;底部露出 Table I 表头。来源:作者公开稿;图表版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
NOCS REAL:
| 指标 | MV-ROPE |
|---|
| IoU25 | 99.9 |
| IoU50 | 93.6 |
| IoU75 | 60.3 |
| 5°2cm | 31.4 |
| 5°5cm | 46.6 |
| 10°2cm | 46.1 |
| 10°5cm | 73.7 |
IoU25 / 50 很高,但严格旋转阈值并非领先所有 RGB-D 方法。作者认为类别内 variation 让 NOCS 旋转质量不足;这说明多视图主要提升位置、尺度和鲁棒性,不能自动解决规范坐标定义。
MEREAL:
- 3 个场景,每个场景由 ZED、Azure Kinect、Structure Sensor 各录 3 次,共 27 条序列;
- 每条 500–1000 帧;
- 校准板提供相机轨迹真值,3D 重建与首帧对象 pose 手工配准后向后传播;
- 三传感器上的 mean rotation error 为 15.2° / 14.4° / 12.9°;
- mean translation error 为 8.3 / 3.6 / 6.6 cm。
这些结果显示系统对尺度源和传感器差异可适配,但旋转误差仍明显。
5. 批判性分析
- 优势:问题建模符合移动机器人观测过程;SLAM depth 与对象图都可解释;自建序列覆盖三种设备。
- 限制:静态对象假设强;关联只依赖 IoU;相机轨迹失败会系统性污染所有对象;公开 REAL 是从单帧数据适配,未完全体现视频协议公平性。
- 指标解读:IoU 优势不等于严格 rotation 优势,应同时查看
5°2cm。
- 可扩展方向:加入对象外观 embedding 与不确定性关联;联合优化相机 / 对象而非串联;扩展到动态对象和关节物体。
6. 复现清单
- 固定尺度约束来源及其噪声模型;
- 报告 SLAM tracking failure 与 keyframe policy;
- 保存单帧 pose、图优化前后 pose 和关联 ID;
- 使用统一的 NOCS 对称定义;
- 分别统计相机误差、关联错误和对象 pose 误差;
- 对动态对象进行静态假设违背测试。
7. 最终评价
MV-ROPE 的主要贡献是把类别级 pose 从单帧感知提升到多视图几何系统。它说明消费级 depth 不稳定时,可以用视频 SLAM 与尺度约束替代;同时也显示 NOCS 旋转与对象关联仍是系统上限。
