论文精读笔记:Marrying NeRF with Feature Matching for One-step Pose Estimation
1. 基本信息
2. 一句话定位
这项工作用一次显式的 correspondence geometry 替代 inverse-NeRF 的数百步 photometric optimization:NeRF 负责从任意初始视角生成 RGB、depth 和可提升的 3D 点,LoFTR 负责连接渲染图与目标图,PnP 负责一次求解相机位姿。
2.1 图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 2 | one-step 主流程 | 2D–2D match 如何借 NeRF depth 变成 2D–3D |
| Table I / Figure 3 | Synthetic、LLFF 主结果 | 分清一步结果与带 refinement 的完整结果 |
| Figure 4–6 / Table II | 遮挡、几何筛选与消融 | 两个附加模块分别解决何种失败 |
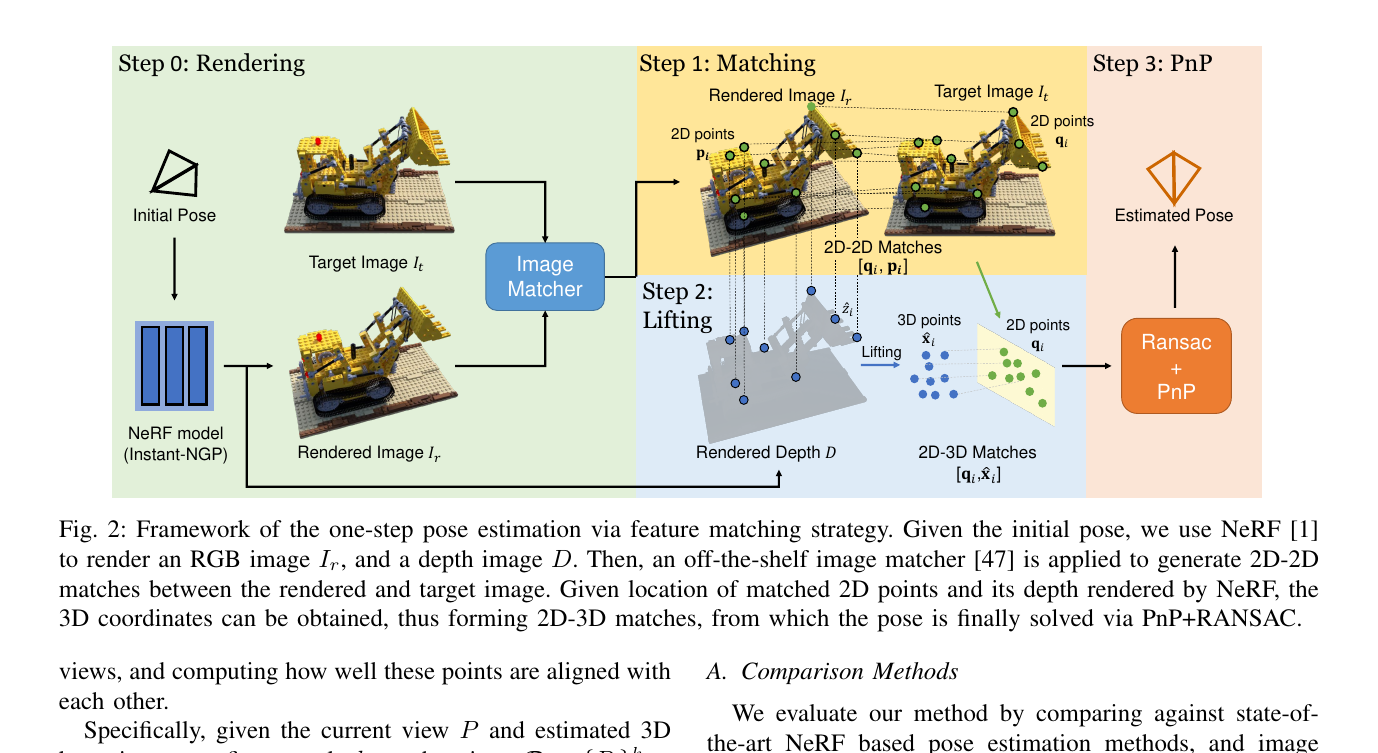 原论文 Figure 2:从初始位姿渲染 RGB / depth,用 LoFTR 匹配目标图,将渲染端像素提升到 3D,最后由 RANSAC-PnP 求解。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与容易误读之处
| 条件 | 是否需要 |
|---|
| 单张 query RGB 与内参 | 是 |
| object-specific NeRF | 是 |
| 多视图图像训练 NeRF | 是 |
| CAD / mesh | 否 |
| 初始相机位姿 | 是 |
| test-time 梯度优化 | 主流程否;完整版本有短 refinement |
论文标题里的“one-step”是相对 iNeRF 的数百次 pose-gradient steps 而言。算法必须先在某个初始位姿渲染,因此不应描述成 IFFNeRF 那样的 initialization-free pose retrieval。它解决的是“从不够准确的初值快速校正到目标位姿”。
4. 方法详解
4.1 NeRF 提供可微表示之外的几何接口
Instant-NGP 从对象的 posed multiview images 学习 radiance / density field。给定初始位姿 P,体渲染同时产生颜色图 Ir 与期望深度:
z^(p,P)=i∑ωiti,
其中 ωi 是沿 ray 的 volume-rendering weights。本文并不对 P 反向传播,而是把 z^ 当成显式几何。
4.2 Match–lift–PnP
LoFTR 在目标图 It 和渲染图 Ir 间产生匹配 (qi,pi)。渲染端像素按
x^i=Pz^iK−1p~i
反投影到世界坐标,得到 (qi,x^i) 的 2D–3D 对应,再用 RANSAC-PnP 求 pose。这样避免了 photometric objective 的非凸优化,也把局部对齐能力交给了预训练 matcher。
4.3 3D Consistent Point Mining
NeRF 的“深度”不一定是真实表面,少视图、pose noise 和 floaters 都会让同一点在不同视角下复算出不同 3D 坐标。作者对每个候选点从 k 个邻近相机重新渲染 / 回投,依据 3D 坐标方差筛掉不稳定点。该模块使 NeRF 从“会渲染”进一步变成“可用于几何求解”。
4.4 Keypoint-guided Occlusion Robust Refinement
传统 inverse-NeRF 在整张目标图上做 RGB loss,遮挡物会制造大量错误 residual。本文只围绕已经匹配成功的 keypoints 采样像素,缩小到较可能属于目标本体的区域,再做短程优化。这一策略不是遮挡分割,而是通过稀疏可靠锚点改变采样分布。
5. 实验与结果
论文使用 NeRF Synthetic 的 8 个场景和 forward-facing LLFF。正确率分别以 rotation / translation threshold 判断,同时报告平均旋转误差 mRE 和平均平移误差 mTE。LLFF 的平移数值处于其场景坐标系,不能直接换算成毫米。
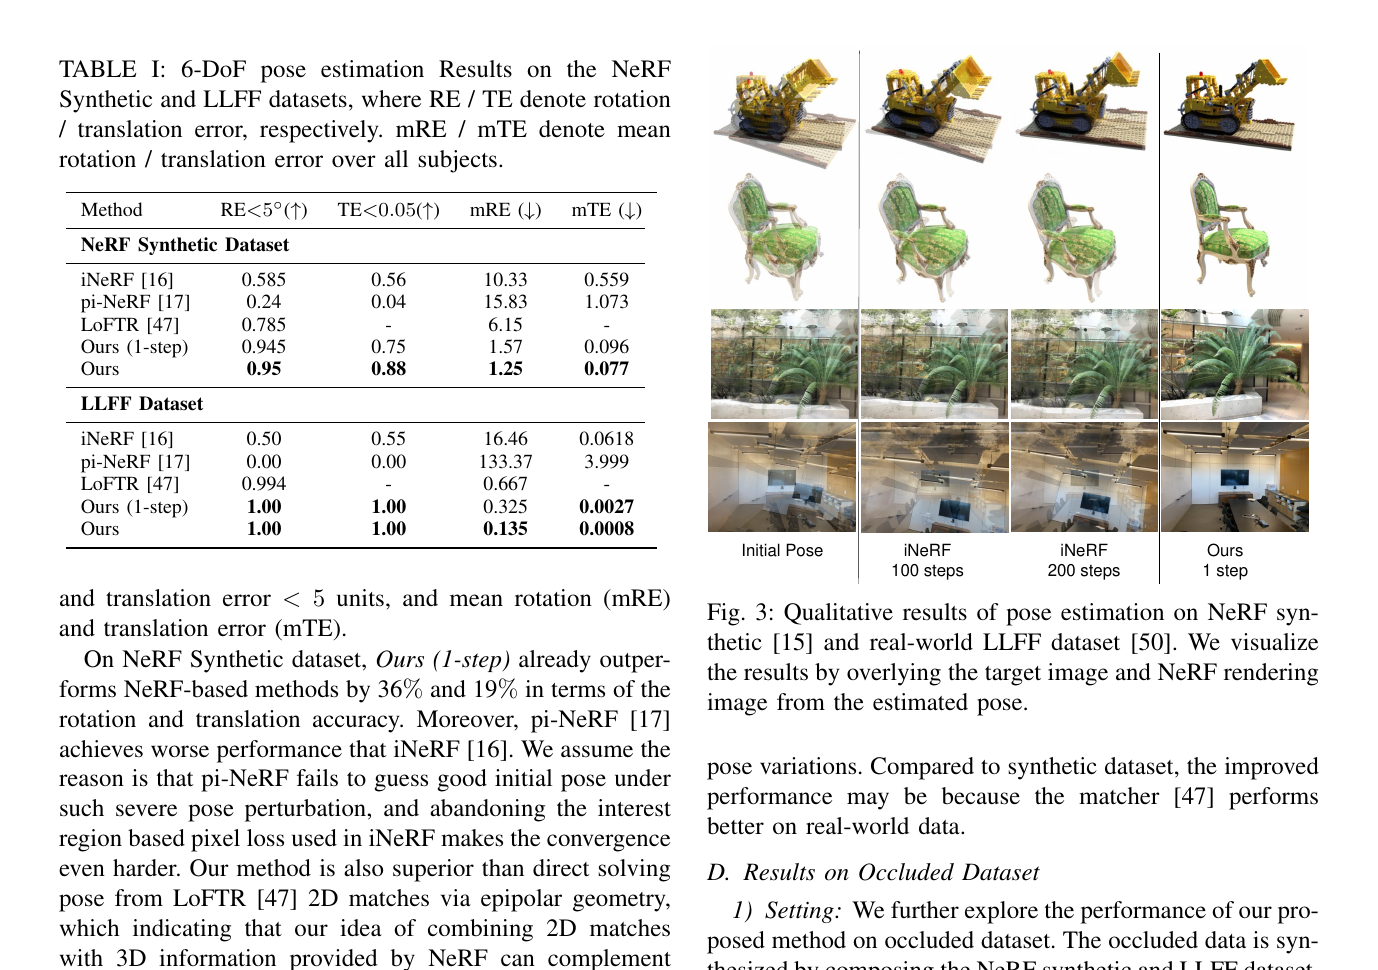 原论文 Table I / Figure 3:一步解算与完整 refinement 的结果,以及 NeRF Synthetic 上的对齐示例。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 数据 | 方法 | Rot. / Trans. 正确率 | mRE | mTE |
|---|
| Synthetic | iNeRF | 58.5% / 56.0% | 10.33° | 0.559 |
| Synthetic | Ours, 1-step | 94.5% / 75.0% | 1.57° | 0.096 |
| Synthetic | Ours, full | 95.0% / 88.0% | 1.25° | 0.077 |
| LLFF | iNeRF | 50.0% / 55.0% | 16.46° | 0.0618 |
| LLFF | Ours, 1-step | 100% / 100% | 0.325° | 0.0027 |
| LLFF | Ours, full | 100% / 100% | 0.135° | 0.0008 |
论文把约 50 ms rendering、60 ms matching、15 ms PnP 等组件计入后报告约 6 FPS;相对其迭代式对比约快 90 倍。需要注意,NeRF 的约 5 分钟对象级训练不在在线延迟中。
5.1 消融该怎样读
- 3D consistency 在 Synthetic 上把一步结果从约 2.08∘/0.133 改善到 1.57∘/0.096,说明深度噪声确实会污染 PnP。
- keypoint-guided refinement 在遮挡数据上把误差从约 0.562∘/0.33 降至 0.518∘/0.29;方向正确,但提升并非数量级变化。
- 完整方法比一步解算更准,所以“one-step”主要代表强 initialization,而不是最终完全无需 refinement。
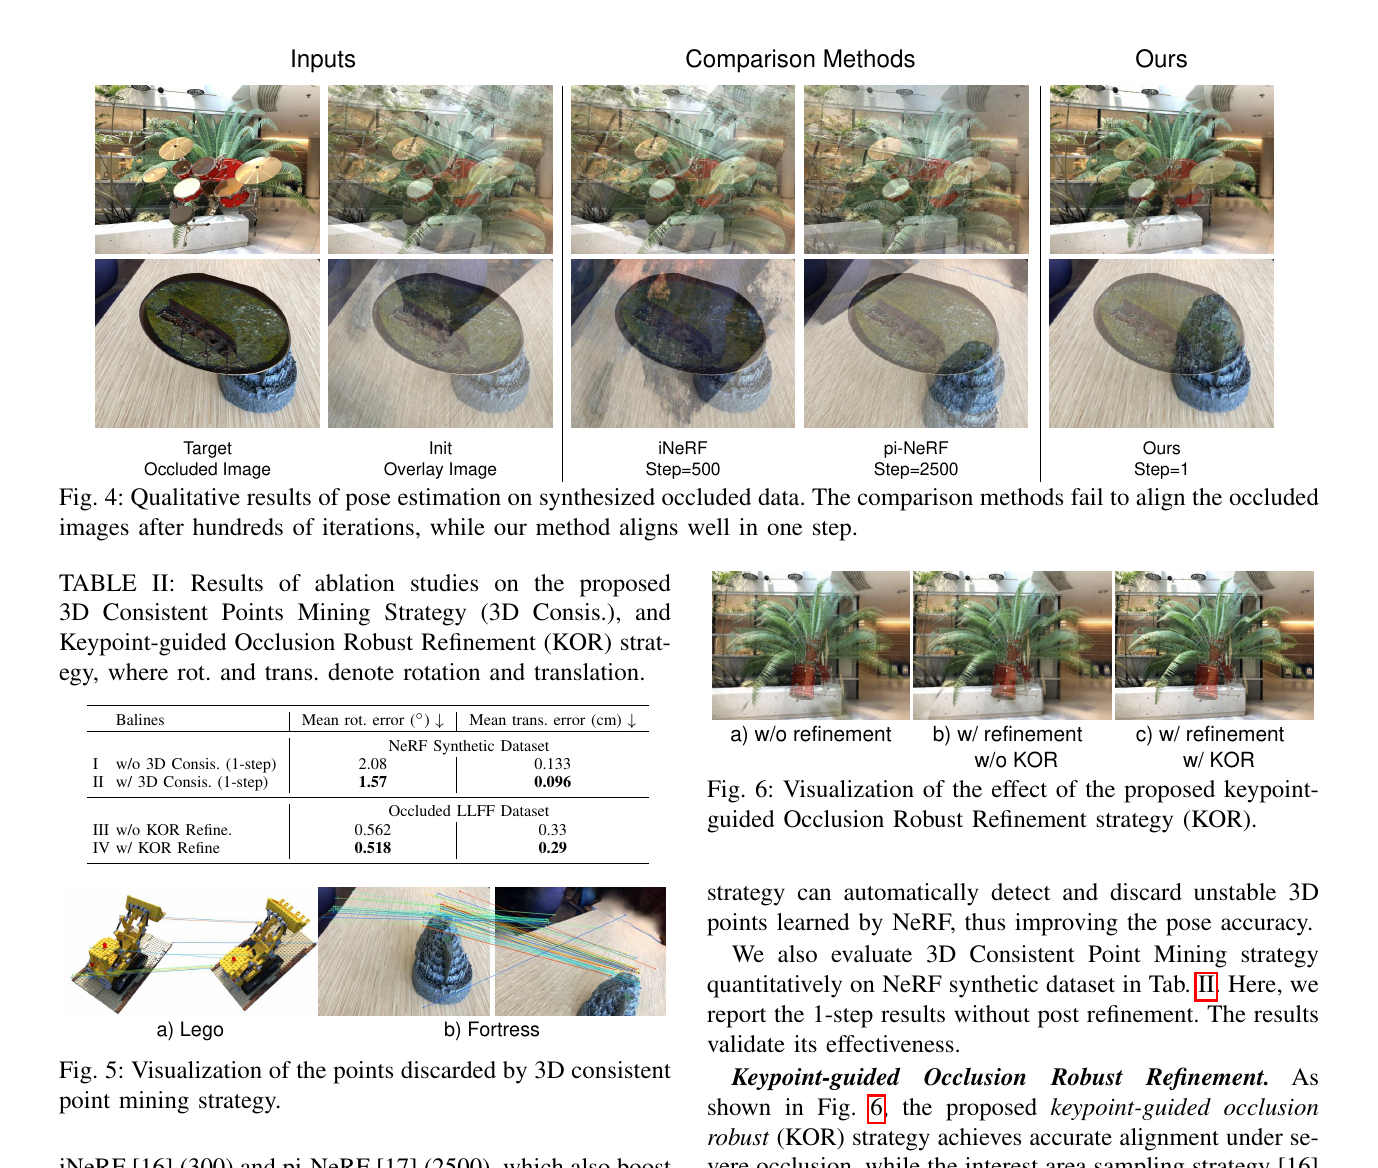 原论文 Figure 4–6:遮挡合成样例、被 3D consistency 剔除的点,以及围绕匹配点采样的 refinement。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6. 优点、局限与适用场景
优点
- 把 neural rendering 与成熟的 2D–3D 几何求解连接得很自然。
- 推理路径清晰,误差来源可以分解为渲染、匹配、深度和 PnP。
- CAD-free,且对象级准备时间比许多重训练方案短。
局限
- 仍需要初始 pose;初始渲染与目标视角差得过大时,LoFTR 也无法建立对应。
- 每个新对象仍需多视图采集、相机 pose 和 NeRF 训练。
- Synthetic / LLFF 缺少 BOP 式 symmetry、实例遮挡、背景 clutter 与 metric pose 协议。
- NeRF depth 不是经过尺度与表面精度保证的 CAD geometry。
- 论文的遮挡实验是合成遮挡,不能替代真实手–物交互或堆叠场景。
7. 研究启发
这篇论文提供了一个很实用的模式:不要只把 NeRF 当可微 renderer,也可以把它当“从当前视角即时生成带深度模板的数据库”。后续值得研究的方向包括多初值检索、对称感知 PnP、NeRF depth uncertainty 加权,以及把 object-level NeRF 换成可跨实例泛化的 3D Gaussian / foundation feature field。
