论文精读笔记:Occlusion-Aware 6D Pose Estimation with Depth-Guided Graph Encoding and Cross-Semantic Fusion for Robotic Grasping
1. 论文定位与阅读结论
本文是一个面向已知对象、RGB-D、2D–3D correspondence、严重遮挡的实例级 6D pose framework,也是 ICRA 2025 Best Conference Paper Finalist。
作者指出,直接用深度网络回归 pose parameters 的方法没有充分建模遮挡场景中表面点的“非相邻、复杂关系”。他们提出:
- depth-guided graph neural network;
- object mask 与 binary code 的 adaptive cross-semantic fusion;
- 用增强 graph features 与 fused semantics 改善 correspondence 及最终 pose。
作者摘要报告 LM-O 和 YCB-V 上相对比较方法提升 1.2% 与 1.9%,部分对象最高 30%,并完成真实 pose test。正文非开放获取,因此本页对具体图构造、loss 与 solver 保持未核验状态。
2. 遮挡为何破坏 2D–3D correspondence?
对于已知 CAD 模型上的三维点 Xj,理想对应像素满足:
λujvj1=K(RXj+t).
对应足够多且 outlier 可控时,可由 PnP / RANSAC 或几何拟合恢复 (R,t)。遮挡会同时破坏三个条件:
- 可见 correspondence 数量减少;
- 可见点集中在局部,几何条件数变差;
- 邻近像素可能属于遮挡物或另一对象,语义 outlier 增加。
更麻烦的是,可见区域可能被切成多个不连续 patch。局部卷积或 kNN point feature 能感知每个 patch 内部,却未必能连接“物理上属于同一表面结构、图像上相距很远”的证据。作者正是用 depth-guided graph 解决这一 non-local relation。
3. Depth-guided graph encoding
公开摘要确认 GNN 由 depth information 引导,用于建模潜在的 surface-point relationships。其高层作用可以写为:
hi′=ϕ(hi,j∈N(i)AGGψ(hi,hj,Δpij)),
其中 pi 可由 depth 和相机内参反投影得到,N(i) 是图邻域。这是解释图消息传递的一般形式,不是论文未公开公式。
与只按 2D 像素邻接不同,depth-guided edges 可以利用三维距离、表面关系或其他几何条件,将图像中分离但三维结构相关的可见点联系起来。作者摘要明确强调“non-adjacent and complex relationships”,但没有披露:
- 节点是像素、点云点、patch 还是 code token;
- edge 按 3D kNN、learned affinity 或 mesh topology 构造;
- depth 进入 edge、node feature 还是 attention bias;
- 图层数与复杂度。
因此,本页只分析其功能,不将常见实现当作本文事实。
4. Mask 与 binary code 的 cross-semantic fusion
4.1 两类语义分别提供什么?
Object mask 是低频语义:它回答“这个像素是否属于目标对象”。对排除背景和邻近实例非常关键,但不能区分对象内部表面位置。
Binary surface code 是高频语义:它通常把 CAD 表面离散区域编码为多位二进制标签。若预测正确,可把像素定位到模型表面,直接形成 2D–3D correspondence;但在遮挡、边缘和相似局部上容易逐位出错。
两者具有互补性:
mask⇒foreground support,binary code⇒surface identity.
作者提出 adaptive fusion,而不是简单拼接,意味着网络根据观测质量调整两类语义贡献。摘要没有公布 gating / attention 公式,所以当前不能判断融合发生在 logits、feature 还是 correspondence confidence 层。
4.2 为什么 cross-semantic 有助于遮挡?
- mask 可抑制遮挡物产生的错误 code;
- binary code 可在 mask 内区分重复外观的不同 CAD 区域;
- graph feature 可利用 depth geometry 修正局部 code ambiguity;
- 三者共同提高 correspondence inlier ratio。
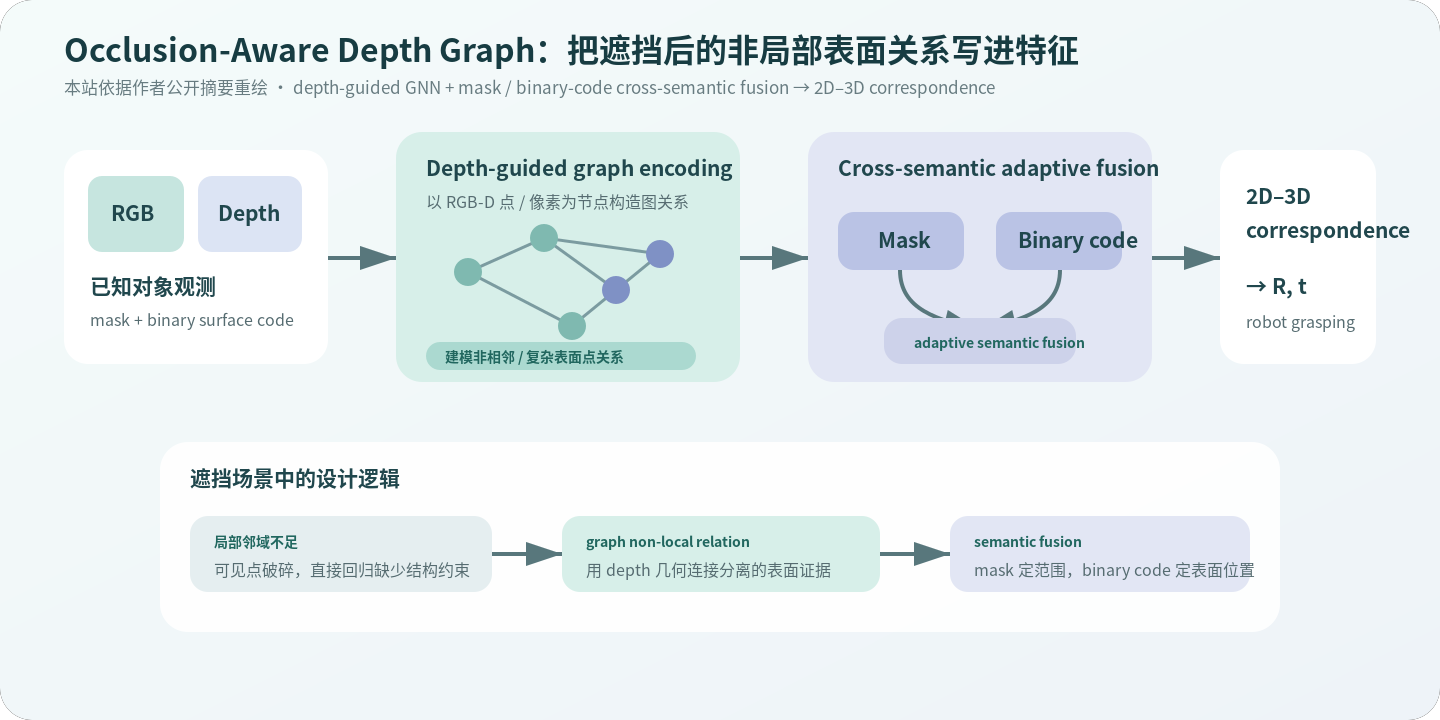 本站依据作者公开摘要重绘,非论文原图。图中的节点和融合箭头只用于解释“depth-guided non-local relation + adaptive cross-semantic fusion”,不代表论文具体网络拓扑。论文内容版权归原作者,重绘用于学术解读。来源:论文 DOI。
5. 从 correspondence 到 pose
公开摘要说 mask / binary code 用于提取 “2D–3D correspondence related features”,但没有披露最终 pose solver。常见选择包括:
- code 解码得到 model point,再用 PnP / RANSAC;
- 稠密 correspondence 进入可微 geometric solver;
- correspondence feature 再经网络直接回归 (R,t)。
metadata 将其归入 correspondence 路线是合理的,但详情页不指定 solver。取得正文后需要核验:outlier rejection、confidence weighting、对称 code 与 final refinement。
6. 实验结果
摘要披露:
| 数据集 / 范围 | 相对提升 |
|---|
| LM-O | 1.2% |
| YCB-V | 1.9% |
| certain objects | up to 30% |
| 真实场景 | pose-estimation test 验证有效 |
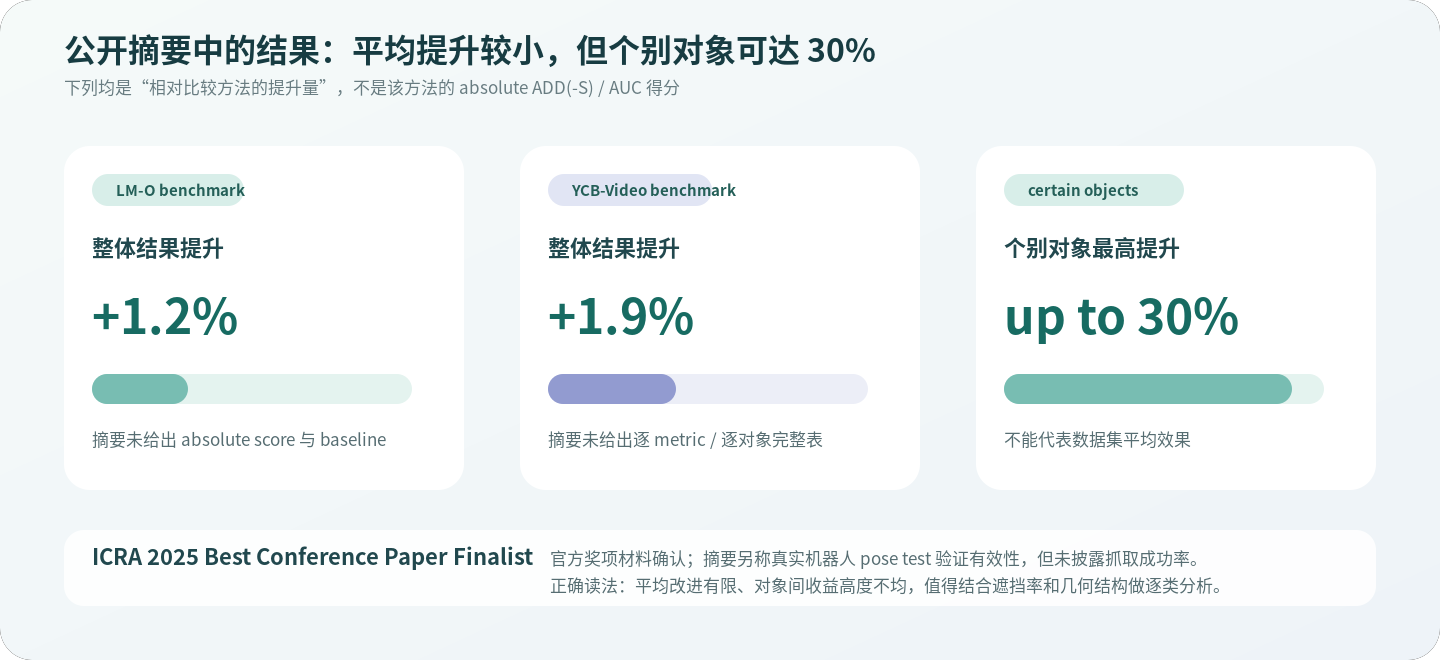 本站依据作者公开摘要重绘。所有数值都是 relative improvement,不是 absolute metric;个别对象 30% 不能代表平均。Finalist 身份由 ICRA 官方奖项册确认。论文来源:DOI。
7. 为什么“平均 +1.x%,个别 +30%”值得分析?
这种分布通常意味着模块不是均匀增强所有样本,而是针对某类 failure regime 起作用。可能相关的因素包括:
- 某对象在 LM-O 中遮挡更严重;
- 对象局部几何重复,local feature 易混淆;
- binary code 对某些表面区域特别脆弱;
- depth graph 在稀疏可见 patch 间提供了关键连接;
- baseline 已经很强,多数对象天花板高。
这些是对结果形态的解释假设,不是论文逐对象消融。要验证必须查看完整 per-object table,并把提升与 visibility fraction、symmetry 和 surface complexity 相关联。
8. 指标口径与未知项
metadata 收录 ADD(-S) / AUC,是该类 benchmark 的常见协议,但公开摘要本身没有说明“1.2% / 1.9%”具体对应:
- ADD(-S) accuracy;
- ADD(-S) AUC;
- BOP-style AR;
- 或作者自定义 aggregate。
因此页面不把这三个提升量标成某个确定 metric。还未公开:
- absolute scores;
- compared methods;
- train split 与 synthetic / real data;
- object mask 是 GT 还是 predicted;
- binary code predictor 是否共同训练;
- runtime 与参数量;
- real test 的对象、trial 和抓取成功率。
9. 批判性分析
9.1 优点
- 问题和模块对应明确:non-local graph 对遮挡破碎,cross-semantic fusion 对 mask / code 互补;
- RGB-D 与 known CAD 场景适合机器人抓取;
- LM-O + YCB-V 同时验证,不只单一 benchmark;
- 官方 Best Paper Finalist 增强了工作的重要性信号;
- 真实测试使方法不止停留在离线表格。
9.2 限制
- 仍依赖前端 mask;mask 漏掉被遮挡的细小可见区,后续 graph 无法恢复不存在的节点;
- depth 在反光 / 透明 / 边缘处可能最不可靠,恰好是图构造的关键;
- binary code 是离散表面表示,逐 bit 错误如何传播取决于编码和 solver;
- graph 增加计算与内存,是否满足实时抓取未知;
- absolute gain 和真实抓取指标未公开,无法评估工程收益。
10. 复现清单
取得全文后应优先补齐:
- graph node / edge 定义、邻域和 depth guidance 公式;
- RGB 与 depth backbone、feature resolution;
- mask / binary code 的来源与监督;
- adaptive cross-semantic fusion 结构;
- correspondence 解码、confidence 与 pose solver;
- symmetry handling;
- LM-O / YCB-V 的确切 metric 和 absolute table;
- per-object +30% 对应哪些对象和 baseline;
- 每个模块消融;
- real robot setup、detector、trial 与 success criterion;
- FPS、硬件、参数量和显存。
11. 研究启发
这篇工作提示遮挡 pose 不应只靠“更强局部特征”,还要显式建模可见片段之间的关系。可进一步尝试:
- 将 depth edge 变为带 uncertainty 的概率边;
- 用 visibility-aware graph pruning 避免遮挡物跨实例错误连接;
- 让 binary code 输出 bit-wise confidence,并在 PnP 中传播;
- 对称对象使用 code equivalence class 而非单一 surface ID;
- 把 graph improvement 与 visibility / geometry regime 绑定报告,而不是只给平均值。
总的来说,本文在 ICRA 2025 物体位姿专题中代表“结构化遮挡推理”方向:以图关系补足局部可见性,以跨语义融合提高 correspondence 可靠性。现有公开摘要足以确认方法定位、提升量与奖项,但还不足以做公式级复现或完整排行榜比较。
