论文精读笔记:Omni6D
1. 核心判断
Omni6D 的贡献不是又增加一个更大的合成数据集,而是把类别级 6D pose 的默认问题从“少数类内泛化”推进到“大词汇、长尾、跨类别泛化”:
- 166 类和 4,688 个实例让类别内、类别间 shape variation 同时出现;
- 自由落体摆放打破 NOCS / CAMERA 常见的 upright bias;
- symmetry 从 category-level convention 下沉到 instance-level 三轴标注;
- Omni6Dout 明确测试训练未见类别;
- category-count scaling 实验直接检验方法能否随词汇扩展。
最值得保留的结论是:现有方法在 translation / size 上还能泛化,但 rotation 对类别扩展极为敏感。只看 IoU50 或 5cm 会对系统能力产生过于乐观的判断。
2. 数据到底“真实”在哪里
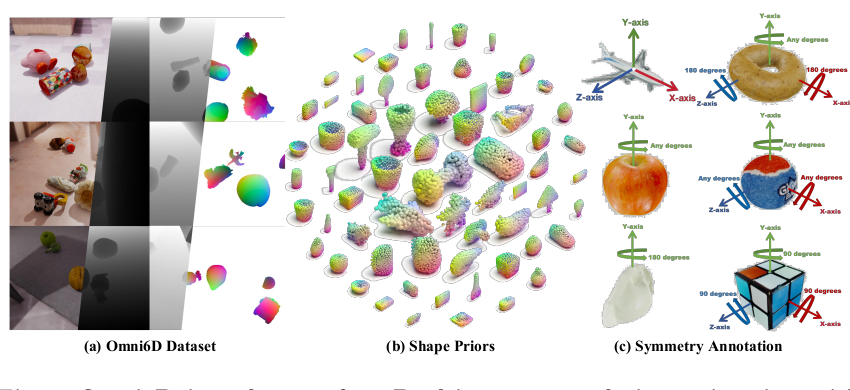 原论文 Figure 1。对象资产来自真实物体扫描,包含 geometry 和 texture;RGB-D、NOCS、mask 与 pose 观测则是在 Replica 场景中渲染得到。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
论文表格将 Omni6D 的 3D model 标为 “Real-Scanned”,容易被转述成“80 万真实图像”。准确拆分如下:
- 真实扫描:OmniObject3D 的 4,688 个 textured meshes;
- 合成场景:9 个 Replica rooms;
- 合成摆放:BlenderProc 2.5.0 内让每场景 6–8 个对象自由落体,object scale 随机为 0.8–1.2;
- 合成相机:每场景 10 个视角,相机半径 8–9 m、elevation 30°–90°;
- 合成输出:640×480 RGB、depth、mask、NOCS、pose、size,intrinsics 为 [577.5,577.5,319.5,239.5]。
因此它比 primitive CAD 渲染具有更真实的 object shape / texture,但仍受 renderer、Replica lighting、传感器噪声和 compositing 的 domain gap 约束。
3. 规模、切分与标注
数据覆盖 166 类、4,688 个 instances 和超过 0.8M captures。对象实例以 7:2:1 切分为 Omni6Dtrain / val / test,使 test 中的实例训练不可见、类别可见。
另设 Omni6Dout:
- 52 个对象模型;
- 17 个训练阶段完全未见类别;
- 4,762 幅图像。
该拆分把两类泛化分开:
- test:unseen instance within seen categories;
- out:unseen instances from unseen categories。
论文还构建了 Omni6D-Real:30 个真实场景、39 类、73 个 instances、约 1K Azure Kinect 图像;mask 用 SAM 辅助,object pose 通过 ICP registration 获得。它适合作小规模 domain-transfer sanity check,不足以取代大规模真实 benchmark。
4. 实例级三轴 symmetry
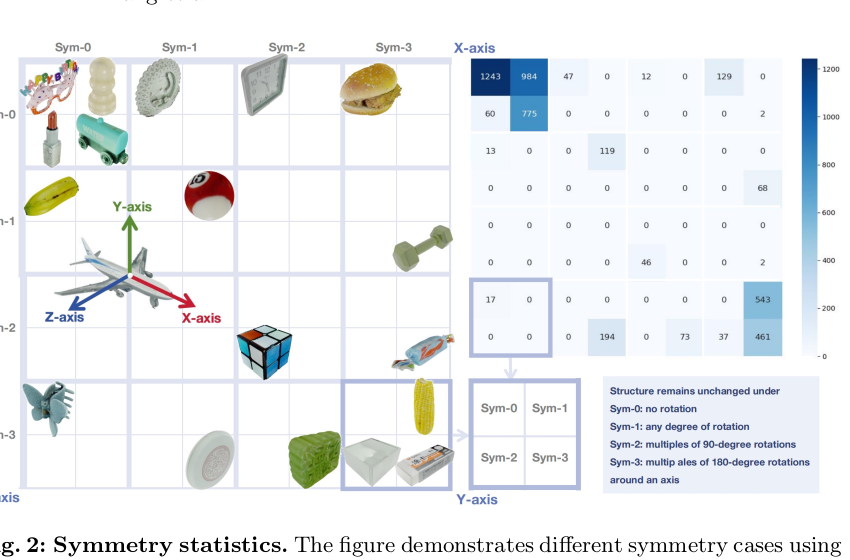 原论文 Figure 2:每个实例在 x / y / z 轴分别标注无对称、连续对称、90° 或 180° 离散对称;右侧矩阵统计各种三轴组合。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
设预测旋转为 R^,GT 为 R,实例的等价旋转集合为 S。symmetry-aware rotation error 应写为:
eR=S∈Smind(R^,RS),
其中 d 是 SO(3) geodesic angle。Sym-0 / 1 / 2 / 3 分别代表无等价旋转、轴向任意角度、90° 倍数和 180° 倍数。三轴组合最多产生 43 次计算。
该设计比“整类统一成轴对称”更合理:同属 bottle、lamp 或 toy 的实例可能因 handle、logo 或局部 geometry 而有不同对称。它也有近似边界:
- 连续 symmetry 被离散评测近似;
- 标注依据主要是 shape invariance,不一定反映 texture;
- 多轴离散旋转的组合可能存在重复;
- canonical frame 本身仍由人工 convention 决定。
5. 数据分布为什么更难
论文分析显示:
- object centroid 与 CAMERA / REAL 的空间分布相近,但遮挡和 point-cloud spatial variation 更强;
- object relative size 分布更宽;
- free-fall 让相对向上方向的 rotation 更均匀,减轻 upright prior;
- VAE shape priors 再做 agglomerative clustering 后,几何相近但语义不同的类别会聚到同一 cluster。
作者发现方法表现与 shape cluster 中的 instance count 比单一 semantic class 的样本数更相关。这暗示类别级模型真正学习的并不完全是名称标签,而是跨类别共享的 geometric modes。数据采样若只追求每类均衡、忽略 shape diversity,未必能提升泛化。
6. 已见与未见类别主结果
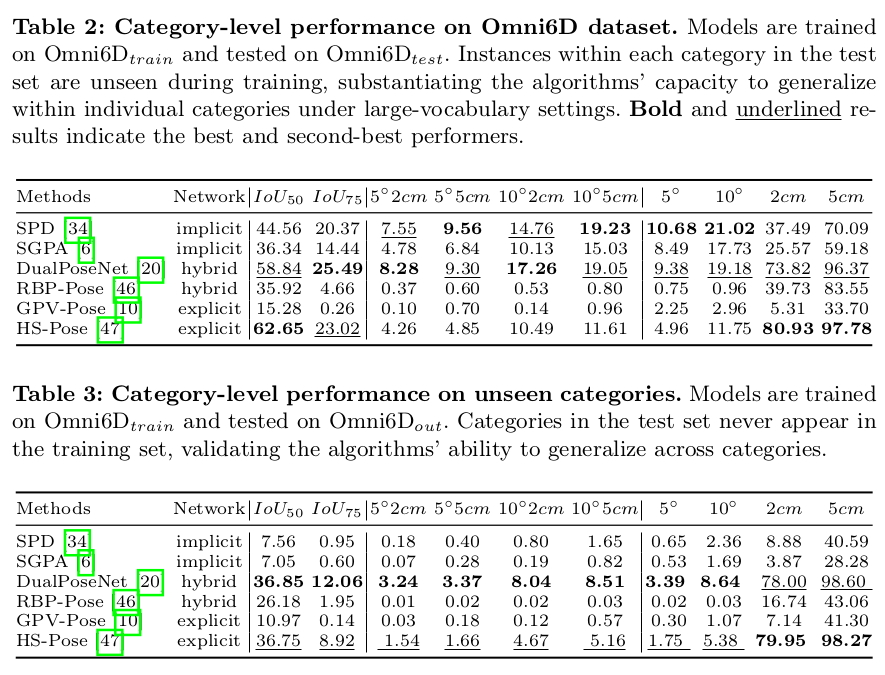 原论文 Table 2–3。所有方法均输入 GT mask;Table 2 测试已见类别内的新实例,Table 3 测试训练未见类别。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
6.1 Seen categories
| 方法 | IoU50 | IoU75 | 5°2cm | 10°5cm | 2cm | 5cm |
|---|
| SPD | 44.56 | 20.37 | 7.55 | 19.23 | 37.49 | 70.09 |
| DualPoseNet | 58.84 | 25.49 | 8.28 | 19.05 | 73.82 | 96.37 |
| HS-Pose | 62.65 | 23.02 | 4.26 | 11.61 | 80.93 | 97.78 |
HS-Pose 在 translation 与 IoU 上突出,但严格 rotation-translation 指标反而弱。以 HS-Pose 为例,5cm 已达 97.78,而 5°2cm 只有 4.26:模型很可能把中心和大小放对,却没有恢复可用 orientation。
6.2 Unseen categories
| 方法 | IoU50 | IoU75 | 5°2cm | 10°5cm | 2cm | 5cm |
|---|
| SPD | 7.56 | 0.95 | 0.18 | 1.65 | 8.88 | 40.59 |
| DualPoseNet | 36.85 | 12.06 | 3.24 | 8.51 | 78.00 | 98.60 |
| HS-Pose | 36.75 | 8.92 | 1.54 | 5.16 | 79.95 | 98.27 |
显式 translation / size heads 的 DualPoseNet 与 HS-Pose 保持很高 2cm / 5cm,但 rotation 仍崩溃。这里的“unseen category generalization”不能用 5cm 单项指标证明,至少要同时报告 angular thresholds。
7. 类别规模实验
作者从 3、6、12、24 到 48 类逐步扩大训练词汇,并比较 scratch 与从前一级 fine-tune。fine-tune 通常优于重新训练,但随着类别数增加仍持续下降;HS-Pose 的 5°2cm 从 3 类 62.52 降到 48 类 14.42。
这表明:
- 加类不是把同一模型喂更多独立样本;
- 网络容量、共享 shape prior 与 class-conditioned head 会互相干扰;
- curriculum / fine-tuning 能缓解 optimization,无法根治 representation conflict;
- 在 NOCS 六类上成立的结构,不应直接外推到大词汇场景。
8. Synthetic-to-real 结果
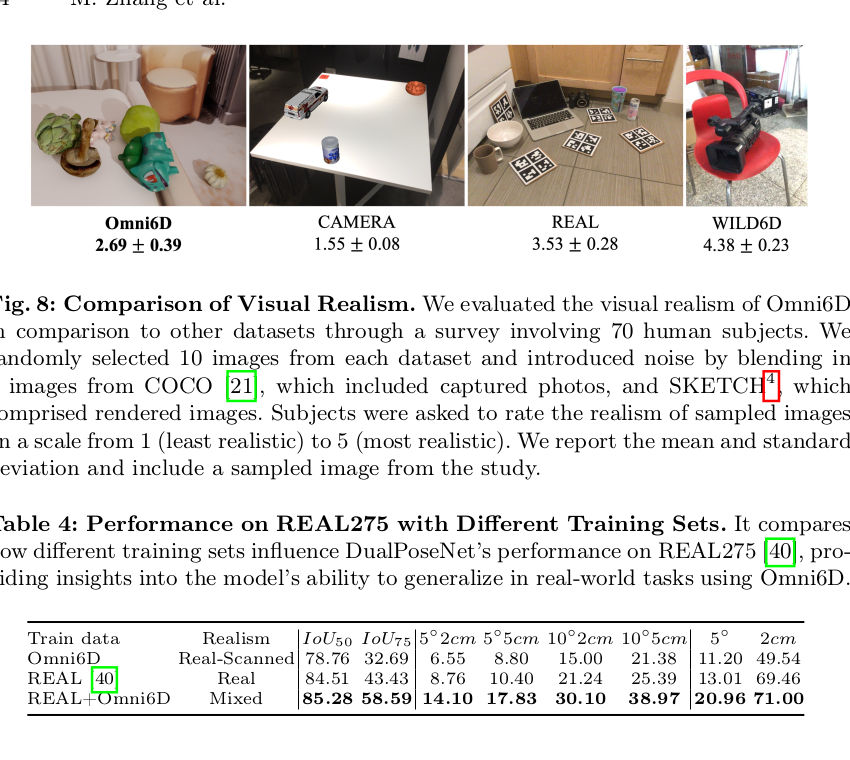 原论文 Figure 8 与 Table 4。70 名参与者的主观真实度均值为 2.69±0.39;DualPoseNet 在 REAL275 上由 Omni6D-only 的 IoU75 32.69 提升到 REAL+Omni6D 的 58.59。来源:ECVA 正式论文;图表版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
70 人视觉真实度调查中,Omni6D 为 2.69±0.39,高于 CAMERA 的 1.55±0.08,低于 REAL 的 3.53±0.28 与 WILD6D 的 4.38±0.23。这支持“扫描资产 + 室内 PBR”更接近真实,但不是 photoreal。
DualPoseNet 在 REAL275:
| 训练集 | IoU50 | IoU75 | 5°2cm | 10°5cm |
|---|
| Omni6D | 78.76 | 32.69 | 6.55 | 21.38 |
| REAL | 84.51 | 43.43 | 8.76 | 25.39 |
| REAL + Omni6D | 85.28 | 58.59 | 14.10 | 38.97 |
Omni6D 能提供有效预训练 / augmentation,联合训练的 IoU75 比 REAL-only 高 15.16 points;但 Omni6D-only 在严格 pose 上仍明显落后,不能据此宣称 synthetic-to-real 已解决。
9. 评测边界与局限
- 主表使用 GT masks,没有测 large-vocabulary detection、classification 和 mask error;
- 真实扫描 meshes 不等于真实图像,renderer / sensor gap 仍存在;
- Omni6D-Real 只有约 1K images,且 mask / registration pipeline 本身会引入标注误差;
- 166 类仍受 OmniObject3D 资产分布限制,不代表开放世界长尾;
- category labels 与 shape clusters 不一致,传统 class-conditioned architecture 未必是合适归纳偏置;
- symmetry-aware minimum error 可能让 texture-distinguishable orientation 被判等价;
- 单帧数据为主,作者将视频扫描与时序建模留作未来工作;
- 附录扩展 Omni6D-xl 到 13,161 instances / 339 categories,但主实验与本文结论基于基础版 Omni6D。
10. 使用与复现检查表
- 明确写清对象资产真实扫描、观测合成渲染;
- 保持 7:2:1 instance split,禁止同一 mesh 跨 train / test;
- 独立报告 seen-category 与 unseen-category;
- 同时报告 IoU、rotation-only、translation-only 和 joint thresholds;
- 把 GT-mask pose backend 与真实 detector / segmenter 的系统结果分开;
- 评测时按每个 instance 的三轴 symmetry 集取最小误差;
- 统计 head / common / tail classes 与 shape-cluster frequency;
- 复现实验固定 BlenderProc、Replica 房间、相机分布、对象尺度和自由落体参数;
- 做真实 depth noise、transparent / reflective object 和 severe occlusion 分层;
- 扩大类数时同时记录 capacity、sampling strategy 与 catastrophic interference。
11. 最终评价
Omni6D 的长期价值在于改变了类别级 pose 的测试问题:它不再问“六个桌面类别能否做得更高”,而是问“方法在 166 类、长尾形状和训练未见类别上是否仍能恢复正确 orientation”。其结果清楚表明,translation 和 size 的高分不能代表 6D pose 已解决。
它也必须被准确使用:主体是由真实扫描对象资产生成的合成 RGB-D,主表使用 GT mask,真实集规模有限。把这些边界写清后,Omni6D 仍是研究 large-vocabulary category-level pose、instance-level symmetry 与类别规模退化时非常有价值的压力测试。
