论文精读笔记:Omni6DPose
1. 核心判断
Omni6DPose 的“universal”不是开放词汇、无需类别训练的 universal,而是:
训练 / 测试共享 149 个类别;
测试对象实例训练不可见;
不给测试实例 CAD;
用同一类别级 representation 处理 pose estimation 与 tracking;
同时覆盖大量 shape、size、transparent / specular materials。
这个边界很重要。它比 NOCS 六类的 category-level setting 大得多,但仍是 known category, unseen instance ,不是任意文本类别或未知类 zero-shot pose。
2. ROPE、SOPE 与 PAM
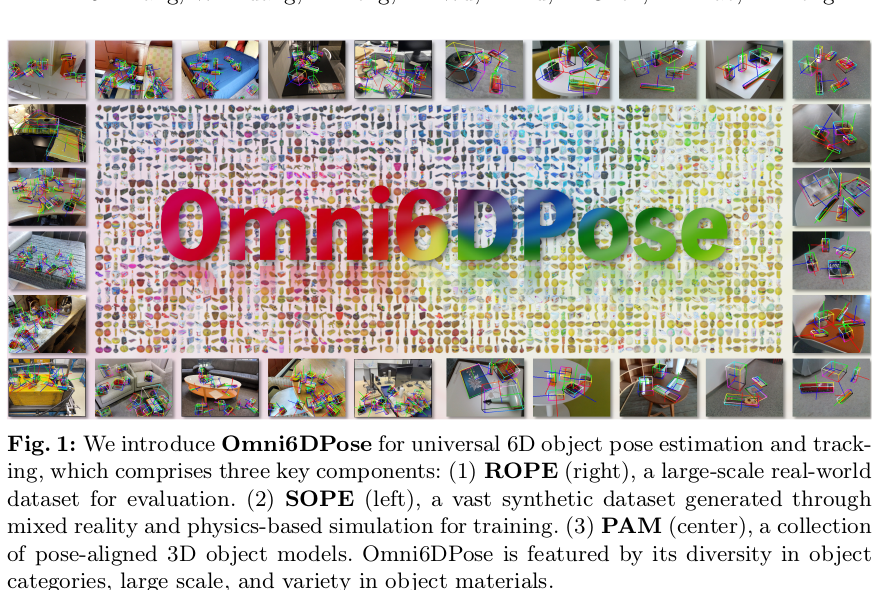
原论文 Figure 1。ROPE 用于真实评测,SOPE 用于合成训练,PAM 提供人工对齐的对象 meshes;数据规模应以论文最终摘要和 Table 1 的 581 / 4,162 个实例为准。来源:ECVA 正式论文 ;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
2.1 ROPE:真实评测
149 categories;
581 object instances;
363 RGB-D videos;
332K images;
1.5M+ pose annotations;
RGB、depth、IR、CAD、mask、pose / scale metadata;
transparent 与 specular objects。
对象用 EinScan H2 或 Revopoint POP 3 扫描。简单 Lambertian 小物体约 15 分钟,复杂、透明或大型对象可达 1 小时;category-level canonical alignment 约 1 分钟 / object。
每段 RealSense D415 视频含 2–6 个对象和 762–1,349 帧。数据不使用外观 marker:SfM 先由 scene features 恢复各帧 camera-to-world T c T_c T c T o T_o T o
这比逐帧标 pose 更一致,但依赖三个假设:场景足够有纹理供 SfM;采集时对象相对世界固定;人工对齐能分辨材质 / symmetry ambiguity。论文没有像 PACE 那样用外部 GT 场景给出角度 / 毫米级标注误差审计。
2.2 SOPE:合成训练
149 categories;
4,162 instances;
475K images;
5M+ annotations。
对象来自 OmniObject3D、PhoCal、GoogleScan 与自扫描资产。RGB 采用 spatially context-aware mixed reality:真实背景来自 19,658 张 Matterport3D、2,572 张 ScanNet++ 和 540 张 IKEA 图像,再合成对象、随机 illumination / material。
Depth 不是理想 z-buffer。作者在 Blender 中渲染结构光传感器的 IR-left / IR-right,再用 stereo matching 生成 depth,主动产生孔洞、误匹配和材质相关噪声。这一点对 transparent / reflective category-level pose 很关键:真实 D415 的 geometry failure 不是简单 Gaussian noise。
2.3 PAM:统一坐标
PAM 保存 pose-aligned meshes 与 meta。人工 category canonicalization 让同类对象共享 orientation convention,是监督 category-level rotation 的前提,也是潜在 label ambiguity 来源。对于外观相似但功能轴不同的对象,canonical convention 可能比图像证据更难学习。
3. GenPose++:从单模态生成到语义条件生成
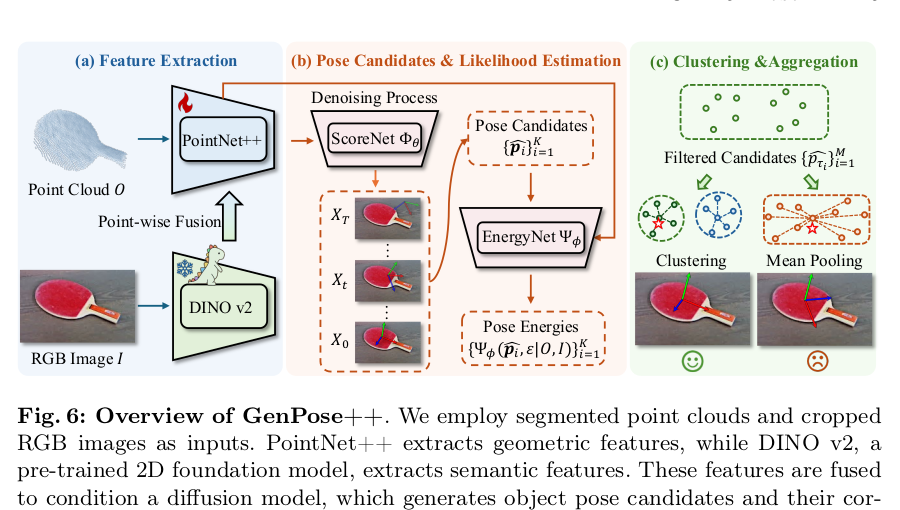
原论文 Figure 6:PointNet++ 与 DINOv2 分别编码 geometry / semantics,扩散 score network 产生 pose candidates,energy network 去除低分样本,DBSCAN 把离散 symmetry modes 分开后再做 cluster 内均值。来源:ECVA 正式论文 ;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
输入是 mask 内 point cloud O ∈ R 3 × N O\in\mathbb R^{3\times N} O ∈ R 3 × N I I I
PointNet++:local 3D geometry;
frozen DINOv2:object appearance 与 category semantics;
point-wise fusion:尽量让局部 RGB feature 与 3D point 对齐,而非只拼 global embeddings。
条件 score network Φ θ \Phi_\theta Φ θ
∇ p log q t ( p ∣ O , I ) , \nabla_p\log q_t(p\mid O,I), ∇ p log q t ( p ∣ O , I ) , 再从 p ( 1 ) ∼ N ( 0 , σ max 2 I ) p(1)\sim\mathcal N(0,\sigma_{\max}^2I) p ( 1 ) ∼ N ( 0 , σ m a x 2 I ) t = 1 t=1 t = 1 ϵ \epsilon ϵ K K K σ min = 0.01 , σ max = 50 \sigma_{\min}=0.01,\sigma_{\max}=50 σ m i n = 0.01 , σ m a x = 50
独立 energy network Ψ ϕ \Psi_\phi Ψ ϕ δ = 40 % \delta=40\% δ = 40%
4. 为什么均值会破坏离散对称
对乒乓球拍这类 180° 离散对称对象,posterior 可能有两个分离 modes。直接对两个 mode 的 rotation representations 求均值,得到的“mean mode”可能两个都不成立。
GenPose++ 在过滤后的旋转候选上使用 DBSCAN:
ϵ ≈ 0.45 \epsilon\approx0.45 ϵ ≈ 0.45 MinPts = 5;
不预设 cluster 数;
选择成员最多的 cluster;
只在该 cluster 内 mean-pool。
它把“概率多峰”与“单个姿态输出”之间的决策显式化,但仍有局限:
最大 cluster 不一定是视觉上正确 mode,尤其采样不均时;
DBSCAN 距离、rotation representation 与 translation weighting 细节影响聚类;
输出仍压缩成单 pose,没有把多个等价 hypothesis 交给下游;
平均结果中去掉 clustering 的 VUS@10°5cm 仅下降 1.6 points,收益集中在离散 symmetry 子集。
额外 scale network 由 pose-conditioned observation 回归 metric size。消融中去掉它后 IoU25 从 39.0 降到 13.8,而 pose VUS 完全不变,说明 3D box overlap 的优势很大部分来自 size head,不应等同于 rotation / translation 改进。
5. 评测指标:AUC 与 VUS 不是单阈值 AP
论文假设 GT instance segmentation,试图排除 detection 对 pose metric 的影响。
5.1 AUC@IoUn
从 3D IoU threshold n n n
5.2 VUS@n°mcm
在 rotation threshold 0 … n ∘ 0\ldots n^\circ 0 … n ∘ 0 … m 0\ldots m 0 … m
6. ROPE pose estimation 主结果
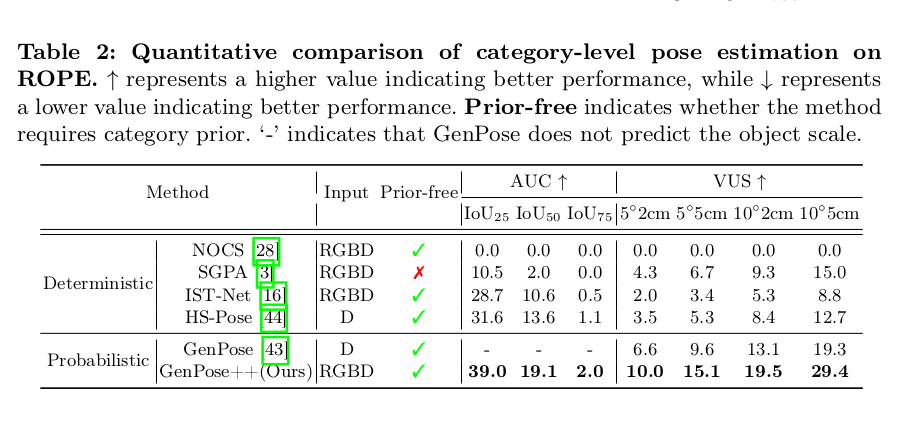
原论文 Table 2。所有方法在 SOPE 训练、ROPE 测试;除 NOCS 自行检测外,其余方法使用 GT detection / segmentation,因此 NOCS 的 0 分不能被解释成 pose head 的纯粹失败。来源:ECVA 正式论文 ;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
方法 输入 AUC IoU25 / 50 / 75 VUS 5°2cm / 5°5cm / 10°5cm SGPA RGB-D 10.5 / 2.0 / 0.0 4.3 / 6.7 / 15.0 IST-Net RGB-D 28.7 / 10.6 / 0.5 2.0 / 3.4 / 8.8 HS-Pose D 31.6 / 13.6 / 1.1 3.5 / 5.3 / 12.7 GenPose D — 6.6 / 9.6 / 19.3 GenPose++ RGB-D 39.0 / 19.1 / 2.0 10.0 / 15.1 / 29.4
GenPose++ 相对 GenPose 的 VUS@5°5cm 增加 5.5 points,支持 RGB semantic conditioning 在大词汇中的价值。但绝对值仍低:IoU75 AUC 2.0、VUS@5°5cm 15.1,不足以宣称 universal pose 已经可靠。
NOCS 行全 0,但它是唯一同时执行 detection 与 pose 的方法,其余方法用 GT segmentation;因此这行混入 detector failure。论文主叙述“focus solely on pose”与 baseline protocol 并不完全一致。
Symmetry-specific augmentation 对所有 baseline 被关闭,因为 NOCS 六类的手工规则不能扩到 149 类。Generative model 学分布确实不需逐类手写 augmentation,但仍依赖 SOPE / PAM 中 pose labels 自身表达多模态。
7. 消融告诉了什么
配置 IoU25 IoU50 VUS 5°5cm VUS 10°5cm Full 39.0 19.1 15.1 29.4 w/o scale prediction 13.8 3.4 15.1 29.4 w/o clustering 38.6 18.7 14.1 27.8 w/o simulated depth 35.3 16.5 11.9 24.3 w/o point-wise fusion 34.2 15.4 10.6 21.9
最大 pose 增益来自 point-wise fusion:VUS@10°5cm +7.5;depth sensor simulation +5.1;clustering +1.6。概念上最醒目的 clustering 并不是平均性能的主要来源,RGB / geometry 的局部结合与逼真的 depth noise 更关键。
8. Tracking 的条件并不完全一致
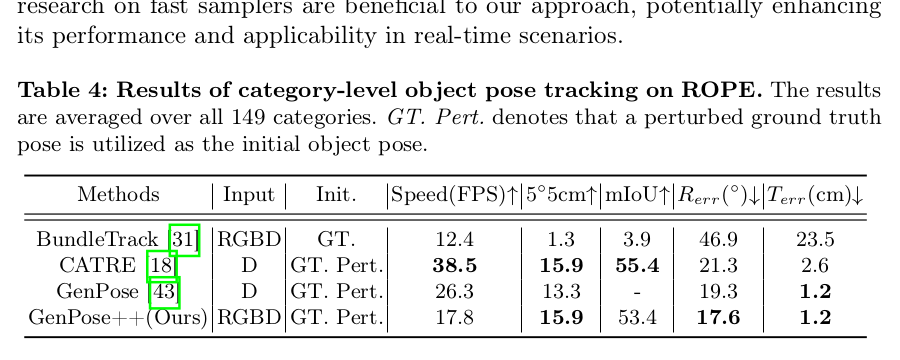
原论文 Table 4:GenPose++ 达 17.8 FPS、15.9 VUS@5°5cm;但 BundleTrack 使用 GT 初始 pose,三个 category-level trackers 使用 perturbed GT,且前者 training-free / unseen-object、后者在 SOPE 学过类别 canonical space。来源:ECVA 正式论文 ;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
方法 初始化 FPS VUS 5°5cm mIoU Rerr Terr BundleTrack GT 12.4 1.3 3.9 46.9° 23.5cm CATRE Perturbed GT 38.5 15.9 55.4 21.3° 2.6cm GenPose Perturbed GT 26.3 13.3 — 19.3° 1.2cm GenPose++ Perturbed GT 17.8 15.9 53.4 17.6° 1.2cm
GenPose++ 与 CATRE 在 VUS 上持平,rotation error 更低,但速度约为 CATRE 的 46%。论文称 17.8 FPS 可支持部分 robotic manipulation;是否真正实时还取决于 segmentation、depth preprocessing 与 hardware,表格没有给完整端到端 latency 分解。
BundleTrack 依赖 RGB keypoints 与 global depth optimization,weak texture、transparent / specular depth noise 都会失败;但它既不在 SOPE 学 category canonical space,也解决 unseen-object tracking,与另外三行并非同任务同先验的直接竞赛。
9. 局限与容易误读之处
“universal”仍要求类别属于训练的 149 类,不是 open-vocabulary;
主 pose 表使用 GT segmentation,未衡量 large-vocabulary detection;
NOCS 使用自己的 detector,与其余 GT-mask baseline 不完全公平;
ROPE 标注没有公开角度 / 毫米级外部 GT 精度验证;
论文正文有 580 / 581、5,000 / 4,162 的叙述差异,数据卡应采用摘要与 Table 1 最终规模;
canonical alignment 与 symmetry ambiguity 仍有人为 convention;
AUC / VUS 是新指标,不能与 NOCS 单阈值 mAP 直接比较;
tracking 初始化、训练先验与任务范围不同;
diffusion PF-ODE 迭代降低速度,作者也把 fast sampler 列为未来方向;
高质量 mixed-reality / simulated depth 仍不能证明已消除 sim-to-real,只能由消融证明有益。
10. 复现检查表
下载时区分 ROPE、SOPE、PAM 与 Meta,并匹配 real / synthetic meta;
采用最终 581 / 4,162 instances 统计;
固定 149-category canonicalization 与 object symmetry metadata;
SOPE 同时保留 IR pair、stereo depth 与 perfect depth 以做消融;
报告 GT / SAM / learned masks 三档输入;
DINOv2 与 PointNet++ 做 point-wise 而非 global fusion;
保留 top 40% energy candidates;
记录 DBSCAN rotation distance、ϵ \epsilon ϵ
分开报告 pose、scale、IoU 与 symmetry subsets;
tracking 统一初始扰动、mask、size、类别先验和 hardware 后再比较;
端到端记录 segmentation + sampling + aggregation latency。
11. 最终评价
Omni6DPose 是 2024 年 category-level pose 从小类桌面数据走向 149 类真实视频的一套完整基础设施。ROPE / SOPE / PAM 的配套设计、透明反光材质与结构光 depth simulation 都很有工程价值;官方 API、数据与 GenPose++ 也已公开。
GenPose++ 证明大词汇条件下 RGB foundation semantics、sensor-aware depth simulation 和 multimodal pose distribution 都有帮助,但 15.1 VUS@5°5cm 与 2.0 IoU75 AUC 同时说明问题远未解决。读这篇论文时,最健康的视角不是“新 SOTA 模型”,而是“大规模真实 benchmark 暴露出哪些旧指标与旧方法无法覆盖的失效”。