论文精读笔记:OmniNOCS
1. 核心判断
OmniNOCS 的首要贡献不是一个更大的 transformer,而是把“大词汇 NOCS 为什么一直做不起来”拆成了三个数据基础设施问题:
- 不同 3D detection 数据集的对象坐标轴约定不一致;
- 许多数据只有 sparse depth 或根本没有 dense depth;
- 许多数据只有 2D / 3D boxes,没有 instance mask。
NOCS 需要知道像素对应的对象表面点,并把该点变换到一致的 object-centric canonical frame。缺少上述任一项,都无法直接生成 NOCS map。论文用人工 axis canonicalization、LiDAR / stereo / NeRF depth 和多种 mask 来源补齐这条链,最终得到 97 类、380k 图像、超过 450k 实例的统一数据。
模型 NOCSformer 的意义也应放在这个尺度上看:它不再为每个小数据集、每个类别配置独立 head 和平均尺寸,而是用一个共享模型从 2D box 提升到 mask、NOCS、metric size、pose 与 visible shape。结果证明多数据域迁移优于 Cube R-CNN 式 box regression;但它并没有消除 domain-specific supervision 的价值,在 NOCS-Real275 上仍远落后于目标域监督 NOCS 模型。
2. OmniNOCS 数据组成
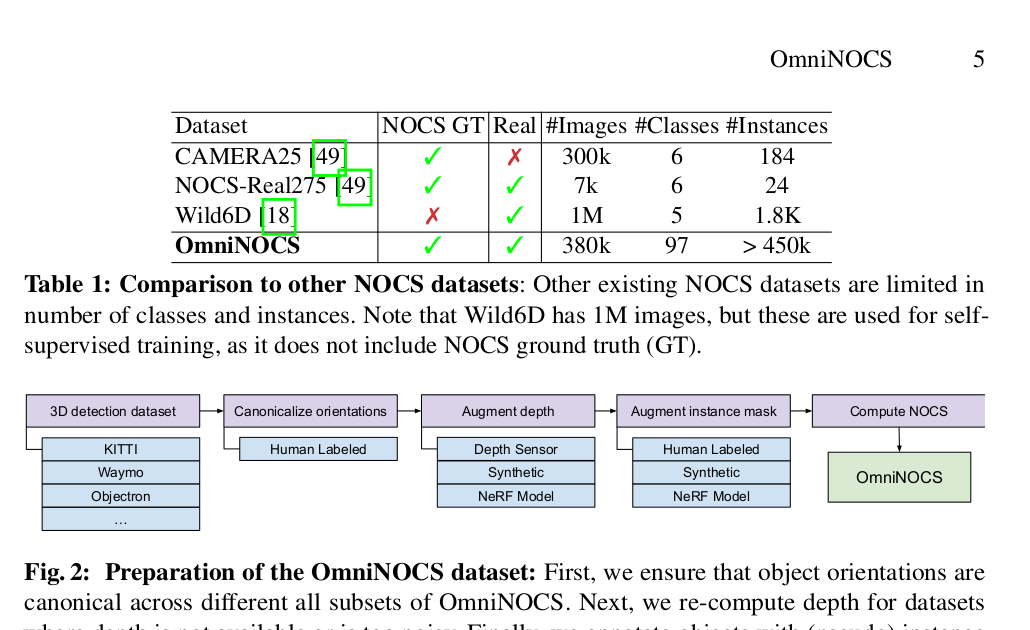 原论文 Table 1 与 Figure 2。统一 3D box 朝向、补 depth、补 mask 后,才可把相机坐标表面点转换为 canonical NOCS。来源:ECVA 正式论文;图表版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
数据来自 10 个来源:
| 数据源 | Depth | Mask | 图像 | 使用类别 |
|---|
| KITTI | LiDAR | 人工 | 7.4k | 7 |
| SUN RGB-D | depth camera | segmentation model | 10k | 72 |
| Objectron | NeRF | NeRF + 人工 | 132k | 9 |
| nuScenes | LiDAR | segmentation model | 30k | 9 |
| Hypersim | synthetic | synthetic | 64k | 31 |
| ARKitScenes | depth camera | segmentation model | 60k | 15 |
| Cityscapes 3D | stereo | 人工 | 3.4k | 8 |
| Virtual KITTI | synthetic | synthetic | 4.1k | 3 |
| NOCS-Real275 | depth camera | 人工 | 7k | 6 |
| Waymo Open | LiDAR | 人工 | 62k | 7 |
合并去重后共有 97 类和 380k 图像,而不是逐行类别 / 图像简单相加。论文另报告:
- 307k real、73k synthetic;
- 107k outdoor;
- 102k complex indoor;
- 140k object-centric video;
- 总实例超过 450k。
这些场景类型数字不是互斥全集,不应强行相加解释全部 380k。
3. 如何把异质 3D detection 数据变成 NOCS
3.1 Canonical orientation
同一类别必须共享语义一致的 object axes。例如汽车 X 轴朝前、Z 轴朝上。对已在数据集内部一致的类别,作者施加 dataset / class-specific fixed rotation offset;对 Hypersim 这类每个实例轴方向都可能不同的数据,人工从 6 种 bounding-box axis orientations 中选择 canonical orientation。
这里存在不可消除的约定性:对称物体可能有多个等价朝向,作者会任意选一个。数据因此提供“单一规范标签”,但物理问题本身仍是多解。
3.2 Depth augmentation
- 室外数据优先使用 sparse LiDAR;
- Cityscapes 原深度噪声较大,改用 stereo depth model;
- Objectron 无 dense depth,作者为每段视频训练 NeRF,再渲染 depth;
- 室内 RGB-D 与合成数据使用原生 / 合成 depth。
这意味着不同 subset 的 NOCS density、边界噪声和尺度误差分布并不一致。大规模不等于同质高精度。
3.3 Instance mask augmentation
ARKitScenes 和 SUN RGB-D 用 projected 3D box 提示 SAM;Objectron 先融合 NeRF depth 得到 mesh,再根据像素 depth 到 mesh surface 的距离生成多帧 mask,并自然处理遮挡。其余数据使用人工、已有模型或 synthetic masks。
3.4 NOCS 定义
相机坐标点 xcam 变为:
xnocs=s1objTcamxcam,
其中 s 是 tight 3D bounding box 的对角线长度。它把对象表面归一化到 unit-diagonal 尺度,同时保留 canonical orientation 和相对形状。
注意该定义使用单一 scalar,而不是沿 XYZ 独立缩放;metric shape 需要模型另行预测 size。
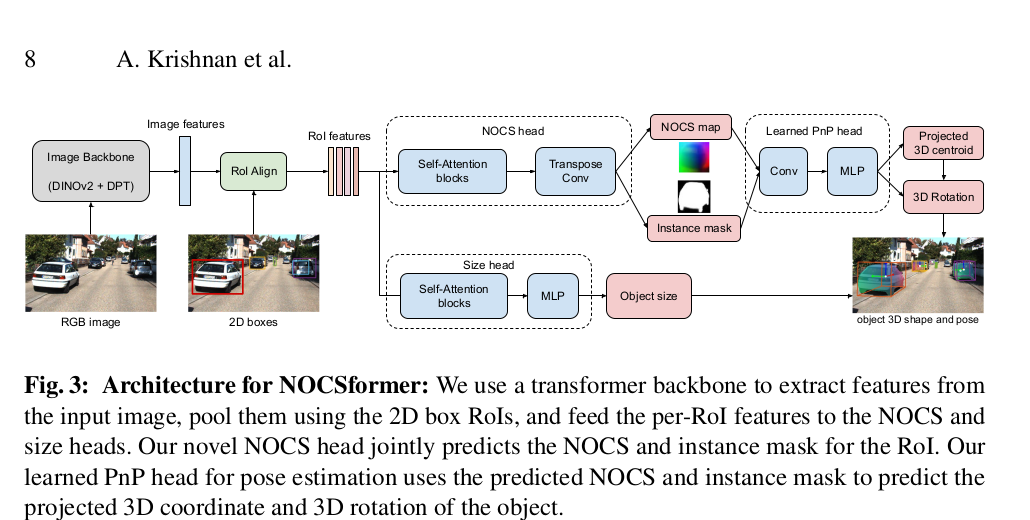 原论文 Figure 3。2D box 是模型输入而不是网络输出;NOCS / mask、size、orientation / centroid 三组 head 共享每个 RoI 的 DINOv2-DPT features。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
4.1 Backbone 与 RoI
- ViT 使用自监督 DINOv2 权重并保持 frozen;
- trainable DPT 融合多个中间层并上采样 8×;
- 外部 2D boxes 通过 RoIAlign 取 28×28 feature grid。
冻结 backbone 降低训练难度,但 NOCSformer 仍依赖大规模有监督 head training;它不是 zero-shot foundation model。
4.2 NOCS 与 mask head
10 个 self-attention blocks + transpose convolution 联合预测 NOCS 和 instance mask。每个 NOCS axis 不是直接线性回归,而是预测 50 个不重叠 bins 的 logits,经 softmax 得到连续坐标。
联合 head 让 shape coordinates 与 foreground extent 共用空间推理;这在大词汇场景中明显优于小型 Mask R-CNN convolutional head。
4.3 Size 与 learned PnP
size head 也使用 self-attention,不用 class-specific layer 或 per-class average size。预测 size 后,normalized NOCS 可恢复 metric object coordinates。
learned PnP head预测:
- allocentric 3D rotation,使用 6D rotation representation;
- 3D centroid 在图像上的 2D projection。
rotation 转到 egocentric frame 后,结合 metric object coordinates、centroid ray 和对应 2D points求 object depth。作者也讨论经典 PnP,但认为 noisy NOCS 对应会让它比 learned solution 更敏感。
4.4 监督信号
总损失含:
- mask L2;
- NOCS 50-bin cross-entropy + coordinate L1;
- 基于真值 pose 的 NOCS reprojection loss;
- normalized size CE + L1;
- rotation matrix L1 与 centroid L2。
因此论文中的跨数据集 “zero-shot” 只表示目标数据 NOCS-Real275 未用于训练;模型在其他 97 类多源数据上有密集 NOCS / pose 监督。
5. 输出不只是 3D box
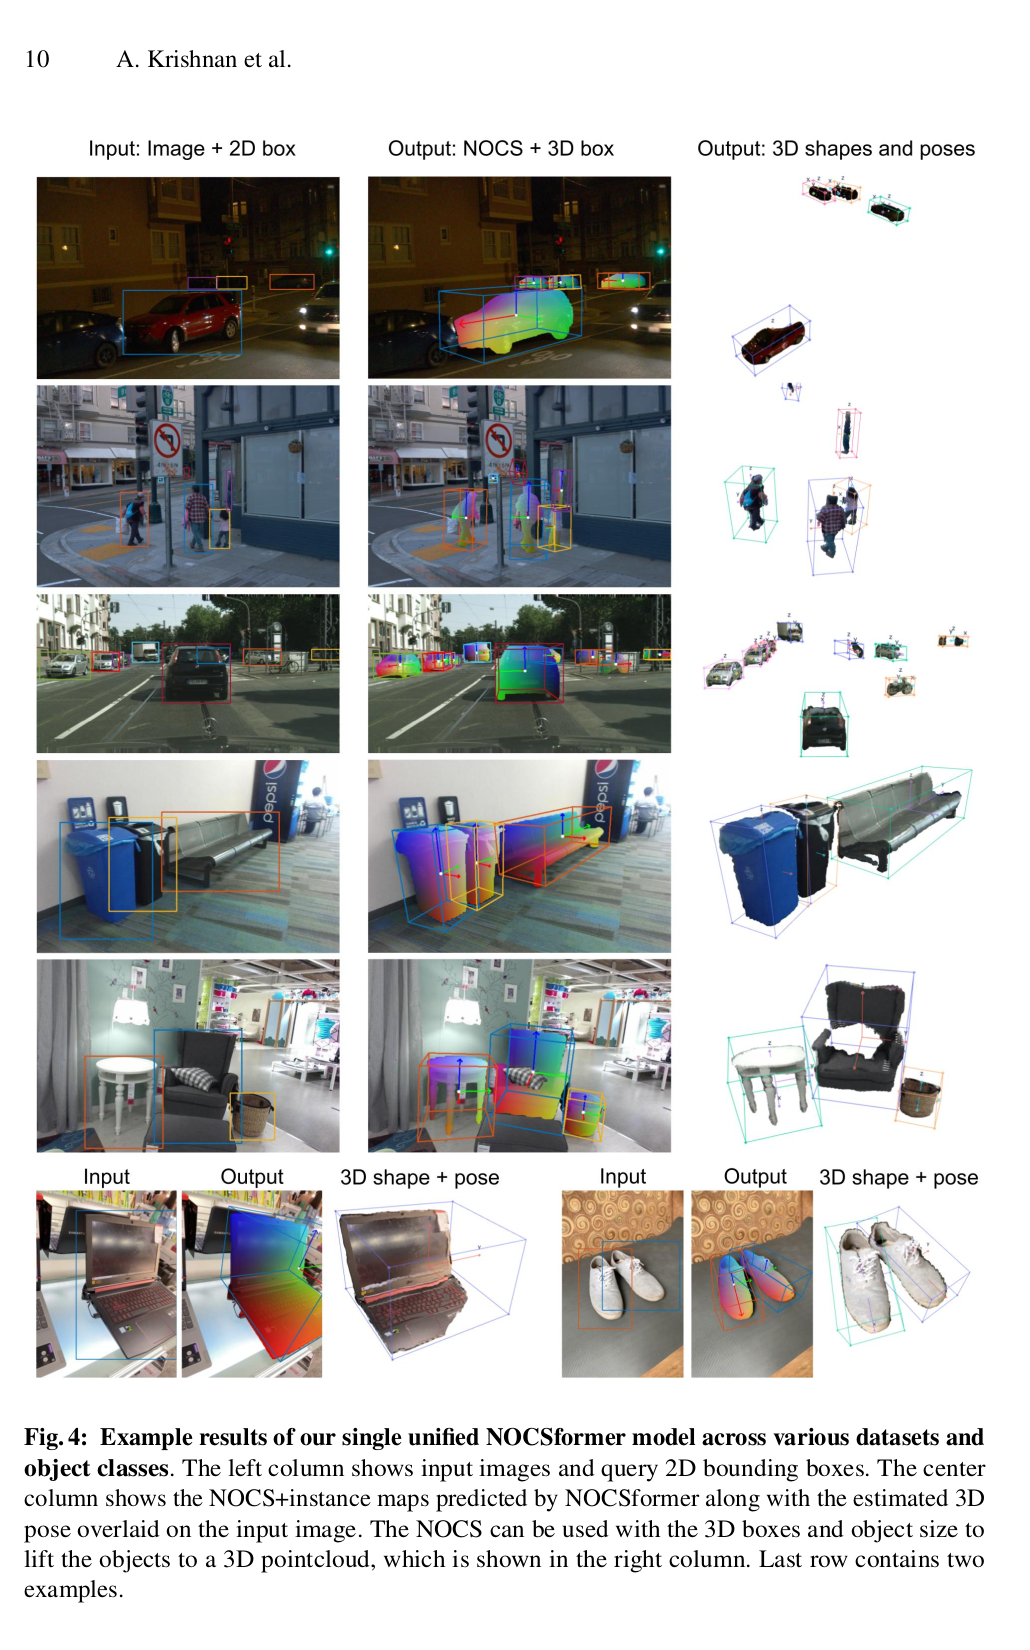 原论文 Figure 4:输入为图像与查询 2D boxes;中列是 NOCS、mask 和 pose overlay;右列将 NOCS 与 size 提升为 metric visible point cloud。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
相比只回归 cuboid 的 3D detector,NOCSformer还能输出:
- canonical dense visible-surface coordinates;
- instance mask;
- metric visible shape;
- oriented 3D box / pose。
但这些是“当前可见表面”的 point cloud,不是完整 watertight object reconstruction。遮挡背面没有被生成。
6. NOCS 直接指标
作者提出 NOCS mAE 和 mPSNR,在 GT / predicted mask 交集上计算,并另报 mask mIoU 以防稀疏预测通过只覆盖容易区域获得虚高坐标分数。
| 测试集 | 方法 | NOCS mAE↓ | NOCS PSNR↑ | Mask IoU↑ |
|---|
| NOCS-Real275 | target-trained NOCS baseline | 0.121 | 16.345 | 86.10 |
| NOCS-Real275 | transferred NOCSformer | 0.107 | 18.527 | 89.03 |
| OmniNOCS 75-class subset | NOCSformer | 0.094 | 20.245 | 78.50 |
NOCSformer 在 held-out NOCS-Real275 的 dense NOCS 与 mask 指标确实超过目标集训练旧模型。但这不代表最终 3D localization 也超过目标域监督方法,下一节会看到明显差距。
7. 3D localization 与跨域泛化
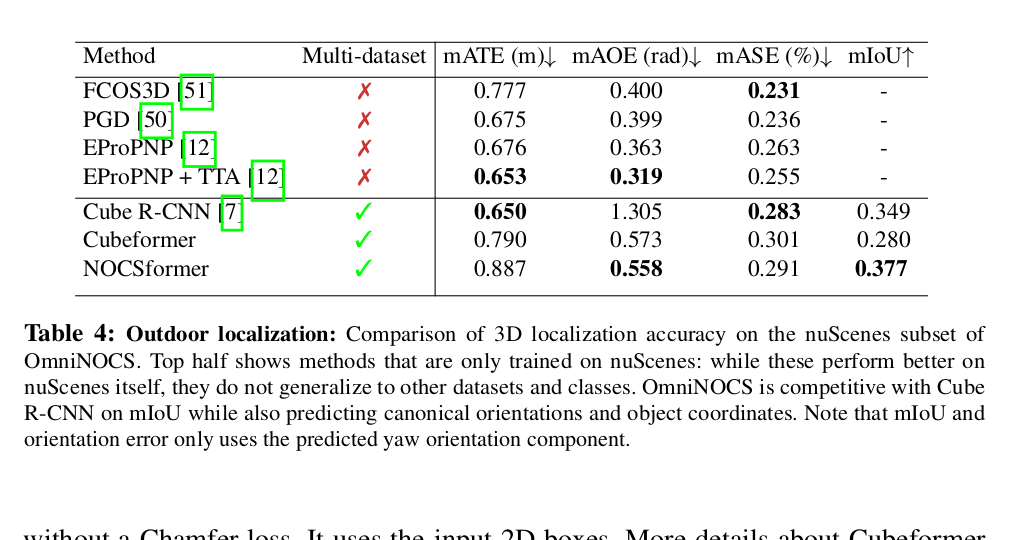 原论文 Table 4:NOCSformer 在 multi-dataset 模型中有更好的 mAOE 与 mIoU,但 mATE 不及 Cube R-CNN;只在 nuScenes 训练的专用方法在该目标域仍更强。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
7.1 nuScenes subset
| 方法 | Multi-dataset | mATE m↓ | mAOE rad↓ | mASE↓ | mIoU↑ |
|---|
| EProPNP + TTA | 否 | 0.653 | 0.319 | 0.255 | — |
| Cube R-CNN | 是 | 0.650 | 1.305 | 0.283 | 0.349 |
| Cubeformer | 是 | 0.790 | 0.573 | 0.301 | 0.280 |
| NOCSformer | 是 | 0.887 | 0.558 | 0.291 | 0.377 |
NOCSformer 的 canonical orientation 和 3D overlap 比另外两个 multi-dataset baselines 更好,但 translation 最差。目标域专门训练的 EProPNP + TTA 在 mATE / mAOE 上仍明显更强。
7.2 Held-out NOCS-Real275
| 方法 | 目标域训练 | Depth | 3D IoU mAP@25 | mAP@50 |
|---|
| NOCS model | 是 | 是 | 79.6 | 72.4 |
| Cube R-CNN | 否 | 否 | 14.9 | 4.1 |
| NOCSformer | 否 | 否 | 43.5 | 10.6 |
NOCSformer 相对 transferred Cube R-CNN 的提升很大,但相对 target-trained NOCS model 仍有 36.1 / 61.8 points 差距。@25 到 @50 的大幅下降也说明其 coarse localization 泛化好于精密 pose。
Cube R-CNN同时负责 2D detection,而 NOCSformer使用输入 2D boxes;false positives / negatives 会影响前者 mAP。论文自己也提示这不是完全公平的系统对比。
7.3 Canonical orientation
在 KITTI-val 五类上,NOCSformer gravity-axis accuracy@5° 为 99.95%,heading-axis accuracy@10° 为 59.65%;Cube R-CNN 对应为 18.29% / 21.55%。这支持“统一 canonical axes 比 Chamfer-invariant cuboid supervision 更能学稳定朝向”的论点。
8. 消融与局限
NOCSformer 完整 head 达到 20.431 dB NOCS PSNR、81.69 mask IoU:
- Hourglass head:-3.064 dB / -3.16 points;
- Mask R-CNN head:-5.23 dB / -21.27 points;
- 去掉 50-bin discretization 改连续回归:-4.11 dB。
论文明确限制:
- 对称对象存在多个等价 canonical frames,单标签损失不自然;
- left / right shoes 等镜像几何需要区分 reflection;
- 2D boxes 必须由外部 detector 或人工提供。
本站补充:
- 多源 depth / mask 的噪声模型不一致,论文没有做按标注来源的误差分层;
- 手工 canonicalization 可扩展到 97 类,但更大开放词汇的人工成本和语义争议仍存在;
- 97 类共享模型不等于 unseen-category open vocabulary;
- NOCS point cloud 仅覆盖可见表面;
- 论文未提供端到端 detector + NOCSformer 的速度、显存和吞吐;
- 目标域高精度 localization 仍显著依赖 domain-specific training 与 depth。
9. 复现检查表
- 获取每个 constituent dataset 的许可、版本和 train / val split;
- 固化 class ontology、axis convention 与 class-specific rotation offsets;
- 记录人工 6-way canonicalization 的标注协议和一致性;
- 分别复现 LiDAR / stereo / NeRF / camera depth 的有效像素与尺度;
- 保存 mask source,并按人工、SAM、model、synthetic 分层审计;
- 严格使用 tight-box diagonal scalar s 计算 NOCS;
- 冻结 DINOv2,仅训练 DPT 与 heads;核对 8× upsample 和 28×28 RoI;
- 复现 10-block transformer head、50 bins、联合 NOCS + mask 输出;
- 区分输入 2D boxes 与 detector predictions;
- 同时报 NOCS mAE / mPSNR / mask IoU、3D box 指标和 canonical orientation;
- 在 held-out dataset 上与 target-trained baseline 分开报告,避免把“优于 transferred baseline”写成“优于目标域方法”。
10. 最终评价
OmniNOCS 是一篇数据工程与任务定义价值大于单一模型增量的论文。它首次把 NOCS 从少数桌面类别扩展到 97 类、多相机、室内外和对象中心视频,并通过直接 NOCS 指标把“坐标预测质量”从最终 pose 指标中单独拆出来。
NOCSformer证明了共享 canonical representation 可以在未见数据域中迁移:它远优于 transferred Cube R-CNN,也在 NOCS 坐标预测上超过旧的 target-trained NOCS head。但高精度 3D localization 仍没有被解决,@50 mAP 与目标域监督模型差距很大。对网站读者而言,最值得带走的不是“一个模型统一所有物体”,而是大词汇 pose 必须先统一坐标系、标注来源和评测边界。
