论文精读笔记:ONDA-Pose: Occlusion-Aware Neural Domain Adaptation for Self-Supervised 6D Object Pose Estimation
1. 核心判断
- 论文:CVF Open Access
- 关键问题:将带标签合成图翻译为真实风格,不能同时解决真实纹理差距与真实遮挡,因而会产生有“真标签”但不够真实的训练数据。
- 核心回答:从真实无标签图反向学习 CAD-like radiance field,得到有真实域外观的可控渲染,再以 pose refiner 产生伪标签。
2. 一句话定位
ONDA-Pose 的 domain adaptation 不是 image-to-image preprocessing,而是用可被 CAD 几何约束的 radiance field 把真实外观、合成 pose 与遮挡适应连接起来。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
| Figure 1 | 与“synthetic→real 后用 GT pose 监督”相比,ONDA-Pose 为什么采用“real→synthetic + pseudo pose”。 |
| 方法图 | CAD-like radiance field、global pose refiner 和 backbone 的训练次序。 |
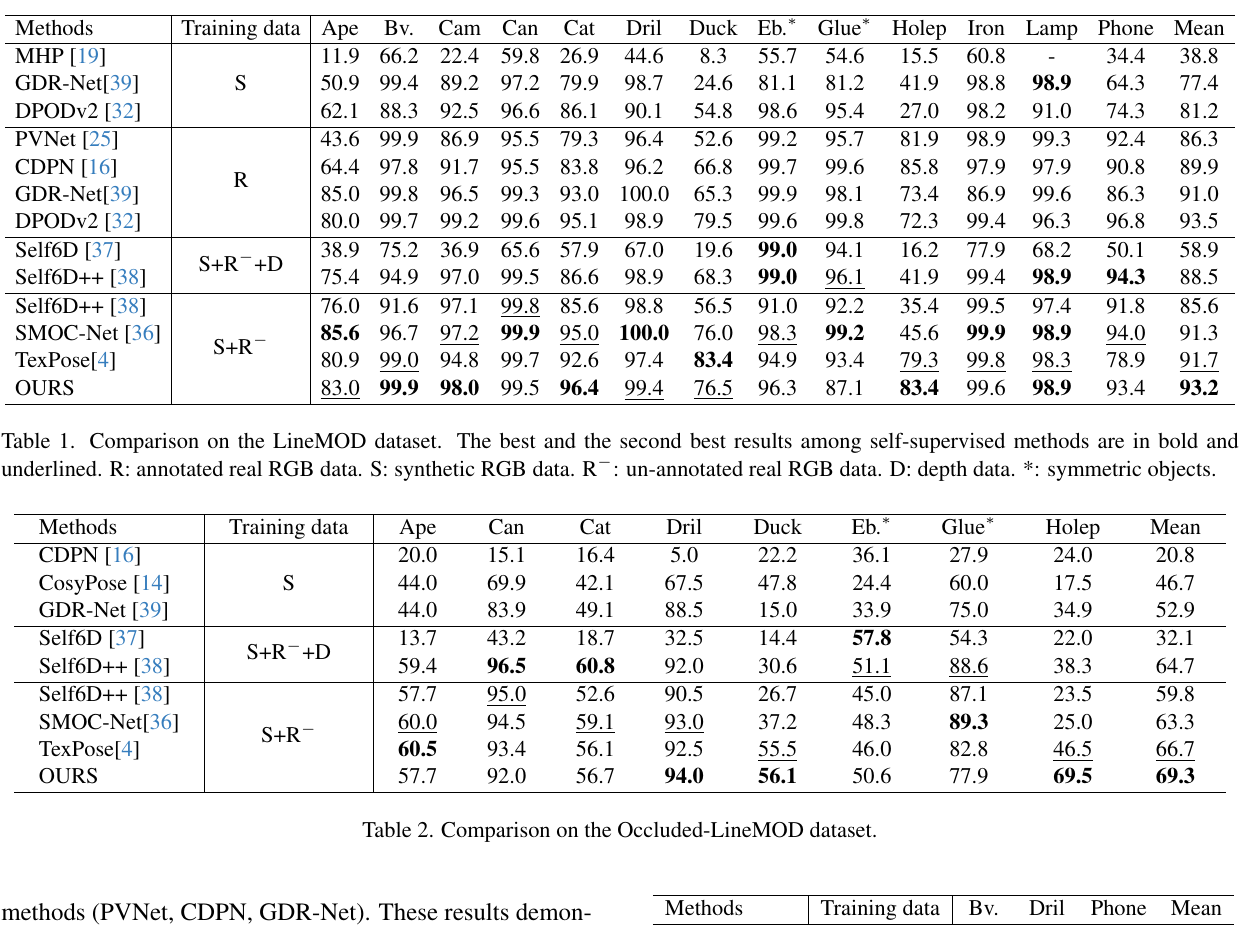
| Table 1–3 | LINEMOD、Occluded-LINEMOD、HomebrewedDB 上的自监督条件是否一致。 |
| Table 4 / Figure 4 | 遮挡感知模块和 domain translation 的实际作用。 |
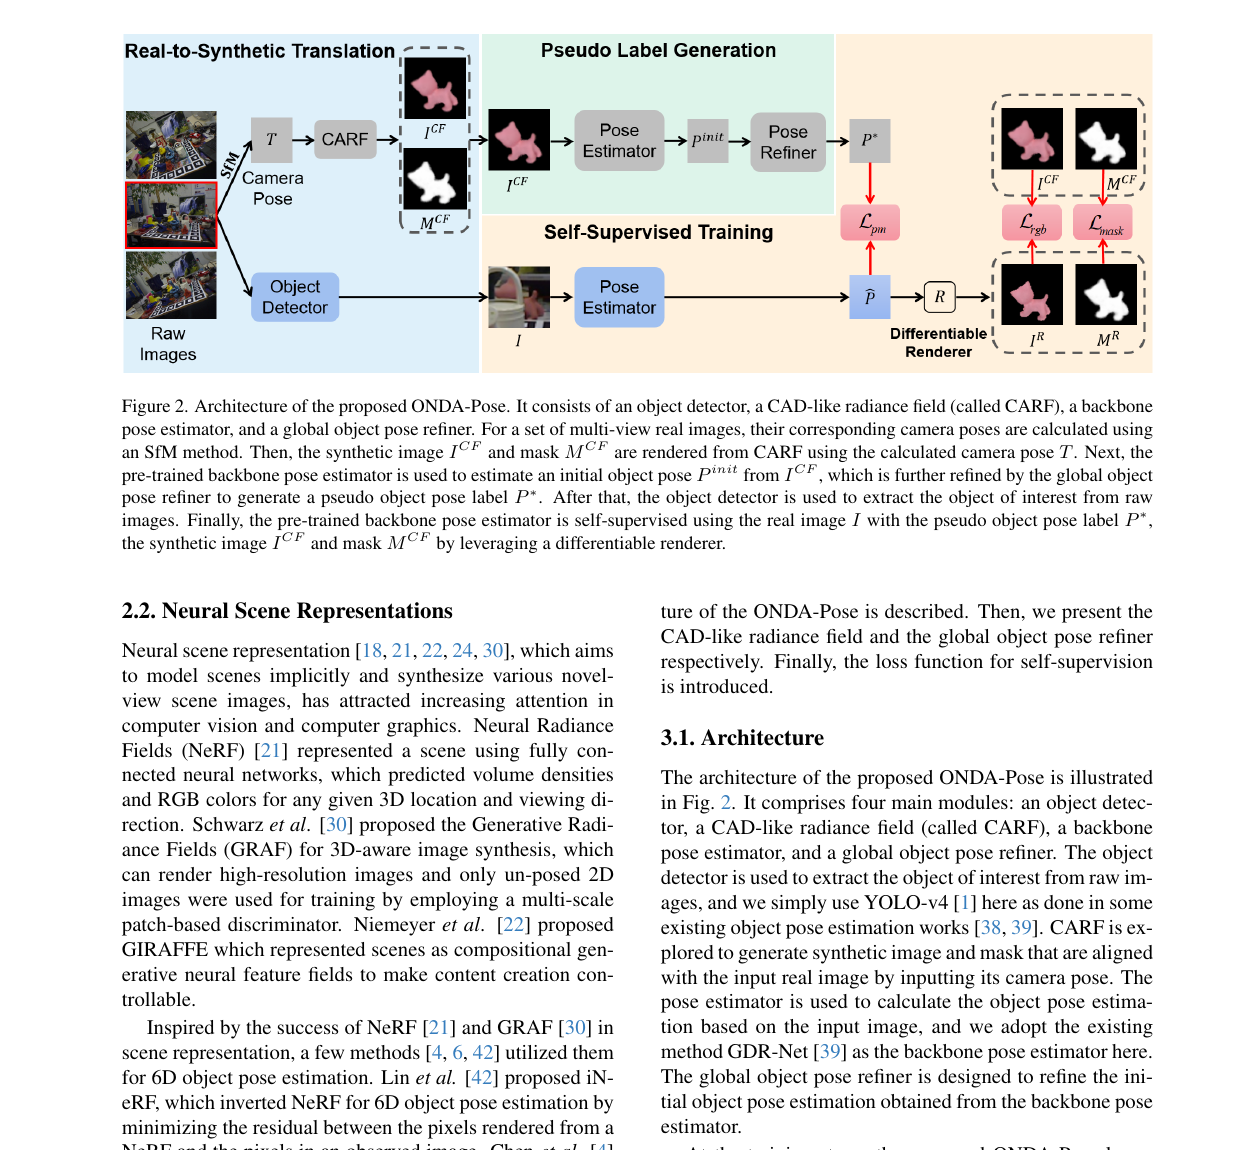 原论文方法图区域:ONDA-Pose 从真实无标签图像构造 CAD-like radiance field、生成伪 pose 并训练最终估计器。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 给定目标 CAD、合成训练数据以及没有 pose label 的真实目标域图像;输出 instance-level 6D pose estimator。
- 因此它针对 sim-to-real adaptation,而不是对测试时完全未知的对象类别直接泛化。
- “occlusion-aware”需要在真实遮挡 benchmark 上检验,标准无 / 轻遮挡 LINEMOD 不足以单独证明。
4. 方法详解
- CAD-like radiance field:结合真实训练图与 CAD 建模,把真实域纹理 / 外观写进可渲染表示。
- Pseudo-label generation:先用 synthetic-trained backbone 给 radiance-field renders 初始 pose,再由 global object pose refiner 校正。
- Joint self-supervision:以真实图像+伪标签以及 radiance-field render 共同训练 pose estimator,使训练分布包含现实遮挡 / 外观。
5. 实验分析
- 主表覆盖 LINEMOD、Occluded-LINEMOD、HomebrewedDB,并标注 self-supervised 方法的排名;需核对是否同用 GT detection / mask、CAD 和相同 evaluation split。
- Table 4 以 Occluded-LINEMOD 为消融场景,才直接对“occlusion-aware design”提供证据。
- 一个严谨的外推应是:方法改善了该 CAD+无标签 target-data 条件下的 pose;不能外推为无 CAD 的 open-world solution。
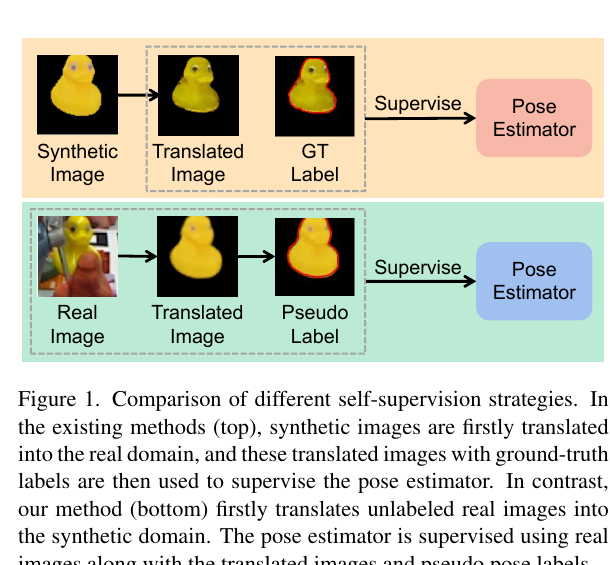 ONDA-Pose 原论文 Figure 1:传统路线把带 GT pose 的合成图翻成真实风格;ONDA-Pose 反向把真实无标签图映到可控合成域,再用 refined pseudo pose 监督。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
这张图揭示了论文最重要的标签流向差异。synthetic→real 路线保留 CAD 渲染时的 GT pose,但图像翻译可能改变轮廓 / 遮挡,导致标签与像素不再严格一致;real→synthetic 路线保留真实观测中的遮挡与视角,再通过 radiance field 和 refiner估计 pseudo pose。后者并没有凭空得到真值,而是把难题从“图像翻译后标签是否仍对齐”转成“伪姿态是否足够可靠”。
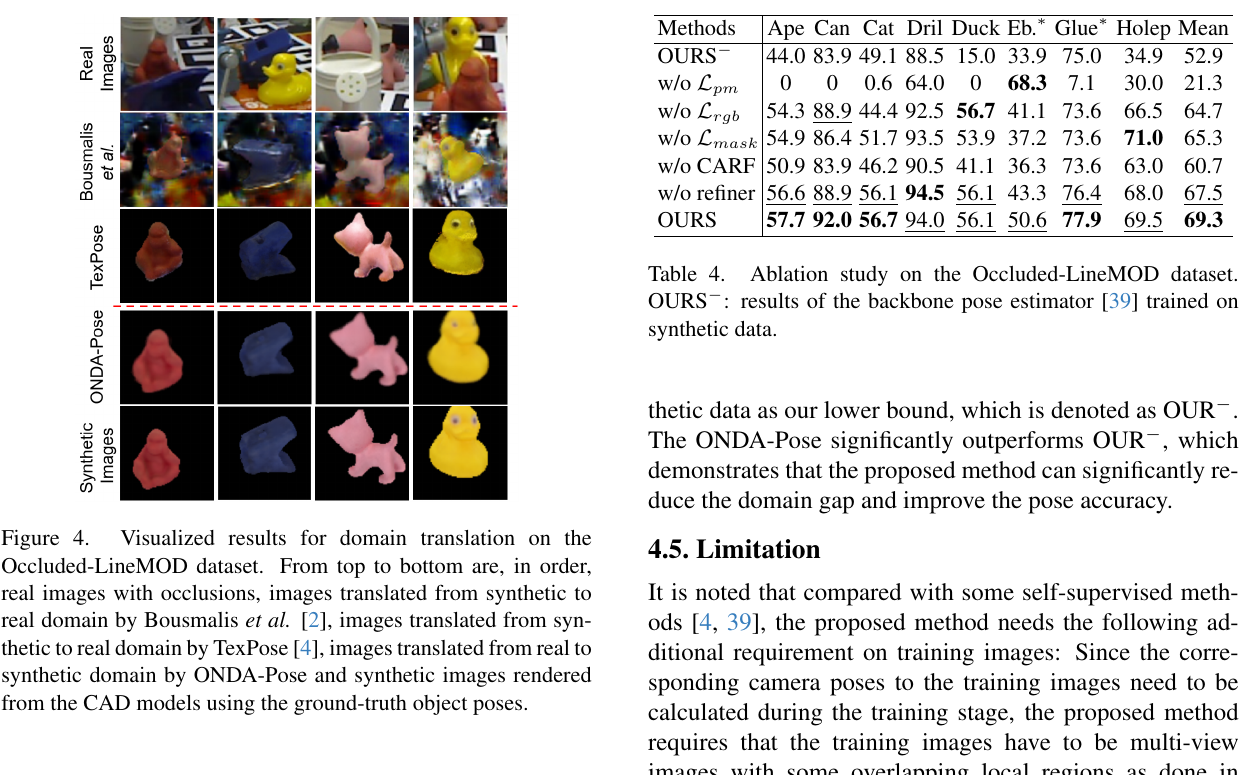 ONDA-Pose 原论文 Figure 4 / Table 4:左侧比较真实图、synthetic→real、real→synthetic 与 CAD 渲染;右侧拆解三项自监督损失、CAD-like radiance field 和 global refiner。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Occluded-LINEMOD 消融中,仅合成训练的 backbone(OURS−)mean 为 52.9,完整模型为 69.3。去掉 point matching loss 后骤降到 21.3,说明该项不仅“略有帮助”,而是维持自监督稳定性的核心;去掉 RGB / mask similarity loss 分别为 64.7 / 65.3。移除 CAD-like radiance field 为 60.7,移除 global refiner 为 67.5,表明真实外观可控渲染带来的作用大于 refiner 单模块的 1.8 点增益。
分对象结果也反映遮挡差异:完整模型在 drill / holepuncher 上为 94.0 / 69.5,而 duck / eggbox 为 56.1 / 50.6。不能把 mean 69.3 理解成所有物体都稳健;弱纹理、对称和严重遮挡依然会产生明显对象差异。HomebrewedDB 的 98.2 / 97.1 / 92.1(benchvise / drill / phone)说明跨采集环境有较强迁移,但只覆盖三个与 LINEMOD 共享的实例。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| 将真实图反向映射到合成可缓解 domain gap | 设计使 pose label 可控,逻辑完整;关键风险是 radiance field 是否会把 pose error 吸收进外观。 |
| 遮挡感知优于普通 self-supervision | 需要以 Occluded-LINEMOD 与 HomebrewedDB 为主要证据;只看 LINEMOD 会夸大结论。 |
7. 复现要点与限制
- 应保存 radiance-field 的训练视图、CAD scale、pose refiner 的初始化和伪标签过滤规则。
- 真实数据量、遮挡分布以及 CAD 与实物的形状差异都会改变 adaptation 成功率。
- 系统包含 field fitting + pseudo-labeling + retraining,延迟与资源开销不适合简单按单帧 network runtime 比较。
- 论文明确要求真实训练图是具有局部重叠的多视图,以计算相机姿态;因此“无标注”只表示没有 object pose 标签,不代表输入是互不关联的任意单图集合。