论文精读笔记:One2Any: One-Reference 6D Pose Estimation for Any Object
1. 核心判断
- 论文:CVF Open Access
- 关键问题:未知对象没有 canonical NOCS、没有 CAD、只有一张 reference 时,何种坐标监督仍然可以从大量 pair-wise data 学到?
- 核心回答:以 reference camera frame 为唯一坐标锚点,预测 ROC 而非 canonical NOCS;ROPE 把 reference 的纹理、形状和 pose 作为对象条件输入 query decoder。
2. 一句话定位
One2Any 是一套从“一张 reference 的对象编码”到“query 的 reference-coordinate decoding”再到 Umeyama 刚体拟合的连续相对 pose 模型。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
| Figure 2 | ROE、ROPE、VQ-VAE、cross-attention U-Net 与 ROC 的信息路径。 |
| Figure 3 | ROC 与 NOCS 的不同:reference frame 使未知类别无需 canonicalization。 |
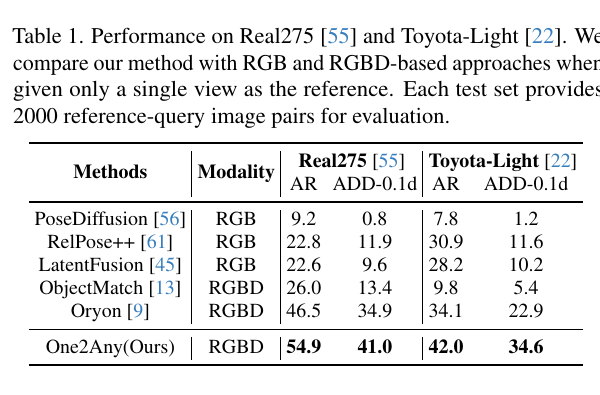
| Table 1–4 | REAL275 / Toyota-Light、遮挡 YCB-Video、大视角 LINEMOD、tracking 的任务并非同一指标。 |
| Table 5 | 速度应与 CAD / multi-view 方法使用的 reference budget 一起比较。 |
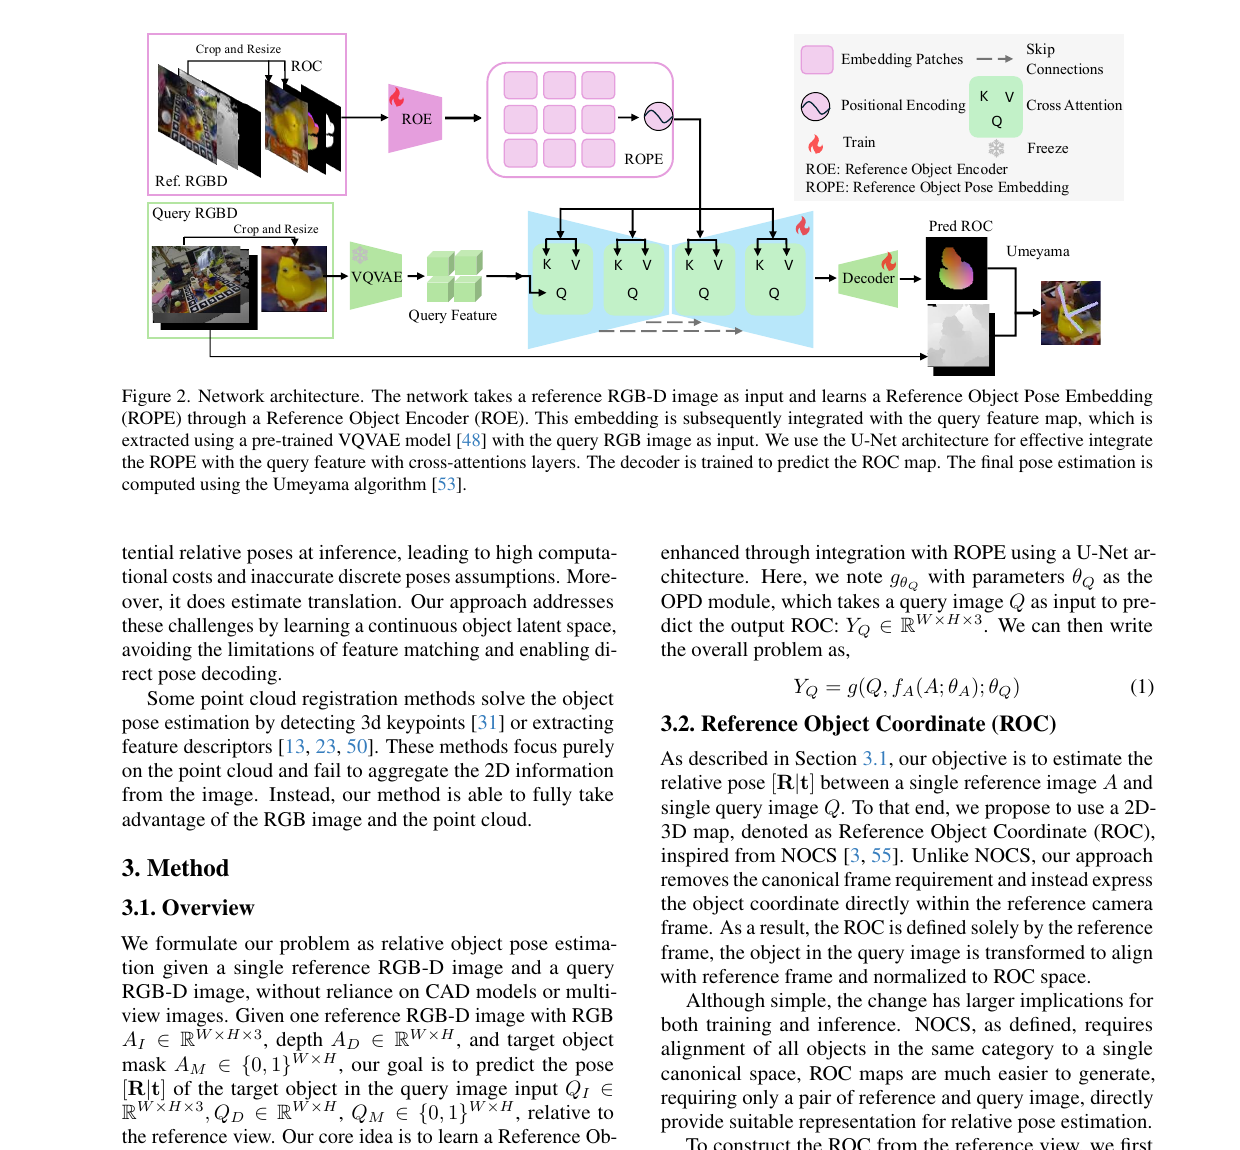 原论文 Figure 2:Reference Object Pose Embedding 从单张 reference RGB-D 编码对象,query decoder 输出 Reference Object Coordinate 后再以 Umeyama 拟合 pose。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- reference 与 query 都是 RGB-D;reference 的物体坐标无需外部 pose 标注。
- 输出是 query 相对 reference 的刚体变换;它和输出 CAD canonical pose 的方法有不同自由度。
- 需要 object mask,且姿态拟合依赖 query depth;这不是纯 RGB 单参考 setting。
4. 方法详解
- ROE / ROPE:Reference Object Encoder 从 reference RGB-D 形成包含 object shape、appearance、orientation 的 latent embedding。
- Query decoding:预训练 VQ-VAE 编码 query;U-Net 的 cross-attention 用 ROPE 条件化 query feature,预测每个像素在 reference frame 中的 ROC。
- Pose solve:ROC 与 query depth back-projected 3D points 组成对应,经 Umeyama 解相对 rotation、translation 与尺度关系。
5. 实验分析
- 论文覆盖 REAL275、Toyota-Light、occluded YCB-Video、large-viewpoint LINEMOD 与 YCB-Video tracking,试图同时检验类别泛化、遮挡与连续任务。
- 这些表要按 reference 条件分组:One2Any 的一张 RGB-D reference 不应和 8–200 views 或 CAD 的结果直接写成无条件胜负。
- 方法的速度优势来自一次 embedding / decode,不必在每个 query 重新做多视图搜索或优化;代价是高度依赖 learned object latent 的泛化。
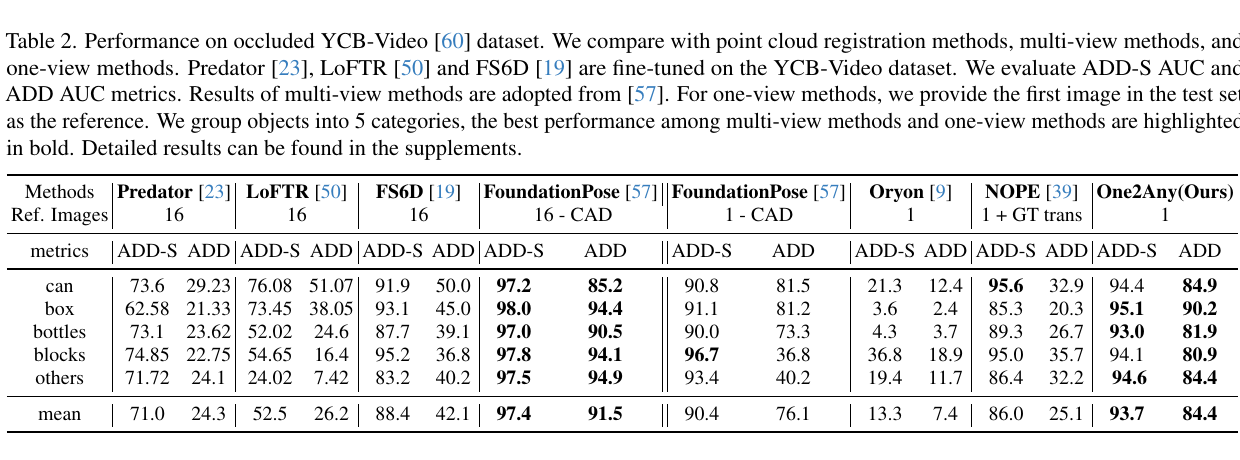 One2Any 原论文遮挡 YCB-Video 结果:表中同时列出 16 视图、CAD、单 CAD 与单 RGB-D reference,应该先按 reference budget 分组,再比较 ADD-S / ADD。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
遮挡 YCB-Video 上,One2Any 用一张 RGB-D reference 获得 mean ADD-S / ADD AUC 93.7 / 84.4;同为单参考的 Oryon 为 13.3 / 7.4,带 GT translation 的 NOPE 为 86.0 / 25.1。FoundationPose 用单 CAD 时为 90.4 / 76.1,而 16 视图生成 CAD 时为 97.4 / 91.5。这个结果支持 One2Any 在“单参考且 reference 可能被遮挡”条件下的强竞争力,但 16-view 完整 CAD 仍代表更高的 reference 信息预算。
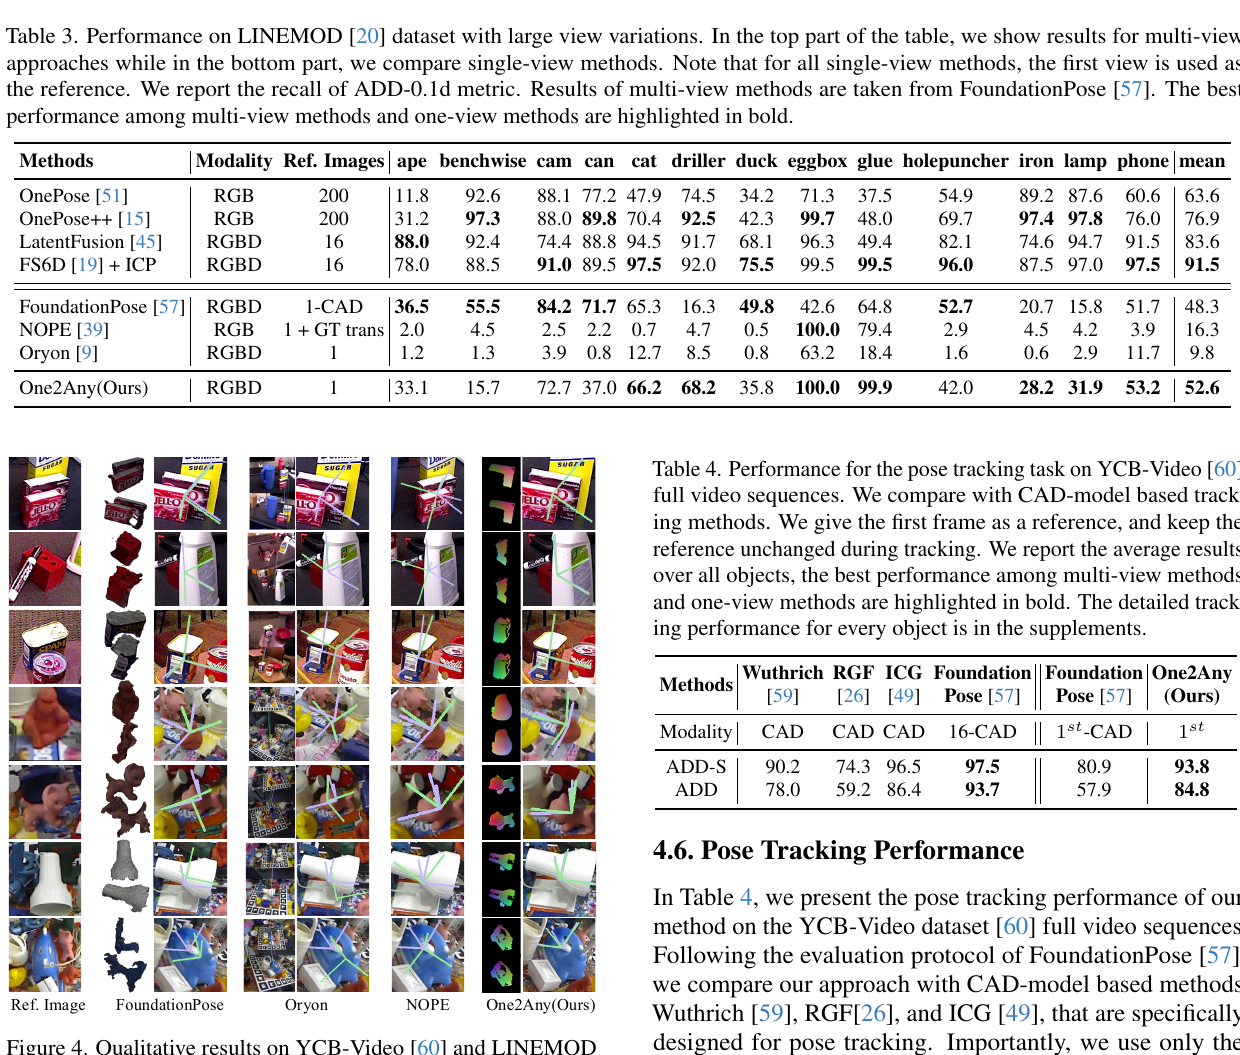 原论文大视角 LINEMOD 表、YCB-Video / LINEMOD 定性对比与 tracking 结果:绿色为预测姿态、粉色为真值,最右列还展示 ROC map。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
在 LINEMOD 大视角变化下,One2Any 的 mean ADD-0.1d recall 为 52.6,高于单 reference 的 FoundationPose 48.3、NOPE 16.3 和 Oryon 9.8,但低于使用 16 张 RGB-D 的 FS6D+ICP 91.5。单物体结果差异很大:eggbox / glue 达到 100.0 / 99.9,而 ape / benchwise 仅 33.1 / 15.7,说明对称性、纹理和 reference 覆盖会以对象依赖方式影响 ROC 解码。YCB-Video tracking 中只固定首帧作 reference,One2Any 的 ADD-S / ADD 为 93.8 / 84.8;单 CAD FoundationPose 为 80.9 / 57.9,而 16-CAD 版本仍为 97.5 / 93.7。
论文还报告 RTX 4090 上 One2Any 为 0.09 s,Oryon 0.90 s、FoundationPose 2.70 s;这支持 feed-forward 路线的低延迟,但不同方法的 GPU、CAD 渲染 / onboarding 成本并不完全一致。ROC head 消融则比直接 rotation + translation head 明显更强:ADD-S / ADD 从 84.7 / 59.4 提到 91.2 / 78.6,5°5cm 从 2.4 提到 15.5,说明显式预测 reference-coordinate correspondence 比直接回归相对变换更可泛化。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| 单 reference 即可 rival multi-view / CAD methods | 从多基准对比看是有竞争力的,但应逐行核对是否共享 mask、depth 和 evaluation protocol。 |
| ROC 比 NOCS 更适合未知对象 | 论证成立:reference frame 避免 unknown canonicalization;代价是每个 query 都相对该 reference。 |
7. 复现要点与限制
- 首先确认 ROPE 的 reference augmentation、ROC normalization、mask convention 和 Umeyama 的 scale handling。
- 最大风险是 reference 被遮挡或视角过窄、query 与 reference 无重叠、深度不准;这时 ROC 不是缺一个小修正而是缺少监督对应。
- 若要用于绝对世界 pose,需要额外把 reference frame 接入机器人 / 场景坐标。
- 训练使用 FoundationPose 合成对和 OO3D-9D 多视图数据;复现时要区分训练期见过的对象分布与测试对象实例,不能把“未见实例”误写成完全不依赖大规模对象先验。