论文精读笔记:OP-Align
1. 核心判断
OP-Align 的关键并不是把刚体 pose head 改成多个 part pose heads,而是把关节物体的变化拆成两个可被无标签几何监督约束的层次:
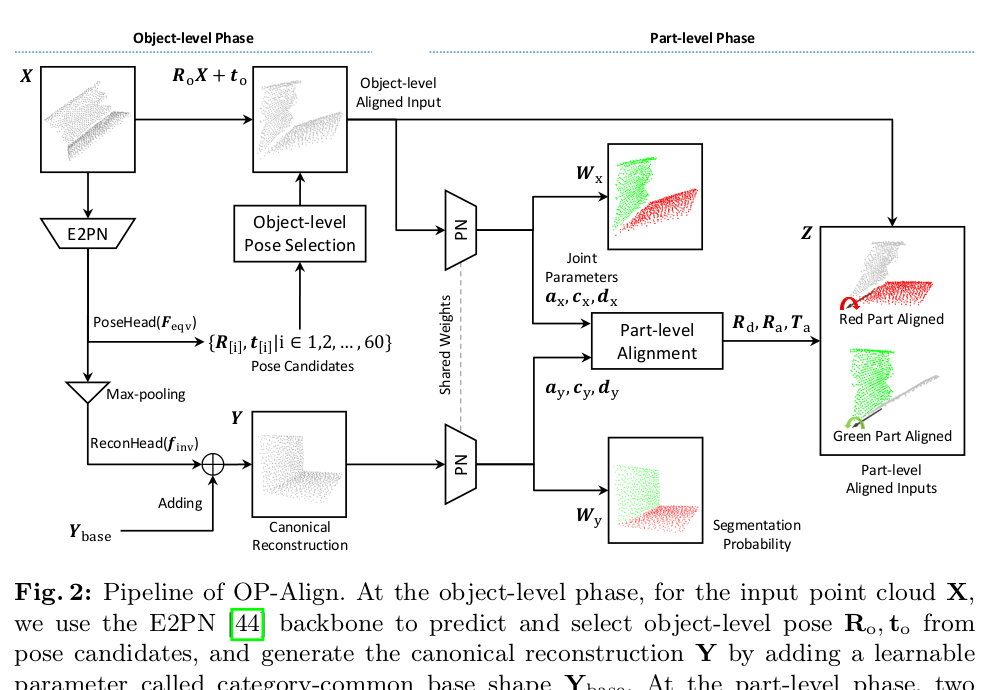
object-level alignment 只负责消除对象整体的 SE(3) 变化;
part-level alignment 模拟 joint movement,使每个部件分别与 canonical reconstruction 的对应部件重合。
只做整体对齐时,不同 joint state 会让 canonical reconstruction 无法同时对齐所有部件;直接预测 part segmentation 又需要昂贵标注。论文利用一个几何事实绕开标签:当某一部件被正确变换后,该部件的点到 reconstruction 应更近,而其他未对齐部件仍保持较大距离。因此,part alignment 产生的距离差可以间接监督 segmentation,segmentation probability 又反过来给 point-cloud distance 加权。
这条闭环在干净合成数据上有效,也带来 41 FPS;但在真实 partial point cloud 中,缺失点、outlier 和小部件会让距离差失去辨识力。论文的真实结果和失败案例恰好揭示了这种监督信号的上限。
2. 输入、输出与“自监督”的准确边界
2.1 输入与输出
输入 X ∈ R 3 × N X\in\mathbb R^{3\times N} X ∈ R 3 × N N = 1024 N=1024 N = 1024
对含 P P P J = P − 1 J=P-1 J = P − 1
part probability W ∈ R P × N W\in\mathbb R^{P\times N} W ∈ R P × N
joint pivot c j ∈ R 3 c_j\in\mathbb R^3 c j ∈ R 3 d j ∈ R 3 d_j\in\mathbb R^3 d j ∈ R 3
revolute angle 或 prismatic displacement;
每个 part 的 R i , t i R_i,t_i R i , t i
模型预先知道部件数和每个 joint 的类型,并假设每个 joint 连接两个独立部件。这不是 topology discovery,也不是一个模型覆盖任意关节结构。
2.2 自监督不等于评测完全不用标签
训练损失不读取人工 pose、part segmentation、joint pivot 或 direction;这符合论文所说的 self-supervised training。
但无标签模型形成的 canonical frame 不一定与数据集人工坐标系一致。评测时,作者对训练样本运行已训练模型,将 reconstruction-to-input 的相对 pose 与训练真值组合,再用 RANSAC 为每个 reconstruction part 估计一个共同 pose。测试预测再通过该 pose 进入人工坐标系。
因此应区分:
学习阶段 :无 pose / shape / part / joint 标签;benchmark 坐标系标定阶段 :使用训练集真值;测试推理阶段 :只用单帧点云及已知结构先验。
这不会否定自监督训练贡献,但“完全无需 pose labels”不宜扩展到整个定量评测流程。
3. 两阶段对齐
原论文 Figure 2。整体 pose、canonical reconstruction、part segmentation 与 joint parameters 不是独立分支:它们通过两层 alignment 和 weighted point-cloud distance 形成训练闭环。来源:ECVA 正式论文 ;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
3.1 Object-level phase
E2PN 为输入产生 D × 60 D\times60 D × 60 R i , t i R_i,t_i R i , t i
( R o , t o ) = arg min i CD ( R i X + t i , Y ) . (R_o,t_o)=\arg\min_i \operatorname{CD}(R_iX+t_i,Y). ( R o , t o ) = arg i min CD ( R i X + t i , Y ) . 这里 Y Y Y
Y = ReconHead ( f i n v ) + Y b a s e , Y=\operatorname{ReconHead}(f_{\mathrm{inv}})+Y_{\mathrm{base}}, Y = ReconHead ( f inv ) + Y base , 其中 Y b a s e Y_{\mathrm{base}} Y base
作者明确说 R o , t o R_o,t_o R o , t o
object-level reconstruction 使用双向 Density-aware Chamfer Distance,左右敏感系数为 α L = 30 , α R = 120 \alpha_L=30,\alpha_R=120 α L = 30 , α R = 120
L r e g S L_{\mathrm{regS}} L regS L r e g D L_{\mathrm{regD}} L regD
3.2 Part-level phase
共享权重的两个 PointNet 分别处理 R o X + t o R_oX+t_o R o X + t o Y Y Y
对第 j j j
先用 R d R_d R d
revolute joint 再绕该方向旋转 state difference a y − a x a_y-a_x a y − a x
prismatic joint 沿该方向平移 d y ( a y − a x ) d_y(a_y-a_x) d y ( a y − a x )
pivot translation 将输入 pivot 移到 reconstruction pivot。
得到的每个 Z j , i Z_{j,i} Z j , i
对共享部件,模型还要搜索 joint-side 到 part label 的合法 assignment σ ( j , i ) \sigma(j,i) σ ( j , i )
3.3 防退化正则
除 object-level loss 外,part-level 还有:
L p L_p L p L r e g W L_{\mathrm{regW}} L regW L r e g P L_{\mathrm{regP}} L regP L r e g A L_{\mathrm{regA}} L regA L r e g J L_{\mathrm{regJ}} L regJ
总损失权重为 ( λ o , λ p , λ r e g S , λ r e g D , λ r e g W , λ r e g P , λ r e g A , λ r e g J ) = ( 10 , 10 , 100 , 10 , 10 , 10 , 10 , 10 ) (\lambda_o,\lambda_p,\lambda_{\mathrm{regS}},\lambda_{\mathrm{regD}},\lambda_{\mathrm{regW}},\lambda_{\mathrm{regP}},\lambda_{\mathrm{regA}},\lambda_{\mathrm{regJ}})=(10,10,100,10,10,10,10,10) ( λ o , λ p , λ regS , λ regD , λ regW , λ regP , λ regA , λ regJ ) = ( 10 , 10 , 100 , 10 , 10 , 10 , 10 , 10 ) 10 − 4 10^{-4} 1 0 − 4
4. 数据集与评测
4.1 合成数据
EAP 数据由 HOI4D / Shape2Motion mesh 渲染为单视角 partial point cloud,含 laptop、safe、oven、washer、eyeglasses。
指标包括 segmentation IoU、part rotation / translation error、joint direction error,以及 joint pivot 到真值轴线的 point-to-line distance。
4.2 新真实数据
作者用 ASUS Xtion RGB-D 相机采集:
类别 训练实例 测试实例 训练图 测试图 关节 basket 4 2 974 449 2 revolute drawer 4 2 884 452 1 prismatic laptop 4 2 740 412 1 revolute scissors 4 2 922 421 1 revolute suitcase 4 2 813 381 1 revolute
每个实例设置 8 个随机 joint states,每个状态约 30 帧。mask 由 SAM 或 Mask R-CNN 产生;数据附带 part segmentation、part pose、joint pivot 和 direction,供评测使用。
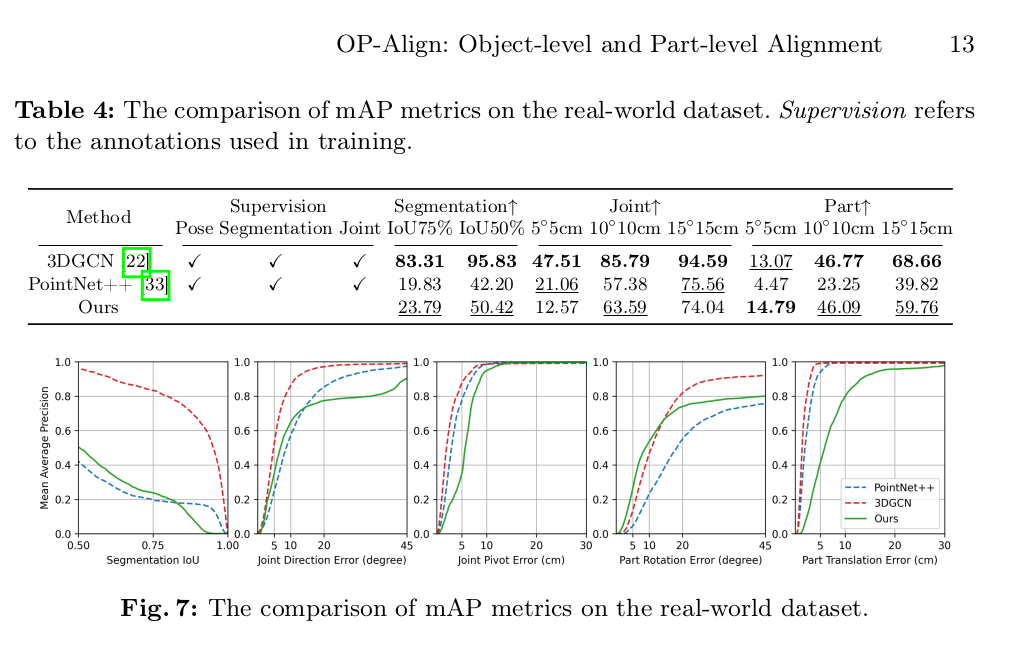
真实集报告多阈值 mAP。part pose 只有在所有 part 的 rotation 与 translation 都低于阈值时才算正确;joint 同时检查 direction 与 pivot;segmentation 用 IoU@50 / 75。对称类别还在 label permutations 中选择 mean IoU 最大者,所以数值包含了部件标签置换容忍。
5. 合成结果:优于自监督基线,但并非每项最好
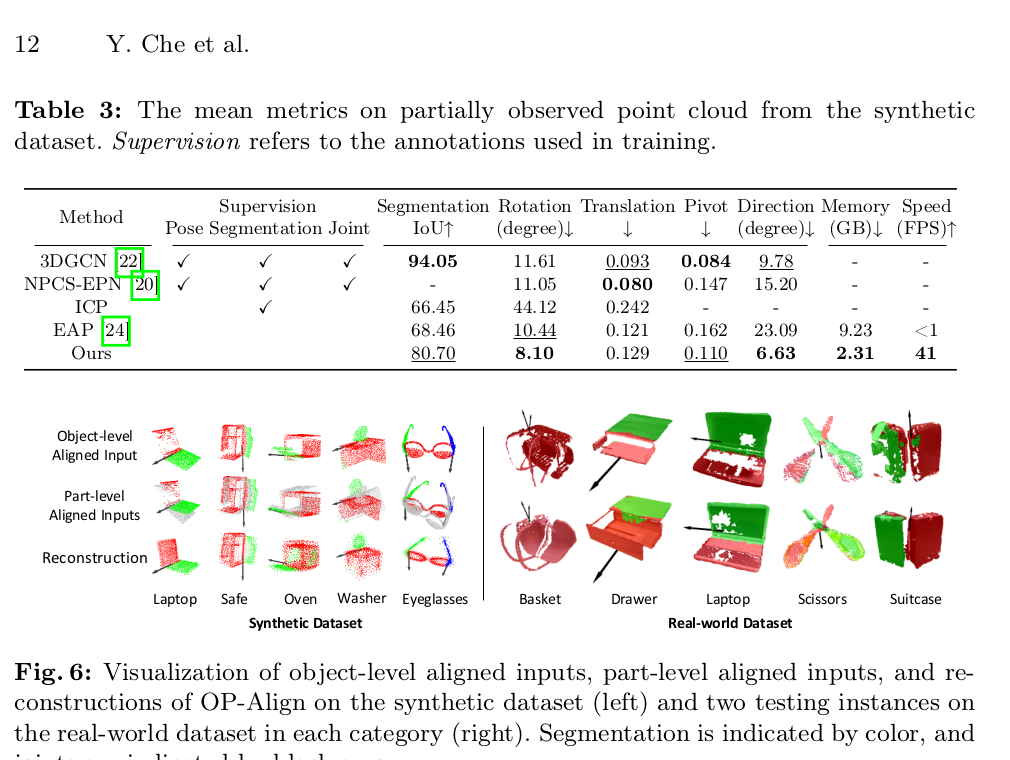
原论文 Table 3 与 Figure 6。OP-Align 对比自监督 EAP 的主要提升出现在分割、旋转和 joint direction;translation 则略差于 EAP。右侧可视化同时展示合成和真实测试实例。来源:ECVA 正式论文 ;图表版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
方法 监督 Seg. IoU↑ Rot.↓ Trans.↓ Pivot↓ Direction↓ Memory↓ FPS↑ 3DGCN pose + seg. + joint 94.05 11.61° 0.093 0.084 9.78° — — EAP 无 68.46 10.44° 0.121 0.162 23.09° 9.23 GB <1 OP-Align 无 80.70 8.10° 0.129 0.110 6.63° 2.31 GB 41
OP-Align 相对 EAP:
segmentation +12.24 points;
rotation 改善 2.34°;
direction 改善 16.46°;
memory 约降至四分之一,速度从不足 1 FPS 到 41 FPS;
translation 0.121→0.129,反而略差。
因此“显著优于此前自监督方法”对整体成立,但不是所有列都占优。与全监督 3DGCN 相比,OP-Align rotation / direction 更好,而 segmentation、translation 与 pivot 更差;监督条件不同,不能当作同成本排名。
6. 真实结果:part pose 接近,joint 与 segmentation 尚有差距
原论文 Table 4 与 Figure 7。曲线从左至右对应 segmentation IoU、joint direction、joint pivot、part rotation 与 part translation。来源:ECVA 正式论文 ;图表版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
方法 监督 Seg. IoU@75 / 50 Joint strict / medium / loose Part strict / medium / loose 3DGCN pose + seg. + joint 83.31 / 95.83 47.51 / 85.79 / 94.59 13.07 / 46.77 / 68.66 PointNet++ pose + seg. + joint 19.83 / 42.20 21.06 / 57.38 / 75.56 4.47 / 23.25 / 39.82 OP-Align 无 23.79 / 50.42 12.57 / 63.59 / 74.04 14.79 / 46.09 / 59.76
OP-Align 的 part strict mAP 14.79 略高于 3DGCN 的 13.07,中等阈值几乎相同;但宽松阈值低 8.90 points。segmentation 和 joint pose 与 3DGCN 差距更大,尤其 joint strict 为 12.57 vs 47.51。
作者对 joint pivot 失误的解释很关键:模型只需找到一个能让部件对齐的“等效轴心”,不保证该点与现实机械 joint pivot 重合。几何 alignment objective 与语义 joint parameter 不完全等价。
7. 消融、失败模式与限制
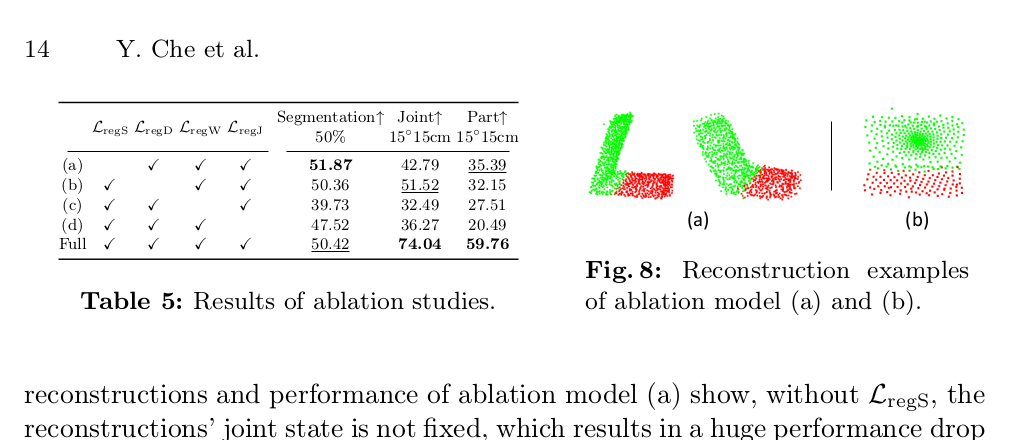
原论文 Table 5 与 Figure 8:移除任一关键正则都会造成 reconstruction 或 joint 参数退化;完整模型的 joint loose mAP 为 74.04,part loose mAP 为 59.76。来源:ECVA 正式论文 ;图表版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
去掉 shape-variance regularization:joint / part loose mAP 降至 42.79 / 35.39,canonical joint state 不固定。
去掉 density regularization:reconstruction points 聚成小区域。
去掉 segmentation regularization:某些多部件对象塌缩为 single-part,无法生成有效 joint。
去掉 joint-pivot regularization:pivot 可漂到对象外,part loose mAP 降至 20.49。
作者报告 basket handle 在测试集中只占全对象点数中位数的 16.9%,且移动对整体形状影响小。即使不做 part alignment,整体 reconstruction 也已经足够接近,模型没有动力发现 handle。
更一般的风险包括:
单帧 partial point cloud 看不到 joint 附近时,多个结构解释可能同样合理;
RGB-D 深度洞和 mask outlier 会直接污染距离监督;
每个类别单独训练,尚未验证跨类别共享;
已知 P P P
41 FPS 是 pose model 的推理速度,不包含对象检测、SAM / Mask R-CNN、RGB-D 获取与反投影;
论文没有报告跨相机、跨数据集、强遮挡分层结果,也没有给置信度。
8. 复现检查表
确认 E2PN 的 60 anchors、旋转约定和 R o X + t o R_oX+t_o R o X + t o
使用 1,024 points、无 RGB,并复现与论文一致的归一化;
分开实现 object-level CD/DCD、part-level weighted distance 与 assignment σ \sigma σ
保持两个 PointNet 共享权重;
核对 revolute / prismatic 的 R d , R a , T a R_d,R_a,T_a R d , R a , T a
完整实现八项 loss 和给定权重,尤其 joint / segmentation 防退化项;
对测试 canonical frame 执行训练集真值 + RANSAC 标定,并在报告中显式说明;
对称类别复现 part-label permutation;
分开计网络 FPS 与检测、分割、点云构建的端到端时延;
额外报告 small-part ratio、可见比例、depth missing ratio 与 mask quality 分层结果。
9. 最终评价
OP-Align 是一篇问题拆解很有启发性的关节物体论文:用“整体对齐降低姿态方差、部件对齐产生分割信号”的两层几何结构,让单帧 category-level articulated pose 可以在不读训练标签的条件下学习,并把 EAP 的不足 1 FPS 推到 41 FPS。
它的证据也提醒读者不要把“alignment 成功”直接等同于“真实 joint 参数恢复”。在真实数据上,OP-Align 的 part pose 某些阈值接近全监督基线,但 segmentation 和 joint pivot 仍有明显差距;同时依赖已知拓扑与评测坐标系标定。把这些边界保留下来后,这篇工作非常适合作为 self-supervised articulated pose 的方法入口。