论文精读笔记:Oryon
1. 核心判断
Oryon 的真正贡献不是“把 CLIP 接到 pose network”,而是重新定义了新物体接入方式:用户不再提供 CAD、扫描视频或固定类别 id,而是用一句描述指定目标。系统必须同时解决三件事:
两幅不同场景里哪个区域是文本所指对象;
两个目标区域之间哪些局部位置对应;
如何把带噪 2D correspondence 转成可靠相对 SE(3)。
它把前两项放进共享 feature learning,第三项交给显式 RGB-D 几何和 PointDSC。结果证明该设定可行,但 REAL275 自预测 mask 的 AR 只有 32.2,而 Oracle mask 为 46.5;开放词汇定位仍然决定了较大一部分上限。Oryon 更适合被看成“语言驱动的 CAD-free relative pose baseline”,不是可替代强 CAD-based BOP 系统的通用绝对位姿器。
2. 任务边界与坐标关系
输入:
anchor scene A = ( I A , D A , K A ) A=(I^A,D^A,K^A) A = ( I A , D A , K A )
query scene Q = ( I Q , D Q , K Q ) Q=(I^Q,D^Q,K^Q) Q = ( I Q , D Q , K Q )
描述对象的文本 T T T
输出:
T A → Q = [ R t 0 1 ] ∈ S E ( 3 ) , T_{A\rightarrow Q}=
\begin{bmatrix}
R & t\\
0 & 1
\end{bmatrix}\in SE(3), T A → Q = [ R 0 t 1 ] ∈ S E ( 3 ) , 使 anchor 中目标点变换后与 query 中同一对象对齐。
论文的“model-free”应严格理解为测试时不需要对象 CAD / object video。系统仍然需要:
两幅图都包含同一刚体对象;
两幅深度图可反投影;
相机内参;
文本能在场景内提供足够区分性;
训练期 ShapeNet6D 的对应与分割监督。
因此它与单图 category-level 6D pose、CAD-based unseen-object pose、纯 RGB relative rotation 都不是同一协议。
3. 共享文本—视觉局部表示
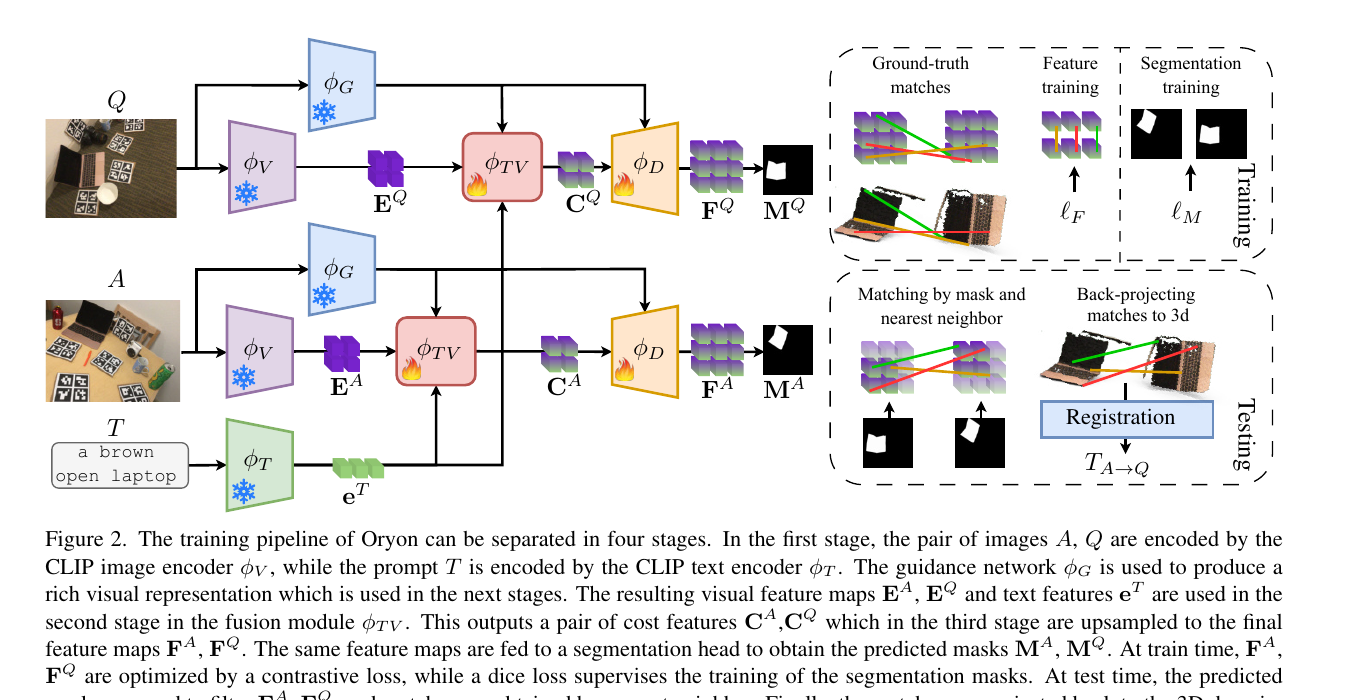
原论文 Figure 2。训练阶段同时学习 feature matching 与 segmentation;测试阶段以预测 mask 过滤局部特征、做最近邻匹配、反投影到三维并注册。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
Oryon 使用三类输入特征:
冻结 CLIP ViT-L/14 图像编码器 ϕ V \phi_V ϕ V E A , E Q E^A,E^Q E A , E Q
冻结 CLIP 文本编码器 ϕ T \phi_T ϕ T e T e^T e T
冻结 guidance backbone ϕ G \phi_G ϕ G
核心 ϕ T V \phi_{TV} ϕ T V
对象级语义:当前匹配的是哪一个概念;
局部外观:跨场景的像素 / patch 对应;
三维结构相关性:后续能由 depth 转成稳定几何。
decoder ϕ D \phi_D ϕ D 192 × 192 192\times192 192 × 192 F A , F Q F^A,F^Q F A , F Q M A , M Q M^A,M^Q M A , M Q
4. 损失、对应与几何求解
局部 feature 采用 hardest-negative contrastive objective:真值对应要接近,其他位置中最难负样本要远离。mask 使用 Dice loss。联合训练的意义可由 Table 4 观察:
只训练 segmentation:AR 24.8、mIoU 63.3;
segmentation only + Oracle mask:AR 33.2;
只训练 matching、使用 Oracle mask:AR 40.3;
联合训练完整 Oryon:自预测 mask AR 32.2、Oracle mask AR 46.5。
也就是说,匹配损失反过来改善 segmentation,segmentation supervision 也让 feature 更聚焦对象。它不是简单把一个开放词汇 segmenter 放在 pose 模型前。
推理流程:
由 M A , M Q M^A,M^Q M A , M Q
在 F A , F Q F^A,F^Q F A , F Q
最多抽取 500 对 feature matches;
用各自 depth 与 intrinsics 反投影:
x = D ( u , v ) K − 1 [ u , v , 1 ] ⊤ ; x=D(u,v)K^{-1}[u,v,1]^\top; x = D ( u , v ) K − 1 [ u , v , 1 ] ⊤ ;
将 { x i A , x i Q } \{x_i^A,x_i^Q\} { x i A , x i Q } R , t R,t R , t
PointDSC 对噪声对应的容忍度是系统重要组成。用 RANSAC-based estimator 替换后,REAL275 AR 从 32.2 降到 15.0,下降 17.2;不能把 Oryon 的性能完全归因于 VLM feature。
5. 数据与评测协议
训练:
ShapeNet6D;
约 20k image pairs;
每对由不同视角 / 场景中的同一模型构成;
20 epochs;
模型学习新类别通用的文本—视觉对应,而不是记忆 REAL275 类别。
评测:
REAL275:NOCS real split 派生的 2k scene pairs;
Toyota-Light:2k scene pairs;
合计 34 个 object instances、4k pairs;
每对图像的场景布局、背景与相机位置可显著不同。
指标:
VSD:可见表面差异;
MSSD:symmetry-aware 最大表面距离;
MSPD:symmetry-aware 最大投影距离;
AR:三者在阈值范围上的平均 recall;
ADD(S)-0.1d;
segmentation mIoU。
由于输出是 anchor→query relative transform,作者将两幅场景中的对象 pose 组合成相对 GT 后评测。这里的 AR 与标准 BOP detection pipeline 的 target list / absolute camera pose 协议相关但不完全等价。
6. 主结果:REAL275 与 Toyota-Light
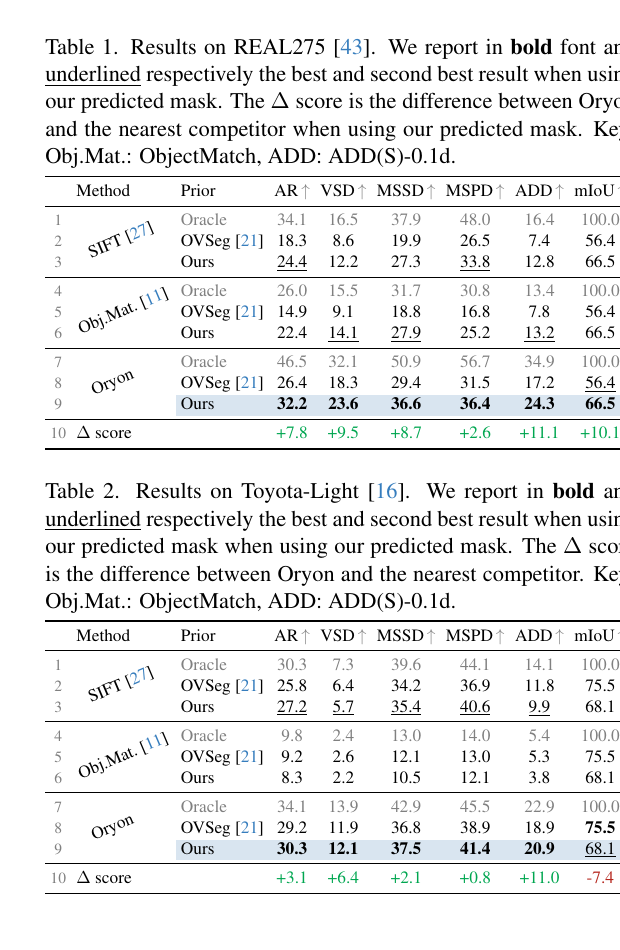
原论文 Table 1–2。每个方法都分别在 Oracle、OVSeg 与 Oryon 自预测 mask 下比较;绿色 Δ 是 Oryon 相对同 mask 条件下最近竞争者的差值,而不是相对 Oracle。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
REAL275:
方法 / mask AR VSD MSSD MSPD ADD mIoU SIFT / Oryon mask 24.4 12.2 27.3 33.8 12.8 66.5 ObjectMatch / Oryon mask 22.4 14.1 27.9 25.2 13.2 66.5 Oryon / Oryon mask 32.2 23.6 36.6 36.4 24.3 66.5 Oryon / Oracle 46.5 32.1 50.9 56.7 34.9 100
同一自预测 mask 下,Oryon 对 SIFT 的 AR 提升 7.8,对 ObjectMatch 提升 9.8。它在 ADD 上相对最近竞争者提升 11.1,说明 learned semantic-local feature 的价值不只来自 mask。
Toyota-Light:
方法 / mask AR VSD MSSD MSPD ADD mIoU SIFT / Oryon mask 27.2 5.7 35.4 40.6 9.9 68.1 ObjectMatch / Oryon mask 8.3 2.2 10.5 12.1 3.8 68.1 Oryon / Oryon mask 30.3 12.1 37.5 41.4 20.9 68.1 Oryon / Oracle 34.1 13.9 42.9 45.5 22.9 100
Toyota-Light 的 illumination / domain shift 更强,SIFT 的 scale invariance 让其与 Oryon 差距变小;ObjectMatch 则明显崩溃。Oryon 的 Oracle→predicted mask AR 只差 3.8,显著小于 REAL275 的 14.3,说明这里 pose 错误更多来自外观 / 几何匹配,而非 mask。
7. 定性结果:正确 mask 不等于正确 pose
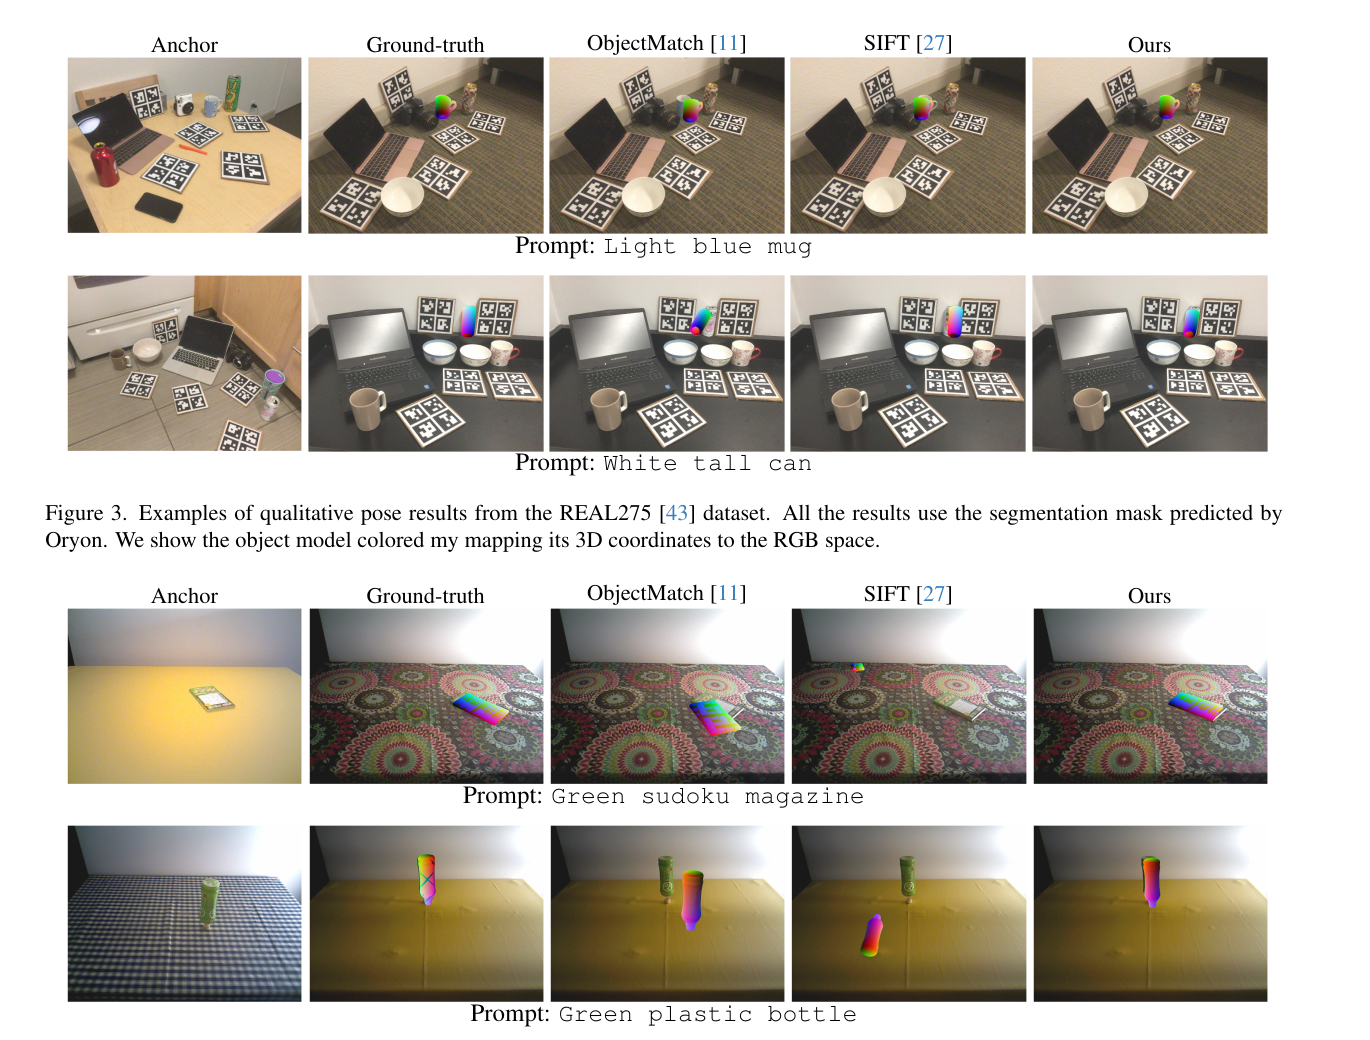
原论文 Figure 3–4。彩色坐标映射展示模型点在预测 pose 下的投影;Oryon 在跨场景、尺度变化和照明变化下通常比 ObjectMatch / SIFT 更贴合,但细长小物体的 translation 仍可能偏移。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
图中有两个值得注意的现象:
目标 mask 可以基本正确,但 ObjectMatch 仍产生明显旋转 / 平移错误;定位与局部几何对应是不同难点。
小目标和细长目标即使语义正确,depth 中可用点少,PointDSC 的稳定性仍受限制。
所以 Oryon 的“joint segmentation + matching”应看成降低 error coupling,而不是消除几何退化。
8. 消融:架构、prompt 与 sensitivity
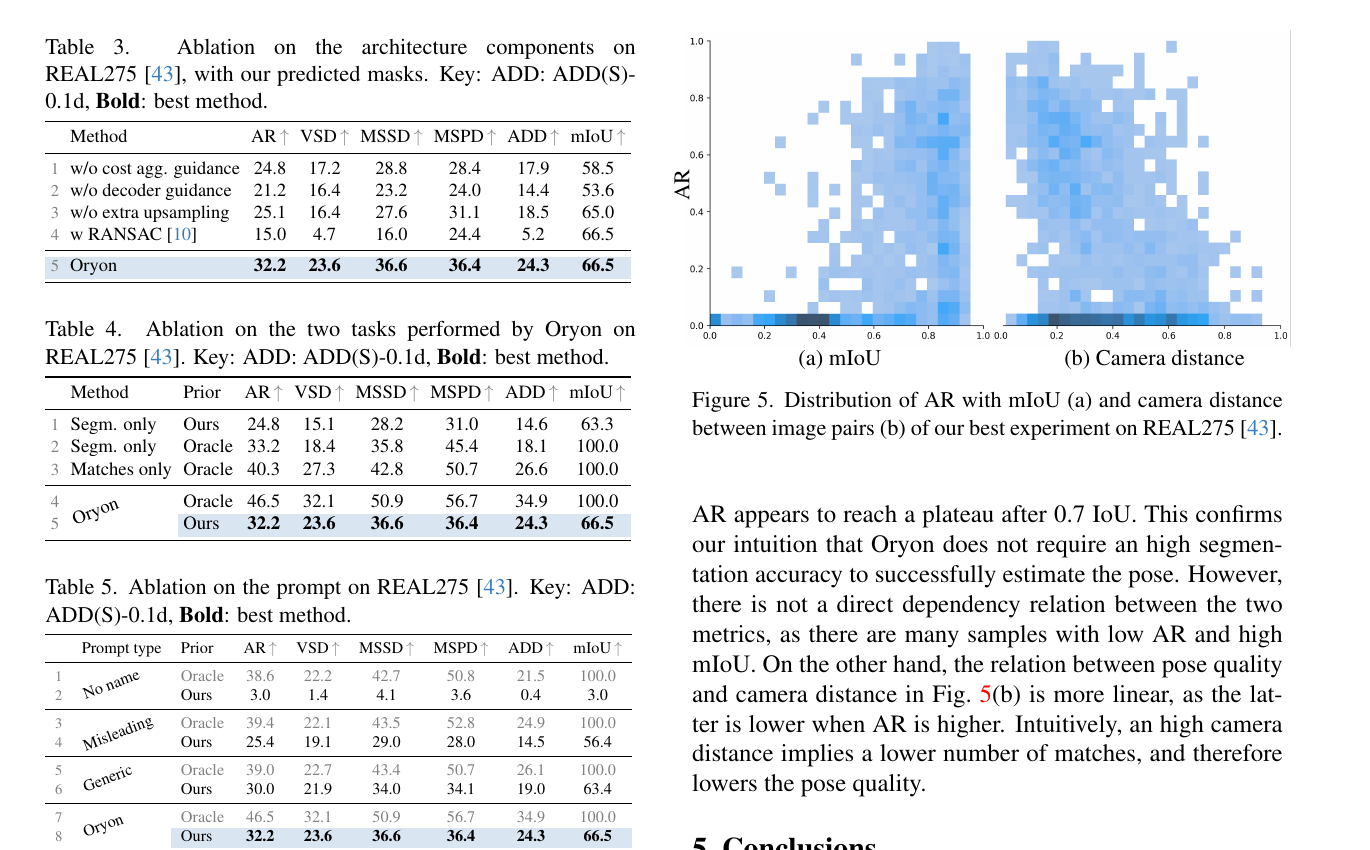
原论文 Table 3–5 与 Figure 5。左侧分别消融 guidance、上采样、注册器、联合任务和 prompt;右侧分析 AR 与 mask IoU / camera distance 的关系。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
架构:
无 cost aggregation guidance:AR 24.8;
无 decoder guidance:21.2;
少一层 upsampling、feature map 仅 96 × 96 96\times96 96 × 96
RANSAC 替换 PointDSC:15.0;
完整:32.2。
prompt:
把对象名也去掉,仅写 “object”:自预测 mask mIoU 3.0、AR 3.0;
给 misleading description 但保留真实对象名:mIoU 56.4、AR 25.4;
只给对象名 / generic description:mIoU 63.4、AR 30.0;
完整描述:mIoU 66.5、AR 32.2。
这说明“名称”承担基本 category selection,“属性描述”主要帮助同类实例 / 状态消歧。模型并未做到任意自然语言都稳健;prompt engineering 是可见的系统变量。
敏感性:
IoU 从低值升到约 0.4 时 AR 快速改善;
约 0.7 后趋于平台;
高 mIoU 样本中仍存在低 AR,二者不是确定函数;
camera distance 越大,可用匹配减少,AR 总体下降。
9. 与相邻路线的关系
与 FoundationPose / GigaPose:
后两者依赖 CAD 或重建模型,输出 absolute pose,通常精度更高;
Oryon 用文本 + anchor RGB-D 替代 model onboarding,任务更开放。
与 NOPE / DVMNet:
三者都面向相对 pose;
NOPE 只需单 reference RGB,但重点是相对 rotation;
DVMNet 用 3D voxel matching 从 RGB pair 解 pose;
Oryon 额外解决文本指代和场景内定位,但要求 RGB-D。
与开放词汇 segmentation:
Oryon 不只是将 OVSeg 作为前端;其自训练 segmentation head 与 correspondence feature 共享表示。
表中 Oryon mask mIoU 66.5 对比 OVSeg 56.4 / 75.5(不同数据),但最终 pose 还受 matching 与注册器控制。
10. 局限与失败条件
depth 是硬依赖;无有效深度时无法形成 3D–3D registration;
同一对象必须在 anchor / query 中都出现;
两图中目标均严重遮挡时,可用对应不足;
相同名称的多个实例需要属性描述,否则存在指代歧义;
对机械部件、纹理贫乏零件,用户难以写出既自然又区分实例的 prompt;
CLIP 的概念偏差会传递到 mask 与 matching;
Oracle gap 表明分割仍是主要瓶颈之一;
PointDSC 增强稳健性,但带来额外依赖与运行开销;
benchmark 只有两个数据源、34 instances,开放世界覆盖仍有限;
论文不提供无 depth / depth prediction 的完整实验。
11. 复现检查表
使用论文版本的 REAL275 / Toyota-Light scene-pair 划分,避免按原数据单图评测;
确认 anchor→query transform 的乘法方向和坐标系;
RGB resize、depth resize 与 intrinsics 必须一致;
冻结 CLIP 与 guidance backbone,只训练 fusion / decoder / mask head;
输出 feature map 保持 192 × 192 × 32 192\times192\times32 192 × 192 × 32
分别复现 feature contrastive loss 与 Dice loss;
最近邻匹配、mask filtering 与 500-pair sampling 顺序一致;
使用相同 PointDSC checkpoint / 参数;
同时报 predicted mask 与 Oracle mask,拆分 perception / geometry 误差;
报 AR、VSD、MSSD、MSPD、ADD 与 mIoU,不只挑一个指标;
保存 prompt 文本,保证不同方法比较时指代条件一致;
对同名多实例、远距离、小目标和 depth holes 单列失败率。
12. 最终评价
Oryon 最有价值之处,是把“我想找哪个对象”从固定 class id / CAD 文件改成语言,并让这条语义线索真正进入局部匹配,而不是只做前端框选。REAL275 上完整方法相对 SIFT / ObjectMatch 的提升、guidance 与 PointDSC 的大幅消融,以及 prompt 类型的量化,都支持这条设计逻辑。
但 32.2 AR 与 46.5 Oracle AR 的差距也说明:开放词汇 pose 的难度没有因 VLM 而消失。可靠系统仍需处理指代歧义、分割漏检、depth holes 与低重叠注册。最准确的结论是:Oryon 建立了文本指定、无 CAD、跨场景 RGB-D 相对位姿的可复现实验起点,并清楚暴露了语义前端与几何后端各自的误差上限。