论文精读笔记:Robust Category-Level 3D Pose Estimation From Diffusion-Enhanced Synthetic Data
1. 基本信息
简称 :P3D-Diffusion + CC3D作者 :Jiahao Yang, Wufei Ma, Angtian Wang, Xiaoding Yuan, Alan Yuille, Adam Kortylewski机构 :Peking University;Johns Hopkins University;University of Freiburg;Max Planck Institute for Informatics会议 / 页码 :WACV 2024,pp. 3446–3455官方论文页 :CVF Open Access 论文 PDF :CVF PDF 代码 :github.com/YangYY06/synthetic_3d 阅读模式 :精读
2. 一句话定位
论文用 CAD renderer 固定 3D rotation label,用 Canny-edge-conditioned diffusion 只改造对象外观,再用类别无关的随机背景削弱 spurious correlation;随后将 Neural Mesh Model 从合成域迁移到无标签真实域,通过 pseudo-pose 建立真实图像 feature 与 3D mesh vertex 的对应并施加 CC3D consistency loss,在 PASCAL3D+ 少标签和 OOD-CV 分布偏移下提高类别级 3D orientation estimation。
最重要的任务边界
本文标题中的 3D Pose 指 3D orientation / rotation :输出 azimuth、elevation、in-plane rotation 或等价旋转矩阵。它没有估计:
相机坐标中的 3D translation;
metric object scale;
instance-level CAD-to-image 6D alignment;
BOP 意义下的完整 S E ( 3 ) SE(3) S E ( 3 )
因此本页把它作为物体位姿专题中的“类别级朝向 + 合成数据泛化”工作收录,但所有结果都按角度指标解释,绝不与 ADD(-S)、VSD、BOP AR 直接混排。
2.1 论文图表导读
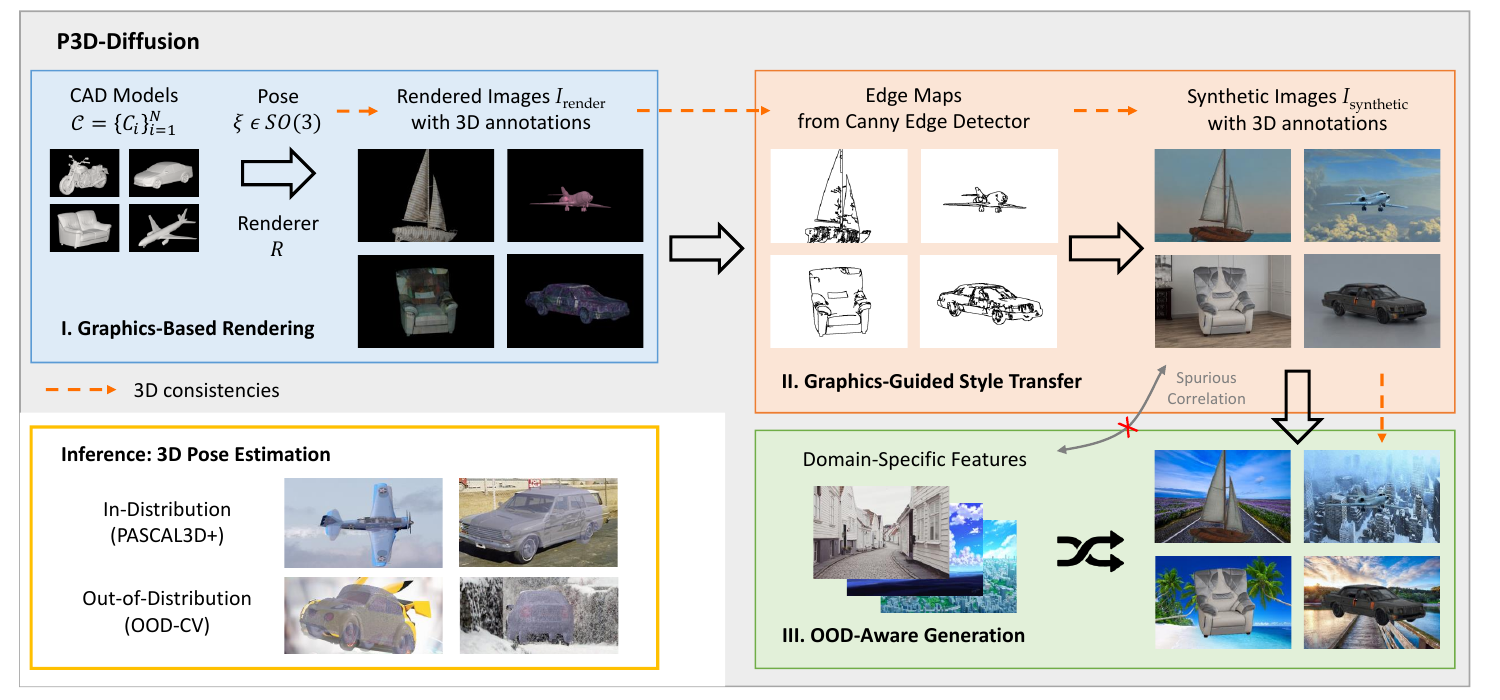
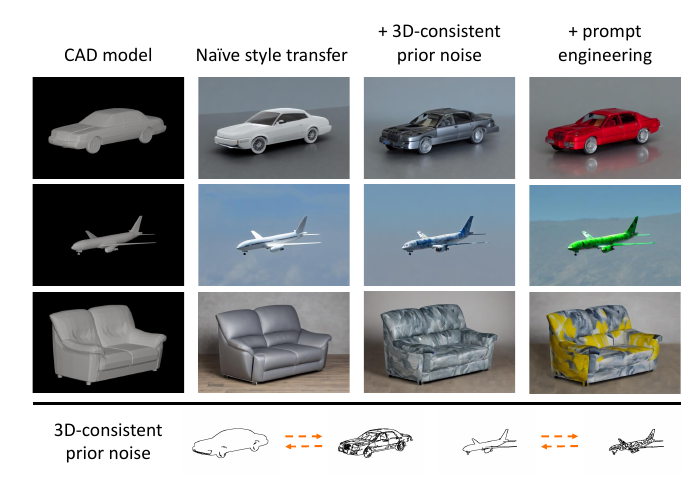
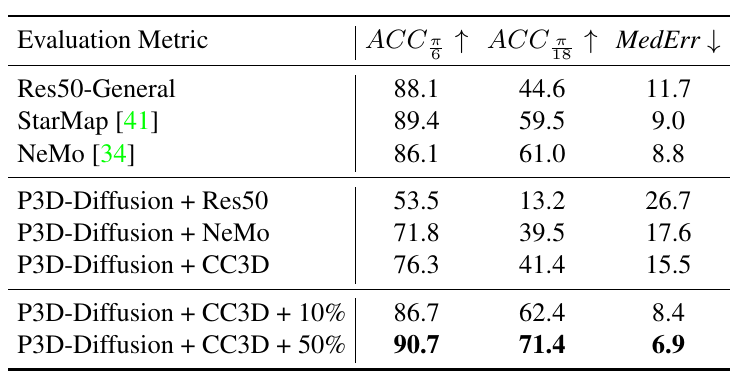
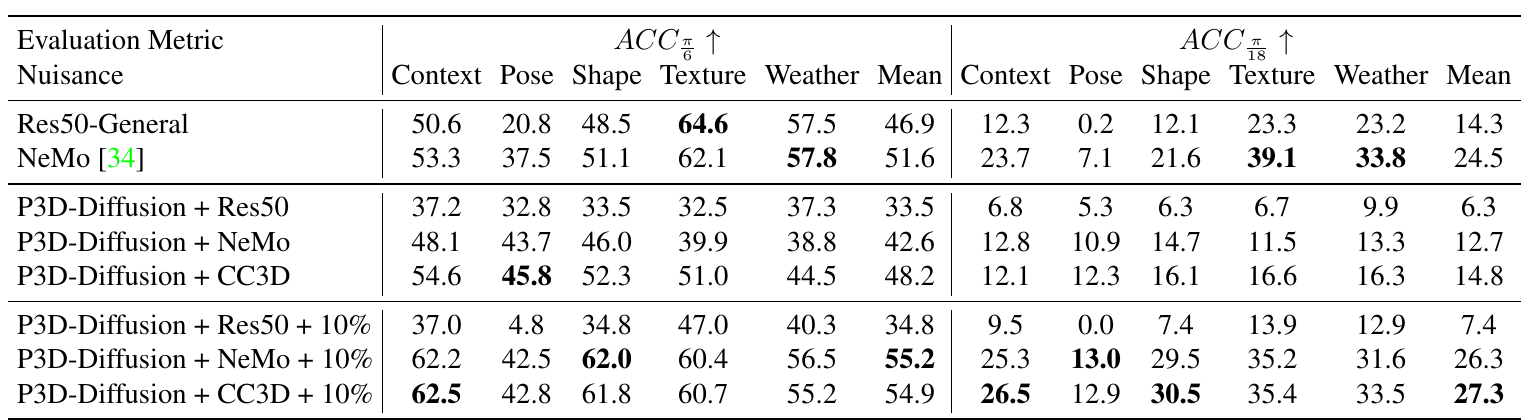
图表 论文主张 需要留意的边界 Figure 1 rendering 提供可控旋转,edge-guided diffusion 改善现实感,随机背景打破类别—环境捷径。 Edge map 约束不自动等于生成后的姿态标签零漂移。 Figure 2 DTD texture prior 与随机颜色 prompt 缓解生成器的颜色 / 纹理 mode collapse。 是定性例子,没有 diversity 或 geometry preservation 的量化指标。 Table 2 10% 真实标签可匹配全监督 baseline,50% 可明显超过。 仍额外使用每类 7,000 合成图和无标签真实图;比较的是人工 pose label 效率。 Table 3 synthetic variation 与 CC3D 提高 OOD-CV robustness。 不是所有 nuisance 和阈值都领先;texture / weather 仍是弱项。
原论文 Figure 1:左上由 CAD、随机 $SO(3)$ 旋转与 renderer 产生精确标签;右上将 render edges 输入条件扩散模型;右下让前景类别与背景独立采样;左下在 PASCAL3D+ 与 OOD-CV 上估计 category-level rotation。CC3D 的具体 neural-mesh adaptation 未在此图中展开。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
3.1 任务定义
输入单张对象 RGB 图像 I I I R p r e d ∈ S O ( 3 ) R_{pred}\in SO(3) R p r e d ∈ S O ( 3 )
Δ ( R p r e d , R g t ) = ∥ \logm ( R p r e d T R g t ) ∥ F 2 . \Delta(R_{pred},R_{gt})=
\frac{\left\lVert\logm(R_{pred}^{T}R_{gt})\right\rVert_F}{\sqrt 2}. Δ ( R p r e d , R g t ) = 2 \logm ( R p r e d T R g t ) F . 报告三个指标:
A C C π / 6 ACC_{\pi/6} A C C π /6 Δ < 30 ∘ \Delta<30^\circ Δ < 3 0 ∘ A C C π / 18 ACC_{\pi/18} A C C π /18 Δ < 10 ∘ \Delta<10^\circ Δ < 1 0 ∘ MedErr:角度误差中位数,单位为 degree。
3.2 训练阶段输入 / 输出
阶段 输入 输出 / 监督 Graphics rendering category CAD、随机旋转 ξ \xi ξ render image、edge map、精确旋转标签 Diffusion enhancement Canny edge、颜色 + 类别 prompt、随机背景 realistic-looking synthetic RGB;沿用 render rotation label Synthetic NMM training synthetic RGB + rotation labels feature extractor、每个 neural-mesh vertex 的 feature prototype Unsupervised adaptation 无标签真实 RGB 初始 pseudo-pose、mesh–image correspondence、CC3D domain loss Semi-supervised fine-tuning 可选少量真实 rotation labels + pseudo labels 最终 category-level orientation model
3.3 推理阶段
Neural Mesh Model 并非直接用分类头一次输出旋转。它:
用 ResNet50 提取 2D feature map;
按候选 pose 把 cuboid neural mesh 投影到图像;
比较投影顶点 feature C r C_r C r f i f_i f i
对 pose 参数做 gradient descent,最小化 feature reconstruction loss。
这属于 analysis-by-synthesis / render-and-compare。它通常比单次前向分类器更可解释,但速度、初始化和局部极值是必须评估的工程因素;论文正文没有给完整 latency / FPS 表。
3.4 先验与假设
目标类别已知,并有 category-level CAD models;
训练 / 测试遵循 PASCAL3D+ 的对象 crop 与类别设定;
CAD render 的 edge structure 足以约束 diffusion 输出保持姿态;
synthetic-pretrained model 在真实图上能产生一批足够准确的初始 pseudo-poses;
高 mesh–image feature similarity 与 pseudo-pose 正确性相关;
cuboid mesh 能覆盖类别对象的大部分可见区域;
单一旋转标签能合理表达类别内实例,即对称性和标注歧义不至于主导指标。
4. 研究脉络
4.1 类别级 rotation 的两类传统方法
Classification / regression :把 viewpoint 离散成 bins 或直接回归角度。Res50-General 是本文代表性 baseline。Keypoint / render-and-compare :预测语义关键点后做 PnP,或将 3D template 渲染到图像并最小化重建误差。NeMo / Neural Mesh Model 属于后者。
分类法速度直接,但容易依赖纹理 / 背景统计;3D-aware neural mesh 明确编码了 mesh vertex ↔ image feature 对应,在少样本下更有结构先验。
4.2 与 NeMo / NVSM 的关系
NeMo:为类别建立 cuboid neural mesh,每个 vertex 存储 discriminative feature,推理时 inverse rendering 求 rotation。NVSM:面向 semi-supervised few-shot 的 neural view synthesis and matching,在 7 / 20 labels 设置中是论文引用的强 baseline。本文:数据侧加入 P3D-Diffusion,模型侧加入 CC3D,让 synthetic vertex features 与 real vertex features 在 pseudo-correspondence 下保持一致。
所以 CC3D 不是从零构造新的 pose representation,而是 对 NeMo 的合成训练与无监督域适配扩展 。
4.3 扩散模型在本文中的位置
扩散模型不预测 rotation,也不参与测试时 pose search。它只在数据生成阶段承担 graphics-guided style transfer:
结构约束:Canny edges;
文本条件:随机颜色 + 类别;
3D-consistent prior noise:先给 CAD 随机 DTD texture,使纹理边缘随对象表面 / 视角变化;
输出:更像真实照片的前景对象,再与随机背景合成。
对应引用是 ControlNet(Adding Conditional Control to Text-to-Image Diffusion Models)。
5. 研究动机
5.1 为什么纯 renderer 不够
大规模 CAD render 可以准确采样旋转标签,但公开 CAD 往往缺少高质量材质,真实照明与 specular effects 也很难模拟。训练网络会识别出明显的 synthetic style,迁移到自然图像时 feature distribution 改变。
5.2 为什么无约束生成也不够
直接用 text-to-image model 生成“car from side view”有三个问题:
视角标签无法精确对应 S O ( 3 ) SO(3) S O ( 3 )
生成器可能改变轮廓、部件和透视;
训练数据可能复制互联网中 object–context bias。
论文的解决方式是让 renderer 决定 geometry / pose,扩散模型只在 edge control 下负责外观。
5.3 为什么还需要 CC3D
即使扩散图像更真实,synthetic 与 real feature 仍不同。传统 feature-level domain adaptation 不知道哪些 2D pixels 对应同一个 3D surface point,容易对齐无关局部区域。
Neural mesh 提供 3D vertex identity。只要有 pseudo-pose,就能把 real feature 投影到 vertex r r r C r C_r C r 同一 3D 位置跨域一致 。
6. 方法详解(一):P3D-Diffusion
6.1 基础生成公式
给定 CAD models C = { C i } i = 1 N \mathcal C=\{C_i\}_{i=1}^{N} C = { C i } i = 1 N B = { B j } j = 1 K \mathcal B=\{B_j\}_{j=1}^{K} B = { B j } j = 1 K
I r e n d e r = R ( C i , ξ ) , ξ ∈ S O ( 3 ) . I_{render}=R(C_i,\xi),\qquad \xi\in SO(3). I r e n d er = R ( C i , ξ ) , ξ ∈ S O ( 3 ) . 朴素生成可写为 render 与背景的叠加,但本文进一步使用:
E = CannyEdge ( I r e n d e r ) , E=\operatorname{CannyEdge}(I_{render}), E = CannyEdge ( I r e n d er ) , I s y n t h e t i c ′ = Ψ ( E ) ⊕ B j , I'_{synthetic}=\Psi(E)\oplus B_j, I sy n t h e t i c ′ = Ψ ( E ) ⊕ B j , 其中 Ψ \Psi Ψ ⊕ \oplus ⊕
6.2 “精确标签”从哪里来
rotation label 直接来自 renderer 参数 ξ \xi ξ
Canny edges 保留 render 的 silhouette 与主要内部边缘;
ControlNet 输出遵守这些 edges;
生成对象没有在 3D sense 上发生会改变 viewing rotation 的结构漂移;
因此可把 ξ \xi ξ I s y n t h e t i c ′ I'_{synthetic} I sy n t h e t i c ′
作者声称 :graphics-guided module 能在产生 realistic images 的同时保持 3D consistency。
我的分析 :这是合理工程近似,但论文只提供定性图和下游性能,没有通过 keypoint reprojection、silhouette IoU、重新标注姿态或多视图一致性定量测量 label preservation。对简单车辆 / 椅子类别大概率可用,对细长、强关节或高度对称对象则需要额外审计。
6.3 缓解生成 mode collapse
初始 edge-to-image generation 会产生相似颜色、弱纹理对象。论文增加两项干预:
DTD textures :渲染前给 CAD 随机纹理。这些纹理在物体表面随视角投影,产生所谓 3D-consistent prior noise,引导扩散模型生成更多局部材质变化。Prompt engineering :prompt 采用 [random color] [category],例如 red car / green aeroplane。
原论文 Figure 2:从 CAD render 到 naïve style transfer,再加入 DTD 纹理形成的 3D-consistent prior noise,最后加入随机颜色 prompt。图中展示外观多样性增强,但未给 LPIPS、CLIP diversity 或几何一致性统计。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.4 OOD-aware background generation
论文从 causal / spurious-correlation 视角讨论背景:真实数据中任务语义与 domain-specific context 相关,例如 car 常在 road,boat 常在 water。模型可借背景猜类别 / 姿态,域内准确、域外脆弱。
具体做法很简单:
从互联网搜索 wallpaper + street / jungle / market / beach,收集 100 张背景;
生成时 B j B_j B j
形成 car-on-beach、boat-in-market 等非典型组合;
以 P3D-Diffusion-Spurious(类别与典型背景绑定)作为消融。
这不是复杂 causal identification,而是一个明确的数据随机化 intervention。
6.5 数据规模
每类别 7,000 张 synthetic images;
CAD 来自 PASCAL3D+ / OOD-CV;
纹理来自 Describable Texture Dataset;
背景 100 张;
旋转随机采样;
Blender renderer。
正文没有系统列出扩散模型版本、sampling steps、guidance scale、分辨率、每图生成耗时和失败样本过滤率;复现时需要结合代码 / supplement。
7. 方法详解(二):Neural Mesh Model 与 CC3D
7.1 Neural mesh 表示
类别对象表示为:
N = { V , C } , \mathfrak N=\{\mathcal V,\mathcal C\}, N = { V , C } , 其中:
V = { V r ∈ R 3 } r = 1 R \mathcal V=\{V_r\in\mathbb R^3\}_{r=1}^{R} V = { V r ∈ R 3 } r = 1 R C = { C r ∈ R c } r = 1 R \mathcal C=\{C_r\in\mathbb R^c\}_{r=1}^{R} C = { C r ∈ R c } r = 1 R F = Φ W ( I ) F=\Phi_W(I) F = Φ W ( I )
Synthetic training 有 GT rotation,所以可把 mesh vertex 投影到 feature map,建立 C r ↔ f i C_r\leftrightarrow f_i C r ↔ f i C r C_r C r
7.2 Contrastive feature loss
论文沿用已有 neural mesh / CoKe 思路,让前景不同位置以及前景 / 背景 features 彼此可区分。正文给出的形式为:
L c o n ( F ) = − ∑ i ∈ F G ( ∑ j ∈ F G ∖ { i } ∥ f i − f j ∥ 2 + ∑ j ∈ B G ∥ f i − f j ∥ 2 ) . \mathcal L_{con}(F)=
-\sum_{i\in FG}\left(
\sum_{j\in FG\setminus\{i\}}\lVert f_i-f_j\rVert^2+
\sum_{j\in BG}\lVert f_i-f_j\rVert^2
\right). L co n ( F ) = − i ∈ F G ∑ j ∈ F G ∖ { i } ∑ ∥ f i − f j ∥ 2 + j ∈ B G ∑ ∥ f i − f j ∥ 2 . 负号意味着最小化时增大不同位置 features 的距离,从而形成空间可辨识 neural texture。
7.3 Reconstruction / inverse-rendering loss
测试时对候选 pose m m m b b b
L r e c ( F , N , m , b ) = − log p ( F ∣ N , m , b ) . \mathcal L_{rec}(F,\mathfrak N,m,b)=-\log p(F\mid \mathfrak N,m,b). L r ec ( F , N , m , b ) = − log p ( F ∣ N , m , b ) . 优化 m m m
7.4 Domain-consistency loss
新域真实图的 feature map 为 F ~ \tilde F F ~ r r r f ~ r \tilde f_r f ~ r
L d o m a i n ( C , { F ~ } ) = ∑ r = 1 R ∥ f ~ r − C r ∥ 2 . \mathcal L_{domain}(\mathcal C,\{\tilde F\})=
\sum_{r=1}^{R}\lVert \tilde f_r-C_r\rVert^2. L d o main ( C , { F ~ }) = r = 1 ∑ R ∥ f ~ r − C r ∥ 2 . 总损失:
L j o i n t = L c o n + L r e c + α L d o m a i n , \mathcal L_{joint}=\mathcal L_{con}+\mathcal L_{rec}+\alpha\mathcal L_{domain}, L j o in t = L co n + L r ec + α L d o main , α \alpha α
7.5 Pseudo-label 生成与筛选
先在 synthetic data 上训练 NMM;
对每张 unlabeled real image 优化 pose m e s t m_{est} m es t
用该 pose 投影 mesh,取得前景和 vertex correspondence;
计算 normalized image / vertex features 的平均内积:
S c o n f i d e n c e = 1 γ ∑ i ∈ F G f i ⋅ C r , S_{confidence}=\frac{1}{\gamma}\sum_{i\in FG} f_i\cdot C_r, S co n f i d e n ce = γ 1 i ∈ F G ∑ f i ⋅ C r , 其中 γ \gamma γ L j o i n t \mathcal L_{joint} L j o in t
该筛选利用 3D render-and-compare 自一致性,比普通 softmax confidence 更贴近 pose matching。但 top-100 策略很可能偏向常见、无遮挡、与 synthetic 外观接近的视角,对真正困难 OOD 样本覆盖不足。
7.6 训练配置
backbone:ImageNet-pretrained ResNet50;
mesh:每类手工 / 规则设定 cuboid dimensions,使大部分对象区域被覆盖;
每类别训练约 1 小时;
hardware:2 × RTX Titan Xp;
framework:PyTorch + PyTorch3D rasterization;
few-shot pseudo labels:通用 baseline 采用 confidence threshold τ = 0.9 \tau=0.9 τ = 0.9
CC3D 无监督适配:每类选 top-100 self-consistent pseudo labels。
论文没有给出测试时每图 pose optimization 时间、初始化数量、迭代数、显存或完整训练总 GPU-hours。
8. 实验协议
8.1 PASCAL3D+
11,045 training images;
10,812 validation images;
12 个 man-made object categories;
带类别与 object pose annotations。
论文包含三种不同口径,不能混淆:
Table 1 few-shot:只用 6 个 vehicle categories(aeroplane、bicycle、boat、bus、car、motorbike),每类 7 / 20 / 50 labels;Table 2 full comparison:全 PASCAL3D+ 口径,对比 0%、10%、50% labels 与 fully supervised;Table 4 ablation:5 个类别(aeroplane、boat、car、motorbike、train),所以 full model 数字与 Table 2 不相同。
8.2 OOD-CV
OOD-CV 覆盖 PASCAL3D+ 的 10 类,并把单一 nuisance 分为:
context;
pose;
shape;
texture;
weather。
它能区分模型究竟对哪类 shift 脆弱,比只在一个混合域外集上给平均值更有诊断力。
8.3 Baselines
方法 表示 / 训练方式 与本文关系 Res50-General ResNet50 rotation classification 非 3D-aware 基线 StarMap category-agnostic keypoint + viewpoint fully supervised 对比 NeMo neural mesh render-and-compare CC3D 的主要基础方法 NVSM semi-supervised neural view synthesis / matching 7 / 20 / 50 labels 的强 few-shot baseline P3D-Diffusion + Res50 合成数据 + 普通分类器 隔离数据对非 3D-aware 模型的效果 P3D-Diffusion + NeMo 合成数据 + neural mesh 隔离 P3D 数据与 NMM 的效果 P3D-Diffusion + CC3D 合成数据 + 3D-aware domain adaptation 完整方法
9. 主结果(一):few-shot PASCAL3D+
Table 1 在 6 个 vehicle categories 上按每类 7 / 20 / 50 labels 报告:
方法 ACC 30° mean ACC 10° mean MedErr mean Res50-General 45.3 24.8 28.5° StarMap 40.0 10.1 41.3° NeMo 53.1 31.8 38.5° NVSM 60.4 33.6 30.1° P3D-Diffusion + NeMo 80.0 57.1 13.9° P3D-Diffusion + CC3D 81.1 58.6 13.6° NeMo full supervision 89.3 66.7 7.7°
更细地看,CC3D 在 7 / 20 / 50 labels 下:
ACC 30°:79.1 / 80.6 / 83.5;
ACC 10°:56.6 / 57.2 / 61.9;
MedErr:16.2° / 15.0° / 9.7°。
结论 :合成数据带来的提升远大于 CC3D 相对 P3D-NeMo 的边际提升。以 mean 为例,P3D-NeMo→CC3D 仅 +1.1 / +1.5 / -0.3°,而原 NeMo→P3D-NeMo 为 +26.9 / +25.3 / -24.6°(注意原 NeMo 的 MedErr mean 异常高于其 50-label 数字)。因此论文的两项贡献中,few-shot 表上首先被强力支持的是 P3D-Diffusion 数据 ,CC3D 再带来小而一致的附加收益。
10. 主结果(二):与全监督 PASCAL3D+ 比较
原论文 Table 2:无真实 pose labels 的 CC3D 与 10%、50% labels fine-tuning 结果。全监督 baselines 使用完整真实标注集;CC3D 各版本还使用 synthetic data 和 unlabeled real images,所以应解释为“减少人工 rotation annotations”,而非“只用 10% 总训练数据”。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
方法 真实 pose label 比例 ACC 30° ACC 10° MedErr Res50-General 100% 88.1 44.6 11.7° StarMap 100% 89.4 59.5 9.0° NeMo 100% 86.1 61.0 8.8° P3D + Res50 0% 53.5 13.2 26.7° P3D + NeMo 0% 71.8 39.5 17.6° P3D + CC3D 0% 76.3 41.4 15.5° P3D + CC3D 10% 86.7 62.4 8.4° P3D + CC3D 50% 90.7 71.4 6.9°
10.1 无真实标签
CC3D 相对 P3D-NeMo:
ACC 30°:71.8→76.3,+4.5 points;
ACC 10°:39.5→41.4,+1.9 points;
MedErr:17.6°→15.5°,降低 2.1°。
这直接验证 cross-domain 3D consistency 的作用,但与全监督 StarMap / NeMo 仍有明显差距,尤其 10° accuracy 相差约 18–20 points。
10.2 10% 真实标签
ACC 30° 86.7,接近全监督范围 86.1–89.4;
ACC 10° 62.4,高于全监督 NeMo 61.0 与 StarMap 59.5;
MedErr 8.4°,略优于 NeMo 8.8°。
所以“10% labels 可匹配 fully supervised”基本成立,但 ACC 30° 仍低于 StarMap 2.7 points;不能写成三项指标全面超过全部全监督方法。
10.3 50% 真实标签
90.7 / 71.4 / 6.9 全部优于表中三种 fully supervised baselines。相对每列最佳 baseline:
ACC 30°:90.7 vs 89.4,+1.3;
ACC 10°:71.4 vs 61.0,+10.4;
MedErr:6.9° vs 8.8°,降低 1.9°。
收益在严格 10° 阈值最明显,说明 synthetic + CC3D 不只改善粗粒度方向分类。
11. 主结果(三):OOD-CV
原论文 Table 3:按 context、pose、shape、texture、weather 五种 nuisance 分别给出 30° / 10° accuracy。CC3D 在无真实标签时比 P3D-NeMo 的 mean 更高;加入 10% 标签后,P3D-NeMo 的 30° mean 为 55.2、CC3D 为 54.9,而 CC3D 的 10° mean 为 27.3、P3D-NeMo 为 26.3,体现不同阈值下并非单调全面领先。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
11.1 Mean 结果
方法 真实 pose labels ACC 30° mean ACC 10° mean Res50-General full supervision 46.9 14.3 NeMo full supervision 51.6 24.5 P3D + Res50 0% 33.5 6.3 P3D + NeMo 0% 42.6 12.7 P3D + CC3D 0% 48.2 14.8 P3D + NeMo 10% 55.2 26.3 P3D + CC3D 10% 54.9 27.3
无真实标签时,CC3D 相对 P3D-NeMo 提升 +5.6 / +2.1 points,表明 vertex-level adaptation 对 OOD 有明显收益。加 10% labels 后两者接近:CC3D 在严格 10° threshold 更好,NeMo 在 30° mean 略高 0.3。
11.2 各 nuisance 的细节
Context :CC3D + 10% 的 62.5 / 26.5,是其最强 OOD 条目;与随机背景设计高度相关。Pose :42.8 / 12.9;严格阈值仍低,极端视角外推困难。Shape :61.8 / 30.5;category-level neural mesh 对实例形变有一定韧性。Texture :60.7 / 35.4;加标签后提升大,但无标签 CC3D 的 51.0 / 16.6 仍明显低于全监督 NeMo 的 62.1 / 39.1。Weather :55.2 / 33.5;无标签时 44.5 / 16.3,论文指出 synthetic textures 对 weather / texture 现实性仍不足。
11.3 不能过度概括的地方
full-supervised NeMo 的 30° mean 51.6 高于无标签 CC3D 48.2;
full-supervised NeMo 的 10° mean 24.5 远高于无标签 CC3D 14.8;
+10% CC3D 并非每列最高,shape 30° 与 weather 30° 均略低于 P3D-NeMo +10%;
“close the gap” 比 “全面达到 / 超过全监督”更准确。
12. 消融实验
12.1 Style transfer 与 UDA
Table 4 在 PASCAL3D+ 的 5 类子集上报告:
设置 ACC 30° ACC 10° MedErr full model 79.2 52.0 14.1° 去掉 style transfer 75.9 47.8 17.1° 去掉 unsupervised adaptation 76.5 49.0 16.0° 两者都去掉 70.6 46.5 23.6°
结论:
style transfer 独立贡献约 +3.3 / +4.2 / -3.0°;
UDA 独立贡献约 +2.7 / +3.0 / -1.9°;
同时存在的提升大于任一单独模块,数据现实感与域对齐互补。
注意 Table 4 的 full model 79.2 / 52.0 / 14.1 与 Table 2 的 76.3 / 41.4 / 15.5 不同,是因为类别子集不同,不能直接当复现实验误差。
12.2 OOD-aware 背景
Table 5 比较类别无关随机背景与类别相关 P3D-Diffusion-Spurious:
数据集 数据版本 ACC 30° ACC 10° MedErr PASCAL3D+ random background 76.3 41.4 15.5° PASCAL3D+ spurious background 77.0 42.8 14.8° OOD-CV random background 48.2 14.8 37.0° OOD-CV spurious background 42.7 16.4 45.7°
解释:
典型背景在域内略有帮助,符合 shortcut learning;
随机背景在 OOD-CV 的 ACC 30° 提高 5.5 points、MedErr 降低 8.7°;
但 OOD ACC 10° 反而从 16.4 降至 14.8,说明收益主要体现在减少大角度错误,而不是提高最严格阈值的精确率;
因此“much better OOD robustness”在 30° 与 median error 上成立,但不是所有指标一致改善。
12.3 缺失的关键消融
正文没有单独报告:
edge conditioning vs 无 edge 的 label drift;
DTD prior noise 与 color prompt 各自的下游增益;
生成图过滤 / 不过滤的影响;
背景数量从 10→100→1,000 的 scaling;
top-100 pseudo labels 与 threshold / curriculum 的比较;
CC3D 中只对齐 high-confidence vertices 的效果;
test-time pose optimization 的初始化与迭代数。
13. 鲁棒性与失败案例
13.1 对遮挡和杂乱
PASCAL3D+ 包含自然图像,但论文没有按 occlusion ratio、truncation 或 clutter 单独分组。Neural mesh 投影需要足够前景 feature 与 vertex 对应;严重遮挡可能同时降低 pseudo-pose 与 confidence score,导致困难样本根本不进入 top-100 自训练集。
13.2 对无纹理 / 弱纹理
方法有 3D geometry prior,但 neural vertex features 仍来自 RGB。生成多样性依赖人为纹理,可能让模型习惯丰富局部外观,反而未必适合真实纯色工业对象。论文的 texture-shift 结果也显示严格 10° accuracy 仍有较大差距。
13.3 对反光 / 透明对象
未覆盖。条件扩散可生成 specular-looking texture,但这不等于准确模拟 view-dependent reflection、transmission 与真实传感器成像;标签保持假设在透明 / 镜面对象上更危险。
13.4 对称性与类别标注歧义
论文直接比较单个 GT rotation matrix,没有 BOP-style symmetry equivalence。对于外观 / 几何对称对象,两个等价视觉姿态可能被算作大角度错误;另一方面,训练标签也可能以数据集 canonical convention 强行区分不可观测方向。
13.5 生成错误
可能出现:
edge-conditioned image 增删局部结构;
轮廓遵守但部件语义错位;
DTD texture edges 被误解释为真实物体部件;
foreground / background compositing 边缘泄漏;
随机背景产生不合理尺度、接触与透视;
prompt color 使类别外观分布偏离真实世界。
论文没有提供自动 quality filter 或失败率。
14. 贡献是否被实验支撑
作者声称 对应证据 充分程度 我的判断 P3D-Diffusion 缩小 synthetic-to-real gap Table 1、2 中 P3D-NeMo vs NeMo / P3D-Res50 较充分 下游增益大,但 style realism 与 label fidelity 缺少直接量化 CC3D 优于普通 synthetic transfer Table 1–3,P3D-NeMo vs P3D-CC3D 充分 域内与 OOD 均有一致附加收益,无标签 OOD 尤其明显 10% labels 接近全监督 Table 2 充分但需限定 30° 低于最佳 baseline,10° / MedErr 略优;额外使用大量合成和无标签数据 50% labels 超过全监督 Table 2 充分 三项均优于表中 baselines,10° 增益最大 OOD-aware 背景打破 spurious correlation Table 5 部分充分 ACC 30° / MedErr 明显改善,但 ACC 10° 下降,只有一组背景策略 生成图保留准确 3D 标签 edge design、Figure 1/2、下游效果 证据不足 没有直接的 label-drift / geometry-consistency 测量
15. 批判性分析
15.1 优点
任务分解清晰 :renderer 管 pose,diffusion 管 appearance,CC3D 管 domain correspondence,背景随机化管 shortcut。3D-aware adaptation :不是盲目对齐全局分布,而是借 mesh vertex identity 对齐同一三维位置的 features。标注效率证据强 :10% / 50% labels 的结果对人工 rotation annotation 成本有现实意义。OOD 不是口号 :使用 OOD-CV 并按五类 nuisance 拆开,能看到 context、texture、weather 的不同表现。对比层次合理 :Res50、NeMo、CC3D 让普通 2D backbone、3D-aware backbone、3D-aware UDA 的贡献可区分。
15.2 缺点
不是完整 6D pose :没有 translation / scale,和机器人操作主流实例级协议距离较大。标签保持是未充分验证的中心假设 :扩散模型可能在遵守 edges 的同时改变三维语义。总资源成本未报告 :每类 7,000 diffusion images 的生成成本、存储、筛选时间没有纳入“data efficiency”。推理效率未知 :gradient-based render-and-compare 可能慢且依赖初始化。Pseudo-label selection bias :每类 top-100 容易只覆盖易样本与常见视角。数据覆盖窄 :100 背景、PASCAL3D+ CAD 与人造类别不足以证明开放类别或工业对象泛化。统计不完整 :未给多 seed variance,10% / 50% 子集只说明先 shuffle 后随机选一次。
15.3 隐含假设
edge map 是 pose-preserving sufficient condition;
category cuboid mesh 上的 vertex identities 对不同实例仍有语义一致性;
pseudo-pose 错误不会通过 L d o m a i n \mathcal L_{domain} L d o main
random background 不会引入更强的 compositing artifact shortcut;
合成材质多样性覆盖真实 texture / weather 的主要变化;
PASCAL3D+ 的单一 canonical rotation label 足以描述对称类别。
15.4 真实应用可行性
对车辆、家具等类别级粗 / 中等精度 orientation 估计,尤其当真实 pose labels 昂贵而 CAD 资源丰富时,方法很有吸引力。若用于机器人抓取,需要至少补齐:
3D translation 与 metric scale;
instance mask / detector 错误鲁棒性;
symmetry-aware 评价与多模态输出;
遮挡 / clutter;
推理延迟;
RGB-D 或多视角几何约束;
透明 / 反光与工业弱纹理对象测试。
16. 复现指南
16.1 最小数据侧复现
选择 PASCAL3D+ 的 1–2 个类别和官方 CAD models。
在 Blender 中均匀 / 按论文分布采样 S O ( 3 ) SO(3) S O ( 3 )
随机贴 DTD textures,渲染 RGB、silhouette、depth、normal 与 Canny edges。
使用与论文一致的 ControlNet checkpoint、sampling steps、seed、prompt template 生成对象图。
与 category-independent backgrounds 合成。
人工抽样并用 silhouette IoU、edge alignment、关键点重投影误差检查 pose-label drift。
16.2 最小模型侧复现
复现 NeMo / NMM 在真实标注数据上的基线。
用 P3D synthetic labels 训练 ResNet50 feature extractor 与 cuboid neural mesh。
对真实无标签图做 multi-start pose optimization。
计算 S c o n f i d e n c e S_{confidence} S co n f i d e n ce
加入 L d o m a i n \mathcal L_{domain} L d o main L c o n \mathcal L_{con} L co n L r e c \mathcal L_{rec} L r ec
在 PASCAL3D+ 0% / 10% / 50% 和 OOD-CV 五 nuisance 上复测。
16.3 必须记录的复现信息
ControlNet / base diffusion checkpoint 与 license;
image resolution、steps、scheduler、guidance scale、negative prompt;
每类生成成功率、过滤率、GPU-hours;
rotation sampling distribution;
CAD texture UV 与 DTD mapping;
crop、mask、detector 与 background compositing 方法;
neural mesh vertex count、dimensions、pose initialization、iterations;
top-100 中各 viewpoint / nuisance 的分布;
3–5 seeds 的 mean ± std。
17. 可改进方向
17.1 显式几何保真约束
仅用 Canny edges 仍可能发生结构漂移。可加入:
rendered depth / normal ControlNet;
silhouette + keypoint multi-condition guidance;
diffusion feature 与 render correspondence loss;
生成后用 pose estimator / differentiable renderer 反检验;
label-confidence score,并在训练中按几何保真度加权。
17.2 从 rotation 扩展到完整 6D pose
renderer 同时保留 metric intrinsics、translation 与 object scale;
预测 category-level NOCS / dense coordinates;
RGB-D 时通过 depth alignment 求 scale + translation;
设计 symmetry-aware S E ( 3 ) SE(3) S E ( 3 )
在 REAL275、CAMERA、HouseCat6D、Omni6DPose 等协议上验证。
17.3 更强的背景与物理一致性
随机粘贴能打破 shortcut,却可能产生新的“不真实合成边缘”捷径。可使用:
scene-aware placement;
contact shadow 与 lighting harmonization;
camera / depth-of-field / motion-blur simulation;
大规模 licensed scene backgrounds;
object–context intervention,同时保留合理物理关系。
17.4 不确定性驱动的 self-training
top-100 hard selection 可替换为:
pose posterior entropy;
multi-start agreement;
mesh-vertex visibility / feature covariance;
teacher–student temporal ensemble;
curriculum:从易视角扩展到稀有 / OOD 视角;
class-balanced、viewpoint-balanced pseudo-label sampling。
17.5 Foundation features
可将 ImageNet ResNet50 features 替换 / 融合为 DINOv2 等 dense foundation features,再研究:
vertex correspondence 是否跨域更稳定;
是否减少 diffusion realism 的需求;
是否能从类别 cuboid 扩展到真实 CAD surface;
在 few-shot 与 unseen-category 上是否仍有效。
18. 对研究工作的启发
可直接借鉴的思想
生成模型只改外观,几何工具保标签 :先确定可审计的条件边界,再调用 diffusion。用 3D identity 做跨域锚点 :vertex correspondence 比全局 feature alignment 更贴近 pose 任务。把背景当干预变量 :数据随机化不仅是增强,也可用于切断 spurious correlation。同时报告 ID 与 OOD :生成数据越多样,不应只在同分布 benchmark 上判断价值。
必须加入 baseline 的情形
category-level orientation + synthetic training;
few-shot 3D pose labels;
diffusion-enhanced rendering;
neural mesh / render-and-compare domain adaptation;
OOD-CV pose robustness。
可能形成的研究切入点
构建一个 geometry-audited diffusion data engine:以 silhouette、depth、normal 和 canonical correspondence 多条件控制生成,再通过 differentiable pose re-estimation 为每张合成图输出 label-confidence;与 foundation-feature neural mesh 联合训练,扩展到 category-level S E ( 3 ) SE(3) S E ( 3 )
19. 待解决问题
概念问题
category-level cuboid vertex 对不同实例是否真的表示同一局部语义?
随机背景改善 OOD 是减少 shortcut,还是只扩大低频统计范围?
diffusion realism 与 pose-label fidelity 的最优平衡在哪里?
公式问题
论文 L c o n \mathcal L_{con} L co n
α \alpha α confidence score 是否按可见顶点或全部前景像素加权?
实验问题
10% / 50% label subset 的多次随机采样方差是多少?
生成图的真实人工 pose re-annotation 误差是多少?
OOD Table 5 中 random background 为何使 10° accuracy 下降?
只增加 rendered texture randomization、不用 diffusion,能取得多少收益?
每类别 7,000 张是否已经饱和?
工程问题
每张图的 diffusion generation time 与总 GPU budget;
test-time pose optimization latency 和 multi-start 数量;
代码是否完整提供数据生成、CC3D 与全部 benchmark 配置;
100 张互联网背景的可再分发与版权状态。
20. 最终判断
作者声称
P3D-Diffusion 提供真实、多样且带准确 3D annotations 的 synthetic data;CC3D 利用 neural mesh geometry 建立跨域 feature consistency;两者组合在只用 10% 真实 labels 时接近全监督,在 50% 时超过表中全监督方法,并增强 OOD robustness。
我的分析
标注效率和 synthetic-to-real transfer 的核心结果有较强支持 :PASCAL3D+ 上 10% labels 达到 86.7 / 62.4 / 8.4°,50% labels 达到 90.7 / 71.4 / 6.9°;无标签 CC3D 相对 P3D-NeMo 也有明确增益。OOD 结论应更克制:CC3D +10% 的 10° mean 最好,但 30° mean 略低于 P3D-NeMo +10%,random backgrounds 对严格 10° accuracy 也不是正收益。
最需要补强的是 扩散生成后的姿态标签保真度 与 完整工程成本 。此外,本文只恢复 category-level rotation,不能直接当作 6D object pose 方法。作为“怎样让可控渲染、生成模型与 3D-aware adaptation 协同”的研究,它非常值得读;作为机器人完整 S E ( 3 ) SE(3) S E ( 3 )