论文精读笔记:Pose Anything Anywhere: Model-free Object Poses from Arbitrary References
1. 基本信息
简称 :PANY(Pose Anything Anywhere)作者 :Hongli Xu、Jiaqi Hu、Junwen Huang、Boyang Zhong、Peter KT Yu、Nassir Navab、Benjamin Busam、Slobodan Ilic机构 :Technical University of Munich、Munich Center for Machine Learning、Siemens AG、XYZ Robotics、ROBOX年份 / 会议 :ECCV 2026;当前全文证据来自 arXiv:2606.23634 v1论文 / PDF :arXiv / PDF 项目 / 代码 :Project / GitHub 阅读模式 :精读证据边界 :以下方法、数字和图表均按 2026-06-22 的公开预印本核验;ECCV camera-ready 若后续更新,应重新核对表格与展示类型。
2. 一句话定位
PANY 将“一个已规范定向 anchor + 若干无位姿 assist views + 一个 query”建模为对象中心多视图图:LoRA 适配 VGGT 预测点图,以几何—视觉融合描述子学习跨视图对应,再经 pose graph canonical registration 和 PnP / Umeyama 恢复未见对象 pose,重点解决大视角差、遮挡和低 query–anchor overlap。
2.1 论文图表导读
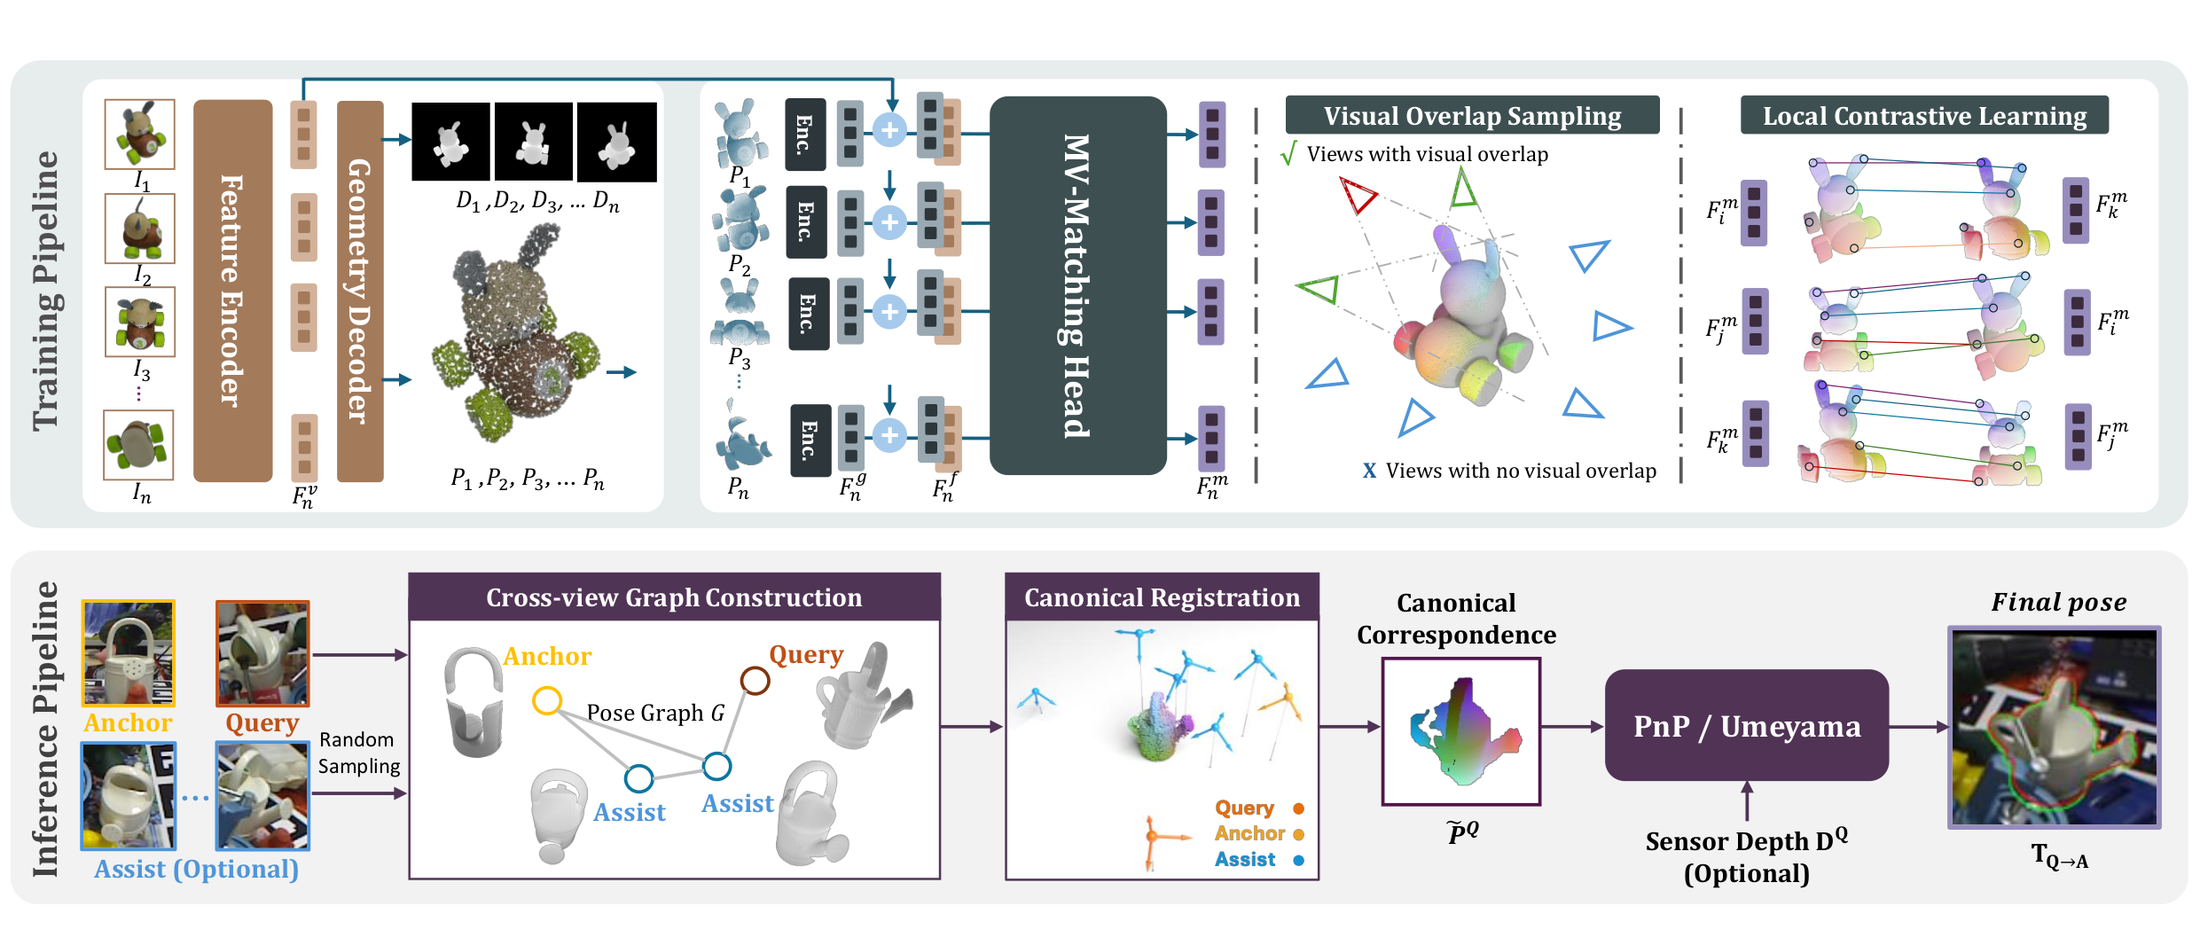
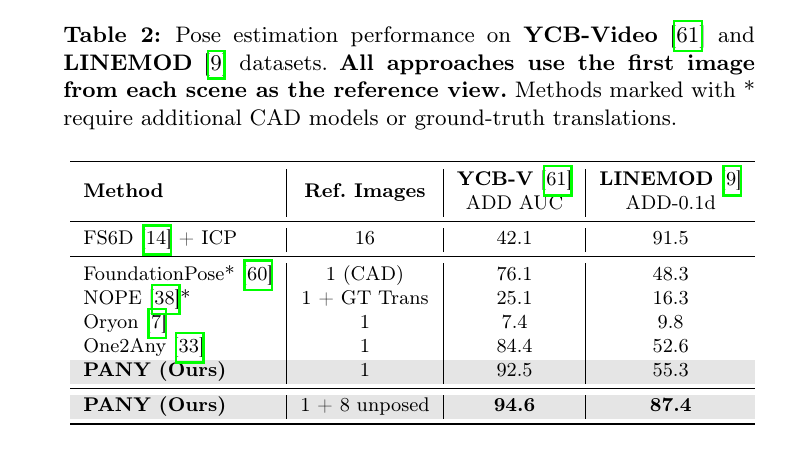
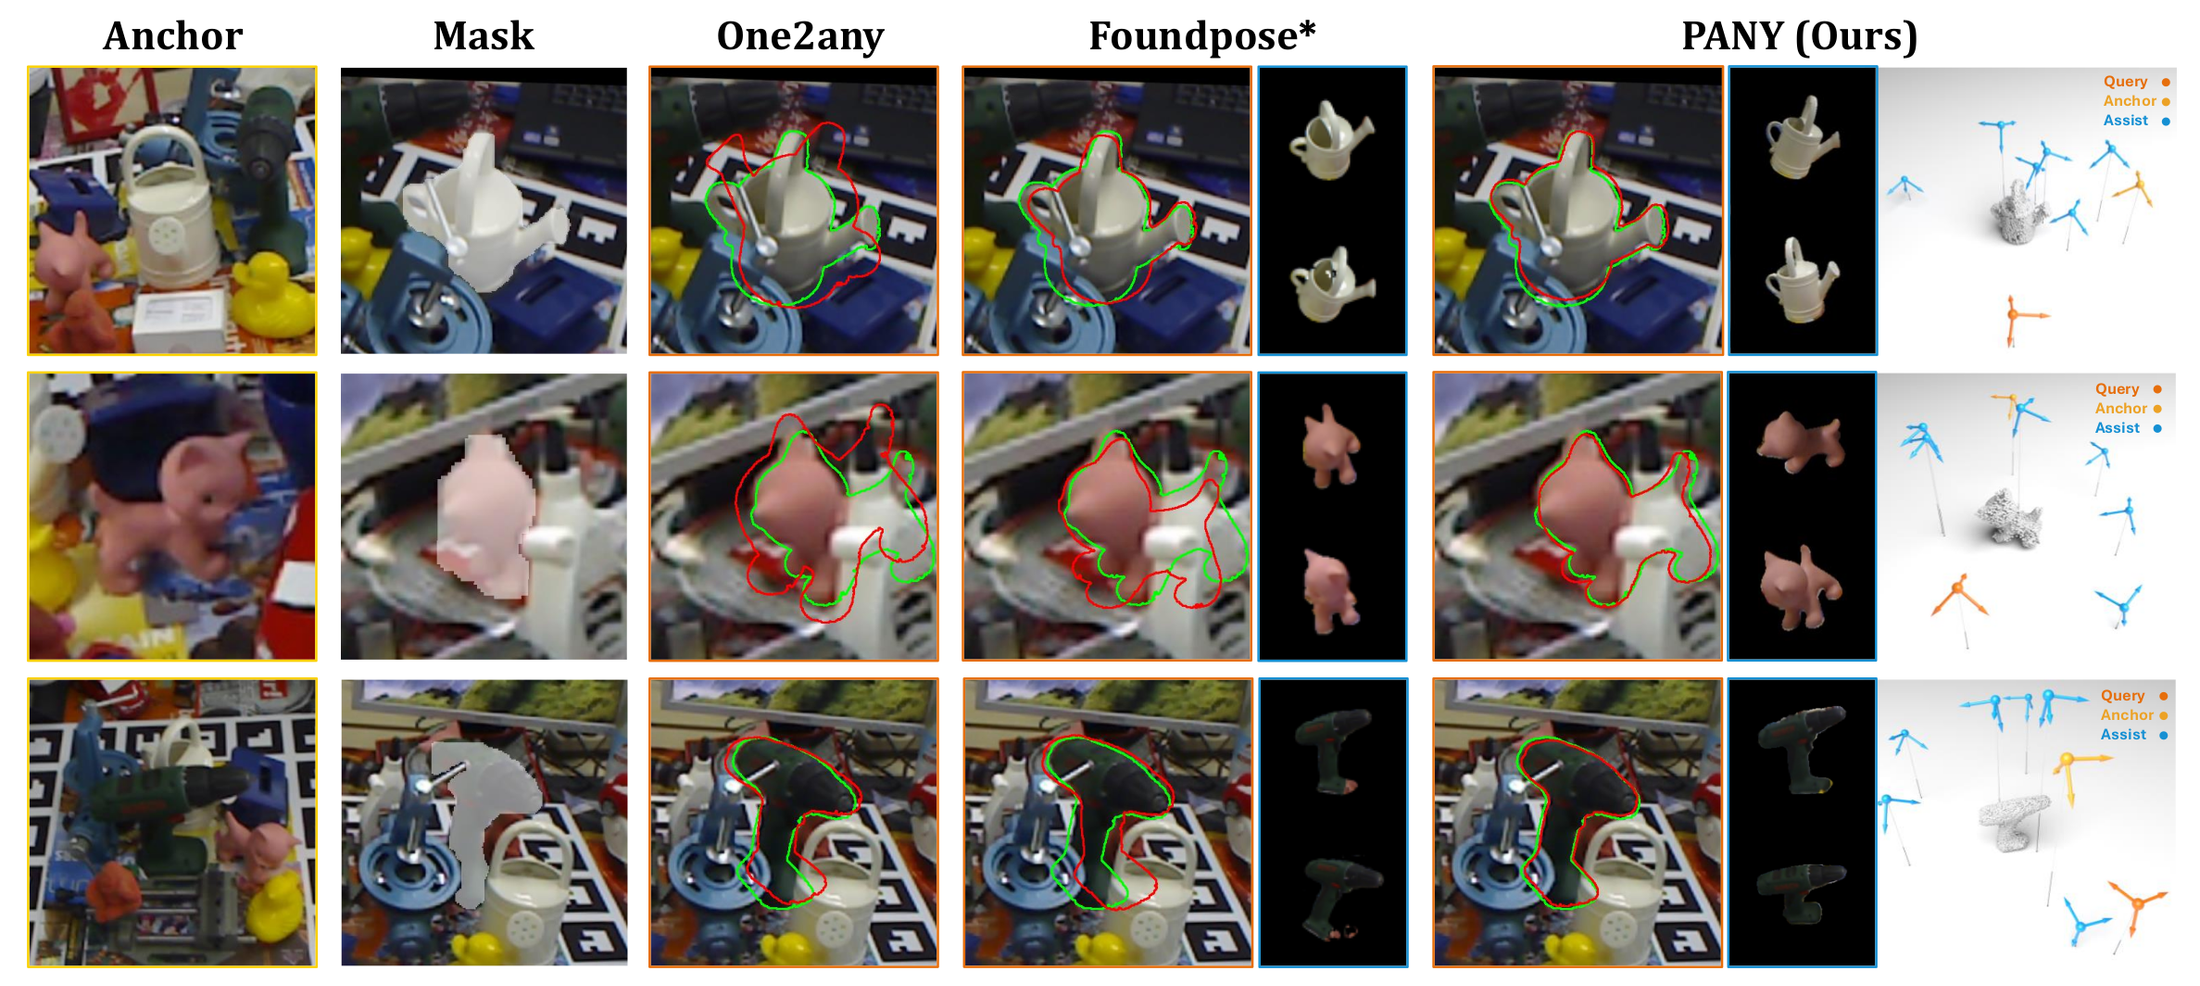
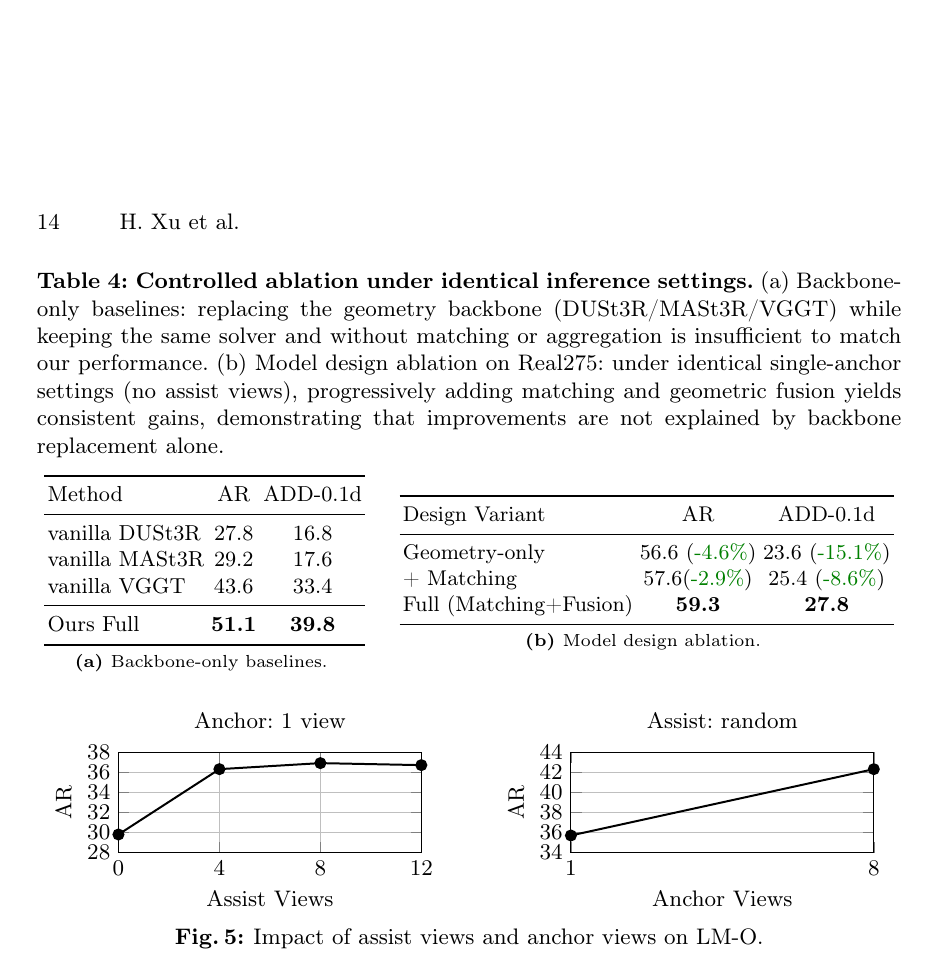
图表 证据作用 本站解读 Figure 2 完整训练 / 推理 pipeline 网络学局部几何与跨视图对应;显式几何图负责把无位姿辅助视图变成 canonical pose 约束。 Table 2 单参考与多参考主结果 assist views 对 LINEMOD 的增益远大于 YCB-V,符合“补足视角覆盖”动机。 Figure 4 LM-O 定性对比 PANY 的轮廓更贴近 GT,但这些样例不能替代全数据定量结果,也未展示失败样例。 Table 4 + Figure 5 backbone、matching、fusion 与视图数量消融 证明增益不是 VGGT 单独带来;4 个 assist 后边际收益明显下降。
3. 问题设定与任务边界
3.1 数学设定
输入集合为:
I = { I Q } ∪ { I A } ∪ { I i U } i = 1 M , N = M + 2. \mathcal I = \{I^Q\} \cup \{I^A\} \cup \{I_i^U\}_{i=1}^{M},\qquad N = M + 2. I = { I Q } ∪ { I A } ∪ { I i U } i = 1 M , N = M + 2.
I Q I^Q I Q I A I^A I A T A T_A T A I i U I_i^U I i U 输入可为 RGB 或 RGB-D。
系统先估计 query 到 anchor 的相对变换 T Q → A T_{Q\rightarrow A} T Q → A
T Q = T A T Q → A − 1 . T_Q = T_A T_{Q\rightarrow A}^{-1}. T Q = T A T Q → A − 1 . 因此,PANY 输出的“绝对 6D pose”并不是脱离参考坐标系的绝对量,而是由 anchor 的 canonical frame 定义。
3.2 训练与推理输入
阶段 输入 监督 / 依赖 输出 训练 3–9 个对象中心 RGB-D 视图 GT depth、GT point maps、跨视图 3D correspondence;Omni6DPose 合成 CAD 数据 稠密几何预测器与跨视图 matching descriptors 推理(RGB) anchor + query + 可选 assist RGB、object masks、camera intrinsics anchor canonical pose;不需 assist poses 3D–2D correspondence + PnP 得 query pose 推理(RGB-D) 上述图像和 sensor depth anchor canonical pose、深度、mask canonical point clouds + Kabsch–Umeyama 得 query pose
3.3 “model-free / pose-free”究竟免除了什么
确实免除 :目标 CAD、目标专属训练、密集 posed-view reconstruction、assist-view pose 标注。没有免除 :一个 canonical anchor、对象实例 mask、相机内参,以及足够的跨视图可匹配区域。需要谨慎的表述 :论文标题的 arbitrary references 指参考视角可稀疏、无序,assist views 可无位姿;不是所有参考都没有坐标定义。
3.4 与 baseline 的 setting 是否完全一致
REAL275 / Toyota-Light 按 Oryon 协议,使用 2,000 个 query–reference pairs,并假设 GT masks。
YCB-V / LINEMOD 按 One2Any 协议,以每段序列首帧为 anchor,同样使用 GT masks。
LM-O 使用 CNOS masks,比 GT mask 更接近实际,但不同方法的 reference 数量和先验不完全一致:model-based 方法拥有 CAD / 大量 posed templates,PANY 使用 1 个 posed anchor 和可选 8 个 unposed assists。
因此,表格能说明各 operational regime 的竞争力,但不能把所有数字解释为严格同输入成本的单一排行榜。
4. 研究脉络
4.1 三条前序路线
路线 代表工作 新对象代价 典型瓶颈 CAD / template model-based MegaPose、FoundationPose、FoundPose、GigaPose CAD、渲染模板或模型库 资产获取、外观 / 几何域差异 reconstruction-first OnePose、NeRF / 3DGS onboarding、OnePoseViaGen 多视图采集、SfM / 神经重建或生成 3D 慢,且生成几何可能 hallucinate pairwise model-free Oryon、One2Any、SingRef6D 单参考,通常无需 CAD 大视角差与遮挡导致重叠不足、对应不稳定
PANY 并非完全摆脱几何基础模型,而是把 VGGT 从 scene-centric camera / depth prediction 适配为 object-centric canonical alignment。它与 One2Any 最直接的差异是:One2Any 主要对单个 reference–query pair 推断 reference object coordinates;PANY 在多个稀疏视图间联合建图,让 assist views 充当 query 与 anchor 之间的中继。
4.2 与 reconstruction-first 的差异
PANY 也会预测 point maps,并把点云注册进 canonical frame,看起来像“重建”。但它不要求先得到完整、可渲染的对象模型再执行 pose estimation;预测的局部几何只承担 correspondence 与 alignment 载体。更准确的说法是 alignment-oriented transient geometry ,而不是 persistent object reconstruction。
5. 研究动机
单参考的根本问题不是网络不够大,而是信息可能不存在:如果 anchor 只看到杯子正面,query 只看到背面,两张图的物理可见表面几乎不重叠,任何直接匹配都面对不可辨识性。额外 assist views 只要覆盖中间角度,就能把一条不可靠的宽基线边拆成多条可靠的短基线边。
作者的核心思路由此分成两层:
学习层 :让点图与描述子跨视图保持对象中心一致,而不是保留强 view dependency;几何层 :只在有效对应足够时连边,再用 pose graph 传播到 anchor canonical frame。
这比“把更多图像 token 丢给 Transformer 后直接回归 pose”更有结构,也更容易诊断失败来自 geometry、matching 还是 graph connectivity。
6. 方法详解
原论文 Figure 2。训练时,DINOv2 / VGGT 风格骨干输出 depth 和 point maps,几何与视觉特征进入 MV-matching head,以局部对比监督跨视图对应;推理时,anchor、query 与 assist views 先构建跨视图图,再做 canonical registration,最终走 PnP 或 Umeyama。来源:arXiv:2606.23634 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.1 多视图几何骨干
每个图像先 patchify,经 DINOv2 encoder 得 token。Transformer 交替执行:
每帧内部的 frame-wise intra-attention;
所有视图之间的 global cross-attention。
DPT-based heads 对每个视图输出 depth D ^ i \hat D_i D ^ i P ^ i \hat P_i P ^ i
f : { I i } i = 1 N → { ( D ^ i , P ^ i ) } i = 1 N . f:\{I_i\}_{i=1}^{N}\rightarrow\{(\hat D_i,\hat P_i)\}_{i=1}^{N}. f : { I i } i = 1 N → {( D ^ i , P ^ i ) } i = 1 N . 这里的重点不是单视图深度精度本身,而是不同视图的点图能否进入一个足够一致的几何表示,支撑后续 canonical alignment。
6.2 几何—视觉融合 matching head
仅有 point maps 不够:foundation geometry model 的视觉特征仍可能随视角漂移。PANY 并行构造:
geometric encoder:以 rotation-invariant positional embedding 从 P ^ i \hat P_i P ^ i F i g F_i^g F i g
visual branch:从 backbone 取 F i v F_i^v F i v P ^ i \hat P_i P ^ i
fusion:得到 F i f F_i^f F i f
geometric Transformer:交替 sparse geometric attention 与 dense linear attention,输出 F i m F_i^m F i m
写成:
F i m = T match ( F i f , P ^ i ) . F_i^m=\mathcal T_{\text{match}}(F_i^f,\hat P_i). F i m = T match ( F i f , P ^ i ) . 它的设计意图是把“看起来相似”与“局部几何相容”同时编码,降低纹理弱、外观变化和宽基线下的误匹配。
6.3 Local contrastive correspondence supervision
对有效视图对 ( i , j ) (i,j) ( i , j )
A i j = F i m ( F j m ) ⊤ . A_{ij}=F_i^m(F_j^m)^\top. A ij = F i m ( F j m ) ⊤ . 以共享坐标系内的点距离构造最近邻 GT correspondence;距离超过阈值 δ d i s \delta_{dis} δ d i s
L i j = C E ( A i j , Y ^ i ) + C E ( A i j ⊤ , Y ^ j ) , \mathcal L_{ij}=\mathrm{CE}(A_{ij},\hat Y_i)+\mathrm{CE}(A_{ij}^{\top},\hat Y_j), L ij = CE ( A ij , Y ^ i ) + CE ( A ij ⊤ , Y ^ j ) , 并在所有有效边集合 E \mathcal E E
6.4 联合训练目标
L = λ d L d e p t h + λ p L p o i n t + λ m L m a t c h , \mathcal L=\lambda_d\mathcal L_{depth}+\lambda_p\mathcal L_{point}+\lambda_m\mathcal L_{match}, L = λ d L d e pt h + λ p L p o in t + λ m L ma t c h , 其中 λ d = 1 \lambda_d=1 λ d = 1 λ p = 1 \lambda_p=1 λ p = 1 λ m = 0.05 \lambda_m=0.05 λ m = 0.05
6.5 Cross-view pose graph
对每个视图对,从 2048 个样本中统计有效 3D correspondences;若超过 η = 500 \eta=500 η = 500 T i ← j T_{i\leftarrow j} T i ← j
对任意节点 i i i π ( i , A ) \pi(i,A) π ( i , A )
T i → A = ∏ ( k , l ) ∈ π ( i , A ) T k ← l , T_{i\rightarrow A}=\prod_{(k,l)\in\pi(i,A)}T_{k\leftarrow l}, T i → A = ( k , l ) ∈ π ( i , A ) ∏ T k ← l , 再把点图注册为 P ~ i = T i → A P ^ i \tilde P_i=T_{i\rightarrow A}\hat P_i P ~ i = T i → A P ^ i
6.6 最终 pose solver
有 sensor depth :query 与 canonical points 做 Kabsch–Umeyama,直接估 similarity / rigid alignment。RGB-only :从预测 canonical 3D 与 query 2D 得 correspondence,使用 PnP。
这两条路径的比较不是严格同信息量:RGB-D 直接获得度量深度,精度显著更高是合理现象,不应只归因于网络结构。
6.7 模块输入输出表
模块 输入 输出 作用 失败信号 Multi-view backbone 多视图 RGB depth / point maps、visual tokens 提供局部几何与跨视图上下文 点图尺度 / 朝向漂移 Geometric encoder + fusion point maps + visual tokens 3D-aligned fused tokens 抑制纯视觉的 view dependency 弱纹理或几何退化 MV-matching head fused tokens + 3D coordinates rotation-invariant descriptors / correspondences 宽基线匹配 对应数量低、错误边多 Pose graph pairwise correspondences 各视图到 anchor 的 canonical transforms 用 assist views 补连通性 图断开或误差累积 PnP / Umeyama canonical correspondences + intrinsics / depth query 6D pose 最终几何求解 PnP 退化、深度噪声、对称多解
7. 训练方式与工程复杂度
7.1 训练数据与采样
Omni6DPose:超过 5,000 个 CAD objects、149 categories;
生成超过 200 万张 object-centric RGB-D images;
每个训练样本含一个 query 和 2–8 个 references,总视图数 3–9;
至少两个 positive reference views;可见重叠 / pose 差阈值在正文中记为 θ O F P = 10 ∘ \theta_{OFP}=10^\circ θ O F P = 1 0 ∘
7.2 优化配置
图像 crop / resize 到 518×518;
VGGT backbone 冻结主体,LoRA rank 8、alpha 32;
matching head 从头训练;
AdamW,learning rate 10 − 4 10^{-4} 1 0 − 4
15 epochs,每个 epoch 500 iterations,batch size 16;
2× NVIDIA A100,约 36 小时。
7.3 推理成本
Table 3 给出的单参考 / 多参考时间是 0.19 s / 0.75 s。论文未把 detector / segmentation、图像 crop、CNOS mask、数据搬运分别计时,因此它更适合比较 PANY 内部参考数量的相对成本,而不能直接作为完整机器人 perception stack 的端到端延迟。
7.4 复现难点
必须正确复现 object crop、mask 和 canonical anchor pose 约定;
point map 的坐标系、尺度和 similarity transform 方向很容易写反;
pose graph 的连边阈值、RANSAC inlier、路径选择对极端视角样本敏感;
RGB 与 RGB-D 使用不同 solver,评测脚本需防止把两种输入条件混为一谈;
对称对象的 GT correspondence 与 metric symmetry protocol 必须对齐 BOP;
公开代码虽已链接,仍需检查模型权重、训练脚本和完整数据预处理是否同时可用。
8. 实验分析
8.1 数据集
数据集 主要难点 使用方式 REAL275 类别级真实对象、domain gap 2,000 个 query–reference pairs,GT masks;RGB / RGB-D 单参考 Toyota-Light 弱纹理 / 光照与对象变化 同 Oryon pairing protocol,GT masks YCB-Video 遮挡、杂乱、多对象 每场景首帧为 anchor,GT masks LINEMOD 近 360° 视角、无纹理 / 不规则对象 首帧 anchor;单参考与 8 assist 对比 LM-O 严重遮挡、大视角差 CNOS masks;1 anchor + 可选 8 unposed assists
训练只使用合成 Omni6DPose,以上真实测试集均作为 unseen-object / unseen-domain 验证。
8.2 评价指标
ADD-0.1d :平均模型点距离小于物体直径 10% 的成功率;对称对象若协议采用 ADD-S / BOP symmetry 需结合原评测脚本理解。ADD AUC :ADD(-S) 阈值曲线下面积,YCB-V 常用。BOP AR :聚合 VSD、MSSD、MSPD 多阈值 recall;比单一 ADD 更关注对称性和可见表面,但仍依赖 mask / detection protocol。
论文用这些指标覆盖姿态精度,但没有端到端检测 AP、机器人抓取成功率或 reference acquisition 时间;“实际可用”仍主要由 benchmark 间接支持。
8.3 主结果:单参考与多参考
原论文 Table 2。PANY 单参考在 YCB-V / LINEMOD 为 92.5 ADD AUC / 55.3 ADD-0.1d;加入 8 个无位姿 assist views 后为 94.6 / 87.4。大视角覆盖更困难的 LINEMOD 获益显著,支持 assist views 作为几何中继的动机。来源:arXiv:2606.23634 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
设置 PANY 关键 baseline 绝对差值 解释 REAL275 RGB,AR 59.3 SingRef6D 28.7 +30.6 RGB-only 的对象中心几何迁移有效 REAL275 RGB-D,AR 81.8 One2Any 54.9 +26.9 深度 + 3D alignment 优势明显 YCB-V 单参考,ADD AUC 92.5 One2Any 84.4 +8.1 遮挡下单参考仍有提升 YCB-V 1+8 views,ADD AUC 94.6 One2Any 84.4 +10.2 已接近饱和,额外视图增益有限 LINEMOD 单参考,ADD-0.1d 55.3 One2Any 52.6 +2.7 单参考下提升较小 LINEMOD 1+8 views,ADD-0.1d 87.4 One2Any 52.6 +34.8 多视图覆盖是决定因素 LM-O 单参考,AR 36.9 One2Any 18.2 +18.7 CNOS mask 下仍有明显收益 LM-O 1+8 views,AR 42.3 RayPose 8 posed refs 42.1 +0.2 用 1 posed + 8 unposed 达到相近水平
需要强调两点:
摘要写“YCB-V +12%、LM-O >+20%”,但精读更应报告比较对象和绝对数;上表按原表重算,避免把相对百分比与百分点混写。
Toyota-Light RGB-only 的 ADD-0.1d 为 10.8,低于 SingRef6D 的 13.1;因此“所有指标均超过 baseline”并不被 Table 1 完全支持。
8.4 定性结果
原论文 Figure 4:LM-O 上 One2Any、FoundPose 与 PANY 的定性对比。绿色 / 红色轮廓分别表示 GT / prediction;右侧小图显示 PANY 的 query、anchor 与 assist 相机关系。PANY 在这些大视角样例中的轮廓更贴近 GT,但论文没有在该图中展示极端遮挡或对称失败样例。来源:arXiv:2606.23634 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
这张图真正有价值的部分不是“PANY 看起来更准”,而是右侧的 view graph:assist cameras 填补了 anchor 与 query 的视角空洞。它把方法动机可视化了。但样例由作者选择,不能据此判断总体失败率。
8.5 消融实验
原论文 Table 4 与 Figure 5。左:仅替换 DUSt3R / MASt3R / VGGT backbone 不能达到完整模型;右:在同一单参考设置下,从 geometry-only 到 matching,再到 matching + geometric fusion,Real275 ADD-0.1d 从 23.6 → 25.4 → 27.8。下:assist views 从 0 增至 4 带来最大提升,之后趋于饱和。来源:arXiv:2606.23634 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
消融 AR ADD-0.1d 证明的主张 判断 Geometry-only 56.6 23.6 点图直接对齐不足 支持 + Matching 57.6 25.4 学习跨视图 correspondence 有独立收益 支持,但 AR 增益仅 +1.0 + Matching + Fusion 59.3 27.8 几何—视觉融合继续改善 支持 vanilla VGGT 43.6 33.4 强 backbone 本身不能解释完整性能 与完整模型 51.1 / 39.8 的对比支持
视图数量实验显示:LM-O AR 从 0 assist 的约 30 上升到 4 assist 的约 36,8–12 views 约 37,明显存在边际收益递减。默认 8 views 是精度与稳定性折中,不是越多越好。
8.6 鲁棒性与失败案例
遮挡 :YCB-V、LM-O 支持对中重度遮挡的鲁棒性;论文明确承认 extreme occlusion 仍会失败。低纹理 :LINEMOD 与定性样例支持一定能力,几何特征融合是主要机制。大视角差 :这是最有力的实验主张;assist-view 增益与图结构可解释性相互印证。对称对象 :作者明确列为 limitation;当前方法没有显式多假设概率表示,几何 cue 不足时方向不可辨。mask 噪声 :除 LM-O 的 CNOS 外,大量实验使用 GT masks,鲁棒性证据不充分。深度噪声 :RGB-D 提升显著,但没有系统的深度 dropout / 噪声消融。pose graph 断连 :有效 correspondence 少于阈值时无法连边;论文未单列断连率和 fallback 策略。
8.7 贡献是否被实验支撑
作者声称 对应证据 是否充分 本站判断 单 / 稀疏参考、RGB / RGB-D 的统一框架 五个数据集、多种输入协议 基本充分 设定覆盖广,但 solver 不同,不能视为完全同模型同信息量 assist views 缓解低重叠 Table 2、Table 3、Figure 5 充分 LINEMOD / LM-O 增益与视图数量消融一致 matching / fusion 不是 backbone 替换 Table 4 基本充分 有 controlled ablation,但缺 matching precision / graph quality 中间指标 对真实世界有强泛化 五个真实 test benchmarks 较强 仍假设 mask,未做完整机器人闭环 所有指标优于 alternatives Table 1 不完全 Toyota-Light RGB ADD-0.1d 存在反例
9. 批判性分析
9.1 优点
问题设定有现实价值 :无位姿 assist views 比密集 posed reconstruction 更符合快速新物体 onboarding。混合式设计合理 :foundation geometry model 负责泛化,显式 matching / pose graph / PnP 负责可解释约束。消融链条较完整 :backbone-only、matching、fusion、anchor sampling、assist count 都有对应实验。跨 benchmark 证据较广 :不是只在单个自建数据集上展示。工程分支清楚 :RGB 与 RGB-D 共享前端,但根据可用几何选择 PnP 或 Umeyama。
9.2 缺点
标题比实际设定更强 :“arbitrary / pose-free references”没有消除 canonical anchor 的已知 pose。mask 依赖被弱化 :大多数主表用 GT masks,真实前端误差传播缺失。对称多解没有建模 :只有单 pose solver,没有 uncertainty / hypothesis set。graph failure 缺少统计 :没有报告连通率、错误边比例、路径长度与 pose error 的关系。训练资源不低 :两张 A100、合成 CAD 大数据;新对象阶段轻量不等于整体轻量。实验文字有轻微过度概括 :Toyota-Light RGB 指标反例需要读者自己从表中发现。
9.3 隐含假设
anchor 的 canonical pose 定义正确且可复用;
object crop / mask 足够准确;
至少存在一条从 query 到 anchor 的视觉重叠链;
foundation model 在 object-centric crop 上的点图尺度和结构可通过 LoRA 适配;
物体是刚体,跨参考拍摄期间外形不变;
相机内参与深度标定可靠;
多视图中是同一对象实例,不涉及实例身份混淆。
9.4 真实应用可行性
适合“机器人面前出现一个新刚体,操作者能给一张规范参考并随手补拍几张图”的场景。要进入稳定产品,还需要:
detector / segmentor 与 PANY 的端到端联合评测;
assist view 质量筛选或主动拍摄策略;
graph 断连和对称歧义的 uncertainty 输出;
对动态背景、反光 / 透明材质、非刚体和相似实例的专项测试;
完整延迟、显存、移动端 / 边缘端部署数据。
10. 未来工作与可改进方向
10.1 论文自身指出
extreme occlusion 或 query–reference overlap 极低时,对应无法建立;
strongly symmetric objects 的 orientation ambiguity 不能仅靠几何 cue 解决。
10.2 本站认为最值得做的扩展
Uncertainty-aware pose graph :边不仅给变换,还给 inlier ratio、covariance 或多峰 hypothesis;全局优化时按置信度加权。主动视图选择 :不固定拍 8 张 assist views,而是根据当前 graph coverage 选择最能降低位姿不确定性的下一视角。symmetry-aware solver :在 canonical correspondences 上保留等价旋转集合,输出 hypothesis set,再由 temporal / grasp context 消歧。mask-robust training :训练时注入 SAM / CNOS 式缺口、外扩、粘连和错实例 mask,报告 mask quality–pose 曲线。动态对象版本 :将 view graph 扩展到时空图,区分相机变化与对象运动,连接 Point2Pose 一类 object tracking。轻量化 :蒸馏 multi-view backbone,减少 518² 多图推理成本,并按 graph 需要动态早停。
10.3 应补充的实验
每类对称对象的 MSSD / MSPD 分析;
graph 连通率、平均边数、错误边比例与性能相关性;
GT mask → CNOS / SAM mask 的系统退化;
深度噪声、缺失深度和 RGB / RGB-D solver 公平比较;
参考图数量、采集时间和 end-to-end latency 的 Pareto 曲线;
相同总视图预算下,随机 assist 与主动选择 assist 的比较。
11. 对我的研究的启发
可直接借鉴 :以视图图的“连通性”定义 onboarding 是否足够,而不是只用参考图数量。可复用模块 :geometry-aware local descriptor、valid correspondence threshold、RANSAC–Umeyama edge、anchor-centric pose composition。必须加入的 baseline :One2Any、Oryon、Any6D、FoundPose / FoundationPose;若研究多参考,还应比较固定 posed templates 与 unposed assists 的同预算性能。潜在切入点 :开放世界 object pose 中的主动参考采集、graph uncertainty、对称多解与 detector–pose 联合鲁棒性。工程提醒 :先统一 T Q → A T_{Q\rightarrow A} T Q → A T i → A T_{i\rightarrow A} T i → A
12. 待解决问题
概念问题
canonical anchor pose 在不同数据集里如何构造,是否需要人工定向?
RGB-only 路径如何稳定恢复尺度与平移,point map 的度量尺度来自何处?
公式 / 实现问题
正文同时出现 bidirectional CE 与 InfoNCE temperature,公开实现里的 matching loss 具体形式是什么?
pose graph 若存在多条路径,当前是树式遍历、最短路径还是全局 pose graph optimization?闭环如何处理?
实验问题
Table 3 的时间是否包括 backbone、matching、graph、solver 和 mask?
对称对象按 BOP symmetry-aware metric 后的分类结果如何?
多视图收益有多少来自覆盖增加,有多少来自等价于 test-time augmentation?
复现问题
公开仓库是否包含预训练权重、Omni6DPose sampling 脚本和全部五个 benchmark 的统一评测配置?
8 个 assist views 的随机采样能否严格复现 Table 2 / 3,随机种子与视图候选池如何定义?