论文精读笔记:Point2Pose: Occlusion-Recovering 6D Pose Tracking and 3D Reconstruction for Multiple Unknown Objects Via 2D Point Trackers
1. 基本信息
简称 :Point2Pose作者 :Tzu-Yuan Lin、Ho Jae Lee、Kevin Doherty、Yonghyeon Lee、Sangbae Kim机构 :MIT Biomimetic Robotics Lab / MIT;Kevin Doherty 的作者标注为 Boston Dynamics,但论文注明工作由个人时间独立完成年份 / 会议 :ECCV 2026;当前全文证据为 arXiv:2604.10415 v1论文 / PDF :arXiv / PDF 演示视频 :YouTube 代码状态 :论文声明未来开源,当前作者论文页仅给 paper / video,本站不将其标为已开源阅读模式 :精读证据边界 :数字和图表均按 2026-04-12 的预印本核验;公开仓库与 ECCV camera-ready 后续可能更新。
2. 一句话定位
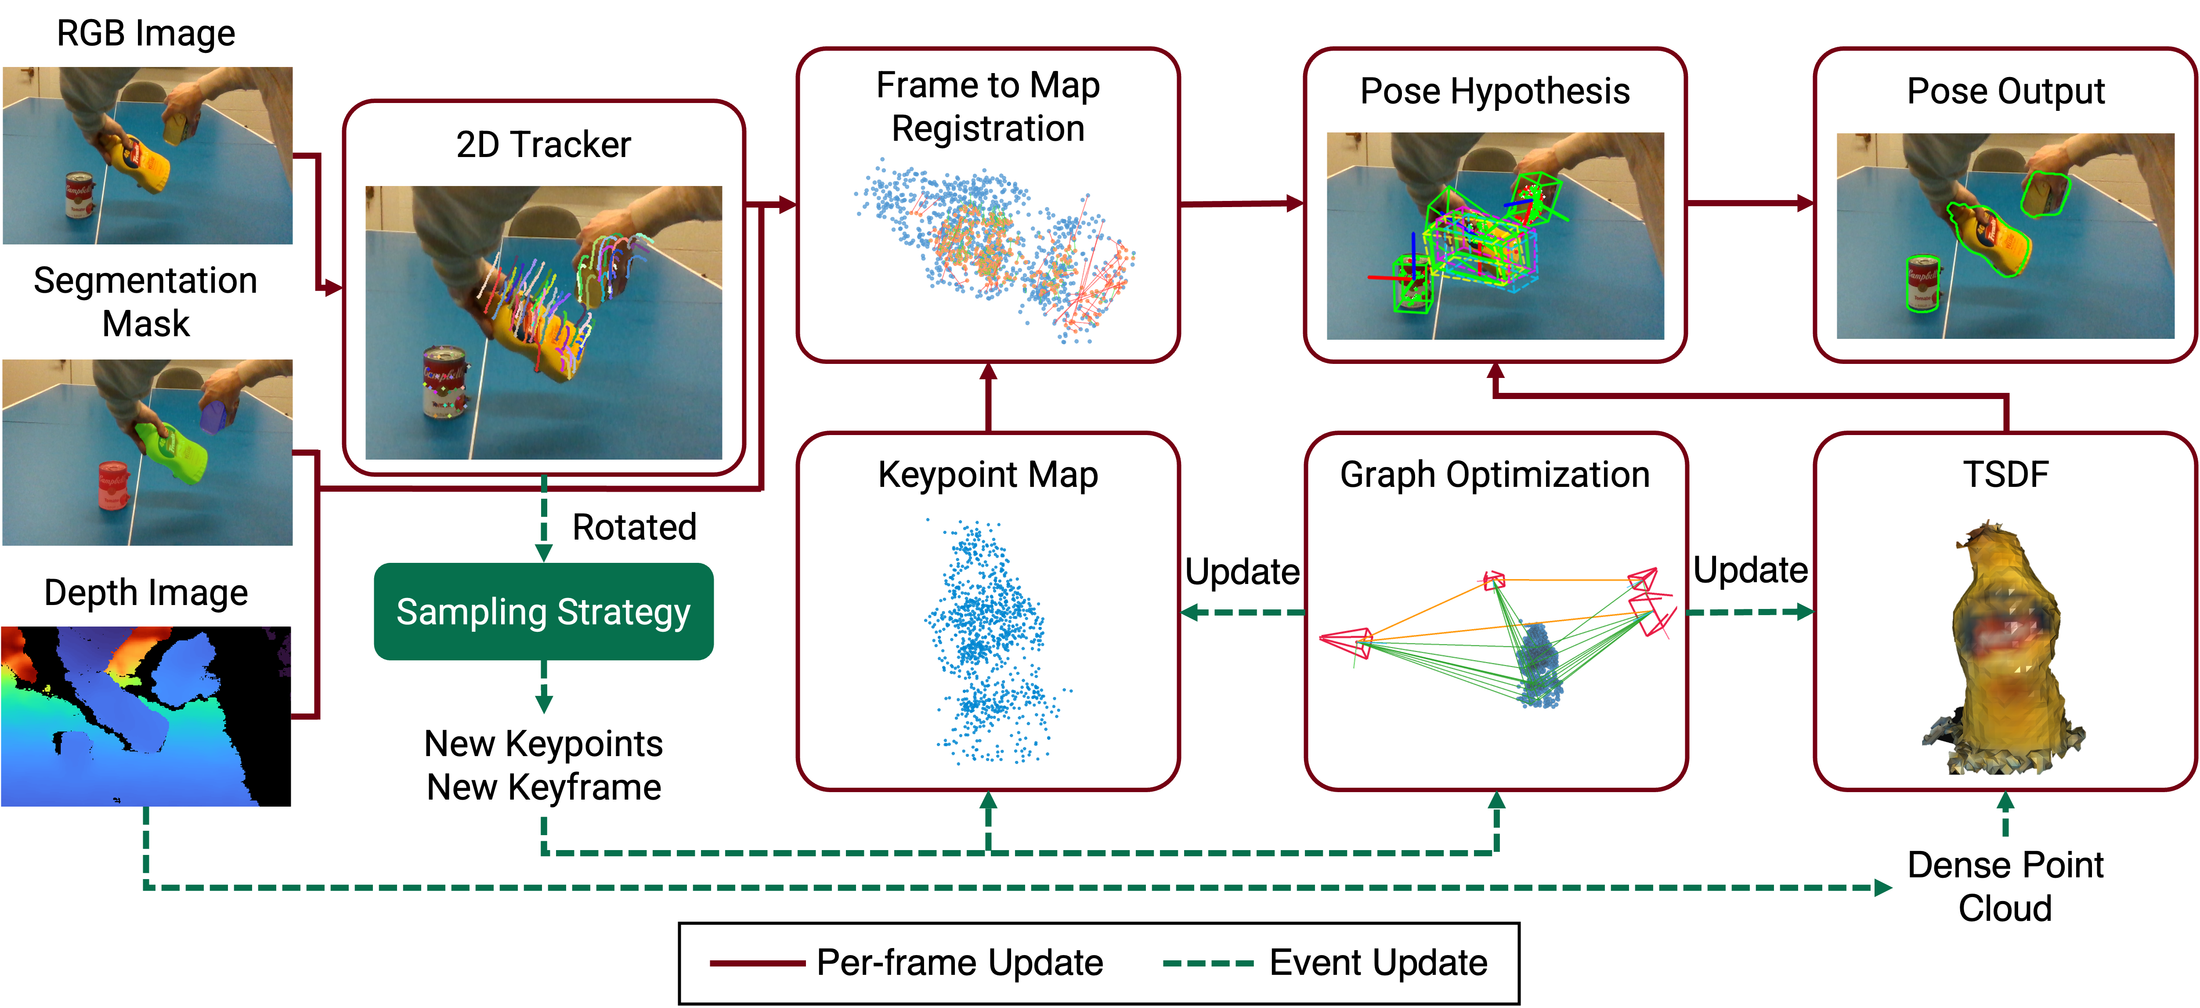
Point2Pose 用长程 2D tracks 代替逐帧 feature matching,把 RGB-D observations 持续写入每个对象的 3D keypoint map;sequential RANSAC 生成多 pose hypotheses,TSDF 负责 dense geometric selection / refinement,GTSAM factor graph 负责跨 keyframe 全局一致性,从而在无 CAD 条件下同时跟踪与重建多个刚体,并在完整遮挡后直接恢复相对首帧 pose。
2.1 论文图表导读
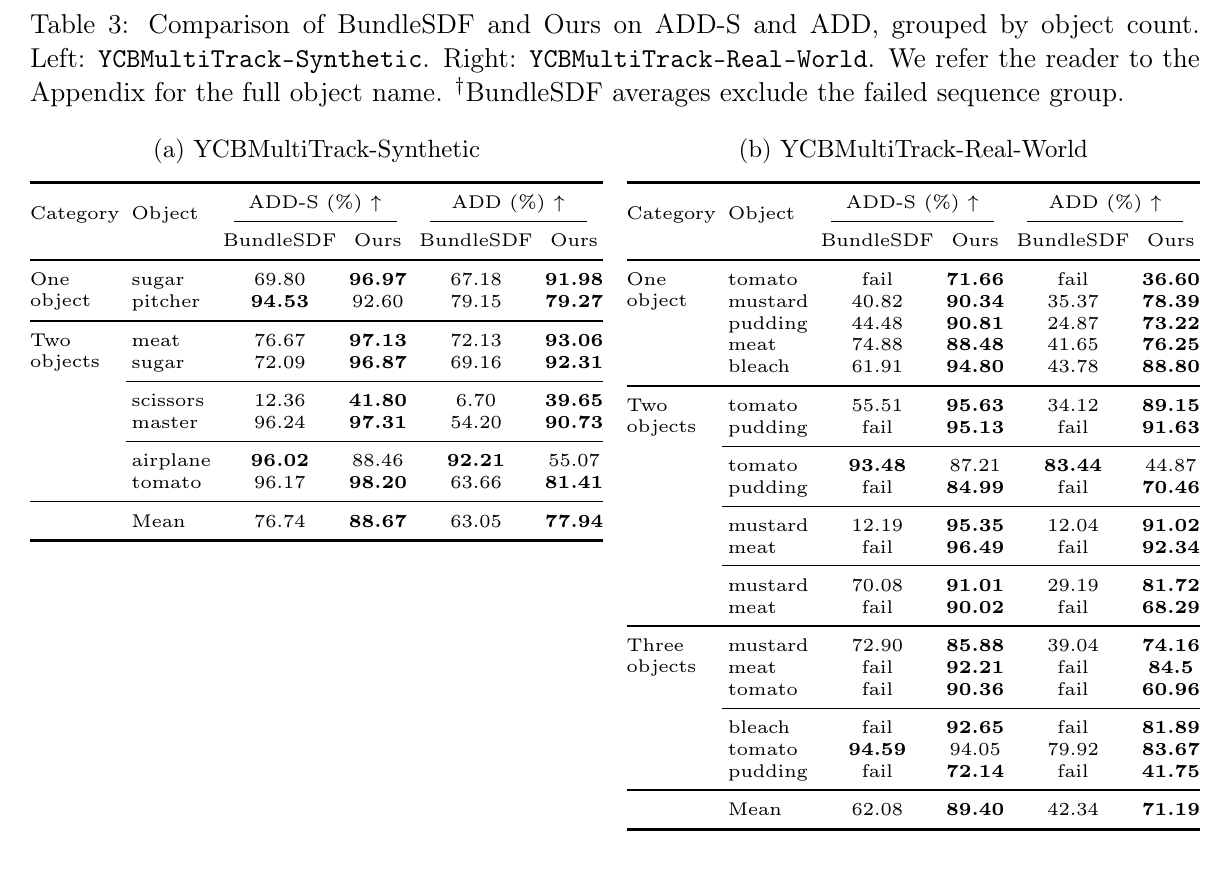
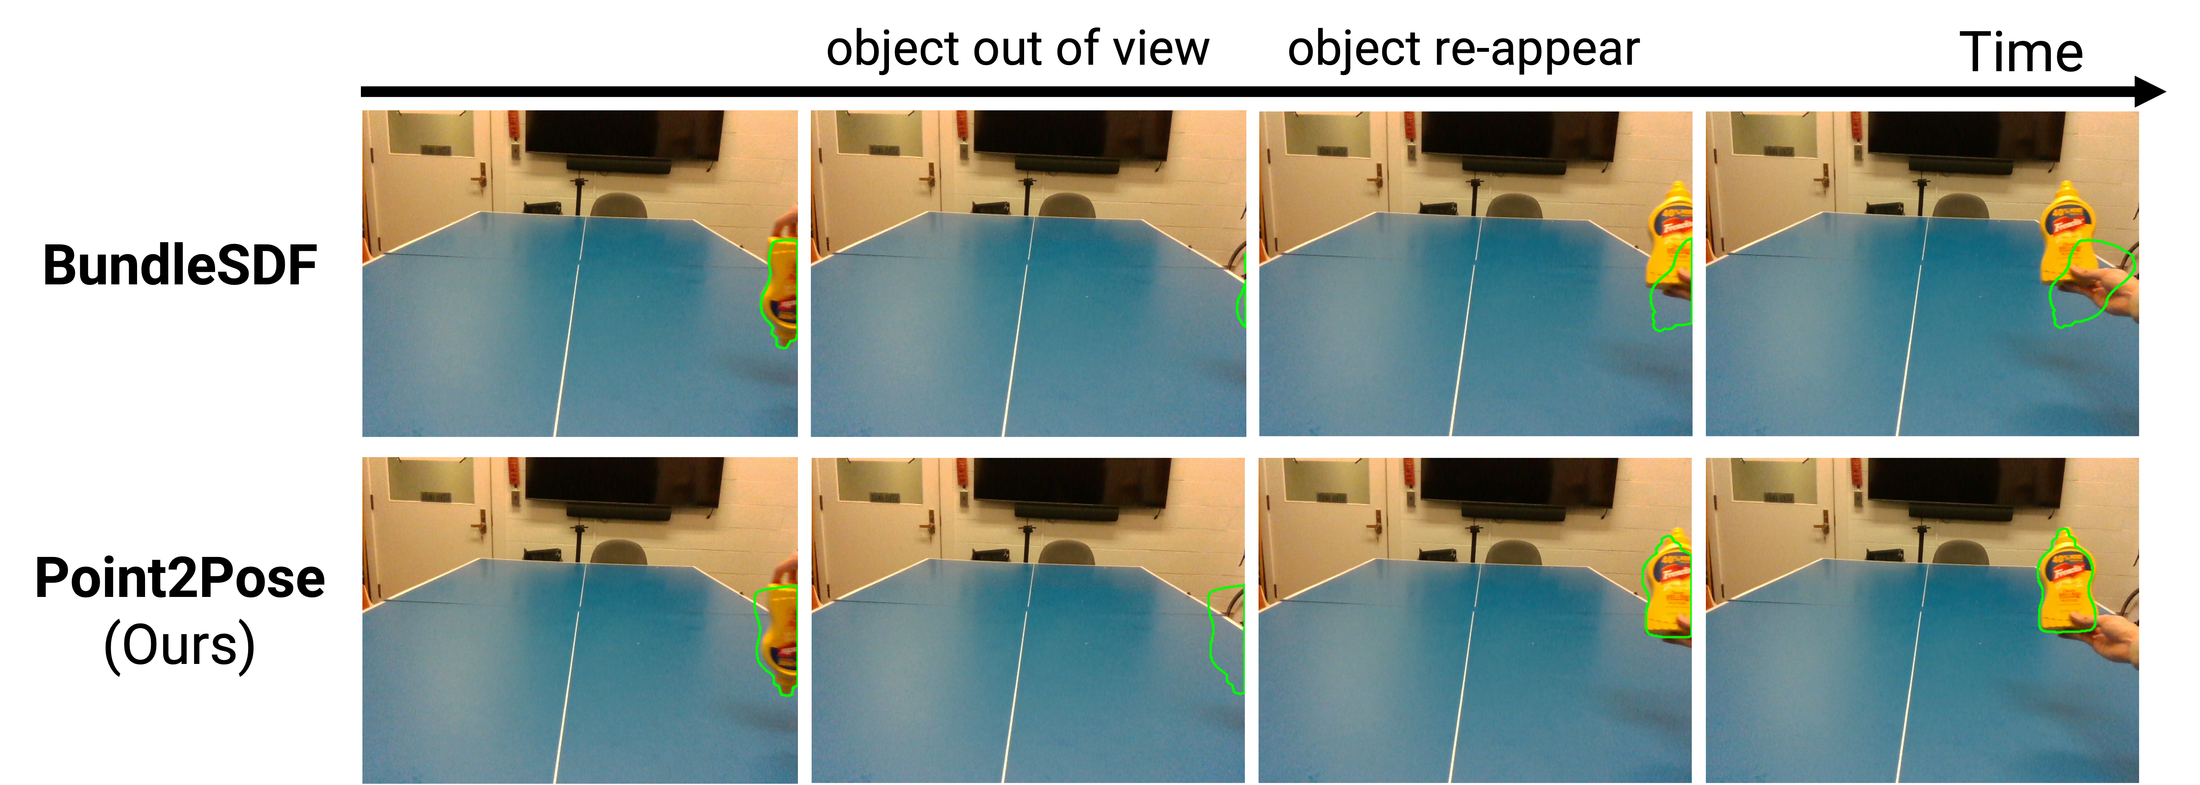
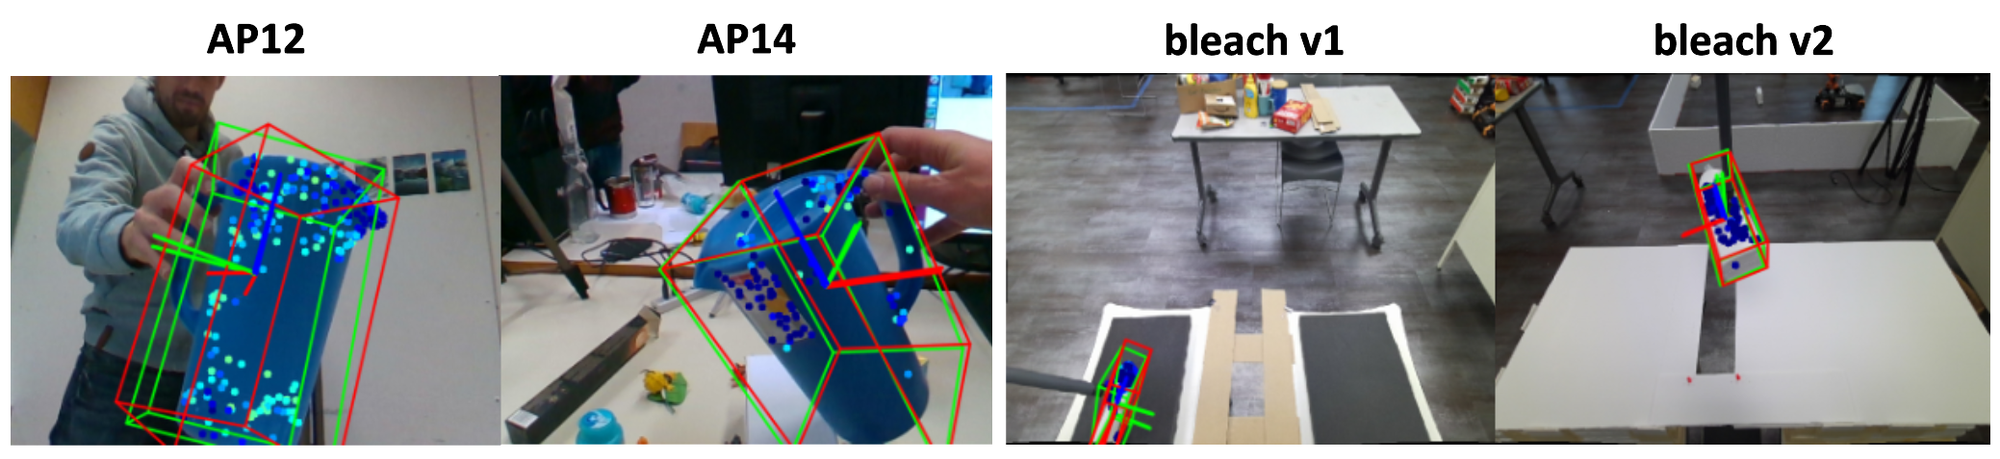
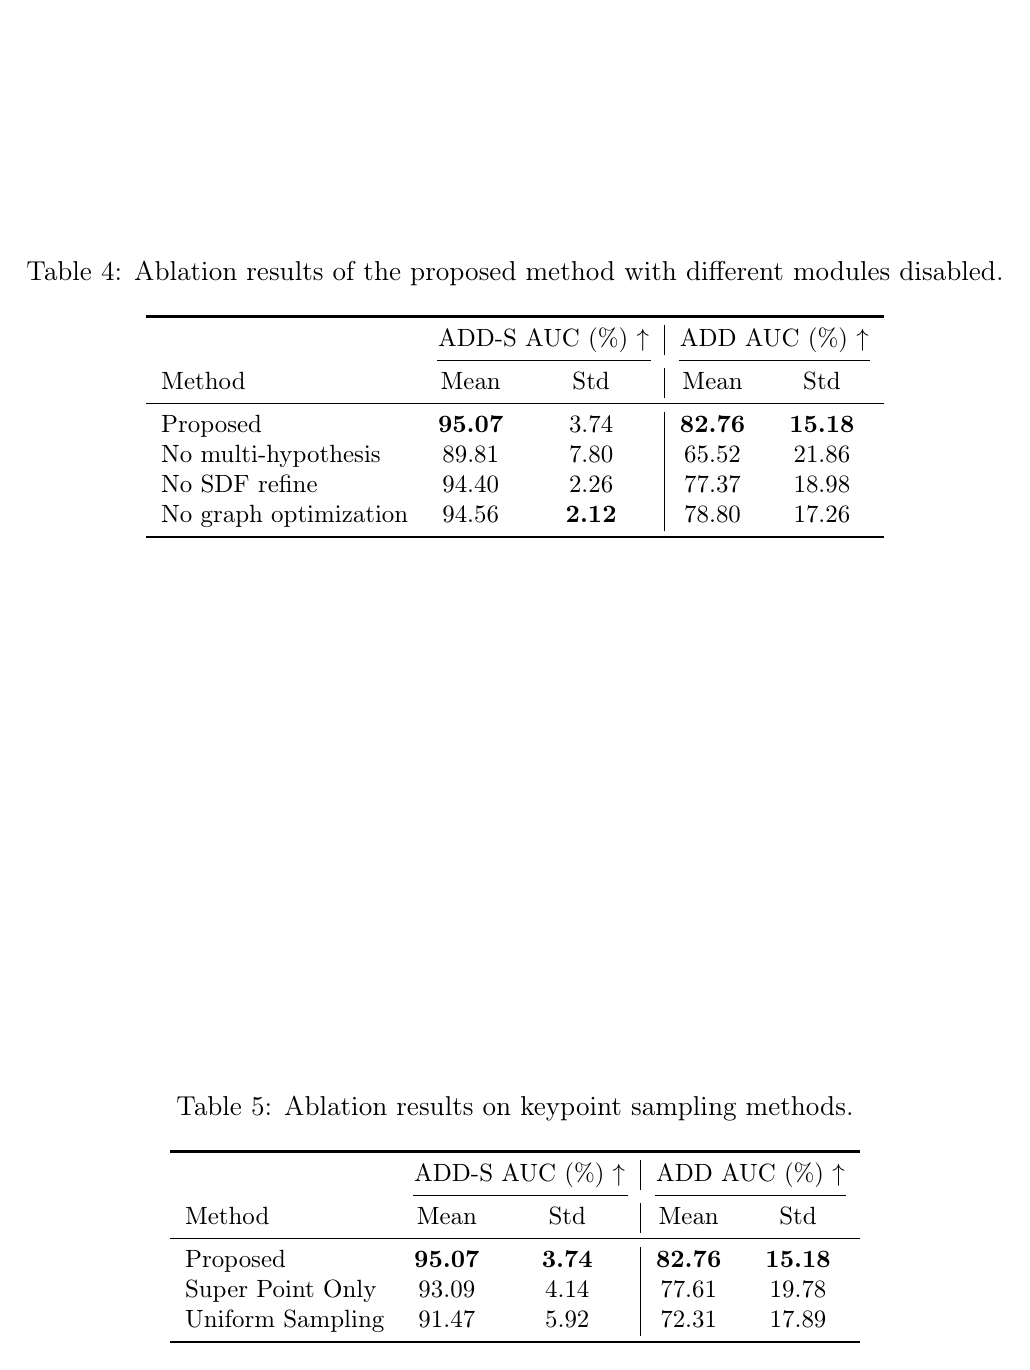
图表 证据作用 本站解读 Figure 2 系统数据流与更新频率 2D tracker 是持续数据关联;TSDF 同时是重建结果和 pose scoring surface。 Figure 4 纹理失败案例 作者没有只展示成功:低纹理导致高 uncertainty、tracks 抖动与 ADD 降低。 Figure 5 complete-occlusion recovery 区分“遮挡期间不输出”与“重现后能否恢复正确 orientation”。 Table 3 多对象主结果 BundleSDF 被逐对象串行运行仍多次 fail;Point2Pose 的优势集中在新 benchmark。 Tables 4–5 系统与采样消融 multi-hypothesis 是最大贡献;只追高 SuperPoint score 或纯均匀采样都不如联合策略。
3. 问题设定与任务边界
3.1 坐标系
论文假设 camera frame C C C i i i O i O_i O i
T O i , 0 C = I 4 × 4 . T^{C}_{O_i,0}=I_{4\times 4}. T O i , 0 C = I 4 × 4 . 后续估计 T O i , t C T^{C}_{O_i,t} T O i , t C
因此:
它能回答“对象相对初始化时转了多少、移了多少”;
不能单独回答“当前物体相对其语义 canonical model 的绝对 pose”;
ADD / ADD-S 评估通过首帧 object frame 与 GT mesh pose 的关系做转换,操作时本身不需要 mesh。
3.2 输入与输出
项目 论文设定 输入流 单个 calibrated RGB-D camera 的 causal video 初始化 每个对象若干 user-provided points;SAM2 instance mask 外部基础模型 TAP / CoTracker 类 long-range 2D point tracker;SuperPoint;SAM2 对象先验 不需要 CAD、类别、训练实例 输出 每对象 6D relative pose trajectory、keypoint map、object-centric TSDF / mesh 对象性质 多个刚体;同一实例在序列内外观 / 几何不变 当前相机假设 camera frame rigidly fixed to world;未建模 moving camera 与 object motion 的联合分解
3.3 causal 与 complete occlusion 的含义
causal :系统按视频时间推进,不使用未来帧全局批处理;新 keyframe 到来时在线更新 graph 与 TSDF。complete occlusion recovery :对象不可见期间没有新 3D observation;重现后 long-range tracker 恢复旧 query point identity,直接建立 map correspondence,而不是只用遮挡前最后 pose 做局部 refinement。不等于 :遮挡期间能预测真实运动轨迹。论文证明的是 reappearance 后恢复,不是对不可见区间 motion 的准确估计。
3.4 比较公平性
BundleSDF 是最主要 baseline,但原生只支持单对象。多对象序列中,作者为每个对象串行运行一份 BundleSDF ;这给 baseline 更多独占 compute / memory,却也没有改造其 relocalization 机制。比较能说明系统能力边界,但未给相同总时延 / 显存预算下的严格效率曲线。
4. 研究脉络
4.1 model-based tracking
FoundationPose 等已知 CAD 方法可用 render-and-compare 做局部 refinement,也能配合 detector / relocalizer,但 CAD 获取、模板渲染和已知实例库限制开放世界部署。
4.2 model-free tracking + reconstruction
BundleTrack :以 feature matching、bundle adjustment 和在线 surfel / mesh map 跟踪未知对象;相邻帧链断裂后易漂移。BundleSDF :加入神经 SDF、online reconstruction 与 relocalization,重建质量强,但通常是单对象且全遮挡重现仍依赖历史初始化。Point2Pose :将长期 data association 外包给 modern 2D tracker,并保留经典 SVD、TSDF、factor graph。它不是用更重的神经表示追求最高 reconstruction fidelity,而是优先保证多对象与 occlusion recovery。
4.3 为什么 point tracking 适合 pose tracking
2D point tracker 的 query identity 在时间上持久。只要有 depth,旧 map point p n p_n p n p ~ n \tilde p_n p ~ n δ t = 0 \delta_t=0 δ t = 0
但这把系统瓶颈迁移到 point tracker:无纹理、重复纹理或运动模糊会让 tracks 漂移,错误 correspondence 随后进入 3D registration。
5. 研究动机
相邻帧 pose tracking 隐含“上一帧 pose 足够接近当前帧”这一局部连续性假设。对象完全离开画面、被手臂遮住或与另一物体交叉时,该假设不再成立。单独增加 RANSAC 也不够:若杯身有大量错误近静止 tracks、手柄只有少量正确 motion tracks,最大 consensus 可能恰好是错误解。
Point2Pose 因而组合三个层次:
长程 identity :尽可能保留遮挡前后的对应;多假设几何 :不让最大错误 consensus 一票否决正确小簇;dense TSDF 验证 :用稠密表面而不是同一批稀疏 tracks 选择 hypothesis。
这是该论文最有价值的系统设计逻辑。
6. 方法详解
原论文 Figure 2。红色实线表示逐帧更新:RGB / mask → 2D tracks → frame-to-map registration → pose hypotheses → pose output;绿色虚线表示 keyframe / event update:新点、graph 与 TSDF。TSDF 既输出 mesh,也参与 hypothesis selection 和 pose refinement。来源:arXiv:2604.10415 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.1 2D point tracker
一个 query point 写作 q = ( t q , u q ) q=(t_q,u_q) q = ( t q , u q )
像素位置 u t ∈ R 2 u_t\in\mathbb R^2 u t ∈ R 2
可见性 δ t ∈ { 0 , 1 } \delta_t\in\{0,1\} δ t ∈ { 0 , 1 }
不确定性 σ t ∈ [ 0 , 1 ] \sigma_t\in[0,1] σ t ∈ [ 0 , 1 ]
每个对象保留独立 query set Q i Q_i Q i
论文允许 TAP 或 CoTracker 类 tracker,说明方法是一层系统框架;性能会随 tracker 版本变化。公开结果对应的具体 checkpoint 与 causal mode 需要在代码公开后确认。
6.2 trackability–coverage 联合采样
SuperPoint 在 object mask 内产生候选 ( p k , s k ) (p_k,s_k) ( p k , s k )
J k = λ s k + ( 1 − λ ) min ( d k r i d e a l , 1 ) − β ρ ( d k ) , J_k=\lambda s_k+(1-\lambda)\min\left(\frac{d_k}{r_{ideal}},1\right)-\beta\rho(d_k), J k = λ s k + ( 1 − λ ) min ( r i d e a l d k , 1 ) − β ρ ( d k ) , 其中 s k s_k s k d k d_k d k r i d e a l r_{ideal} r i d e a l ρ \rho ρ r m i n r_{min} r min
三项分别解决:
只做均匀采样:点可能位于无纹理区,tracker 不稳定;
只取 SuperPoint 高分:点会聚集在少数角点,3D registration 几何退化;
联合策略:兼顾可追踪性与空间 spread。
6.3 pending keypoint verification
新点按当前 pose 和 depth 提升到 object frame,但不立即写入永久 map。它先进入 pending:多帧观察中每次通过验证累积 +1,窗口内达到阈值才晋升。
这是重要的 map hygiene:若当前 pose 偏了或 depth 在边缘出错,立即写图会造成自增强污染,后续 frame-to-map 又被错误 landmark 拉偏。
6.4 frame-to-map SVD
可见 track 经 depth back-projection 得当前 camera-frame 3D observation p ~ n \tilde p_n p ~ n p n p_n p n
T O i , t C = arg min T ∈ S E ( 3 ) ∑ n = 1 N ∥ p ~ n − T p n ∥ 2 , T^C_{O_{i,t}}=\arg\min_{T\in SE(3)}\sum_{n=1}^{N}\|\tilde p_n-Tp_n\|^2, T O i , t C = arg T ∈ S E ( 3 ) min n = 1 ∑ N ∥ p ~ n − T p n ∥ 2 , 可用 SVD 闭式求解。若对应大部分正确,这一步简单、高效;真正困难是 outlier distribution。
6.5 sequential multi-hypothesis registration
普通 RANSAC 只返回最大 consensus。Point2Pose 重复执行:
RANSAC + SVD 找当前最大 consensus;
保存其 pose hypothesis;
移除该 consensus;
在剩余 correspondences 上继续。
这样即使错误的对称杯身 tracks 数量最多,少数手柄正确 tracks 仍有机会形成第二个 hypothesis。它类似从 correspondence set 中做 greedy motion segmentation。
6.6 TSDF hypothesis selection 与 SDF refinement
对当前 mask 内 dense depth points,分别变换到每个 hypothesis 的 object frame,计算其绝对 TSDF 值;总分最低者为最符合已重建表面的 pose。
选择后,以 T 0 T_0 T 0 D ∈ S E ( 3 ) D\in SE(3) D ∈ S E ( 3 )
D ∗ = arg min D ∑ p ∈ P c u r ρ H ( Φ ( T i − 1 D − 1 p ) 2 ) , D^*=\arg\min_D\sum_{p\in\mathcal P_{cur}}\rho_H\left(\Phi(T_i^{-1}D^{-1}p)^2\right), D ∗ = arg D min p ∈ P c u r ∑ ρ H ( Φ ( T i − 1 D − 1 p ) 2 ) , 用 TSDF 数值梯度和 Levenberg–Marquardt 求解。这里把稀疏 hypothesis generation 与稠密 surface refinement 分开,避免同一批错误 tracks 同时生成和裁决 pose。
6.7 online factor graph
作者采用“固定物体、虚拟相机运动”的等价视角,用 inverse pose X m = T C O ( m ) X_m=T^O_C(m) X m = T C O ( m ) P P P
L ( X , P ) = L p r i o r + L o d o m + L o b s . \mathcal L(X,P)=\mathcal L_{prior}+\mathcal L_{odom}+\mathcal L_{obs}. L ( X , P ) = L p r i or + L o d o m + L o b s .
prior :固定 X 0 = I X_0=I X 0 = I odom :约束相邻 keyframe 的 relative registration,并用 Huber 抑制异常;observation :以 bearing + range 表示 3D landmark observation,联合惩罚方向角与径向误差。
每次新 keyframe 插入时用 GTSAM / LM 重优化 keyframe poses 与 keypoint positions。它改善的是全局 map consistency,不是对不可见期间运动的动态模型预测。
6.8 TSDF reconstruction
优化后的 keyframe pose 将 segmented RGB-D 融入 object-centric voxel grid。projective TSDF update 以 truncation τ \tau τ
选择经典 TSDF 的好处是在线、可微分 surface distance 易算、工程稳定;代价是细节和孔洞修复不如 BundleSDF 等 neural implicit model。
6.9 模块输入输出
模块 输入 输出 作用 主要失效条件 SAM2 / mask 初始 clicks + RGB per-object masks 限定 points 与 depth 漏分、粘连、背景污染 Long-range tracker RGB video + query sets u t , δ t , σ t u_t,\delta_t,\sigma_t u t , δ t , σ t 遮挡前后 identity 无纹理、重复纹理、模糊 Sampling / pending SuperPoint + mask + map verified 3D keypoints 扩张 map 且防污染 depth edge noise、pose 初值错 Multi-hypothesis SVD current 3D observations ↔ map pose candidates 保留小众正确 motion 全部 tracks 错或几何共线 TSDF scoring / refine dense depth + candidates + TSDF selected refined pose 独立稠密验证 TSDF 尚未成形、深度缺失 Factor graph keyframes、relative poses、landmark observations optimized poses / points 降漂移、统一 map 错 factor、对象非刚体 TSDF fusion segmented RGB-D + optimized pose object mesh / SDF reconstruction + pose surface 透明反光、mask 噪声
7. 实验分析
7.1 数据集
数据集 序列 / 对象 GT 来源 主要用途 HO3D v3 13 sequences、4 objects 多帧 registration 自动生成 与 BundleSDF 比较重手部遮挡单对象 tracking YCBInEOAT 9 sequences、5 objects 每帧人工 6D pose 远距离双臂机器人操作、目标较小 YCBMultiTrack-Synthetic 7 YCB objects;1 single + 3 two-object scenarios Isaac Lab exact poses / depth 控制 multi-object motion 与 mutual occlusion YCBMultiTrack-Real-World 5 objects;5 single + 4 two + 2 three-object scenarios OptiTrack + AprilTag camera extrinsic + 时间同步 complete occlusion、出画、跨对象遮挡
真实集用 RealSense D435i,物体上安装 4–5 个 mocap markers。这个 GT 比伪标签可靠,但标记物可能略微改变对象外观 / 可追踪纹理,论文未量化其影响。
7.2 指标
ADD AUC :保留旋转 / 对称轴误差,要求 exact pose;ADD-S AUC :最近点匹配容忍对称等价,可能在姿态轴有偏时仍较高;Chamfer Distance :比较 reconstructed mesh 与 GT mesh,反映重建而非仅 tracking。
论文的失败分析说明 ADD-S 与 ADD 必须一起看:AP12 / bleach v1 中姿态沿对称方向错误,ADD-S 仍可能“看起来合理”。
7.3 HO3D 与 YCBInEOAT:普通 benchmark 并非全面领先
数据集 方法 ADD-S AUC ADD AUC Chamfer 判断 HO3D BundleSDF 93.34 92.62 0.58 m exact pose 与 reconstruction 更好 HO3D Point2Pose 94.63 80.79 1.02 m symmetry-tolerant 指标略高,但 exact pose / mesh 更差 YCBInEOAT BundleSDF 94.51 89.07 — tomato 组 fail,均值排除了失败 YCBInEOAT Point2Pose 92.67 85.11 — 普通序列略低,但全部组都有输出
作者声称 “competitive”是恰当的;若写成 SOTA 或全面超过,则与表格不符。Point2Pose 的价值不是在单对象、持续可见场景抢最高平均分,而是在 baseline fail 的完整遮挡 / 多对象 regime 保持可恢复性。
7.4 多对象主结果
原论文 Table 3。左侧合成集 Point2Pose 均值 88.67 ADD-S / 77.94 ADD,高于 BundleSDF 的 76.74 / 63.05;右侧真实集 Point2Pose 为 89.40 / 71.19,BundleSDF 即使将 failed groups 排除后也只有 62.08 / 42.34。注意个别 airplane、tomato 组合中 BundleSDF 更高,优势不是逐行全胜。来源:arXiv:2604.10415 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Synthetic mean :ADD-S +11.93 points,ADD +14.89 points。Real mean :ADD-S +27.32 points,ADD +28.85 points;BundleSDF 均值还排除了 fail groups,因此差距是保守的。不是逐对象全胜 :Synthetic pitcher ADD-S 92.60 < 94.53;airplane 88.46 / 55.07 < 96.02 / 92.21。Point2Pose 的总体优势来自减少灾难性 failure,而不是每个容易序列都更精确。
7.5 完整遮挡恢复
原论文 Figure 5:物体完全不可见后重新进入画面。BundleSDF 的重定位由旧 pose 初始化,保留了 stale orientation;Point2Pose 的 long-range tracks 重新建立旧 map point 到当前观测的对应,恢复正确方向。图中展示的是代表性序列,整体成功率仍应以 Table 3 为准。来源:arXiv:2604.10415 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
这里的“恢复”并不意味着系统知道遮挡期间的轨迹。它只在目标重现并有可靠 tracks 后重新求 pose。若重现外观与旧 query points 完全不同,仍可能无法恢复。
7.6 纹理失败案例
原论文 Figure 4:AP12 与 bleach v1 的可见表面纹理弱,许多 points 显示高 tracker uncertainty,tracks 跨帧抖动并使 pose 不稳定;AP14 与 bleach v2 有更多标签 / 局部纹理,跟踪更可靠。绿色框为 prediction,红色框为 GT。来源:arXiv:2604.10415 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
这张图揭示系统并没有真正“绕过 correspondence”:它只是用更强、更长程的 correspondence memory 替代逐帧 matching。纹理不足仍是根本限制。
7.7 消融实验
原论文 Tables 4–5。系统消融中,去掉 multi-hypothesis 后 ADD AUC 从 82.76 降到 65.52,是最大跌幅;去掉 SDF refine / graph optimization 分别降到 77.37 / 78.80。采样消融中,只用 SuperPoint 或均匀采样分别为 77.61 / 72.31,均低于联合 trackability–coverage 策略。来源:arXiv:2604.10415 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
消融 ADD-S AUC ADD AUC 绝对跌幅(ADD) 证明的主张 Full 95.07 82.76 — 完整系统 No multi-hypothesis 89.81 65.52 -17.24 outlier-heavy tracks 不能只求单一最大 consensus No SDF refine 94.40 77.37 -5.39 dense TSDF local alignment 有收益 No graph optimization 94.56 78.80 -3.96 全局 keyframe / landmark refinement 有收益 SuperPoint only 93.09 77.61 -5.15 可追踪性不等于空间条件良好 Uniform sampling 91.47 72.31 -10.45 空间均匀但无纹理点不可靠
消融支持三个模块的互补性,但没有报告 TSDF selection 与 SDF refinement 分离消融,也没有把 tracker uncertainty 显式加权和不加权做对照。
7.8 贡献是否被实验支撑
贡献 证据 是否充分 本站判断 complete-occlusion recovery YCBMultiTrack Real、Figure 5、BundleSDF fail groups 较充分 新 benchmark 与定性 / 定量一致;仍需更多物体和遮挡时长分层 multi-object tracking 2 / 3-object scenarios、单 tracker aggregate queries 基本充分 功能成立,但未报告 FPS / memory 随对象数曲线 multi-hypothesis robustness Table 4 充分 ADD -17.24 points 是强证据 sampling strategy Table 5 充分 比两个自然 baseline 更稳;可再补 uncertainty-aware sampling reconstruction HO3D Chamfer 不支持优于 baseline 能在线重建,但 fidelity 明显低于 BundleSDF competitive existing benchmarks HO3D、YCBInEOAT 基本成立 ADD-S 接近,ADD / Chamfer 较弱,不应宣传为全面 SOTA
8. 批判性分析
8.1 优点
将 complete occlusion 转化为 data association 问题 :思路直接,且可替换 tracker 持续升级。多假设设计针对结构化 outlier :不是泛泛“加 RANSAC”,而是保留小 consensus 里的正确解。稀疏—稠密证据分工清楚 :sparse tracks 产生 candidates,dense TSDF 负责独立裁决。factor graph 与 TSDF 有真实职责 :一个改全局 map,一个做表面评分 / 重建,不是装饰模块。数据集击中现有空白 :动态多对象、完整遮挡、真实 mocap 这一组合确实少见。
8.2 缺点
相机固定假设 :与论文引言提到的 egocentric / camera motion 场景存在距离。RGB-D 与 mask 依赖强 :透明 / 反光 / depth holes 与 segmentation noise 都可能双重污染 map 和 TSDF。普通 benchmark exact pose 较弱 :HO3D ADD 和 Chamfer 明显不如 BundleSDF。资源扩展性未量化 :每对象 points、landmarks、TSDF volume 都增长,论文只定性承认 memory 问题。不确定性没有进入优化 :tracker 输出 σ t \sigma_t σ t 重现后 identity 仍可能错 :相似对象交叉、同类多实例或长时间出画时,point tracker 可能把 identity 交换。
8.3 隐含假设
目标刚体且没有 articulated / deformable motion;
camera frame 静止;
每个对象能在首帧被用户可靠点击并分割;
多对象 mask 不粘连,object identity 不交换;
depth 与 RGB 严格对齐;
首段观测足以建立初始 map / TSDF;
遮挡后至少有部分旧 query surface 重现;
mocap marker 不显著帮助视觉 tracker。
8.4 真实应用可行性
适合固定 RGB-D 相机下的桌面操作、装配台和多对象人机交互原型。进入机器人系统前需要:
moving-camera compensation 或与 SLAM 联合;
detector / prompt 自动初始化,减少人工 clicks;
point identity 与 instance identity 的联合管理;
mask / depth 质量门控,防止错误更新 TSDF;
对目标数、track 数、voxel 分辨率的实时资源预算;
遮挡期间的 motion prior 与恢复置信度。
9. 未来工作与可改进方向
9.1 论文自身指出
低纹理 / 重复纹理使 point tracker 不可靠;
noisy / incomplete masks 引入 background points;
多对象造成 tracked points 和 memory 增长;
TSDF fidelity 低于现代 neural reconstruction,可探索 EfficientNeRF 等在线表示。
9.2 本站建议
uncertainty-weighted registration :将 tracker 的 σ t \sigma_t σ t track lifecycle management :按长期可见率、uncertainty、空间覆盖和对象 identity 进行增删,控制多对象内存。moving-camera extension :加入 background camera motion / SLAM factor,联合估计 T C W T^W_C T C W T O W T^W_O T O W reappearance verification :用 object-level appearance embedding / mask shape 验证 point tracker 的重现 identity,降低同类物体交换。neural / hybrid TSDF :保留 classical TSDF 的在线稳定性,用局部 neural residual 提升表面 fidelity,而不是完全替换为昂贵 NeRF。active occlusion recovery :当 graph / tracks 置信度低时,让机器人移动视角或对象,主动暴露已知 map surface。
9.3 建议补充实验
遮挡持续帧数、出画比例与恢复率曲线;
1→2→3→5→10 objects 的 FPS、GPU memory、track count;
GT mask、SAM2 mask 与受控腐蚀 / 膨胀 / 粘连噪声;
RealSense depth dropout / quantization / reflective objects;
moving camera + moving objects;
多个外观相似 YCB instances 交叉时的 ID switch;
TSDF voxel resolution 与 pose / Chamfer / runtime 的 Pareto。
10. 对我的研究的启发
核心抽象 :把长期 2D tracks 当作“稀疏、可恢复的对象坐标记忆”,再由 depth 将其转成 3D pose constraints。可复用模块 :trackability–coverage sampling、pending verification、sequential consensus removal、TSDF hypothesis score、keyframe–landmark factor graph。baseline 组合 :BundleTrack、BundleSDF、FoundationPose tracking;若强调长遮挡,还应加入 detector-based per-frame relocalization baseline,区分“长期 tracks”与“每帧重新估 pose”。研究切入点 :moving-camera multi-object pose、uncertainty-aware point-to-pose、同类实例 identity 和主动视角恢复。评测提醒 :一定同时报告 ADD 与 ADD-S;只看 ADD-S 会掩盖对称轴 orientation 的明显错误。
11. 待解决问题
概念问题
相机固定是实现方便还是算法必要?若 camera motion 已知,能否直接变换 depth observations 后复用系统?
首帧 object frame 与 GT mesh frame 的对齐如何在每个 benchmark 中实现,是否引入额外 GT?
公式 / 实现问题
sequential RANSAC 的 hypothesis 数量、consensus 移除阈值和停止条件是什么?
TSDF score 如何按当前 mask 面积 / valid depth 数归一化?
tracker uncertainty σ t \sigma_t σ t
实验问题
YCBMultiTrack 每段序列的帧数、遮挡持续长度和目标出画时长分布是什么?
BundleSDF failed group 排除后再算均值会偏高;若把 fail 记为 0,差距多大?
mocap markers 是否给对象增加了额外高对比视觉特征?
复现问题
论文承诺的代码、参数和 YCBMultiTrack 数据何时完整公开?
TAP 与 CoTracker 使用哪种 causal checkpoint、query update 策略和输入分辨率?
多对象 factor graphs / TSDF volumes 是并行线程还是单线程调度,完整实时性能如何?