论文精读笔记:Exploring Category-level Articulated Object Pose Tracking on SE(3) Manifolds
1. 基本信息
2. 一句话定位
论文把 category-level articulated pose tracking 改写成连续帧之间的 s e ( 3 ) se(3) se ( 3 )
2.1 论文图表导读
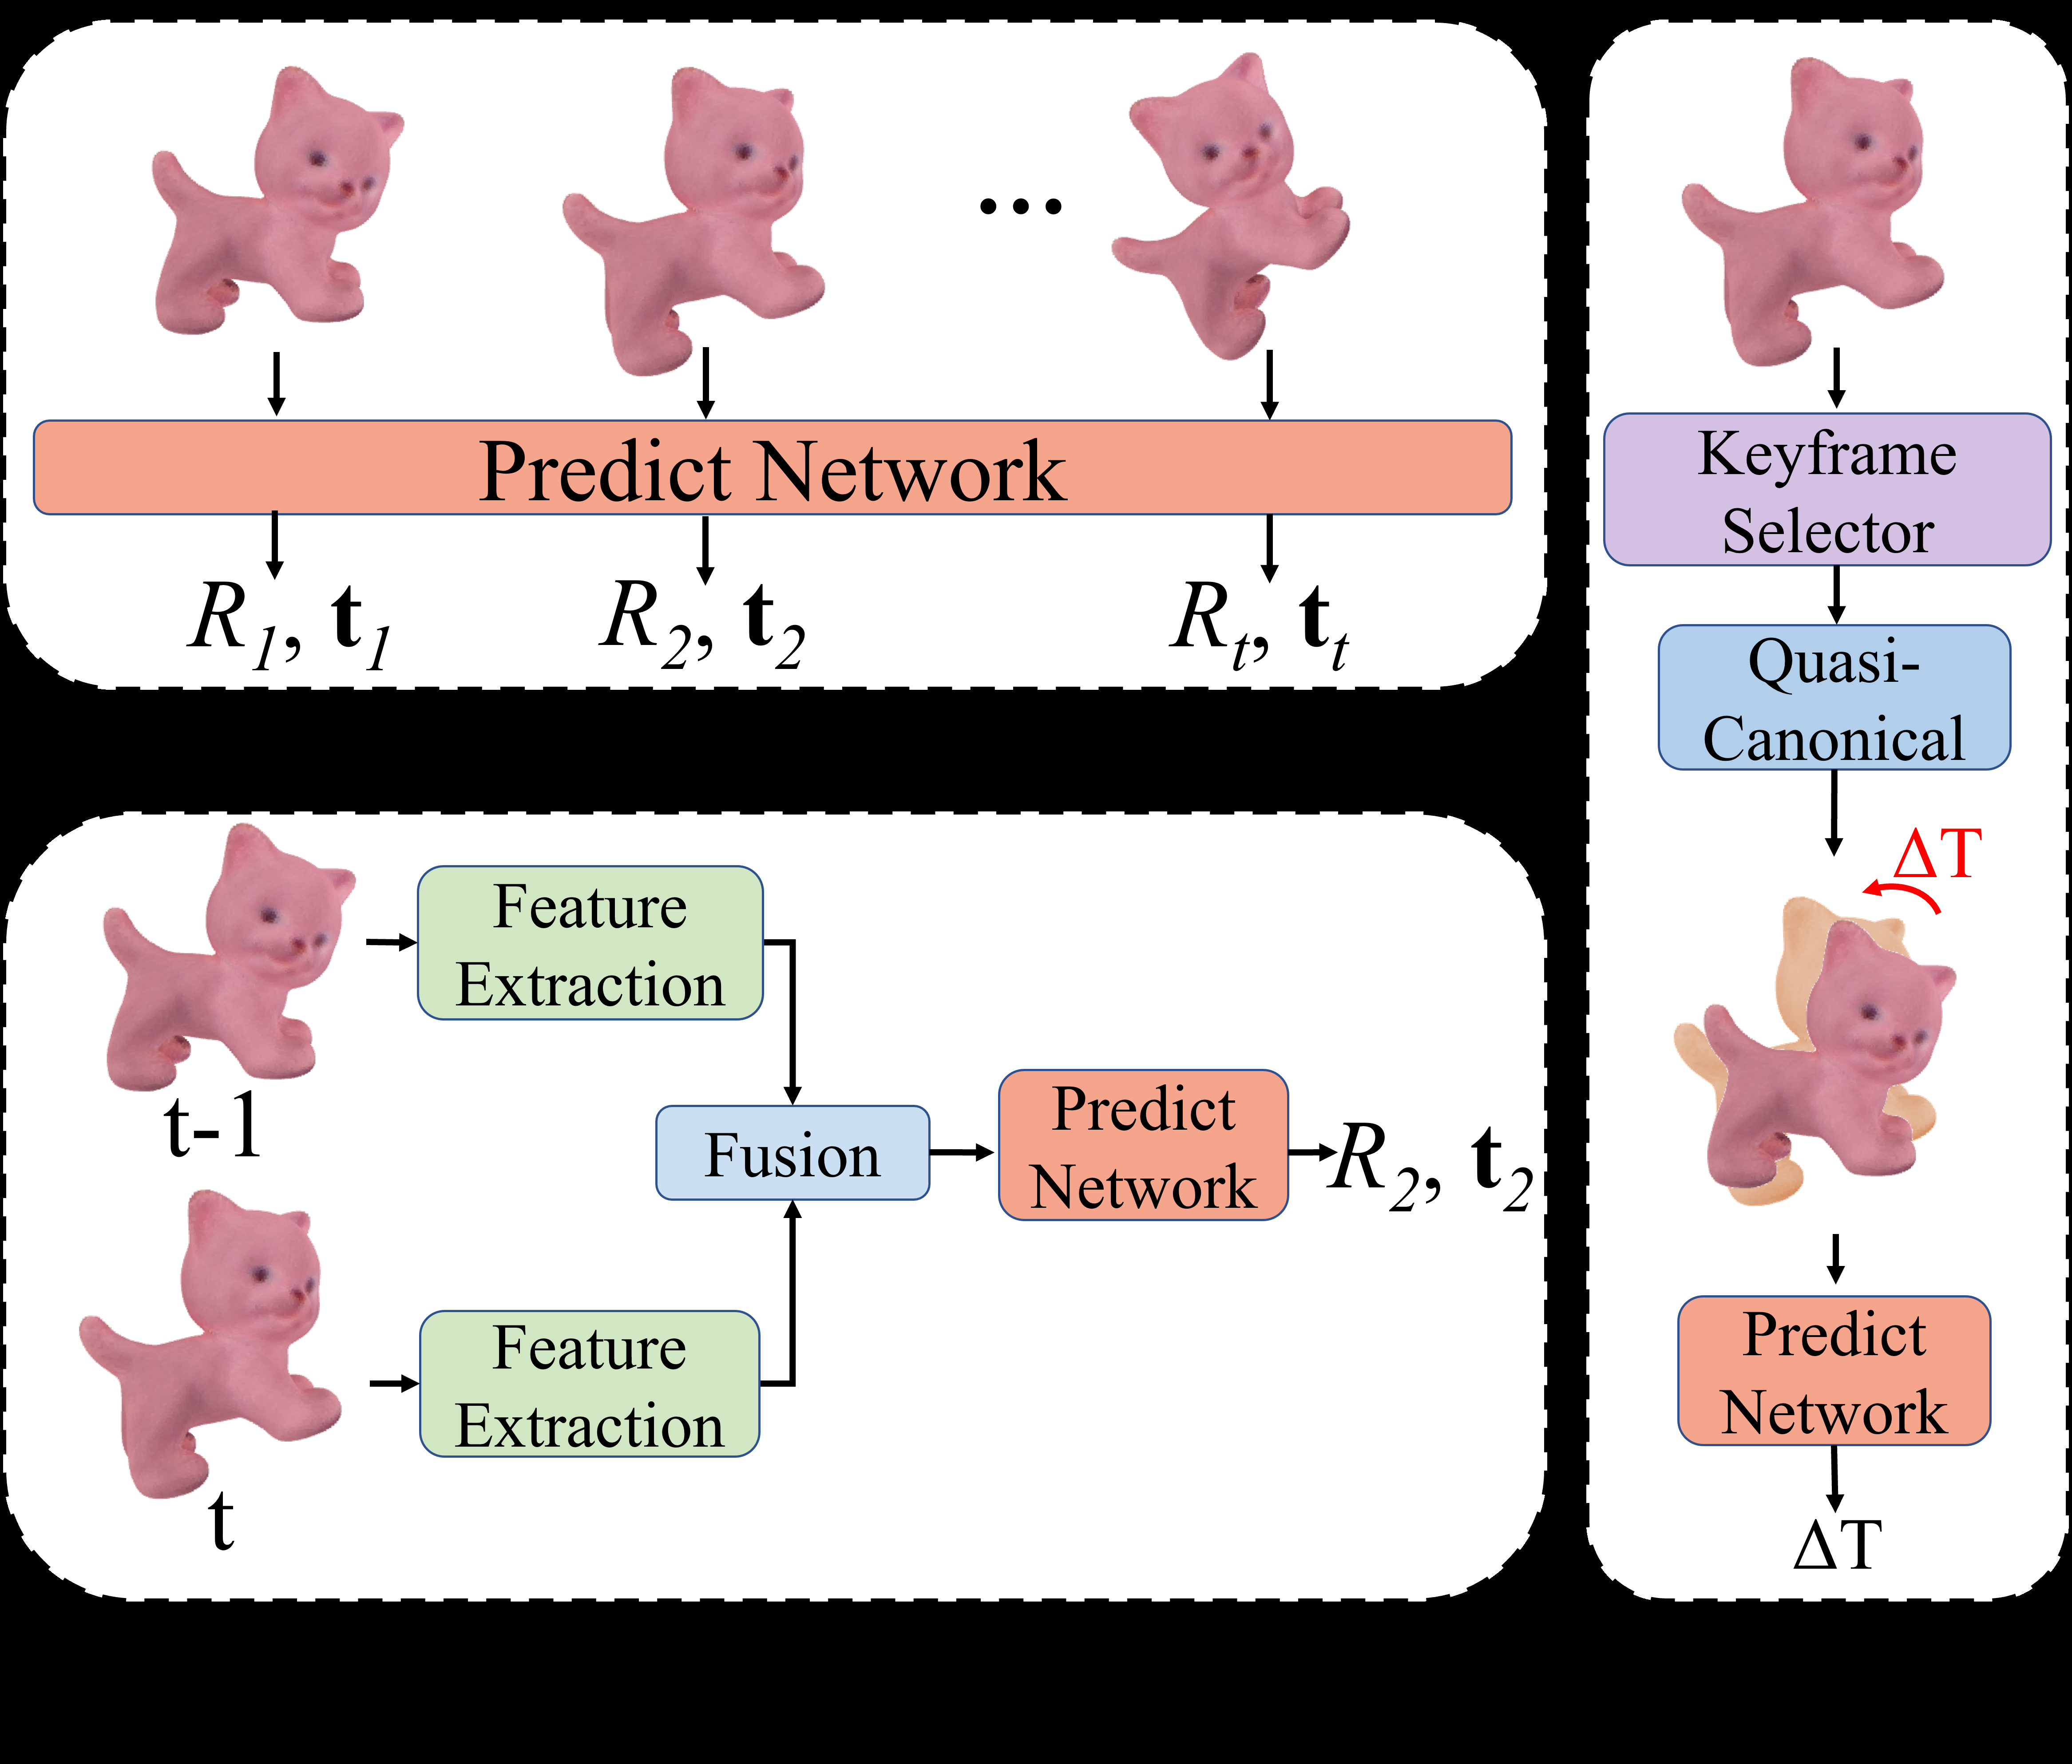
图表 内容 阅读重点 Figure 1 frame-wise prediction、inter-frame fusion 和本文方法对比 本文主要贡献是把时间信息、keyframe 和增量更新合并起来 Figure 2–4 总体结构、temporal segment 和 quasi-canonicalization 理解每个 segment 如何共享 keyframe transformation Figure 5–6 weighted point pairs 与 voting scheme 观察几何点对如何产生 translation / orientation votes Table 1–4 PM-Videos、ReArt-Videos、RobotArm-Videos 结果 同时看精度、scale IoU 和 inference time Table 2 kinematic constraint 与 keyframe selection 消融 直接验证减少 drift 和强化结构一致性的效果
原论文 Figure 1:逐帧预测、帧间融合和 PPF-Tracker 的 tracking 范式对比。来源:AAAI 官方 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
设物体包含 K K K J J J { P t } t ≥ 0 \{P_t\}_{t\ge 0} { P t } t ≥ 0 T 0 k T_0^k T 0 k
输出为每个部件每一帧的 T t k ∈ S E ( 3 ) T_t^k\in SE(3) T t k ∈ S E ( 3 ) s t k ∈ R 3 s_t^k\in\mathbb{R}^3 s t k ∈ R 3
tracking 的基本关系是:
T t k = Δ T t k T t − 1 k , T_t^k=\Delta T_t^kT_{t-1}^k, T t k = Δ T t k T t − 1 k , Δ T t k \Delta T_t^k Δ T t k
论文默认 articulated structure 已知或可被定义,且有初始 pose;它不是无初始化的 category-level detection。
输入可以是 point cloud / RGB-D,论文评价重点是连续帧的 per-part pose,而非只恢复整物体的一个刚体 pose。
4. 研究脉络
早期 category-level pose 方法多以单帧 canonicalization、segmentation 或 keypoints 为中心;这些方法在 articulated object 上容易忽略部件运动和时间连续性。
A-NCSH、CAPTRA、ContactArt、GAPS 等方法是本文主要比较对象;PPF-Tracker 的差异在于将点对不变性、时间 keyframe 和运动学 refinement 组合起来。
PPF 的优点是对刚体变换具有不变性,但普通 PPF 对所有点对等权;本文引入 weighted PPF,以提升具有判别力点对的作用。
论文把 tracking 放在 Lie group 上,而不是直接在欧氏向量里回归旋转矩阵,意图避免旋转正交性和数值不稳定问题。
5. 研究动机
作者的核心判断
部件 pose 的时间连续性应该成为显式先验。
keyframe 能把长序列拆成局部稳定的 temporal segments,减少累计误差。
articulated object 的部分运动受 joint axis 约束,单独优化每个部件会产生物理不一致。
我的分析
这篇论文的价值不只在一个 PPF 变体,而在于把“几何不变性、时间记忆和结构约束”组织成层次化 tracking system。它更接近一个可解释的 optimizer / tracker,而不是完全 end-to-end 的 black-box estimator。
6. 方法详解
6.1 总体 Pipeline
根据动态 keyframe 把序列分成 temporal segments。
用 keyframe 的变换将 segment 中的点云映射到 quasi-canonical space。
对点云采样点对并计算 weighted PPF,使用 PointNet++ 预测每个部件的 SE(3)-invariant 参数。
通过 point-pair voting 恢复 translation / orientation,并预测 scale。
用 Lie algebra 表示增量,采用 exponential map 得到 Δ T t k \Delta T_t^k Δ T t k
用 geometry energy 和 joint kinematic energy 优化部件 pose。
当前帧如果与观测点云足够相似,动态 keyframe selector 将其设为下一 segment 的参考。
6.2 关键模块
模块 输入 输出 作用 与下一模块如何衔接 Quasi-canonicalization 当前点云、keyframe pose quasi-canonical point cloud 将局部 segment 对齐到稳定参考 提供给 PPF voting Dynamic Keyframe Selection 预测点云、观测点云 keyframe update decision 用 Chamfer + Hausdorff energy 判断是否更新 keyframe 决定下一段的 reference Weighted PPF sampled point pairs invariant features / votes 编码局部几何关系并抑制低价值点对 PointNet++ 预测参数 Lie algebra increment PPF predictions Δ ξ ∈ s e ( 3 ) \Delta\xi\in se(3) Δ ξ ∈ se ( 3 ) 在切空间建模旋转和平移增量 exponential map 回到 S E ( 3 ) SE(3) S E ( 3 ) Kinematics-aware optimization part poses、joint axes refined part poses 同时最小化几何和 joint consistency energy 输出最终每部件 pose
6.3 训练方式与监督信号
网络用 point-wise voting 的 KL divergence 监督 translation / orientation,scale 用 MSE,mask 用 BCE。
总损失为:
L t o t a l = 0.3 L t r a n s + 0.3 L o r i e n t + 0.2 L s c a l e + 0.2 L m a s k . L_{total}=0.3L_{trans}+0.3L_{orient}+0.2L_{scale}+0.2L_{mask}. L t o t a l = 0.3 L t r an s + 0.3 L or i e n t + 0.2 L sc a l e + 0.2 L ma s k .
运动学 refinement 使用几何能量 E g e o E_{geo} E g eo E k i n E_{kin} E k in E c o m p = E g e o + E k i n E_{comp}=E_{geo}+E_{kin} E co m p = E g eo + E k in
训练总 epoch 为 200,实验使用 RTX 4090;论文重新构造 PM-Videos,是因为 PartNet-Mobility 原始数据生成脚本和配置没有完全公开。
6.4 推理与工程复杂度
网络负责当前增量估计,几何 / 运动学优化负责结构化后处理。
动态 keyframe 能减少持续累积误差,但也引入 Chamfer / Hausdorff 计算和阈值 ϕ = 0.01 \phi=0.01 ϕ = 0.01
论文报告速度约 0.06–0.16 s/frame,取决于类别和部件数;这不是严格意义上的高帧率 tracker,但已接近交互式应用区间。
复现难点:PM-Videos / ReArt-Videos 的数据生成、部件与关节标注、点对采样策略和 energy optimization 的迭代次数。
7. 实验分析
7.1 数据集
PM-Videos :从 PartNet-Mobility 构建的 synthetic category-level articulated tracking dataset。ReArt-Videos :基于 ReArt-48 的 semi-synthetic tracking dataset。RobotArm-Videos :真实机器人 / 真实场景视频,包含 Box、Stapler、Cutter、Scissors、Drawer 等类别。
7.2 主结果
在 PM-Videos 上,论文报告 PPF-Tracker 在 Laptop、Eyeglasses、Dishwasher、Scissors、Drawer 等类别中通常取得最低 rotation / translation error 或最高 3D IoU。以 Eyeglasses 为例,平均 rotation error 约 3.3°、translation error 约 0.036 m,推理约 0.12 s/frame。RobotArm-Videos 上的 rotation error 为约 2.26°–19.43°,translation error 为约 0.002–0.155 m,类别难度差异明显。
7.3 消融实验
消融项 结果 是否充分 无 kinematic constraints rotation 约 8.6/9.1°、translation 约 0.109/0.122 m 与 full model 3.2/3.4°、0.038/0.045 m 对比,支持关节约束有效 无 keyframe error 最大 支持长期 tracking 需要局部参考 Fixed keyframe 优于无 keyframe,但弱于 dynamic 支持动态更新比固定更新更灵活 Dynamic keyframe 最佳 但阈值敏感性和跨物体泛化仍需更多实验
7.4 鲁棒性与失败案例
论文提供半合成和真实场景结果,说明从 synthetic 到 real 有一定泛化。
运动学约束可以抑制部件独立漂移,但当关节轴估计错误或部件大面积不可见时,错误可能被约束传播。
论文没有系统讨论初始 pose 大误差、关节拓扑未知、透明/反光材质和快速非刚体运动。
8. 批判性分析
优点
位姿增量定义在 s e ( 3 ) se(3) se ( 3 )
keyframe + motion increment + joint energy 的组合具有清晰的错误解释路径。
实验覆盖 synthetic、semi-synthetic 和 real-world,且报告速度。
缺点与隐含假设
初始 pose、部件结构和 joint information 的依赖较强,限制了完全开放场景使用。
论文重建了 PM-Videos,和已有工作使用的具体数据生成协议可能存在差异;公平比较需要重新运行代码。
运动学优化可能提高准确性,但也可能将错误的结构先验硬编码到输出中。
真实应用可行性
适合机器人中对已初始化的 articulated object 做连续 tracking。要用于从零检测,需要额外加入 segmentation、initial pose proposal 和结构识别模块。
9. 未来工作与可改进方向
将初始 pose proposal、part segmentation、joint discovery 与 tracking 统一。
用 uncertainty-aware PPF votes 表示遮挡和局部点云缺失。
研究 learned keyframe policy,而不是固定 energy threshold。
将 differentiable kinematic solver 与 end-to-end training 结合。
评估快速运动、关节摩擦、软体部件和未知拓扑下的失效模式。
10. 对我的研究的启发
可以借鉴动态 keyframe 和 s e ( 3 ) se(3) se ( 3 )
对 multi-object pose tracking,可将每个物体的局部 tracker 与 scene-level association 分离。
对实验设计,应报告 frame-wise error、cumulative drift、per-part consistency 和速度,而不只给单帧 ADD / IoU。
11. 待解决问题
初始化误差达到多大时 tracking 会失效?
动态 keyframe 的 energy 阈值是否需要针对类别和点云密度调节?
关节轴标签是训练时已知还是可从输入估计?
与 RGB-only articulated tracking 的公平比较应如何设置?