论文精读笔记:Comparative Evaluation of 3D Reconstruction Methods for Object Pose Estimation
1. 基本信息
2. 先给结论
这篇论文把“重建质量”从一个独立的 3D 几何问题,改写为 6D pose 系统中的资产质量问题:同一个 YCB-V 对象分别由多种 reconstruction method 建模,再替换 MegaPose / FoundationPose 的 CAD model,以固定 test images 和 BOP metrics 测量下游 pose。结果表明,常见 completeness、accuracy、PSNR 与人眼观感都不能稳定预测 pose AR;只有直接放进 pose estimator 才知道 reconstruction 是否保留了真正有用的几何与外观线索。
论文最值得保留的不是“某个 reconstruction 排名第一”,而是五条更稳健的结论:
CAD replacement 对部分对象可行 :简单、大型、Lambertian 物体的 reconstruction 有时接近 CAD oracle。整体仍有缺口 :最佳 reconstruction 相对 CAD 通常仍有约 10%–20% pose quality gap。经典 MVS 仍很强 :RealityCapture 速度快、少视图稳定,和强 neural methods 有竞争力;Nerfacto 也处于较好的准确率—耗时区域。资产不必视觉完美 :缺损 mesh 或错误 texture 只要保留 pose-discriminative parts,也可能支持好 pose。困难集中在特定对象属性 :小、反光、细纹理,以及采集实物与 legacy test texture 不一致的对象明显更难。
同时要看清 benchmark 的“CAD-free”边界:新采集图像确实用于生成部署资产,但 YCB-V CAD 仍用于 reconstruction evaluation、坐标注册和 CAD oracle;每个 reconstruction 还需要人工 coarse alignment 初始化 ICP。因此它评估的是“pose inference 时能否用 reconstruction 替换 CAD”,不是完整 onboarding 流程已经不需要 CAD。
2.1 论文图表导读
图表 主要变量 需要读出的因果边界 Figure 1 geometry metrics、MegaPose / FoundationPose AR、runtime、PSNR 指标相关但不等价;反例证明不能用单一 reconstruction metric 代理 pose Figure 2 uniform、small Lambertian、shiny groups 困难来自尺度、材质、细纹理和版本差异,不是“无纹理一律难” Figure 3 image count、pose AR、completeness、缺损 mesh 作者认为 75–100 张可得较好重建,不是所有方法都饱和;判别部位比完整性更重要
3. 研究问题与任务边界
3.1 为什么通用 pose estimator 仍被 CAD 卡住
FoundationPose、MegaPose 等方法已经能跨未见对象泛化,不需要针对每个测试对象重新训练;但它们的 render-and-compare、template generation 或 correspondence 往往依赖准确 3D model。工业 CAD、激光扫描或高质量手工 mesh 获取成本高,服务机器人也无法提前为所有可能遇到的物体准备 CAD。
另一方面,对新物体围绕拍摄 RGB images 较现实。于是核心问题不是“能不能重建一个看起来像的模型”,而是:
reconstructed asset → fixed pose estimator object pose accuracy \text{reconstructed asset}\quad\xrightarrow{\text{fixed pose estimator}}\quad
\text{object pose accuracy} reconstructed asset fixed pose estimator object pose accuracy 能否足够接近:
CAD asset → same pose estimator oracle pose accuracy ? \text{CAD asset}\quad\xrightarrow{\text{same pose estimator}}\quad
\text{oracle pose accuracy}? CAD asset same pose estimator oracle pose accuracy ? 3.2 Benchmark 的变量控制
论文希望变化的是 reconstruction method,而不是 pose estimator。核心控制包括:
固定 YCB-V 21 个对象与 test frames;
固定 MegaPose / FoundationPose checkpoint 与 inference;
reconstruction 全部注册到同一 YCB-V CAD coordinate frame;
reconstruction method 自带的 camera-pose refinement 被关闭,统一使用同一批 refined camera extrinsics;
CAD baseline 作为 Oracle;
评价统一采用 BOP protocol。
仍不能完全控制的变量包括:
RealityCapture 使用 RTX 3060 / Windows,其他方法多数单 A100;
各方法预处理、表示类型、meshing 和 texturing 路径不同;
某些 YCB 原对象停产,采集的是官方推荐 look-alike;
ICP 有人工初始化;
implicit rendering 与 mesh rendering 的计算路径不等价。
3.3 主集合属于什么 pose 任务
instance-level :21 个 YCB-V 具体对象;seen asset at inference :每个对象都有 reconstruction 或 CAD;generalizable estimator :pose network 没有为这 21 个对象逐个训练;完整 6D pose evaluation :使用 BOP VSD / MSSD / MSPD,而非只评 orientation;RGB / RGB-D 双路线 :MegaPose 使用 RGB,FoundationPose 使用 RGB-D;研究对象是 asset,不是 estimator architecture 。
4. Benchmark 数据构建
4.1 为什么需要重新采集,而不能复用 YCB-V 视频
YCB-V test images 为 pose estimation 设计,刻意包含 clutter、occlusion、复杂背景和有限目标像素;这些条件能考验 pose,但并不适合获得完整、高质量 3D reconstruction。若直接用 test video 重建,最终错误同时混合“输入数据不适合重建”和“reconstruction algorithm 不够好”,无法公平比较方法本身。
因此论文构建两部分数据:
Reconstruction component :新采集 object-focused、无遮挡、高分辨率、标定多视图;Pose component :继续使用成熟的 YCB-V / BOP test images 与 GT poses。
这样可以问:在给 reconstruction 相对有利的数据后,它生成的资产能否应对真正困难的 pose test scene。
4.2 采集硬件与轨迹
项目 论文设置 相机 Basler Ace acA2440-20gc 机械臂 7-DoF KUKA LBR IIWA 14 R820 相机安装 机器人法兰 图像分辨率 2448×2048 latitude 0°–150°,10° 间隔 longitude 0°–360°,10° 间隔 每对象图像数 397–505,平均 480 曝光 扫描期间固定 内容 整个对象在 field of view 中,无遮挡、object-focused 发布项 calibrated / undistorted images、object masks、3D reconstructions
相机位置按球面轨迹均匀分布,运动规划与碰撞避免使用 IIWA stack、MoveIt 与 CHOMP。
4.3 标定与外参 refinement
camera / hand-eye calibration 由 OpenCV 与 MoveIt 完成,论文报告误差可到 5 mm translation、0.1° rotation。机械臂 kinematic-chain extrinsics 仍会受 encoder noise 影响,尤其接近退化的伸展构型。
为给 reconstruction method 一致的 camera poses,作者做两阶段离线 refinement:
iNGP pose refinement;
COLMAP bundle adjustment。
之后 camera extrinsics 固定,关闭各 reconstruction method 自带的 pose refinement。这样避免某方法既优化 geometry 又额外优化 cameras,而另一方法只能接受原始 cameras,导致比较混入外参质量差异。
4.4 Look-alike replacement 与 domain mismatch
部分原始 YCB-V 商品停产,作者按 YCB benchmark 建议使用 look-alike alternatives。新对象与旧 CAD / test images 可能在 texture 和 scale 上不同,平均 scale change 为对象尺寸的 4%。作者选择保留采集对象的真实尺度,不强行缩放到旧 CAD。
这带来双重含义:
现实意义 :商品包装迭代很常见,资产更新系统确实会遇到 legacy image 与新物体外观不一致;因果混杂 :pose drop 不全来自 reconstruction algorithm,也可能来自实物版本变化。
论文通过 legacy / updated object group 分析部分隔离这一问题,但 benchmark 使用者仍应把对象版本记录为 metadata。
5. Benchmark Pipeline
5.1 Reconstruction
输入为 calibrated multi-view RGB、intrinsics、refined extrinsics 和 masks。输出可能是:
textured mesh;
colored mesh;
从 SDF / density field 提取的 mesh;
implicit representation 的直接 novel-view rendering。
论文在统一坐标与下游 pose 评价中尽量使用 mesh,因为现成 renderer 快。implicit direct rendering 作为额外对照:它可能保留 view-dependent appearance,但推理通常昂贵。
5.2 Mesh Registration
YCB-V GT poses 定义在原始 CAD coordinate frame。新采集场景中的 reconstruction 处于机器人 / world frame,必须求一个 rigid transform 才能用原 GT 评价。作者流程是:
人工给出 coarse alignment;
ICP 对齐 reconstruction 与 YCB-V CAD;
对齐后继续 crop 掉剩余背景。
这个步骤是 benchmark 最需要警惕的隐含人工环节。若目标是部署时完全去 CAD,必须另找 canonicalization / reference registration 方案;本文没有解决该问题。
5.3 Pose Inference
用每个 reconstruction 替换 pose estimator 的 CAD model;
MegaPose 在 YCB-V RGB test images 上运行;
FoundationPose 在 RGB-D test images 上运行;
同一对象的 CAD 版本使用相同 estimator 得到 Oracle;
输出按 BOP format 评价。
Benchmark 关注的是相对下降:同一 pose estimator 使用 reconstruction 而不是 CAD 后,AR 损失多少,以及不同 reconstruction 的排序是否稳定。
6. 被比较的 Reconstruction 方法
6.1 Classical MVS
COLMAP
以 SfM / MVS 获得 dense point cloud,再做 Poisson surface reconstruction。作者使用默认 reconstruction 参数,并粗略 crop 房间背景。COLMAP 自身缺少目标所需的 texturing 路线时,论文比较发现 colored mesh 比外部 MVS texturing 更利于 pose,因此主结果采用 colored mesh。
RealityCapture
商业 MVS 系统,作者强调效率高。在 RTX 3060 / Windows 上运行,仍是最短 reconstruction time 之一,并且少视图表现稳定。它不是 neural method,却在 pose-oriented evaluation 中和强学习方法竞争。
6.2 Surface / SDF Methods
方法 代表性设计 进入 pose 的表示 UniSURF occupancy network 近似 surface extracted mesh NeuS 神经 SDF + volume rendering Marching Cubes mesh VolSDF density 由 SDF 约束 mesh MonoSDF 融合单目几何 / 深度 cues 约束 SDF mesh BakedSDF 在 VolSDF 基础上 baking mesh,并在顶点建模 view-dependent appearance baked mesh NeuralAngelo multi-resolution hash-grid 提高高分辨率 surface mesh
6.3 Radiance / Grid Methods
方法 代表性设计 关键工程点 iNGP hash-grid 加速 NeRF 同时评价 extracted / colored mesh 与 direct implicit rendering Nerfacto Nerfstudio 集成多项 NeRF 工程改进,含 adaptive sampling pose 表现强,但 direct rendering 下游很慢 Plenoxels 无 MLP 的显式 feature / density grid + spherical harmonics 训练较传统 NeRF 快 SplatFacto Nerfstudio 中的 splatting 路线 Figure 1 中 pose 表现较弱
论文说明:完整比较一批方法、只用一个 pose estimator,就大约需要 8 张 A100 连续 8 天 。这解释了为何 benchmark 选择代表方法而非声称穷尽所有 reconstruction。
6.4 Texturing 与 direct rendering
Learning-based mesh 的 face color 通过查询其网络获得;
RealityCapture 使用 proprietary texturing;
COLMAP 与 iNGP 主结果使用 colored mesh,因为 off-the-shelf MVS texturing 反而降低 pose;
iNGP 还测试 direct network rendering;
Nerfacto 若与 MegaPose 直接结合,论文报告单张 A100 每张 pose image 接近 2 分钟 ,说明高质量 novel-view rendering 目前未必适合 pose 的大规模候选渲染。
这揭示“重建 representation”和“pose renderer”之间的接口本身也是研究变量。mesh geometry 不够好,不代表 implicit rendering 没用;相反,漂亮的 PSNR 也不保证 render-and-compare 的 feature 对 pose 判别有效。
7. 评价指标
7.1 Geometry Completeness
从 reference CAD surface 采样点,对每个 reference point 找 reconstruction 上最近邻;最近邻距离小于阈值的比例即 completeness。它回答“真实表面有多少被重建覆盖”。
7.2 Geometry Accuracy
从 reconstruction surface 采样点,对每个 reconstructed point 找 reference CAD 最近邻;阈值内比例即 accuracy。它回答“重建出来的表面有多少真的靠近 reference”。
两者在 1 mm–2 cm 阈值范围画曲线。因为 mesh density 会改变最近邻统计,作者先 subsample 每个 reconstruction 到固定点数。
7.3 Appearance PSNR
论文用 rendered appearance 的 PSNR 评价 mesh 外观。但 PSNR 偏像素平均误差,不知道哪些纹理 / 边缘真正参与 pose disambiguation,也不一定对应 pose estimator 的 learned feature space。
7.4 BOP Pose Metrics
VSD
Visible Surface Discrepancy 比较 GT / predicted pose 下可见表面差异。它对对称、遮挡和可见区域更友好,论文把它与 global positioning / navigation 需求联系起来。
MSSD
Maximum Symmetry-Aware Surface Distance 测量对称等价下的最大表面距离。它对高曲率抓取区域的小位移敏感,适合判断 manipulation 风险。
MSPD
Maximum Symmetry-Aware Projection Distance 测量像素投影错位,和 AR / VR render alignment 更相关。
在多个 error thresholds 下计算 recall,再跨 threshold 和 test images 平均为每个指标的 AR,最后平均三项得到全局 BOP AR。
一个重要措辞修正:这些指标不是简单的 translation / rotation scalar error;它们把 pose 应用到 object model 后评价 surface / projection misalignment,并处理 symmetry。
8. 主结果:为何必须做 task-aware evaluation
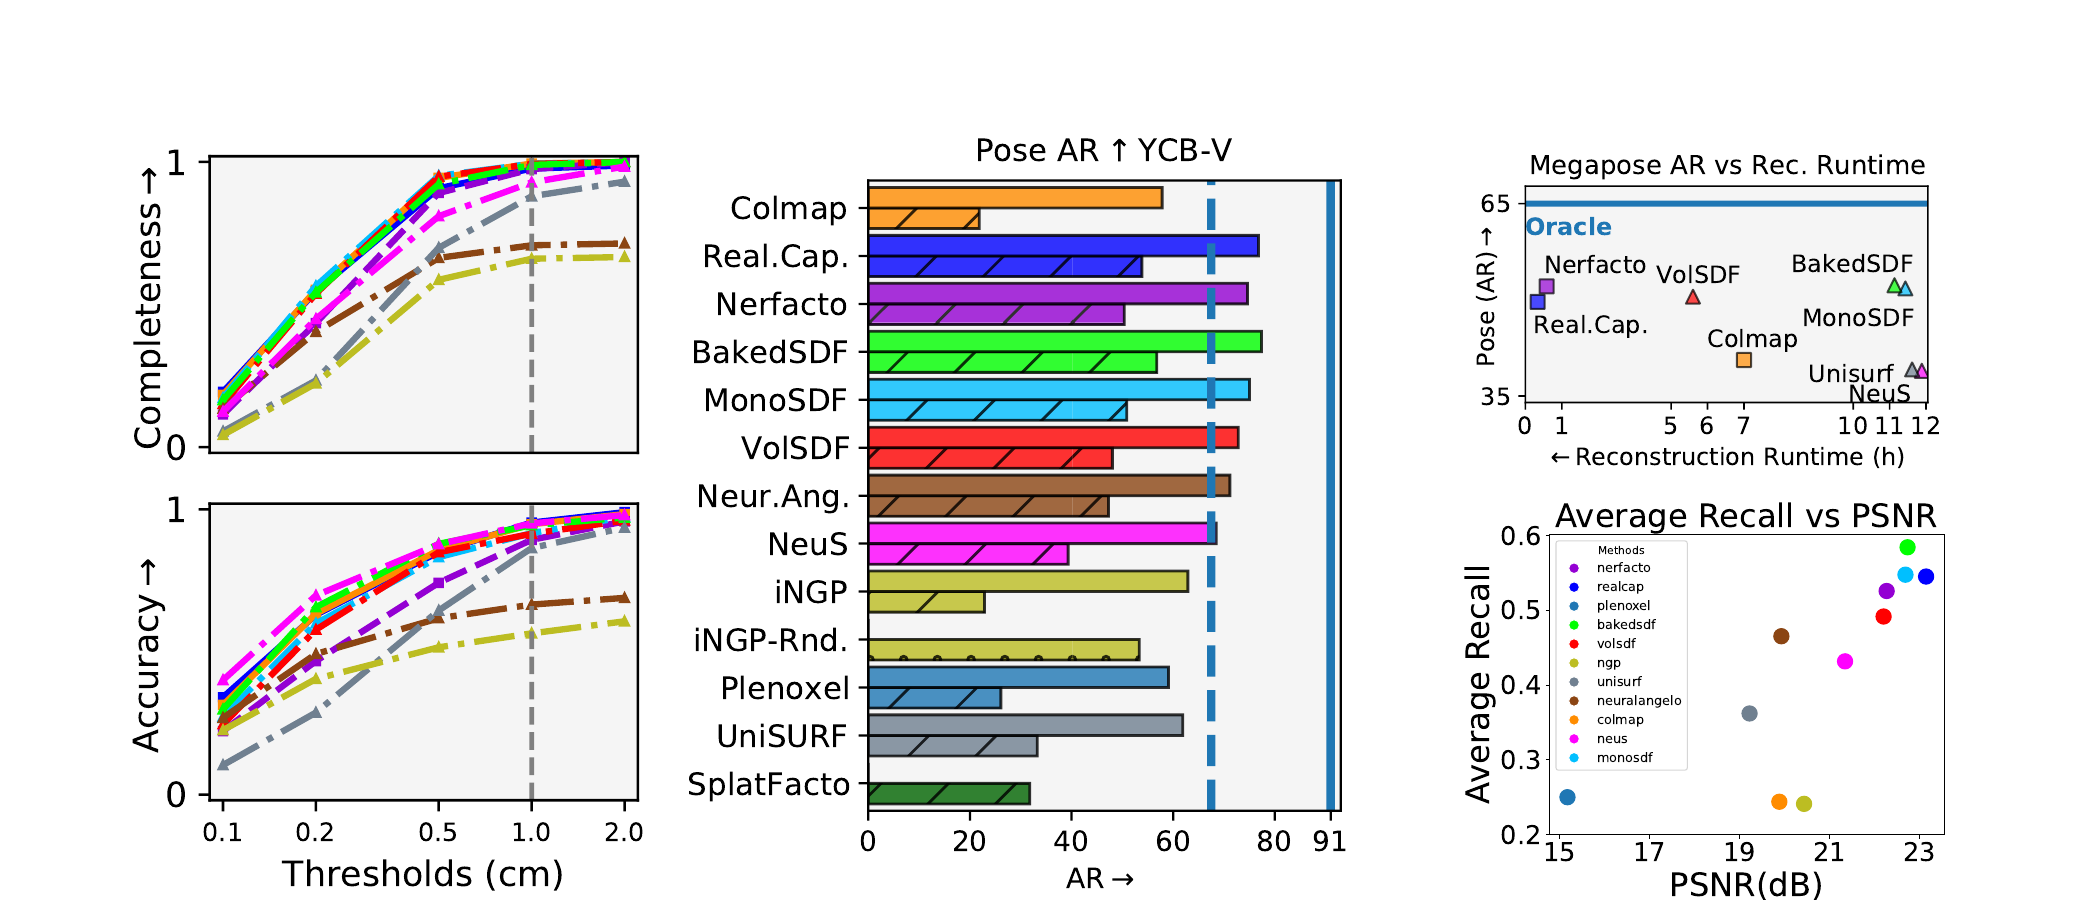
原论文 Figure 1:左侧 geometry completeness / accuracy,中间为 MegaPose(纹理 / 点状条)和 FoundationPose(实色条)使用重建资产后的 AR,右侧比较 reconstruction runtime、PSNR 与 MegaPose AR。该图的重点是排序不等价,而非只找一根最高柱。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8.1 CAD oracle 与重建资产的整体差距
Figure 1-center 中 CAD Oracle 位于最右的高 AR 位置;最强 reconstruction 仍普遍低于它。正文把这一差距概括为约 10%–20% 。这说明“现代重建的 geometry 常常足够”与“CAD 已可普遍删除”不能画等号。
更细地看,VSD recall 较接近 baseline,说明全局 object positioning 往往还能维持;MSSD 和 MSPD drop 更明显,分别暴露操作时的表面错位和视觉 overlay dissonance。
8.2 Geometry metric 的反例
论文不是只报告 correlation coefficient,而是列出排序冲突:
RealityCapture 与 BakedSDF 的 completeness / accuracy 接近,BakedSDF pose 略好;
Nerfacto geometry 比 MonoSDF 差,pose 却相近;
VolSDF 与 MonoSDF 几何曲线几乎重合,pose evaluation 能区分;
UniSURF 与 iNGP geometry 较低,这部分与 pose 较低一致。
因此正确结论是:geometry quality 对 pose 有必要的基础作用,但不足以形成稳定单调映射。重建误差发生在哪里,比平均覆盖率更重要;一个缺失大平面但保留独特边缘的 mesh,可能比几何更完整但抹平判别细节的 mesh 更适合 pose。
8.3 Appearance metric 的反例
RealityCapture PSNR 高于 BakedSDF,后者 pose 更好;
COLMAP 与 NeuralAngelo PSNR 相近,pose 差异明显;
iNGP direct implicit rendering 的 pose 表现高于 iNGP mesh rendering。
PSNR 对全部像素等权,pose estimator 则可能主要使用轮廓、局部纹理和合成—真实 feature consistency。高 PSNR 可能来自背景或大面积低频颜色拟合,并不保证 discriminative cue 被保留。
8.4 两个 pose estimator 的排序一致性
Figure 1-center 同时画 MegaPose 与 FoundationPose。尽管一个 RGB、一个 RGB-D,top-performing reconstructions 的相对排序大体一致。作者据此推测 reconstruction 进步可能普遍帮助 pose estimator。
本站更谨慎的解释:
一致性说明结论不完全是 MegaPose 特例;
但两个方法都属于 CAD / render-and-compare 范式,不能外推到所有 keypoint、coordinate regression 或 direct pose network;
若要证明跨 estimator universality,应加入不同表示与训练路线的更多方法。
8.5 Accuracy–runtime tradeoff
Figure 1-right 显示 RealityCapture 和 Nerfacto 处于较好的 pose AR–runtime 区域。RealityCapture 尤其值得注意:它运行在较弱 RTX 3060,却比多种单 A100 neural reconstruction 快很多。BakedSDF pose 较强但耗时明显更高。
这对部署意味着:若目标只是快速生成 pose asset,最先进的 neural rendering 不一定是最佳系统选择。应把 capture time、reconstruction time、meshing time、pose runtime 和最终 AR 放在一张 Pareto 图上。
9. 对象属性分析
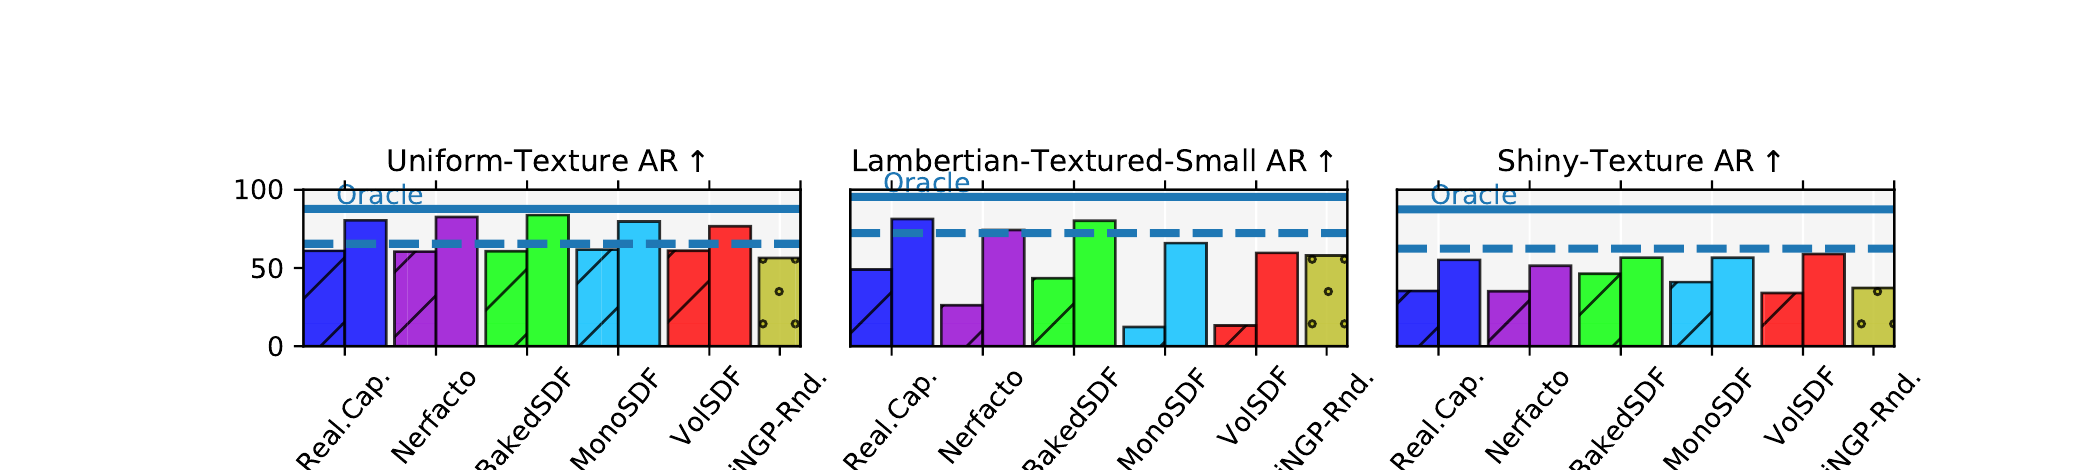
原论文 Figure 2:三类对象属性上的 MegaPose / FoundationPose AR。均匀纹理并不自动意味着 reconstruction 不能用于 pose;小型和 shiny objects 的下降更一致。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
作者按 shape、texture、material、采集实物是否与原对象变化,把 21 个对象分为 8 groups;正文 Figure 2 展示 3 组,其余在 supplementary。
9.1 大型、Lambertian、均匀纹理
这类对象有时接近 CAD oracle。原因不是“纹理不重要”这一普遍定律,而是在这些对象上:
geometry 较容易重建;
大尺度轮廓和表面足以约束 pose;
纹理本来就不提供很多额外 cue,因此 texturing imperfections 的损害有限。
这修正了“textureless object 一定最难重建资产”的直觉。对 pose 而言,稳定 geometry 可能比逼真纹理更关键。
9.2 小物体(≤8 cm)
小物体在固定图像分辨率下可用 texture texels 少,重建出的纹理分辨率低。若对象几何近似对称,细纹理又是区分 orientation 的主要证据,一旦被 blur / baking error 抹掉,pose 会产生对称混淆。
9.3 Shiny / reflective objects
反射外观随 viewpoint 变化,静态 UV texture 无法准确表示。按理 NeRF 类方法能表达 view-dependent effects,但 Figure 2 中它们没有稳定压倒 RealityCapture。作者据此认为 texture generation / downstream interface 仍有改进空间。
9.4 Legacy vs updated objects
某些 look-alike 的包装更新或材质变化导致 reconstruction texture 与 YCB-V test image 中旧版本不一致。论文观察 legacy objects 的 pose 更好,说明 appearance domain mismatch 是独立于 geometry 的资产风险。
9.5 没有统一赢家
在最难对象类型中,没有一个 top method 对其他方法形成稳定优势。不能简单写成“NeRF 解决反光”或“RealityCapture 最适合所有对象”。更合理的系统是先估计对象属性,再选择 reconstruction / rendering pipeline。
10. 图像数量与少视图重建
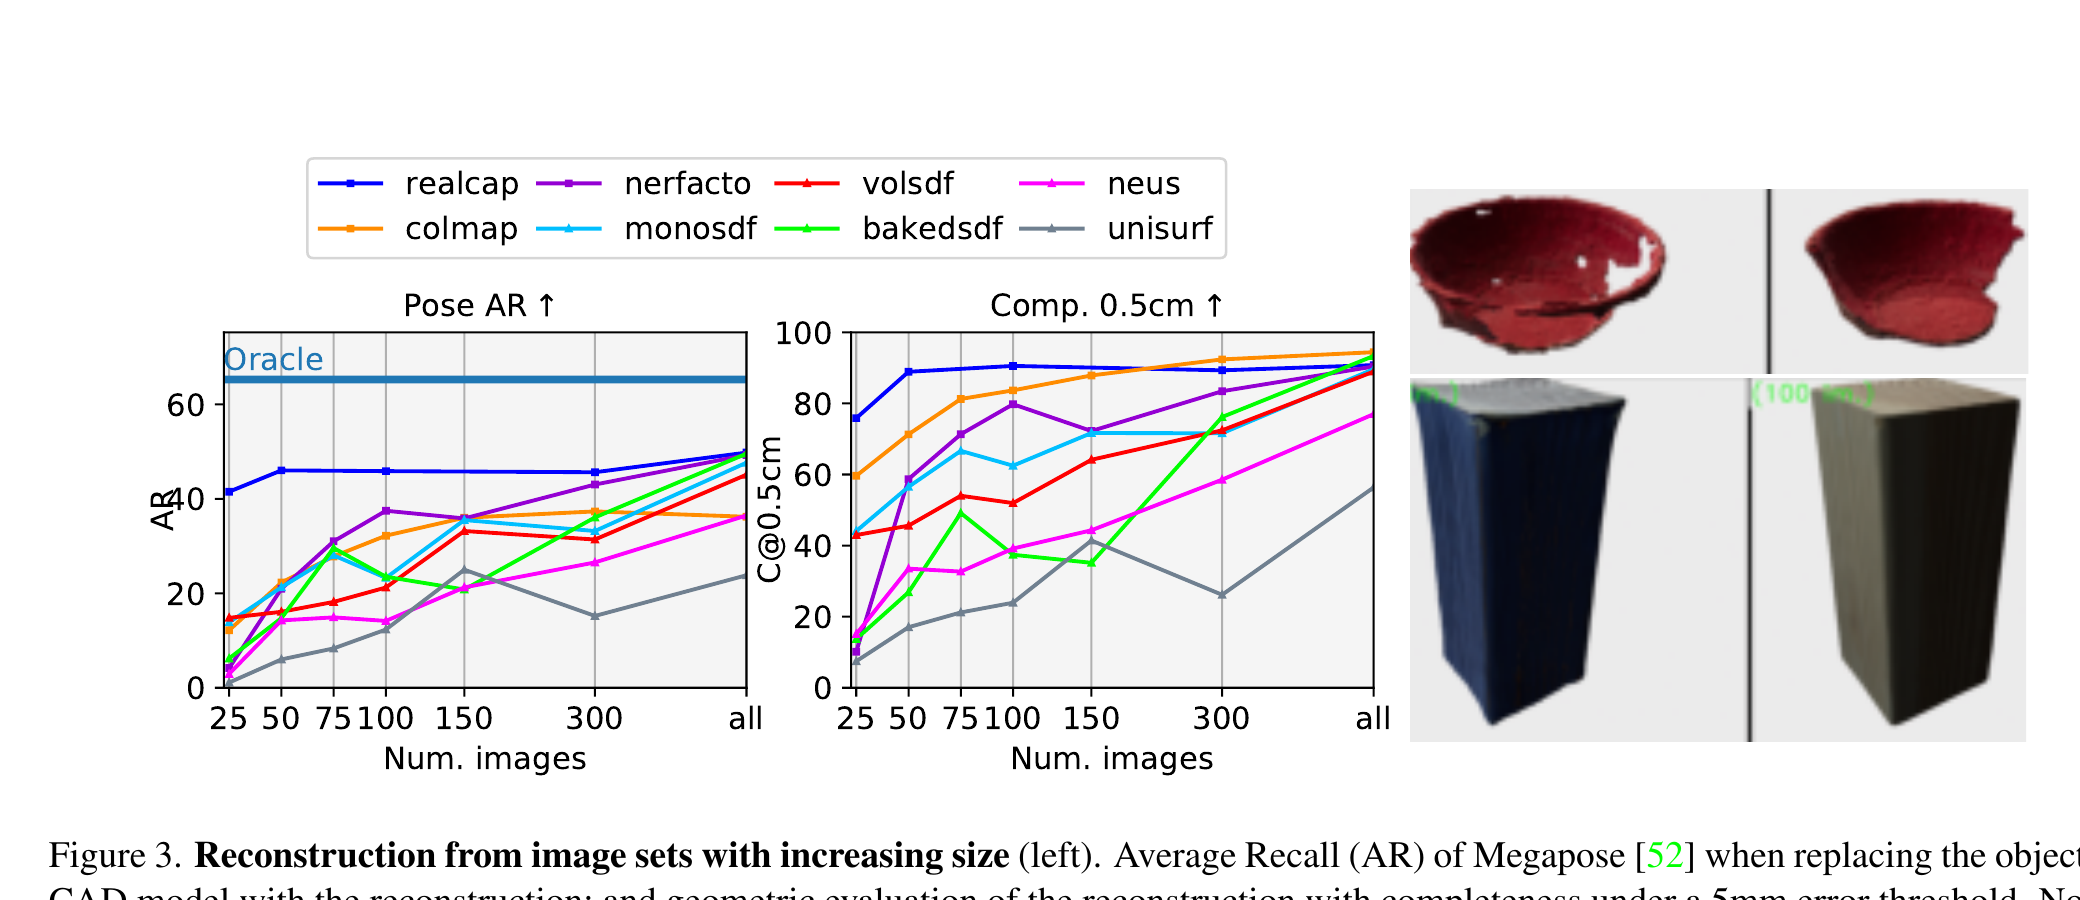
原论文 Figure 3:左侧从 25 到全部图像比较 pose AR 与 5 mm completeness;右侧展示不完整 bowl 和错误纹理 wood block 仍可能支持高 pose AR 的案例。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
10.1 数据量曲线
作者从球面轨迹均匀抽取 25、50、75、100、150、300 和全部图像重建。原文认为 75–100 views 已可获得接近最佳的重建;但 Figure 3 中部分 neural methods 的 pose AR 在之后仍明显提高,应理解为当前采集下的经验预算,不是普遍饱和阈值。
但曲线并非严格单调:
某些 neural methods 在 25 / 50 views 无法稳定收敛;
robot encoder noise 随机械臂构型变化,不是 i.i.d.;
加入某批 noisy camera poses 可能暂时损害 geometry;
pose AR 与 5 mm completeness 的变化也不完全同步。
因此“拍得越多一定越好”不如“挑覆盖好、外参可靠、信息增益高的视角”准确。
10.2 RealityCapture 的少视图效率
论文 Figure 3 caption 给出:
25 images:平均少于 1 min;
50 images:平均约 2 min;
pose performance 在图像数减少时相对稳定。
这使 RealityCapture 成为很强的 practical baseline。任何 neural reconstruction 声称适合 object onboarding,都至少应对比 25 / 50 / 100 views 下的 RealityCapture Pareto curve。
10.3 “视觉差”不等于“pose 差”
Figure 3-right 的精确例子:
两个 reconstructed bowls 都缺失部分表面,一个达到 CAD oracle performance AR=38,另一个只有 AR=15;
两个 wood blocks 达到 AR=39,高于该对象 CAD oracle AR=27,即使其中一个 texture 明显不正确。
论文解释为:只要 outer bowl edge 等 discriminative parts 被重建,pose estimator 仍可匹配;反之,mesh 全局更完整但关键 cue 丢失,pose 仍差。
CAD oracle 被 reconstruction 超过也不代表 reconstruction 比 CAD 更准确。可能原因包括:
reconstruction texture 更接近当前 test appearance;
CAD rendering 与真实图的材质 gap 较大;
estimator 对某种 artifact 产生偶然有利偏置;
对单个对象的样本波动。
应避免把个别 AR=39 > 27 外推成“重建普遍优于 CAD”。
11. 贡献是否被实验支撑
作者声称 对应证据 证据强度 本站判断 标准 reconstruction metrics 不能可靠预测 pose Figure 1 多组排序冲突 强 benchmark 核心结论成立 经典方法可与 neural reconstruction 竞争 RealityCapture 的 AR / runtime 与少视图曲线 强 对这套 YCB-V pipeline 成立 top reconstruction 排名在两个 pose estimator 上一致 Figure 1-center 中—强 支持跨两个 render-and-compare estimator,不宜外推所有方法 某些对象上 reconstruction 可替代 CAD Figure 2 组别结果、部分接近 oracle 中—强 对简单 / 大型 / Lambertian 组成立,不是普遍结论 最佳 reconstruction 与 CAD 仍有显著 gap Figure 1、正文 10%–20% 强 特别在 MSSD / MSPD 与困难对象上明显 作者认为 75–100 views 可得较好重建 Figure 3 多方法曲线 中 是当前受控采集的经验预算,部分方法继续提升,不能视为统一饱和点
12. 批判性分析
12.1 优点
下游任务定义正确 :不再假设 Chamfer / completeness / PSNR 自动代表 pose utility。变量覆盖完整 :同时考虑 geometry、appearance、pose、runtime、image count 和 object properties。固定强下游模型 :MegaPose + FoundationPose 避免 benchmark 只绑定 RGB 或 RGB-D。使用成熟 YCB-V / BOP test :不另造宽松 pose 测试,便于社区理解和复用。数据开放 :calibrated images、masks、reconstructions 与 code 支持后续方法接入。工程结论诚实 :经典 MVS、人工注册、不同硬件和少视图 failure 都没有被隐藏。
12.2 局限
仍依赖 CAD 注册 :没有解决新物体 canonical coordinate system 如何自动定义。人工 coarse alignment :大规模 onboarding 时会成为成本瓶颈,也可能造成 operator bias。21 个对象规模有限 :对象来自 YCB,缺少透明、大型工业、薄片、严重重复结构等类别。受控采集很理想 :无遮挡、固定曝光、完整物体、已知相机 pose,与机器人在线围绕杂乱物体重建差距大。look-alike mismatch 混入结论 :geometry method、texture update 与 scale variation 共同影响 pose。硬件和软件不完全统一 :runtime 不能被解释为纯算法复杂度。下游 estimator 范式相似 :两者都依赖 render-and-compare,对其他 pose family 的外推仍弱。统计区间不足 :主文图多为平均曲线,缺少 per-method uncertainty / repeated capture runs。检测依赖未进入分析 :benchmark 重点是 model-based pose,未把 object detector / segmentation failure 纳入 end-to-end 成功率。
12.3 隐含假设
对象可以从近完整球面无障碍拍摄;
机器人运动学和外参可离线校正;
object identity 已知;
有可用于 registration / evaluation 的 reference CAD;
实物在采集期间静止;
reconstruction asset 与 test 时对象版本相符或差异可接受;
pose estimator 能消费统一 mesh / rendering interface;
object masks 可得到;
reconstruction scale 可被保留或正确对齐。
12.4 结果中容易误读的三点
“Geometry 不重要”——错误
多数高 pose AR 方法也有较好 geometry,差的 geometry 常限制 pose。论文证明的是单一 geometry summary metric 不足以排序 task utility ,不是 geometry 可以忽略。
“75 张对所有方法都够”——错误
这是作者对受控球面采集的经验总结;图中部分方法在更多图像下仍明显改善。少视图分布、相机外参、对象材质和 reconstruction family 都会改变所需预算。
“CAD 已经可以删除”——错误
CAD 仍用于 benchmark coordinate registration,困难对象仍有 10%–20% gap。正确结论是“部分部署场景可用重建资产替代 CAD,并且 benchmark 提供了判断条件”。
13. 复现与扩展清单
13.1 数据采集
记录相机型号、lens、resolution、exposure、white balance;
保存 raw / undistorted images;
视角覆盖至少报告 latitude / longitude histogram;
同步保存 robot joint states 与 flange poses;
为每张图提供 object mask;
记录 legacy / updated product version、真实尺寸与材质;
对 transparent / reflective 额外记录 lighting setup。
13.2 Camera Calibration
单独报告 intrinsics reprojection error;
hand-eye calibration 报 translation / rotation error;
保存 refinement 前后 extrinsics;
所有 reconstruction 使用同一套固定 refined cameras;
对 camera-pose noise 做 controlled perturbation,避免只给最终最优版本。
13.3 Reconstruction 标准化
固定 foreground crop 和 mask;
记录每方法 input views、iterations、GPU hours;
区分 training / optimization、meshing、texturing、registration time;
mesh 统一单位和 scale;
geometry metrics 前固定 surface sample count;
保留 direct implicit rendering 与 extracted mesh 两条结果,不混为一个方法。
13.4 Registration
保存人工 coarse alignment;
报告 ICP residual 与 failure;
进行多初值测试;
若研究真正 CAD-free onboarding,必须增加无需 CAD 的 canonical registration 方法;
评价 registration error 与 pose AR 的敏感性。
13.5 Pose Evaluation
固定 MegaPose / FoundationPose version、checkpoint、detector 与 renderer;
CAD Oracle、每个 reconstruction 使用相同 test detections;
报 VSD / MSSD / MSPD 三项,不只报总 AR;
给出 per-object、per-property-group 与 aggregate;
把 pose runtime 与 asset construction runtime 分开;
检查 reconstruction mesh 是否因坐标 / scale 错误导致系统性失败。
13.6 统计
对 image-count sampling 重复多次,报告 mean ± std;
对 capture trajectory 做 bootstrap;
计算 Spearman / Kendall correlation,但同时保留排序反例;
对 object size、reflectance、symmetry、texture frequency 建立多变量回归;
把 updated-object domain mismatch 作为独立 covariate。
14. 可改进方向
14.1 学习 pose-aware reconstruction objective
当前 reconstruction 主要优化 photometric / SDF / geometric loss。可以把固定 pose estimator 的 feature matching 或 render-and-compare score 回传到 asset optimization,让模型优先保留 pose-discriminative edges、symmetry-breaking textures 和 grasp-critical surfaces。
风险是 overfit 某个 estimator。更稳妥的做法是联合多个 estimator 或使用任务集合:BOP AR、rendering fidelity、collision geometry、grasp contact error。
14.2 自动选择 reconstruction pipeline
先用少量 views 估计对象属性:尺寸、反光程度、texture frequency、几何对称性、视角覆盖;再选择:
Lambertian / textured:RealityCapture 或 COLMAP;
view-dependent appearance:NeRF / 3DGS direct rendering;
geometry-critical manipulation:SDF / depth-assisted reconstruction;
very small object:macro imaging / higher resolution / active view planning。
14.3 Active View Planning
Figure 3 表明数量不是唯一变量。可以根据当前 reconstruction uncertainty 和 pose utility,主动选择最能补全 discriminative parts 的下一视角,而不是均匀球面拍 480 张。
目标可写成:
v ∗ = arg max v E [ Δ AR p o s e ∣ v ] , v^*=\arg\max_v\;
\mathbb E[\Delta\operatorname{AR}_{pose}\mid v], v ∗ = arg v max E [ Δ AR p ose ∣ v ] , 而不是最大化全局 completeness。
14.4 CAD-free Canonicalization
真正去 CAD 需要解决:
新 reconstruction 的 metric scale;
canonical orientation;
object origin;
与 reference images / downstream robot frame 的转换;
symmetry group。
可通过 fiducial-free robot calibration、known support plane、gravity、category canonical prior、reference pose graph 或 multi-view foundation model 实现,并将 registration error 纳入 benchmark。
14.5 3DGS / neural renderer 接口
论文显示 iNGP direct rendering 可比 extracted mesh 更适合 pose,说明 meshing 会丢失有效 appearance。后续可比较:
3D Gaussian Splatting direct renderer;
distilled fast neural renderer;
mesh geometry + learned neural texture;
hybrid SDF surface + view-dependent appearance;
pose feature space 中的渲染,而非 RGB。
关键门槛是 candidate rendering speed:若每张 test image 接近 2 分钟,即便 AR 好也不适合大量 pose hypotheses。
14.6 资产级 failure predictor
在部署前预测某个 reconstruction 是否“pose-ready”:输入 geometry maps、novel-view consistency、feature render gap、object property 与 image coverage;输出不同下游任务的风险:
navigation-ready;
AR-ready;
grasp-ready;
not-ready / 需补拍。
这比单一 completeness threshold 更符合论文证据。
15. 对 6D Pose 网站与研究的启发
数据资产应单独建模 :pose 方法的上限不仅由 estimator 决定,还由 CAD、reconstruction、texture 与坐标注册决定。无 CAD 不是二元标签 :应拆成“无需 CAD 训练”“无需 CAD inference”“无需 CAD canonical registration”“仅需 reference images”。本文只解决其中一部分。指标要按下游任务选 :VSD、MSSD、MSPD 对 navigation、manipulation、AR 的含义不同,不能只保留总 AR。工程 benchmark 需要 runtime 与 image count :asset onboarding 成本是系统落地的重要组成。失败案例比漂亮 mesh 更有信息 :不完整 mesh 仍可 pose,说明研究应关注 discriminative geometry,而不是仅追求视觉完整。
16. 待解决问题
数据问题
21 个对象是否足以训练一个可靠的 pose-readiness predictor?
look-alike texture / scale mismatch 对每个对象具体贡献多少?
若使用原始 YCB-V 视频重建,性能会下降多少?
方法问题
direct neural rendering 的高 pose AR 来自 view-dependent appearance,还是 estimator feature 对 neural artifact 的偏好?
mesh simplification、UV atlas 与 texture resolution 对 AR 的独立影响是什么?
能否设计比 PSNR 更接近 pose utility 的 feature-space asset metric?
协议问题
人工 coarse alignment 需要多少时间,operator variance 多大?
ICP registration error 在 1–10 mm / 1–5° 时如何影响 BOP AR?
FoundationPose / MegaPose 使用的检测与初始化是否完全一致?
不同方法的失败对象是否一致,还是 aggregate ranking 掩盖互补性?
17. 总体评价
这是一篇对 6D pose 社区很重要的 benchmark 论文。它把“重建看起来更好”这种常见但不可靠的推理,替换为可复验的下游测量:固定 pose estimator,把 reconstruction 真正接进去。Figure 1 的多组排序冲突、Figure 2 的对象属性分桶和 Figure 3 的 image-count / failure cases 共同证明,pose utility 取决于 geometry、appearance、representation、对象属性和 renderer interface 的组合,而不是某个单一 reconstruction score。
论文没有宣告 CAD 已过时。相反,它精确定位了何时 reconstruction 能接近 CAD、何时仍有 10%–20% gap,以及为什么小、亮、细纹理对象和少视图 regime 仍是瓶颈。对于研究无 CAD pose、NeRF / 3DGS asset、机器人 object onboarding 或 synthetic render pipeline 的工作,这个 benchmark 应被视为比“展示 mesh + Chamfer / PSNR”更严格的实验范式。