论文精读笔记:RGBTrack
1. 核心判断
RGBTrack 的思路可以概括为:只要 CAD 的真实大小已知,对象在图像中的投影大小就为 camera-object depth 提供了单调约束;首帧用这一约束搜索 metric translation,后续局部 pose update 则可以让 FoundationPose 放弃不可靠 depth、只读 RGB。
论文还加入 XMem + Kalman + state machine,避免普通 FoundationPose 在遮挡 / 快速运动后继续用错误上一帧 pose 产生级联漂移。它是一篇低训练成本的系统改造,而不是新的 backbone。
2. “Depth-free”成立的条件
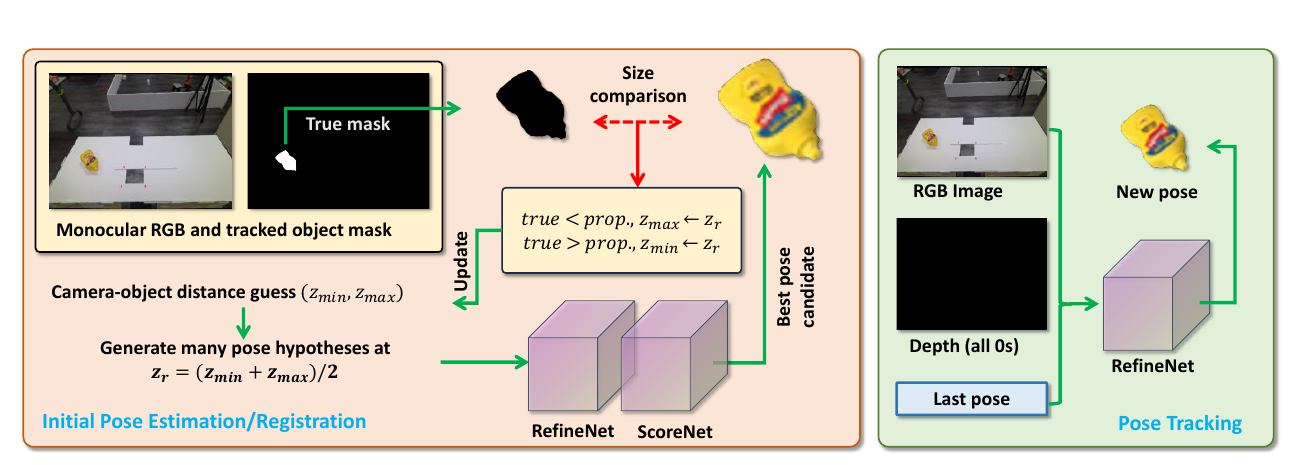 原论文 Figure 2。真实尺度 CAD 的投影面积约束首帧 depth;注册后,FoundationPose RefineNet 的 point-cloud 输入被全零替代。本站核对:图中面积比较后的上下界更新方向与正文及 Algorithm 1 相反;本文操作说明依照算法,原图按原样保留。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
纯 RGB 模式仍需要:
- 确定对象身份;
- 准确 CAD 几何与 metric scale;
- 首帧对象 mask;
- 相机内参;
- 包含真值的 [zmin,zmax];
- FoundationPose 预训练 RefineNet / ScoreNet;
- 后续 2D mask tracker。
因此,它不是 model-free,也不是任意单目视频中的 scale recovery。对新 CAD “无需重训练”是 FoundationPose 的 object generalization;对 metric translation 的约束来自已知 CAD 尺寸。
3. 首帧 RGB registration
FoundationPose 原本从 mask 内 median depth 得到
zc=median(depth[mask]),
再由 mask center (uc,vc) 与相机内参恢复
xc=fxz(uc−cx),yc=fyz(vc−cy).
RGBTrack 将未知 z 放在预设搜索区间。每轮:
- zr=(zmin+zmax)/2;
- 由 mask center 得到 xr,yr;
- 在该 translation 上采样旋转 hypotheses;
- FoundationPose RefineNet 逐个更新 pose;
- ScoreNet 选出 best pose;
- 按 best pose 渲染 CAD mask;
- 比较 rendered area 与 observed mask area。
若 rendered mask 更大,CAD 假设离相机太近,令 zmin←zr;反之令 zmax←zr。当 refiner 输出 depth 相邻迭代变化小于 10−2,或搜索区间宽度小于 10−2 时停止。
严格来说这不是纯粹的一维几何二分:每一轮 rotation 和 translation 都被神经 refiner 更新,mask 面积关于搜索中点未必始终严格单调。遮挡、截断、错误 mask 和 CAD 几何误差都会破坏“面积差只来自 depth”的假设。
4. 为什么不使用上一帧 rendered depth
一个直觉方案是:上一帧 pose 已知,先渲染 CAD depth,作为当前帧 FoundationPose 的 depth 输入。论文实验发现它会积累 drift:上一帧的 translation / rotation error 变成错误 depth,再影响下一帧 refiner。
RGBTrack 反而把后三个 point-cloud channels 全置零。FoundationPose RefineNet 原本分别编码 RGB 和 depth-derived point cloud,再做 weighted fusion;全零后只能依赖 RGB feature 与上一帧 pose 做相对更新。
这个做法简单但有效,也揭示出 FoundationPose 的 RGB branch 本身已具备较强局部 pose correction 能力。代价是:
- 当前帧没有独立 metric depth correction;
- 平移漂移只能依赖 RGB、mask 几何与 recovery;
- 大帧间运动仍可能超出 refiner basin。
5. Tracking-loss 状态机
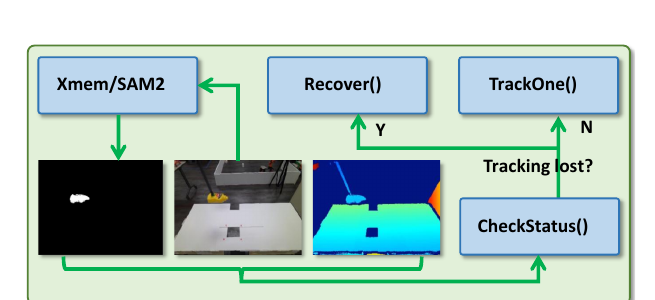 原论文 Figure 3。CheckStatus 在普通 TrackOne 与 Recover 间切换;XMem / SAM2 mask 同时提供目标区域与丢失信号。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
5.1 有 depth 时
以下任一条件触发 lost:
- 2D tracker 返回的 mask pixel count 低于阈值;
- mask + depth 得到的 coarse 3D center 与 FoundationPose pose center 的欧氏距离超过 θ。
丢失后 Kalman filter 预测 translation 与 rotation;系统不再做完整 252 候选 registration,而是在预测旋转附近采 20 个 hypotheses,经 RefineNet / ScoreNet 选出候选。若新 pose 与预测 / 粗估一致,切回 tracking。
5.2 无 depth 时
无法比较三维中心,改用两项 image-space heuristic:
(u−up)2+(v−vp)2>θ1,
即当前 pose 投影中心偏离 2D tracker 中心;以及
∣Area(Mobs)−Area(Mrender)∣>θ2.
丢失时 Kalman 粗预测 z 和 rotation,在附近采 20 candidates。论文没有列出 θ,θ1,θ2、mask-size threshold、Kalman noise 或状态切换 hysteresis 的完整敏感性分析,因此这些是复现和跨场景泛化的关键风险。
6. CAD scale recovery
若 CAD scale 错误,projection size 无法同时确定“对象大小”和“对象距离”。RGBTrack 的解决方式是首帧额外给 true depth,以 binary render-and-compare 搜索缩放系数。
- 有首帧 metric depth:可以恢复 CAD metric scale,后续纯 RGB tracking;
- 只有 ZoeDepth / Metric3D:只能在其预测的相对 / 偏移尺度中对齐,metric accuracy 没有保证;
- 完全无尺度信号:单目 RGB 与未知 CAD scale 存在不可辨识性,无法凭 mask 面积同时恢复两个未知量。
所以“unknown-scale CAD + RGB-only metric tracking”并未从物理上被完全解决;系统把 metric scale 先验压缩到首帧 depth。
7. 指标与评测
作者按 BOP 2019 误差族计算:
- VSD:可见表面差异;
- MSSD:symmetry-aware 最大表面距离;
- MSPD:symmetry-aware 最大投影距离;
- 三者多阈值 recall 的平均再取均值形成 AR / 表中 Rec。
同时报告逐序列 mean translation error(m)和 rotation error(degree)。由于这是视频 tracking,平均值包含完全丢失后的帧;这有利于反映 recovery,但论文未另报初始 registration 与 steady tracking 的分段误差。
8. YCBInEOAT 主结果
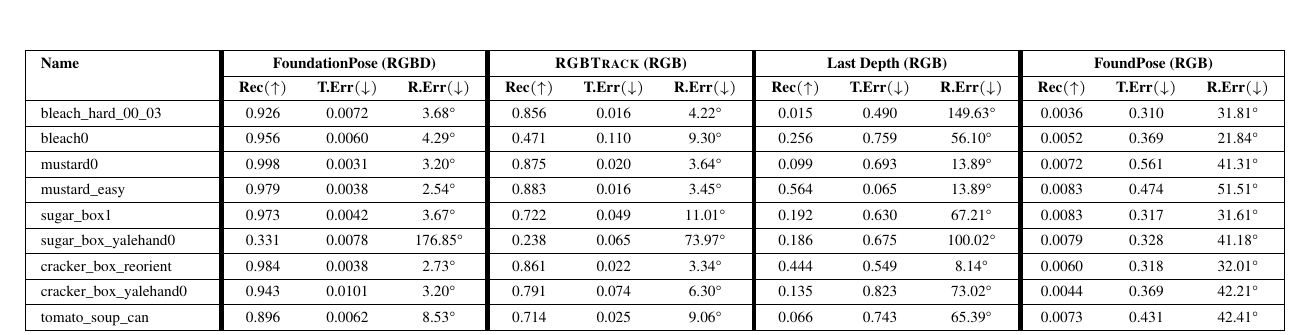 原论文 Table I。RGB-D FoundationPose 是良好深度条件下的上界型 baseline;Last Depth 验证错误 rendered depth 会累计;FoundPose 作为逐帧 RGB 模板匹配基线。来源:作者公开稿;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
代表序列:
| 序列 | 方法 | Rec ↑ | T.Err m ↓ | R.Err ° ↓ |
|---|
| mustard0 | FoundationPose RGB-D | 0.998 | 0.0031 | 3.20 |
| mustard0 | RGBTrack RGB | 0.875 | 0.020 | 3.64 |
| mustard_easy | FoundationPose RGB-D | 0.979 | 0.0038 | 2.54 |
| mustard_easy | RGBTrack RGB | 0.883 | 0.016 | 3.45 |
| cracker_box_reorient | FoundationPose RGB-D | 0.984 | 0.0038 | 2.73 |
| cracker_box_reorient | RGBTrack RGB | 0.861 | 0.022 | 3.34 |
良好 depth 下,RGBTrack 的 translation 明显落后 RGB-D FoundationPose,但 rotation 较接近。困难的 sugar_box_yalehand0 两者都失败严重:FoundationPose R.Err 176.85°,RGBTrack 73.97°,说明 RGB-only recovery 不能消除强手部遮挡 / 对称歧义。
Last Depth 在多数序列 translation 0.49–0.82 m、rotation 8–150°,支持“错误 depth 累积”判断。FoundPose recall 全部低于 0.01,但它是逐帧初始估计而非同等时序 tracking system,这个对比更多说明 coarse template pose 不能直接替代 tracker。
论文还展示坏 / 远距离 depth 时 RGBTrack 优于 FoundationPose 的定性例子,但没有构造按 depth noise / range 分桶的定量 benchmark,不能据此量化 RGBTrack 的传感器失效优势。
9. Recovery 实验与速度
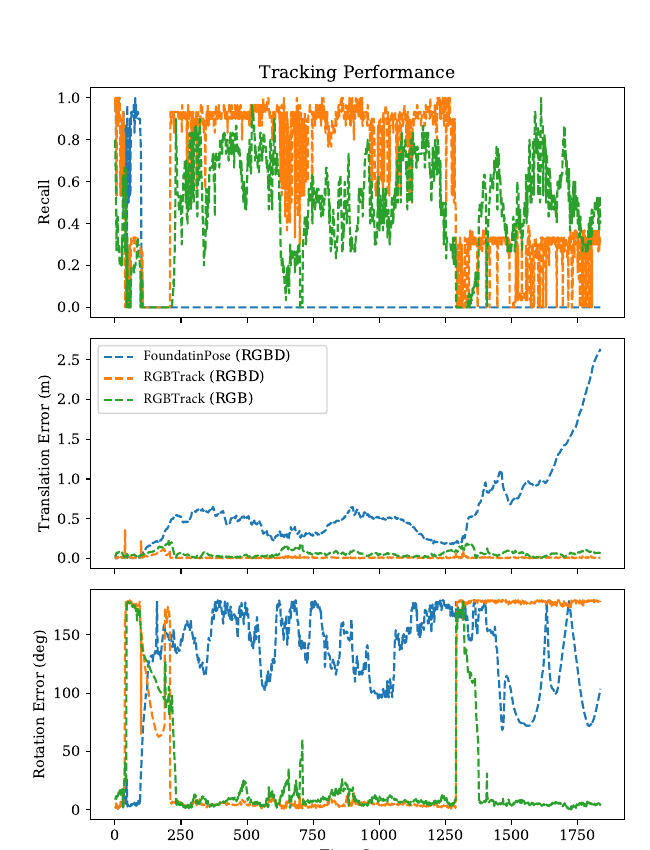 原论文 Figure 6:ClearPose set 8 scene 2 的 mustard bottle 长序列。蓝色 FoundationPose 丢失后 translation error 累积;带恢复的 RGB-D / RGB 版本能在多个区间重新捕获,但后段也存在不稳定。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
ClearPose set 8 scene 2,统计所有 opaque objects 和所有帧:
| 方法 | Recall ↑ | T.Err m ↓ | R.Err ° ↓ |
|---|
| FoundationPose | 0.0442 | 0.598 | 130.36 |
| RGBTrack + depth recovery | 0.616 | 0.0129 | 67.795 |
| RGBTrack RGB | 0.4682 | 0.0620 | 25.806 |
RGB-only 版本 rotation error 最低,但 depth-assisted 版本 recall / translation 更好;不存在一个版本在三指标都最好。更重要的是 recovery 定量只覆盖一个 ClearPose scene,作者也承认可用 CAD + 全程 pose GT + 遮挡的公开序列很少。因此这张表证明机制“可以恢复”,但不足以给出跨对象平均成功率。
RTX 3090、640×480、默认 refinement iteration:
- RGBTrack + XMem / Kalman / recovery:约 22 FPS;
- 原 FoundationPose:约 45 FPS。
约 2× 的速度代价来自 2D tracking、状态检查和候选恢复;论文未报告 registration 的二分搜索首帧总延迟,也未给 recovery 触发帧的最坏 latency。
10. Scale recovery 结果
实验将每个 YCBInEOAT CAD 人工放大 3×。不做恢复时,九段 Rec 全为 0。加入首帧 depth + scale search 后:
cracker_box_reorient:Rec 0.894,T.Err 0.0179 m,R.Err 3.353°;bleach_hard_00_03:0.853 / 0.0169 m / 4.18°;mustard0:0.726 / 0.0389 m / 3.60°。
但首帧有手遮挡的 sugar_box_yalehand0 Rec 0,cracker_box_yalehand0 仅 0.003,tomato_soup_can_yalehand0 0.299。mask 面积被遮挡后,scale 与 depth 二分会把“少看见的面积”误当作对象更远 / 更小。
11. 开源与复现
官方仓库当前可访问,包含:
run_demo_without_depth.py;run_demo_unkown_scale.py;run_demo_clearpose.py;- XMem 与 SAM2 submodule / wrapper;
- FoundationPose 派生实现和自定义 demo data。
README 仍把 SAM2 / TensorRT 部分列为 ToDo,同时依赖 FoundationPose、nvdiffrast、XMem、可能的 ZoeDepth / Metric3D 和多组模型权重。复现需重点核对:
- zmin,zmax 及单位;
- registration 252 个 rotation 的采样;
- 二分停止条件与 RefineNet 更新后 depth 的关系;
- θ,θ1,θ2 与 mask-area threshold;
- Kalman 状态、noise 和 20 candidates 分布;
- XMem 首帧 mask、遮挡后 template memory;
- CAD coordinate、metric scale、BOP symmetry annotation;
- 22 FPS 是否包含 mask network 和 recovery 帧。
12. 局限
- accurate-scale CAD 是纯 RGB metric pose 的必要条件;
- unknown scale recovery 仍需首帧 metric depth;
- mask area 对 depth、scale、遮挡、截断和 segmentation error 不可分辨;
- 二分搜索需要预先知道包含真值的 depth range;
- zero-depth tracking 缺少逐帧 metric correction;
- recovery 依赖 2D tracker,mask 跟错对象时状态机也会被误导;
- 只在一个 ClearPose scene 定量验证 recovery;
- 速度降至 FoundationPose 的约一半;
- 良好 depth 下整体精度仍不及 RGB-D FoundationPose。
13. 最终评价
RGBTrack 的贡献很务实:它发现 FoundationPose 的 RGB branch 可以在 point-cloud channel 全零时继续局部跟踪,再用真实尺度 CAD 的投影面积解决首帧 depth,并补上一套遮挡后的恢复状态机。代码公开、22 FPS 和 YCBInEOAT / ClearPose 结果使它具有较强工程参考价值。
最准确的定位不是“从 RGB 解决任意物体的 metric 6D pose”,而是“在已知尺度 CAD + mask 的约束下,把 FoundationPose 改造成可无深度运行并能主动恢复的 tracker”。如果 CAD scale 也未知,首帧 depth 依赖仍然存在;如果 mask / 2D tracker 不稳,系统的尺度与恢复判断都会一起退化。
