论文精读笔记:SAM-6D: Segment Anything Model Meets Zero-Shot 6D Object Pose Estimation
1. 基本信息
标题:SAM-6D: Segment Anything Model Meets Zero-Shot 6D Object Pose Estimation
作者 / 机构:Jiehong Lin, Lihua Liu, Dekun Lu, Kui Jia;DexForce Co., Ltd.、The Chinese University of Hong Kong, Shenzhen、South China University of Technology
年份 / 会议或期刊:2024 / CVPR
论文链接:arXiv:2311.15707
代码:GitHub
阅读模式:精读
2. 一句话定位
SAM-6D 将“给定目标 CAD、从杂乱 RGB-D 中找出所有目标实例并估计 R , t R,t R , t
方法输入与输出
项目 内容(本站整理) 推理输入 场景 RGB、depth、内参 K K K 最终输出 各目标实例的 mask 和物体到相机刚体变换 ( R , t ) (R,t) ( R , t ) x c a m = R x C A D + t x_{cam}=Rx_{CAD}+t x c am = R x C A D + t 训练输入 PEM 使用合成训练对象的 RGB-D、CAD 点云和 GT pose 构造点对及背景 / 无对应标签;ISM 使用预训练 SAM / FastSAM、DINOv2,不为测试目标训练分割器。 训练目标 学习 coarse / fine correspondence 与 background assignment,再用对应关系经 weighted SVD 求 pose。GT 对应和姿态是监督,不是测试输入。 输出细节 mask 位于场景图像坐标;R ∈ S O ( 3 ) R\in SO(3) R ∈ S O ( 3 ) t ∈ R 3 t\in\mathbb R^3 t ∈ R 3 必要条件 完整 ISM + PEM 可不依赖外部 mask;替换成外部 masks 的论文协议需要明确标注。目标 CAD、有效深度、标定与模板覆盖仍是部署条件。
2.1 论文图表导读
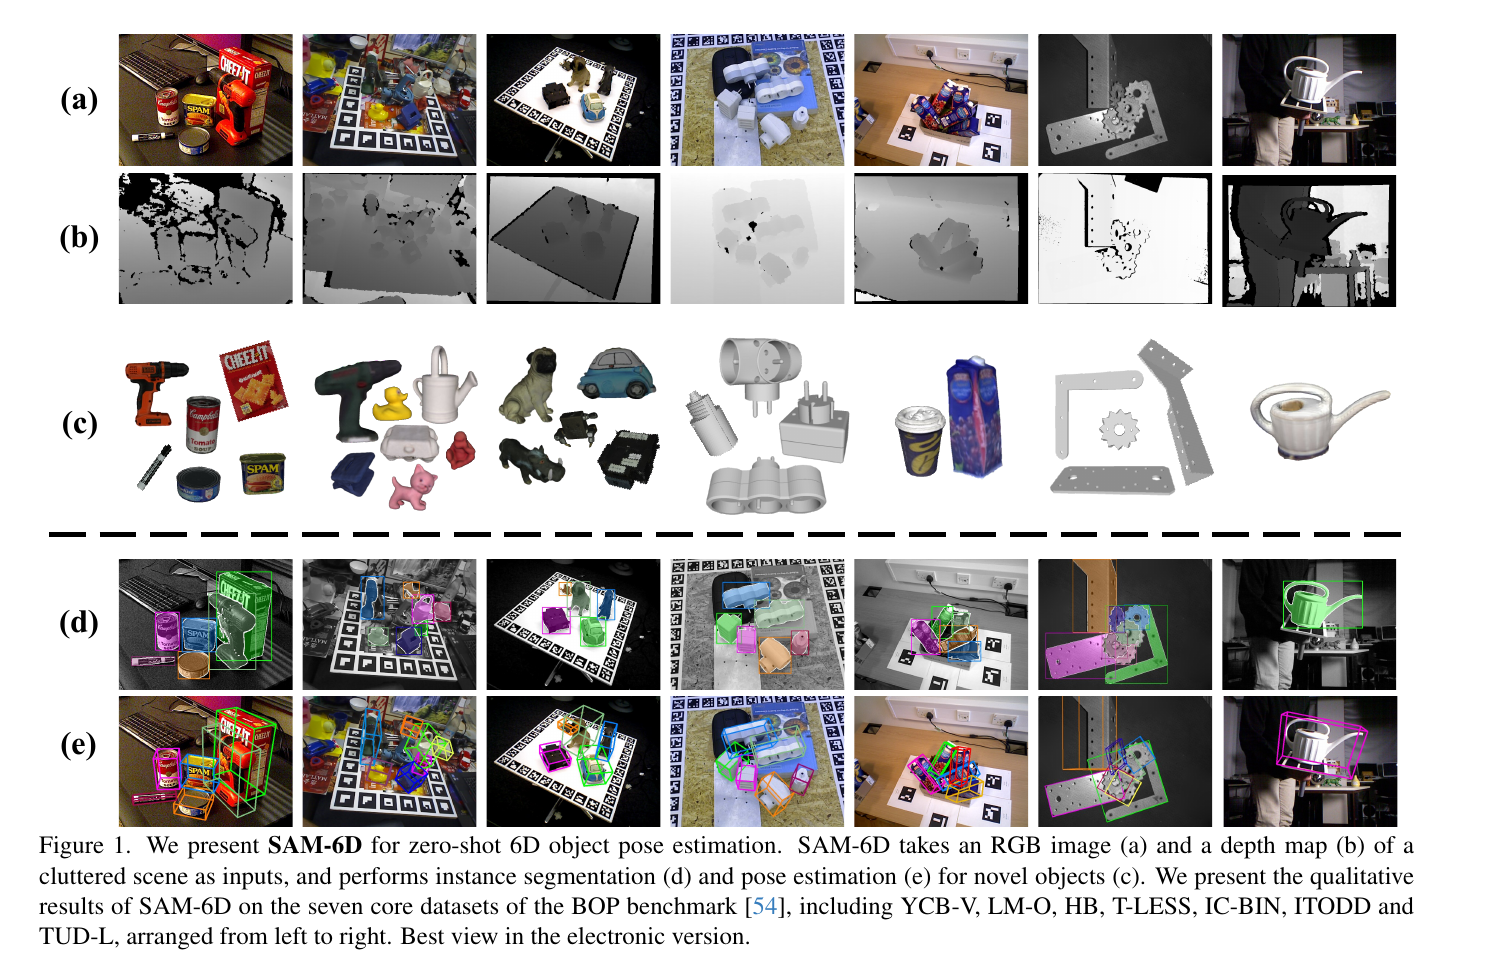
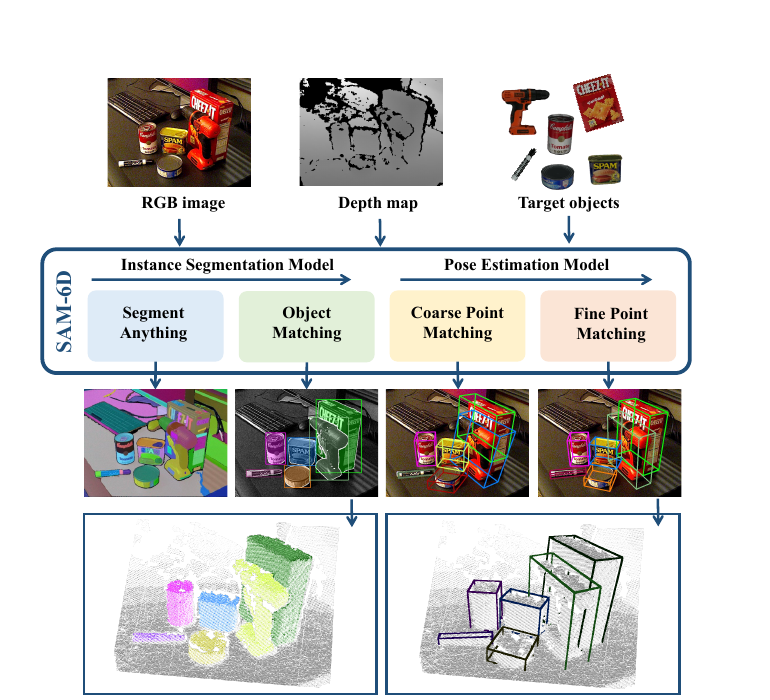
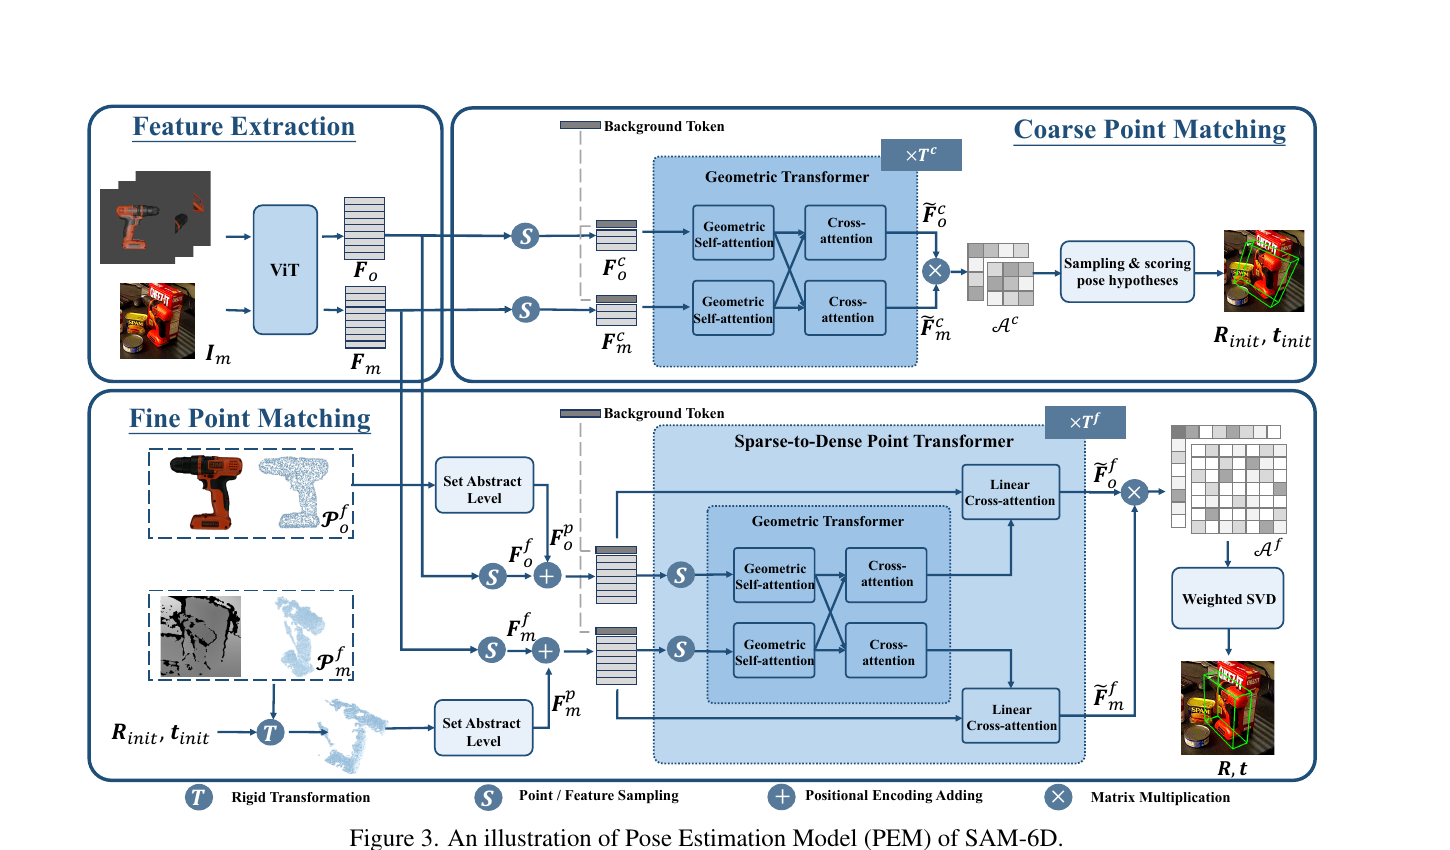
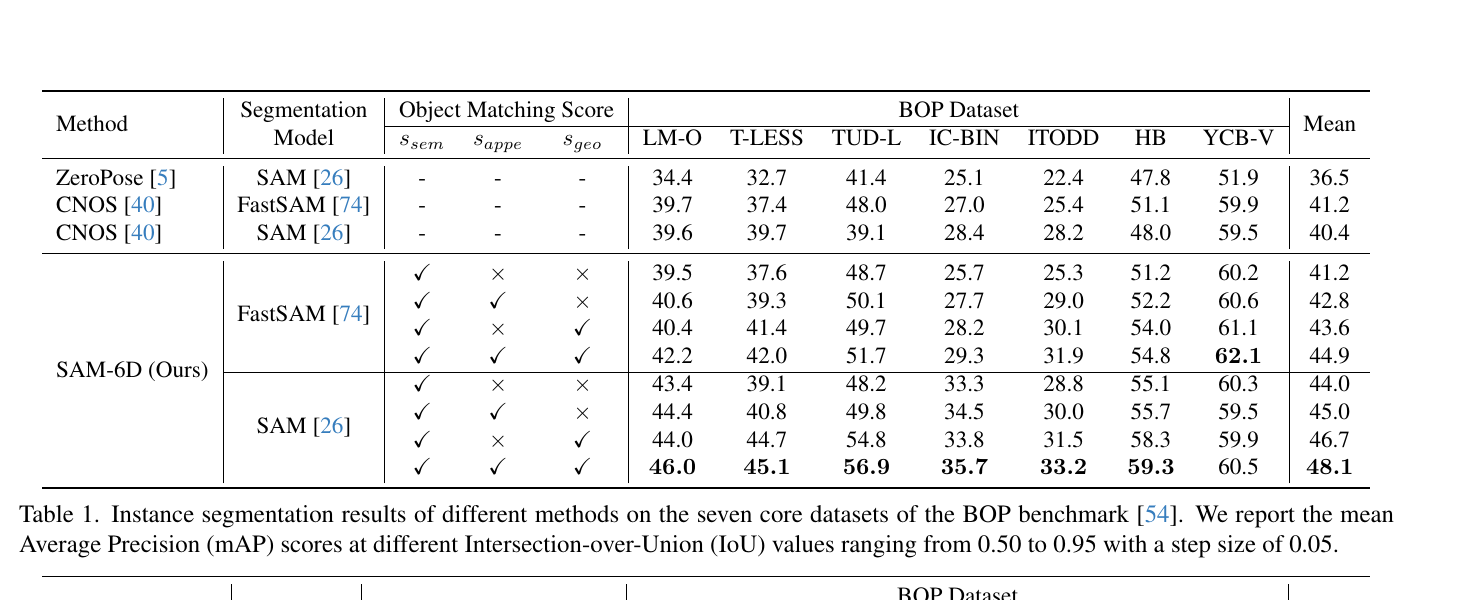
图表 在论文中的作用 本页阅读建议 Figure 1 BOP 七个核心数据集的定性结果 观察输入深度质量、mask 与 3D box 的关系 Figure 2 ISM 和 PEM 的总体数据流 把 CAD template 在前端筛选、在后端匹配的双重用途分开看 Figure 3 PEM 的特征、coarse matching、fine matching 对照下面的 196 点、2048 点、background token 与 SVD Table 1 ISM 评分项消融与 CNOS / ZeroPose 比较 看为何三类分数缺一不可 Table 2 七个 BOP 数据集 pose 结果 先按 mask 来源分组,再比较 AR Tables 3—6 PEM 与运行时消融 评估 background token、两阶段与 SDPT 的必要性
原论文 Figure 2:输入 RGB、depth 与目标 CAD templates。ISM 产出有效实例 mask,PEM 对每个 mask 建立点云对应并输出 pose。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题定义与任务边界
对一个刚体 CAD 点 x o b j x_{obj} x o bj
x c a m = R x o b j + t . x_{cam} = R x_{obj} + t. x c am = R x o bj + t .
输入 :场景 RGB I I I D D D K K K .ply mesh、RGB、depth、内参作为 demo 输入。输出 :每个检测到的目标实例的 mask、R R R t t t 测试对象 :目标实例对 PEM 的训练集而言未见,且不在测试时为该目标重新训练。这是 instance-level unseen-object 设置。不是类别级 :它不学习杯子、瓶子等类别共享的 NOCS;目标身份由该物体自己的 CAD templates 指定。不是 CAD-free 或纯 RGB :CAD、深度、相机内参和模板渲染是核心输入。把“zero-shot”理解成“没有对象专用训练”才准确。基本假设 :CAD 尺度和坐标系正确,深度与 RGB 标定一致,目标表面能在 SAM proposals 中被分出来,场景中至少有足够的可见区域支持 partial alignment。
4. 研究脉络
传统 BOP instance-level 方法通常为每个 target object 训练或渲染,且常在已给 detection / segmentation 的条件下评估 pose。
MegaPose、GigaPose 等 generalizable CAD-based 方法把网络训练从目标实例解耦,但实际系统仍取决于怎样得到目标 mask 或 bounding box。
CNOS / ZeroPose 尝试用 CAD renders、foundation model feature 和 SAM/FastSAM 做 novel-object detection;它们的重点在 semantic proposal matching,而非这一篇的 RGB-D pose 后端。
OVE6D 是与本文较接近的 zero-shot RGB-D pose baseline。SAM-6D 的补充材料在 LM-O 相同 masks 下报告 ADD(-S) 74.7,相比 OVE6D 的 56.1、OVE6D + ICP 的 72.8 更高。
本文的位置:将 open-set instance segmentation 与 RGB-D CAD alignment 合为一条可端到端运行的 novel-object pipeline;它不是“无先验”的开放世界 6D pose。
5. 为什么要这样设计
proposal 召回与目标确认是两件事。 SAM 擅长提出可分割区域,却不理解用户指定的 CAD 目标;只有全局 embedding 时又会把相似外观物体选进来。CAD-to-scene correspondence 是 partial-to-partial。 scene crop 因遮挡、mask 边界和传感器噪声而不完整;CAD 的背面同样在当前图像不可见。强制二者全匹配会制造错误刚体约束。稀疏全局匹配和稠密局部细化的预算不同。 直接让 Geometric Transformer 在 2048 点间全注意力代价高,只有 196 个点又会丢细节;因此需要从 sparse geometric reasoning 到 dense correspondence propagation 的桥梁。
6. 方法详解
6.1 总体信息流
将目标 CAD 从多个视角渲染成 template RGB / depth,论文使用 42 个 views。
SAM 或 FastSAM 从 scene RGB 产生 class-agnostic mask proposals。
ISM 为每个 proposal 对 templates 打分,留下属于目标的 masks。
对每个有效 mask,使用 K − 1 K^{-1} K − 1
PEM 先粗匹配、采样并评分 pose hypotheses,再以细匹配输出 correspondence matrix,用 weighted SVD 得到最终 R , t R,t R , t
模块 输入 输出 解决的问题 CAD template rendering target mesh、camera convention 多视角 RGB / depth templates、CAD points 给未知目标提供外观和几何先验 ISM proposal generation scene RGB class-agnostic masks 不为每个新对象训练 detector ISM object matching proposal、rendered templates target-instance mask 过滤非目标与无效 proposal PEM coarse matching partial scene / CAD points R i n i t , t i n i t R_{init}, t_{init} R ini t , t ini t 在大范围初值不确定时获得可用刚体假设 PEM fine matching 变换后的 points / features dense assignments、R , t R,t R , t 补足稀疏匹配精度并抑制遮挡区域
6.2 ISM:从 class-agnostic masks 到目标实例
SAM / FastSAM 给出所有物体候选。令 proposal 为 p p p { T j } \{T_j\} { T j }
语义分数 s s e m s_{sem} s se m :用 DINOv2 ViT-H 的 class token 计算 proposal 与 templates 的全局相似度,并取 top-K K K 外观分数 s a p p e s_{appe} s a pp e :比较 patch token,强调局部的纹理、边缘和零件外观。它可缓解“全局类别相近但局部细节不同”的混淆。几何分数 s g e o s_{geo} s g eo :取最佳 template 对应的粗 rotation,以 proposal 的平均 depth 和位置构造粗 pose;将 CAD 3D bounding box 投影回图像,与 proposal 2D box 的 IoU、可见比例等几何一致性共同评分。
这不是用该粗 pose 作为最终 pose,而是一个 proposal verification:一个貌似正确的 DINO match 若投影尺度或位置不合理,就不应进入 PEM。
原论文 Table 1:七个 BOP 数据集上的实例分割 mAP。SAM 版本从仅 $s_{sem}$ 的 44.0,加入 $s_{appe}$ 到 45.0,再加入 $s_{geo}$ 到 48.1;FastSAM 也呈现相同趋势。来源:论文 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
我的分析 :这张表支持“分数互补”而非“DINO 很强所以足够”的说法。尤其几何项带来 SAM 46.7 到 48.1 的增益,说明 CAD 的作用不仅是给 pose 后端,也能约束前端 false positive。相应代价是系统对深度尺度、内参和 CAD 尺度一致性更敏感。
6.3 PEM:带背景状态的 partial 3D-3D matching
将有效 mask 内的深度点回投影为 P o \mathcal{P}_o P o P m \mathcal{P}_m P m R , t R,t R , t
原论文 Figure 3:PEM 在 source 和 CAD feature stream 都附加 background token。coarse stage 通过 Geometric Transformer 构造候选 pose;fine stage 使用 SDPT 将稀疏匹配上下文传播给稠密点。来源:论文 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
feature extraction :以 ViT 提取 masked RGB crop 与 templates 的 multi-layer patch features;每个 feature 与通过 depth 得到的 3D position 配对。background tokens :在 observed stream 和 CAD stream 各接一个可学习 token。没有可靠对象对应的点可以指向 background,而不是被迫与某个实体点配对。双向 soft assignment :对 feature similarity 分别做 row-wise 与 column-wise softmax,并相乘形成 assignment score。它既鼓励每个 source point 的候选,也抑制多个点无约束地拥向同一 CAD point。weighted SVD :以 correspondence probability 为权重求两组点的加权中心和协方差,SVD 解出最优正交 R R R t t t
6.4 Coarse Point Matching
从两边各采样 196 points,经 Geometric Transformer 的 self-attention / cross-attention 获取结构化特征。
从 assignment 中抽样三点对应关系,构成并评分约 6000 个 pose hypotheses,选择最可信的 R i n i t , t i n i t R_{init},t_{init} R ini t , t ini t
三点可确定刚体变换的思想使它对局部错误具有一定容错,但前提是采样到的少数对应不退化且含有足够 inlier。
6.5 Fine Point Matching 与 SDPT
fine stage 取 2048 点,先以 coarse pose 变换 observed cloud,并以 multi-scale Set Abstract Level 编码相对几何位置。若直接以 Geometric Transformer 处理 2048 点,计算和显存不经济;若只保留 196 点,又不足以提供精确 correspondence。
SDPT 的做法是:在稀疏采样点上运行较重的 Geometric Transformer,然后用 linear cross-attention 将该几何上下文传播给稠密 features,最终获得 2048 点上的 assignment 并再次 weighted SVD。这是“sparse reasoning,dense readout”的折中。
6.6 训练和实现条件
PEM 训练数据来自 MegaPose 的 ShapeNet Objects 与 Google Scanned Objects 合成数据;训练约 600k iterations,使用 Adam、初始学习率 10 − 4 10^{-4} 1 0 − 4
训练时以真实 correspondence / background assignment 监督 attention,采用 cross-entropy / InfoNCE 风格目标;目标是把可见对应指向实体点,把 unmatched region 指向 background。
模板数不是无关实现细节:补充材料中,1、2、8、16、42 个 template views 的 AR 依次为 21.8、62.7、83.9、84.1、84.5。足够的 view coverage 是前端和后端共同的前提。
7. 实验设置与主要结果
7.1 数据集和指标
BOP core datasets :LM-O、T-LESS、TUD-L、IC-BIN、ITODD、HB、YCB-V,覆盖遮挡、多对象、纹理弱、工业件等条件。instance segmentation mAP :在 IoU 0.50 到 0.95、步长 0.05 的阈值上取 AP 平均,衡量 mask quality,而不等于 pose quality。BOP AR :VSD、MSSD、MSPD 三种 recall 的平均。VSD 更关注可见表面,MSSD 与 MSPD 对 3D / 2D 投影及对称性有不同处理;三者均值让单一误差类型较难主导排名。ADD(-S) :补充材料在与 OVE6D 对比时使用的模型点距离协议;不要与 BOP AR 混为同一个尺度。
7.2 主结果:必须按 segmentation protocol 分组
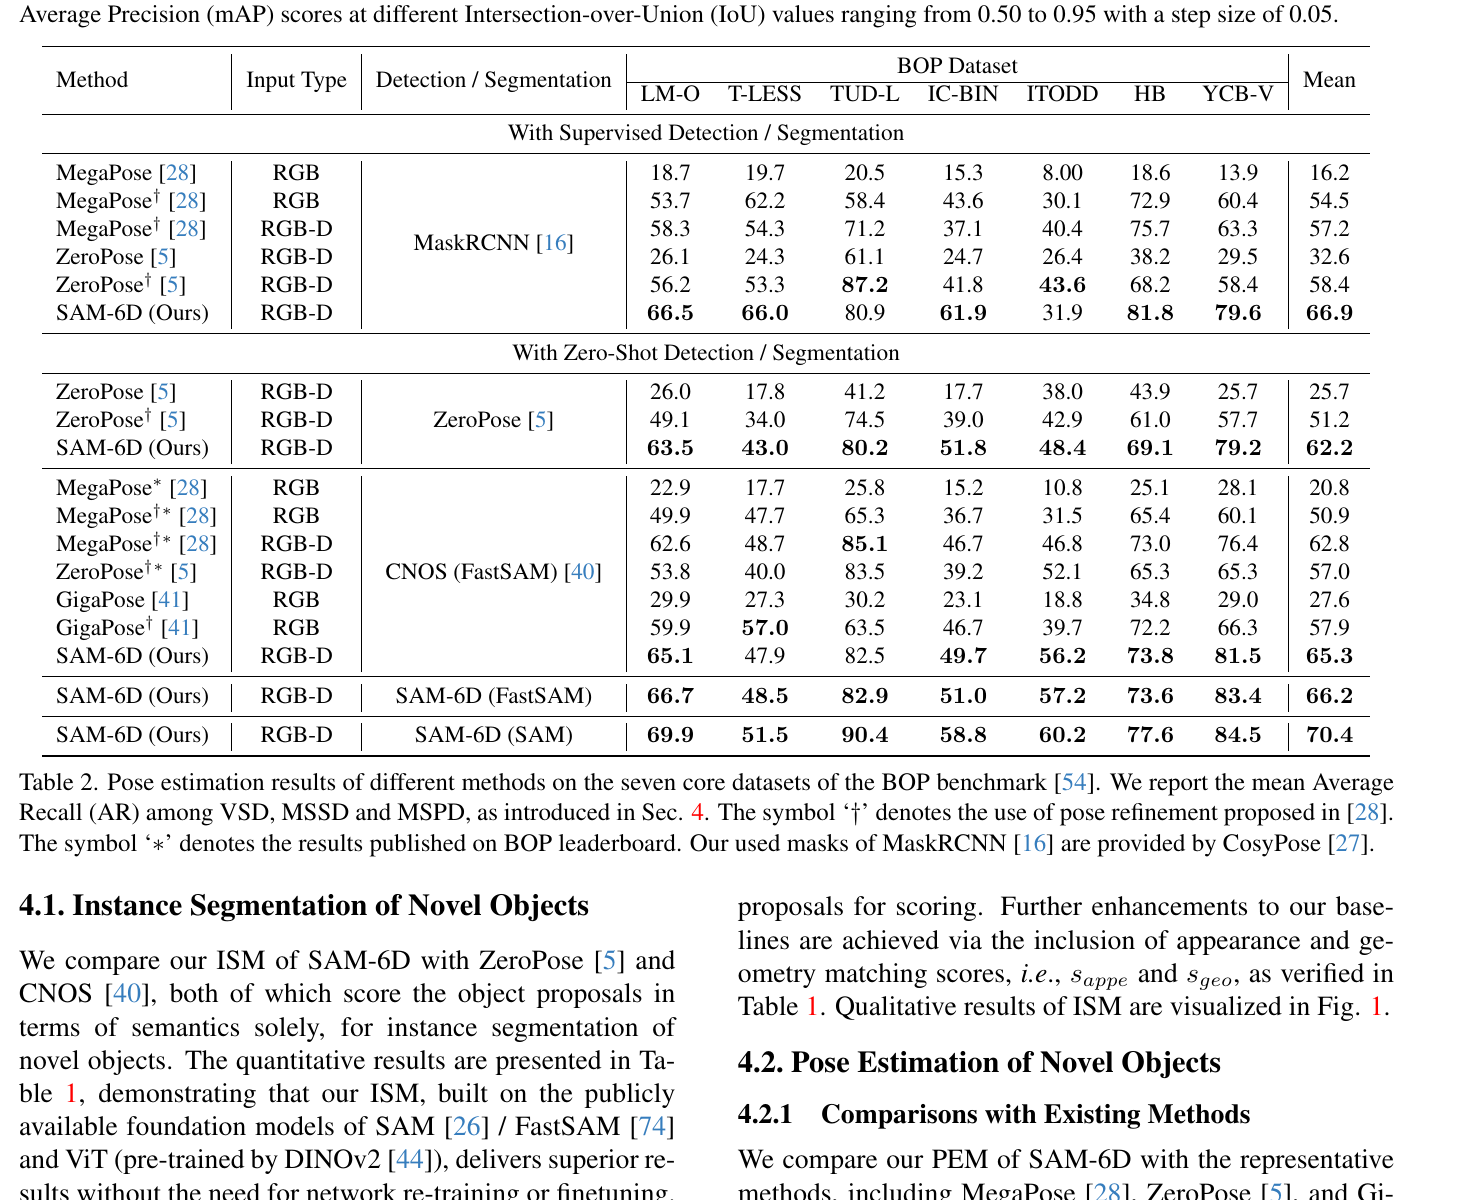
原论文 Table 2:七个 BOP 核心数据集上的 BOP AR。表格分为 supervised detection / segmentation、external zero-shot masks 和 SAM-6D 自带 ISM 三部分;十字表示使用 MegaPose 的 pose refinement,星号表示 BOP leaderboard 已发布结果。来源:论文 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
协议 SAM-6D 平均 AR 关键解释 MaskRCNN supervised masks 66.9 更接近 PEM 在高质量 mask 下的能力;与 MegaPose RGB-D 57.2、ZeroPose RGB-D 58.4 同表比较 ZeroPose masks 62.2 同一外部 mask 前端下,相比 ZeroPose + refiner 的 51.2 有明显提升 CNOS FastSAM masks 65.3 同一外部 zero-shot segmentation 下,与 RGB / RGB-D / refiner baseline 的输入条件仍不完全一致 SAM-6D FastSAM ISM 66.2 自带前端,强调快速版本 SAM-6D SAM ISM 70.4 论文最高完整 pipeline 数字;各数据集为 69.9 / 51.5 / 90.4 / 58.8 / 60.2 / 77.6 / 84.5
如何读 70.4: 它是 SAM-based ISM、RGB-D、CAD templates 与 PEM 的组合结果,不是“仅 pose backbone”的可迁移分数。相比使用 SAM-6D 的 SAM mask,FastSAM 版低 4.2 AR;这表明前端 mask quality 仍是系统上限的重要组成部分。另一方面,文中将监督 masks 与 zero-shot masks 分栏,是值得保留的评测透明度:不能把前端不同的 pose 数字混成单一 leaderboard。
7.3 设计消融与速度
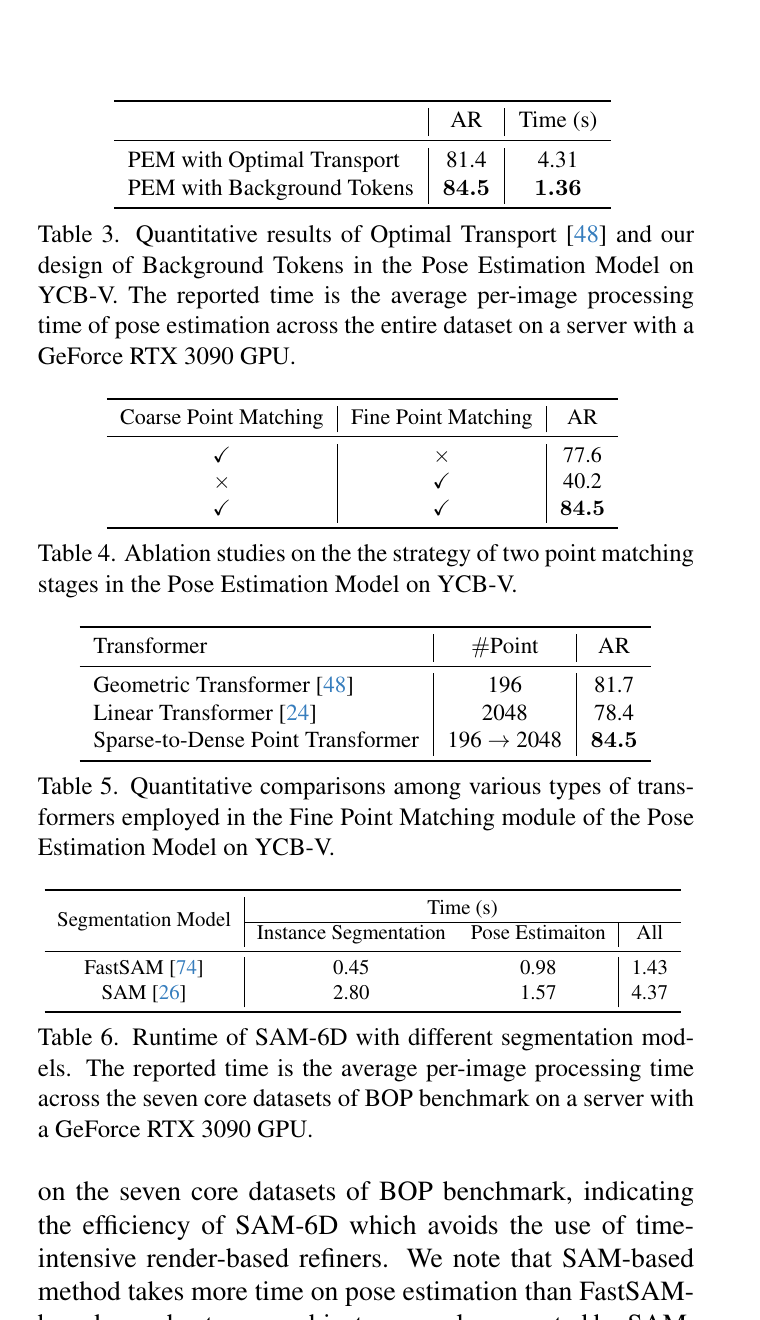
原论文 Tables 3--6:YCB-V 上的 PEM 消融和 BOP 七数据集上的平均运行时。background token、coarse-to-fine 和 SDPT 都有对应证据;速度在 RTX 3090 上统计。来源:论文 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
消融 结果 说明 optimal transport -> background tokens AR 81.4 -> 84.5 ;pose time 4.31 s -> 1.36 s 背景状态既避免强制错误匹配,也避免 OT 的高计算量 coarse only / fine only / both 77.6 / 40.2 / 84.5 AR fine stage 依赖 coarse initialization;coarse stage又缺少稠密精度 196-point Geometric Transformer 81.7 AR 全局几何上下文足够做初始匹配,但无法穷尽细节 2048-point Linear Transformer 78.4 AR 只求速度的稠密线性注意力会损失复杂几何关系 SDPT 196 -> 2048 84.5 AR稀疏几何 reasoning 加稠密传播是有效折中 FastSAM / SAM 全流程 1.43 s / 4.37 s 都不是高帧率实时配置,SAM 的 proposal 代价尤为明显
我的分析 :这些消融较完整地覆盖了 PEM 的三个主要设计,而非只展示最终架构。background tokens 的速度与精度双赢尤其有说服力。不过消融主要在 YCB-V,能否等比例迁移到 T-LESS 这类纹理弱、几何重复的对象,以及到失真更重的深度传感器,论文没有单独展开。
8. 鲁棒性、局限与公平性
8.1 对挑战条件的实际响应
遮挡 / partial observation :background tokens、双向 assignment、coarse hypothesis sampling 都是直接设计给 partial matching 的;这是 PEM 最有针对性的部分。mask noise :ISM 和 PEM 串联,且 Table 2 对比多个 mask source。自带 SAM ISM 高于外部 FastSAM masks,说明前端 mask 影响显著;但严重前端漏检没有后端补救机制。深度噪声与缺失 :论文将 observed cloud 作为 3D matching 输入,因而可从点级几何受益;同样也会受深度空洞、量化误差和 RGB-depth misalignment 影响。没有显式 uncertainty model。对称 / 弱纹理 :BOP 的 MSSD / MSPD 协议会处理对称性评估的部分问题,CAD 也提供了强结构先验;但方法没有单独设计 symmetry-aware correspondence 或 ambiguity distribution。透明 / 反光 :未提供专门传感器或外观模型。此类物体会同时削弱 SAM mask、DINO appearance 和 depth,属于实际部署的高风险域。
8.2 公平比较的边界
SAM-6D 拥有 RGB-D、CAD 和内参,不能与 RGB-only 或 CAD-free 方法只看一个平均 AR。
Table 2 中部分 MegaPose、ZeroPose、GigaPose 行标有十字,表示使用额外 pose refinement;有些行来自 BOP leaderboard。应当比较“输入模态、mask 来源、是否 refiner、是否 zero-shot segmentation”四个维度。
与 category-level 方法的“unseen”含义不同:这里是指定的新实例有 CAD 先验;类别级是同类未见实例但通常没有其 CAD。
结论 :作者“在 zero-shot RGB-D CAD pose pipeline 上强”的主张被 Table 1、Table 2 与系统消融支持;将其扩展为“通用无先验 6D pose 最优”则超出了证据。
9. 批判性分析
优点
任务边界清楚且系统完整:SAM 不再只是 demo 的分割器,而是与 CAD-aware matching 和 pose 后端形成真正可评测的 pipeline。
语义、外观、投影几何的组合让 CAD templates 同时服务“找对物体”和“算准 pose”,工程上很自然。
PEM 不直接回归 pose,而输出带 background state 的 point correspondences 后交给 weighted SVD,几何链路清晰,便于诊断与替换模块。
三类核心设计都有相应 quantitative ablation,且没有掩盖 SAM 与 FastSAM 的速度差异。
缺点
对目标 CAD 和 RGB-D 的依赖很强,导致它不能覆盖临时未知物、无深度相机或 CAD 不准确的实际需求。
42 个 templates 在补充消融中十分关键,暗示每个新目标的 mesh 清理、尺度确认、模板渲染和缓存成本不可忽略。
foundation model proposal 的错误会级联。前端高 precision 不替代高 recall;目标没有 proposal 时,后端的强 correspondence 无法挽回。
平均 1.43—4.37 s / image 更适合离线、低频抓取或候选排序,不直接满足高频视觉闭环。
隐含假设
CAD 的视觉外观与真实物体足够一致,或者 DINO 特征能跨过颜色、材质与光照差异。
目标在当前 RGB-D 中有足够可见且非退化的表面,能产生可靠的 3D correspondence。
深度尺度、内参、CAD units 和相机坐标 convention 彼此一致;任一环出错都会让 s g e o s_{geo} s g eo
10. 后续方向与研究启发
在 ISM 中显式预测 proposal confidence 与 failure type,并允许多假设目标 ID / pose 共同传入 PEM,减少 top-1 template selection 的早期承诺。
让 CAD templates 带 visibility、材质不确定性或 depth reliability,而不把全部 observed points 当等权对应;可将 background token 拓展为多种“缺失 / 遮挡 / depth invalid”状态。
以 RGB-only geometric foundation features、monocular depth uncertainty 或 sparse reference images 降低对消费级 RGB-D 和精确 CAD 的锁定。
将 SAM-6D 前端接入 tracking 与 active view selection:在低频全局重定位后,用时序约束维持 pose,减少每帧执行昂贵 proposal generation。
实验上应补充透明、镜面、错误 CAD 尺度、RGB-depth misalignment、极少 template views 和长尾小物体的压力测试。
11. 对我的研究的启发
可直接借鉴 :以 foundation segmenter 提供高召回 proposal,再通过 model-aware multi-evidence verification 提精度;partial registration 中加入显式 unmatched / background state;sparse geometric transformer 与 dense propagation 的算力分配。应加入的 baseline :若课题是 RGB-D、给 CAD、面向 unseen instance、需要自行分割的 6D pose,SAM-6D 应作为完整 pipeline baseline,同时报告 GT / supervised masks、外部 masks 与自有 masks 三种前端条件。复现实务 :官方仓库提供 SAM-6D / FastSAM 路径与 Docker;复现前先统一 BOP 模型单位、深度尺度、相机内参、CAD render convention,并分开 profile template generation、ISM 与 PEM。潜在切入点 :在不牺牲 CAD-aware 可信度的前提下减少模板数量和 SAM 时延;或将 uncertainty-aware correspondence 与追踪 / 多视角融合结合,处理单帧严重遮挡和低质 depth。