论文精读笔记:SecondPose
1. 核心判断
类别级 pose 的核心矛盾是:模型必须跨实例知道“哪里是杯子的正面 / 顶部”,又必须理解当前实例独有的几何。mean shape 路线把所有实例压成一个模板,遇到结构差异大的 camera、chair 或 household object 会失真;纯 DINOv2 语义又缺少精确 metric 3D geometry。
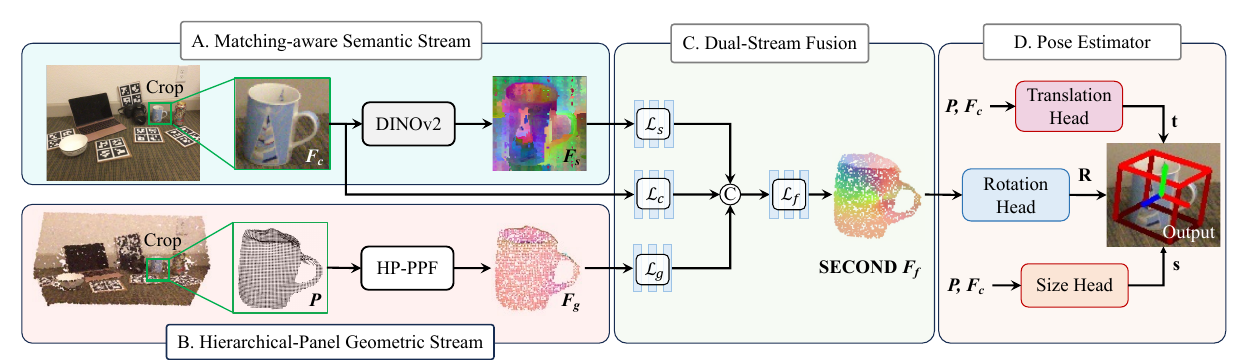
SecondPose 采用双流:
semantic stream :DINOv2 提供跨实例、跨视角语义对应;geometric stream :Hierarchical-Panel PPF 提供对象特定、局部到全局的 S E ( 3 ) SE(3) S E ( 3 ) fusion :两流逐点对齐,构造成近似随输入坐标变换保持一致的 representation。
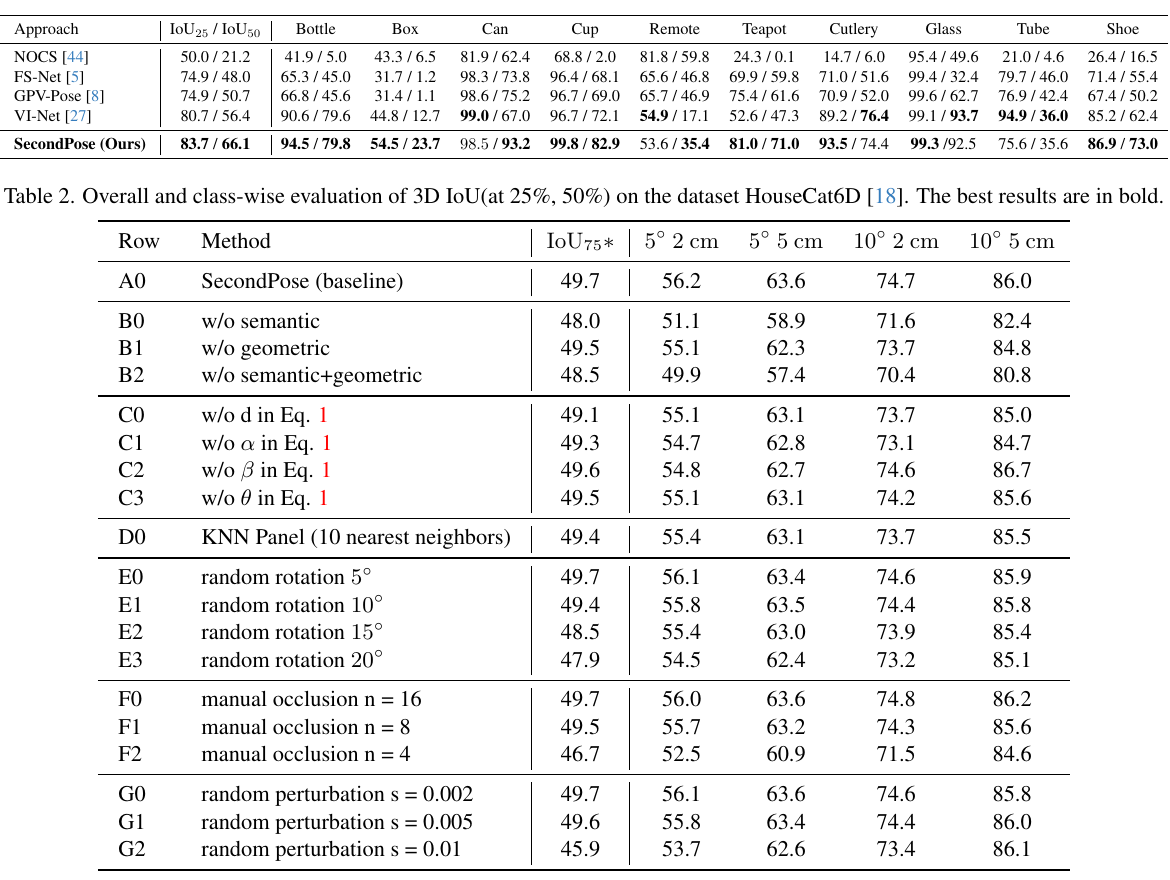
REAL275 的严格 5°2cm 从 VI-Net 50.0 提至 56.2;去掉 semantic 后降到 51.1,表明最大增益确实来自 foundation semantic prior,而不是只换了 point descriptor。
2. 任务与系统边界
输入流程:
Mask R-CNN 给对象 mask / bbox;
RGB crop 提取 DINOv2 patch features;
depth + camera intrinsics 反投影对象 point cloud;
每点附 RGB、radial distance、semantic feature 和 geometric feature。
输出是类别级 9DoF:
( R , t , s ) , R ∈ S O ( 3 ) , t ∈ R 3 , s ∈ R 3 . (R,t,s),\quad
R\in SO(3),\
t\in\mathbb R^3,\
s\in\mathbb R^3. ( R , t , s ) , R ∈ S O ( 3 ) , t ∈ R 3 , s ∈ R 3 . 类别在训练时已知,测试实例未见。方法不需要 test-instance CAD,也不需要 category mean shape;但依赖已训练类别、有效 depth 与前景分割。
3. DINOv2 作为“语义方向先验”
作者使用 DINOv2 第 11 层 token facet。深层 feature 比浅层 patch 更具类别和整体部件语义:例如杯柄、相机镜头、鞋尖可以帮助定义 canonical front / left / top。
这不是说 DINOv2 feature 对 rotation 数学不变。论文更准确的说法是,它对跨实例 semantic matching 与一定视角变化具有经验一致性。直接把 DINOv2 feature 与 xyz 拼接有两个问题:
DINOv2 只看 RGB,缺少 metric local geometry;
深层 feature 偏全局,细节被平滑。
因此需要第二条几何流补足局部结构。
4. Hierarchical-Panel Point Pair Features
对点云中 p i , p j p_i,p_j p i , p j n i , n j n_i,n_j n i , n j
f i , j = [ d i , j , α i , j , β i , j , θ i , j ] , f_{i,j}=
[d_{i,j},\alpha_{i,j},\beta_{i,j},\theta_{i,j}], f i , j = [ d i , j , α i , j , β i , j , θ i , j ] , d i , j = ∥ p j − p i ∥ , d_{i,j}=\|p_j-p_i\|, d i , j = ∥ p j − p i ∥ , α i , j = ∠ ( n i , p j − p i ) , β i , j = ∠ ( n j , p j − p i ) , θ i , j = ∠ ( n j , n i ) . \alpha_{i,j}=\angle(n_i,p_j-p_i),\quad
\beta_{i,j}=\angle(n_j,p_j-p_i),\quad
\theta_{i,j}=\angle(n_j,n_i). α i , j = ∠ ( n i , p j − p i ) , β i , j = ∠ ( n j , p j − p i ) , θ i , j = ∠ ( n j , n i ) . 若两点与 normals 一起接受相同刚体变换,上述距离和夹角不变,因此 descriptor 对 S E ( 3 ) SE(3) S E ( 3 )
单一局部 KNN panel 容易受 normal noise 影响,也看不到整体结构。SecondPose 对每个中心点按距离排序,分成由近到远的 support panels:
S i , m = { p j ∣ k m − 1 < r i , j ≤ k m } , \mathcal S^{i,m}=
\{p_j\mid k_{m-1}<r_{i,j}\le k_m\}, S i , m = { p j ∣ k m − 1 < r i , j ≤ k m } , 每个 panel 内平均 PPF,再跨尺度拼接:
f g i = f l i , 1 ⊕ f l i , 2 ⊕ ⋯ ⊕ f l i , l . f_g^i=
f_l^{i,1}\oplus f_l^{i,2}\oplus\cdots\oplus f_l^{i,l}. f g i = f l i , 1 ⊕ f l i , 2 ⊕ ⋯ ⊕ f l i , l . 近 panel 描述边缘、曲率与局部零件,远 panel 描述整体长宽和部件关系。相对固定 10-NN,5°2cm 从 55.4 提至 56.2,增益不大但稳定。
5. 双流融合与 pose head
原论文 Figure 2 的方法图。DINOv2 feature 与 HP-PPF feature 都对齐到 point samples;流专用模块 \(L_s,L_g,L_c\) 处理语义、几何和颜色,拼接后共享 \(L_f\) 得到 SECOND representation。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
SecondPose 以 VI-Net 为 pose estimator,将 point-wise feature 和点云投影到 spherical feature map。希望学习:
Φ : R n × 3 × R n × C → S O ( 3 ) , \Phi:\mathbb R^{n\times3}\times\mathbb R^{n\times C}
\rightarrow SO(3), Φ : R n × 3 × R n × C → S O ( 3 ) , 并满足:
Φ ( R x P , ψ R x ( F ) ) = R x Φ ( P , F ) . \Phi(R_xP,\psi_{R_x}(F))
=R_x\Phi(P,F). Φ ( R x P , ψ R x ( F )) = R x Φ ( P , F ) . 若融合 feature 近似 invariant:
ψ R x ( F ) ≈ F , \psi_{R_x}(F)\approx F, ψ R x ( F ) ≈ F , 则网络只需学习 point cloud rotation 与 output rotation 的 equivariant mapping,不必同时补偿 feature 自身随视角漂移。论文把这一性质称为 SE(3)-consistent,而不是严格群等变证明。
rotation network 与 translation-size network 分开训练;后者使用轻量 PointNet++ 和 L1 losses。实现采 2,048 points,几何 PPF 从中再采 300 points,以 10-NN 估 normals。
6. REAL275 主结果
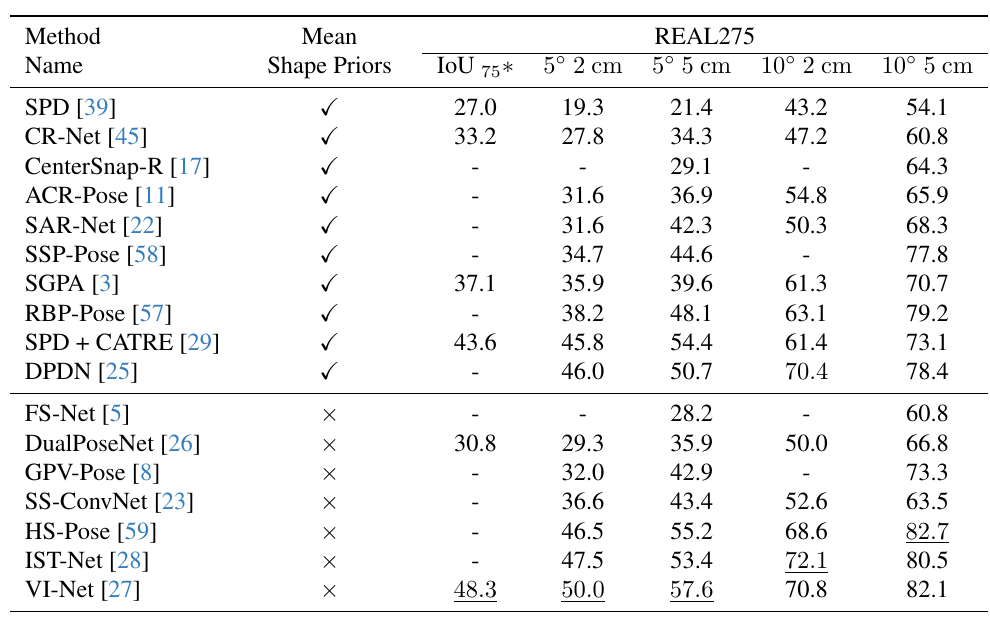
原论文 Table 1 的基线部分。上半是 mean-shape-prior 方法,下半是 prior-free 方法;当前截图未包含 SecondPose 行,其完整结果可由下附原 Table 3 的 A0 行核验。SecondPose 用 semantic prior 而非显式 shape prior。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
方法 IoU75 5°2cm 5°5cm 10°2cm 10°5cm DPDN — 46.0 50.7 70.4 78.4 HS-Pose — 46.5 55.2 68.6 82.7 IST-Net — 47.5 53.4 72.1 80.5 VI-Net 48.3 50.0 57.6 70.8 82.1 SecondPose 49.7 56.2 63.6 74.7 86.0
摘要所说的“12.4% leap”对应 5°2cm 相对 VI-Net 的相对提升,绝对提升是 6.2 points。网站读表应优先写绝对点数,避免相对百分比造成过大直觉。
7. REAL275 定性与表征贡献
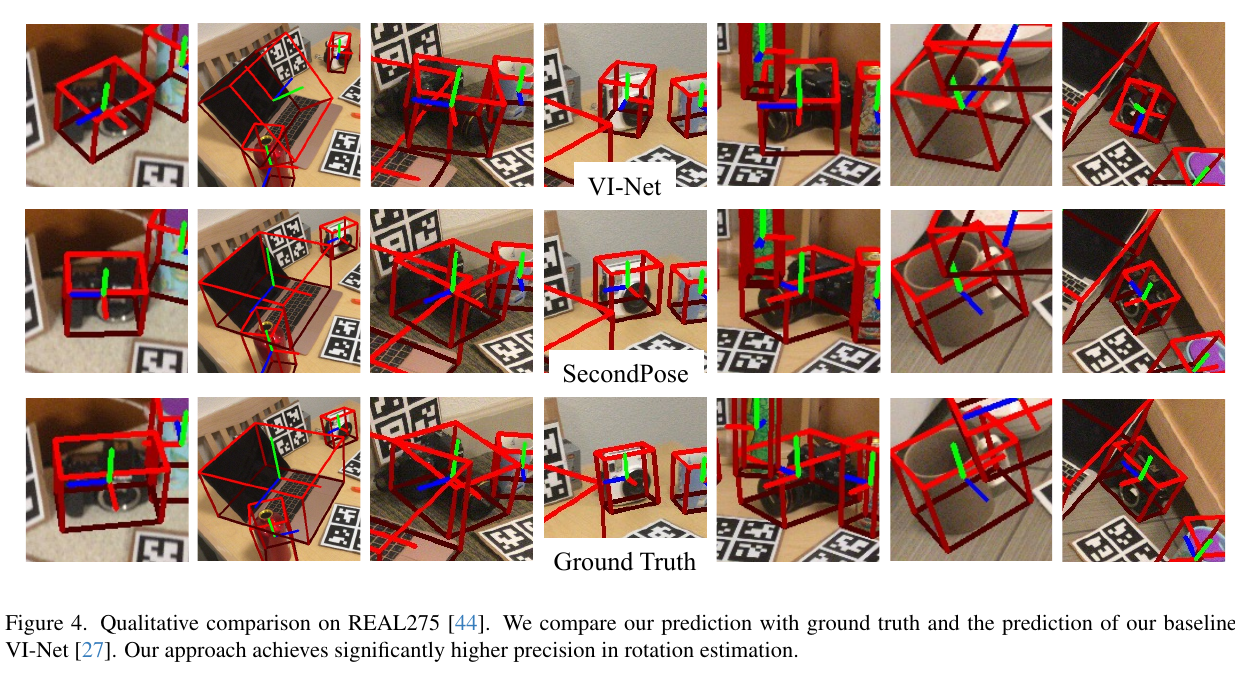
原论文 Figure 4:第一行为 VI-Net,第二行为 SecondPose,第三行为 GT。camera、laptop、mug 等类别内差异较大时,SecondPose 的旋转轴和 3D box 更接近真值。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
语义 / 几何消融:
配置 IoU75 5°2cm 5°5cm 完整 49.7 56.2 63.6 无 semantic 48.0 51.1 58.9 无 geometric 49.5 55.1 62.3 两者都无 48.5 49.9 57.4
semantic 对 strict pose 的贡献最大;geometry 单独只有 +1.1,但与 semantic 合用比两者都无高 6.3。说明几何流主要帮助语义 feature 在 metric 3D 中落位,而不是独立承担类别方向识别。
四个 PPF 分量各自去除时 5°2cm 为 54.7–55.1,均低于 56.2。normal angle 与 point distance 都有贡献,不能只保留最易算的 distance。
8. HouseCat6D
原论文 Table 2 与 Table 3:上方是 HouseCat6D overall / class-wise IoU25、IoU50;下方汇总语义、几何、panel、旋转、遮挡和点云扰动消融。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
方法 Overall IoU25 Overall IoU50 NOCS 50.0 21.2 FS-Net 74.9 48.0 GPV-Pose 74.9 50.7 VI-Net 80.7 56.4 SecondPose 83.7 66.1
IoU50 对 box 从 VI-Net 12.7 提到 23.7,对 can 从 67.0 提到 93.2,对 teapot 从 47.3 提到 71.0;但 tube 从 36.0 降至 35.6,glass 从 93.7 降至 92.5,并非所有类别都改善。HouseCat6D 的透明 / 反光 depth 也可能不完整,方法对 depth quality 的依赖值得单独评估。
9. 鲁棒性消融
随机 rotation 上限 5° / 10° / 15° / 20°:IoU75 49.7 / 49.4 / 48.5 / 47.9。
人工遮挡 mask 尺寸为 bbox 的 1/16、1/8、1/4:IoU75 49.7 / 49.5 / 46.7。
point perturbation s = 0.002 , 0.005 , 0.01 s=0.002,0.005,0.01 s = 0.002 , 0.005 , 0.01
小扰动几乎不影响,较大点云噪声比 1/4 遮挡更伤 IoU75。原因是 HP-PPF 依赖 normal 和 pair geometry,坐标噪声会同时污染多个角度量。
10. 训练与效率
NOCS training mix:25% REAL275 real + 75% CAMERA25 synthetic;
batch 48,单张 RTX 3090,40 epochs;
DINOv2 crop:210×210;
point cloud:2,048 points;
HP-PPF:其中 300 points,10-NN normal;
inference:完整 9 FPS;不含 DINOv2 为 10 FPS。
DINOv2 只造成约 1 FPS 差异,主要时延还在 point-cloud geometry、spherical projection 和 pose heads。9 FPS 未说明是否包含 Mask R-CNN;部署比较时应把前端分割单独计入。
11. 局限与复现检查
深度和相机内参是硬依赖;不是 monocular foundation-feature pose。
DINOv2 若无法提供正确部件语义,几何流不足以完全救回,作者在 limitation 中明确承认。
PPF 对 noisy normals 敏感,透明 / 反光 depth 可能破坏 feature。
“SE(3)-consistent”是近似 representation property,不是严格网络 equivariance theorem。
known-category protocol 不等于 open-vocabulary;DINOv2 并未让模型直接泛化到训练外类别。
Mask R-CNN 前端、bbox crop 与 object depth segmentation 的误差需要在完整系统中评测。
REAL275 的六类与 HouseCat6D 十类仍较有限。
12. 最终评价
SecondPose 展示了 foundation feature 在类别级 pose 中最合理的一种用法:DINOv2 负责跨实例语义方向,手工结构化的 PPF 负责 metric local geometry,二者通过 point alignment 进入一个 pose-consistent representation,而不是把大模型 feature 当作万能输入。
它在严格 pose 指标和 HouseCat6D IoU50 上均有实质提升,消融也能把 semantic、geometry 与 panel 的贡献分开。代价是系统仍依赖 RGB-D、分割和已知类别。对后续研究,最值得延伸的是让 semantic stream 走向开放类别,同时让 geometry stream 对缺失 / 噪声 depth 更稳健。