论文精读笔记:SE(3)-Equivariance with Geometric and Topological Guidance for Category-Level Object Pose Estimation
1. 核心判断
- 论文:CVF Open Access
- 核心判断:SEGPose 将三个常被分开处理的因素放进同一 pipeline:点的局部几何、点之间的拓扑关系、输入变化下的 SE(3) 等变性。
2. 一句话定位
topology-guided reconstruction 负责恢复类别结构,SE(3)-equivariant pose head 负责让预测随输入旋转和平移一致变换,二者共同提高 depth-only category-level pose。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | topology 和 SE(3) guidance 分别插入 pipeline 的哪一层? |
| Figure 2 | reconstruction 后的点云如何与 category NOCS 对齐? |
| Table 1 | CAMERA25 与 REAL275 上 depth-only 方法是否超过 RGB-D 方法? |
| Table 2 | 单独去掉 topology、SE(3)、reconstruction 或 augmentation 的损失是什么? |
| Table 3 | Wild6D 上的跨场景泛化是否仍然保持? |
| Table 4 | grasping 六种任务的成功率是否与 pose 指标一致? |
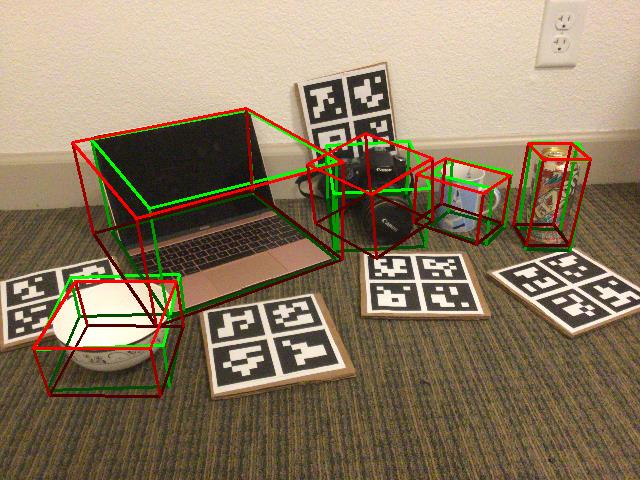 原论文定性位姿结果节选:真实场景上叠加红、绿 3D 包围框;当前截图可观察 pose 对齐,不展示 geometric / topological feature 或 SE(3) 等变网络结构。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 类别级物体 pose 估计从点云出发,输入至少包含 object mask 过滤后的点,通常采样 1024 点。
- 输出与 NOCS 对应的 rotation、translation、scale;评价使用 IoU 和旋转—平移联合阈值。
- RGB 仅用于 segmentation,论文有意研究低光环境下不依赖 RGB texture 的 depth-only 路线。
- 训练和评测假定类别 NOCS point cloud / category model 可用;这不同于无模型的 novel-object pose。
4. 研究脉络
- NOCS、GPV-Pose、HS-Pose 等类别级方法已经利用点几何和投票 / alignment,但多数忽略点云的 graph / topology 属性。
- Point cloud 在 SE(3) 变换下应表现出结构化的 equivariance;如果网络只用普通特征,动态视角变化会破坏 pose prediction。
- SEGPose 在已有 depth-based pose 基础上增加 topology-aware reconstruction 和 SE(3)-equivariant feature prediction。
5. 研究动机
- 点之间的拓扑连接关系可以补充单点距离与局部法向,尤其适合类别共享结构。
- 真实机器人中相机与物体不断运动,需要网络对输入旋转、平移具备一致响应。
- 只用几何 feature 重建点云会受到遮挡、外部干扰和形状变化影响。
- 通过 topology-guided reconstruction 将观测转成更完整的类别空间,再用 NOCS alignment 修正 pose。
6. 方法详解
6.1 Topology-guided reconstruction
- 从点云构造 geometric descriptors 与 topological / graph features,topology 表达点之间的邻接、连接和结构关系。
- 约束式 feature extraction 预测拓扑相关特征,并通过 3D reconstruction 生成更稳定的 point representation。
- reconstruction 与 category-specific NOCS point cloud 对齐,使用 Density Chamfer Distance 衡量重建质量。
6.2 SE(3)-equivariant pose head
- 设计 SE(3)-equivariance feature prediction network,使输入点云发生刚体变换时,预测 feature 和 pose 以相同方式变换。
- pose head 预测 rotation components,并结合 translation / size 得到最终类别级 pose。
- 等变损失约束不同增强视角下的输出一致性,避免仅靠数据增强学习近似 equivariance。
6.3 Loss 与 augmentation
- 使用 point / category topology loss、feature alignment、reconstruction 和 SDF / equivariance 相关损失。
- 对点云做 random cropping、resizing、random occlusion,模拟真实遮挡与点数量变化。
- NOCS alignment 作为重建与 pose 的桥梁,可在不增加额外 pose branch 的情况下修正不一致。
7. 实验分析
7.1 数据与指标
- CAMERA25:合成物体植入真实场景;REAL275:六个真实场景,均含 bottle、bowl、camera、can、laptop、mug。
- Wild6D:五类真实环境中的对象,检验跨场景泛化。
- 指标包括 IoU50 / IoU75、5° 2 cm、5° 5 cm、10° 2 cm、10° 5 cm 和整体 mAP。
7.2 主结果
- CAMERA25 上 SEGPose 的 IoU50 / IoU75 为 93.7 / 90.5,10° 2 cm 与 10° 5 cm 为 82.7 / 91.2。
- REAL275 上 IoU50 / IoU75 为 83.1 / 78.3,5° 2 cm、5° 5 cm、10° 2 cm、10° 5 cm 分别为 51.8、61.1、73.9、87.1。
- Wild6D 上 depth-only 的 IoU50 为 72.2,10° 5 cm 为 48.1,优于对比 depth-based 方法。
- UR3 六类任务按 single grasp、occluded grasp、handover、pouring、stacking 和 external disturbance 排序,成功率分别为 88.9、82.2、75.6、71.1、64.4、84.4%。原 Table 4 的 84.4 对应任务 F,不是六任务平均值。
7.3 消融
- 同时移除 topology 和 SE(3) 模块时 REAL275 10° 5 cm 下降到 79.2;加入二者后达到 87.1。
- topology-guided reconstruction、NOCS alignment 与 reconstruction loss 各自对点云质量和 pose 有贡献。
- 去掉 SE(3) equivariance loss 会削弱动态视角变化下的 pose consistency。
8. 批判性分析
- 优势:depth-only 设定和真实抓取让论文的应用边界清晰;拓扑与等变性的组合有理论直觉。
- 限制:类别 NOCS 与重建先验仍需准备;对于没有共享拓扑的开放类别,方法需要重新定义。
- 指标与任务差异:抓取成功率受夹爪、物体摩擦和碰撞影响,不应直接等同于 pose mAP。
- 鲁棒性:极重遮挡和缺失部件时,topology 可能也缺少足够证据,需进一步引入 uncertainty。
9. 对我的研究的启发
- 可将拓扑 persistence、部件图或局部连接关系作为 category-level pose 的额外 supervision。
- SE(3) 等变 feature 可以与 NOCS、canonical point cloud 和 object-centric Gaussian 融合。
- 真实机器人评测应把 pose、遮挡、操作类型和失败恢复分开统计,而不是只报告单一成功率。
10. 待解决问题
- 如何在类别未知、无 NOCS 的场景自动发现拓扑结构?
- 如何处理对称物体的等价 pose 和 topology ambiguity?
- 如何用主动观测和机器人动作补足被遮挡的拓扑?
11. 精读补充:SE(3) 等变性与拓扑先验的联合证据
11.1 设定与实现
SEGPose 以 point cloud 为主输入,RGB 只用于 instance segmentation;它不依赖 RGB-D feature fusion。点数固定为 1024,batch size 24,单张 RTX 3090,初始学习率 10−4,cosine schedule;损失权重为 λ1=8,λ2=1,λ3=4,λ4=0.1,λ5=2,β1=0.5,β2=1。
方法包含三条互补路径:
- geometric / topological guidance 从点云构造局部几何和拓扑特征,帮助重建类别结构;
- reconstruction 与 NOCS alignment 将观测点映射到 canonical space;
- SE(3)-equivariant feature prediction 让输入整体旋转 / 平移时,feature 变化遵循对应群作用,再用 NOCS 对齐恢复 pose。
11.2 CAMERA25 / REAL275 主结果
| 数据集 | IoU50 | IoU75 | 5°2cm | 5°5cm | 10°2cm | 10°5cm | FPS |
|---|
| CAMERA25 | 93.7 | 90.5 | 76.3 | 82.9 | 82.7 | 91.2 | — |
| REAL275 | 83.1 | 78.3 | 51.8 | 61.1 | 73.9 | 87.1 | 45.8 |
这些是 depth-only 结果。作者明确承认 RGB-D 的 SpotPose 在部分指标上更强,因此 SEGPose 的优势主要在输入更简单、速度更高和结构 / pose 的联合建模,而不是在所有指标上压过 RGB-D 方法。
11.3 Wild6D 与机器人验证
Wild6D 上 SEGPose 的 IoU25 / IoU50 为 88.1 / 72.2,5°5cm / 10°5cm / 15°5cm 为 35.6 / 48.1 / 52.2,均超过表中的 depth-based HS-Pose(85.4 / 58.1 / 28.6 / 41.6 / 44.7)。
UR3 的六类任务分别是 single-object grasping、occluded grasping、handover、pouring、stacking 和 external disturbance;成功率为 88.9 / 82.2 / 75.6 / 71.1 / 64.4 / 84.4。最后的 84.4 属于 external disturbance 任务 F,不是平均值。这里的机器人结果是应用证据,不应与 mAP 当成同一个指标。
11.4 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| topology guidance 让重建更符合类别结构 | 去掉 reconstruction / topology 相关项时 10°5cm 从完整 87.1 降到约 79.2,方向一致。 |
| SE(3) equivariance 改善动态姿态变化 | 去掉 equivariant guidance / loss 后 pose 指标下降;但应进一步按旋转幅度和点云密度分组。 |
| depth-only 仍能实用 | 45.8 FPS 与 UR3 结果支持部署潜力,但 mask、点云质量和类别 NOCS 仍是前提。 |
12. 失败模式与可迁移设计
拓扑特征在严重缺失部件时也可能没有足够证据;对称类别存在 multiple equivalent NOCS poses;Mask-RCNN 漏检会把 reconstruction 和 pose 一起拉偏。后续可以将 persistent topology 的置信度传给 pose head,把 pose 输出改为等价解集合,并在机器人侧用 grasp success / re-observation 作为在线校准信号。
