论文精读笔记:U-COPE
1. 核心判断
U-COPE 的“Universal”指统一 rigid 与 articulated category-level pose formulation ,不是开放词汇、任意拓扑或任意传感器。其核心抽象是:
object = { K rigid parts , K − 1 joints } , \text{object}=\{K\text{ rigid parts},K-1\text{ joints}\}, object = { K rigid parts , K − 1 joints } , 刚体只是 K = 1 K=1 K = 1
关节 pivot 与 direction;
K K K 每个 part 的 R ( k ) , t ( k ) , s ( k ) R^{(k)},t^{(k)},s^{(k)} R ( k ) , t ( k ) , s ( k )
这一抽象确实减少了两套独立 pipeline,但仍需要 category-specific 的部件数、关节关系和训练监督。它更准确的定位是 shared architecture across predefined rigid / articulated categories 。
2. 输入与监督边界
论文的问题定义输入为 P ∈ R N × 3 P\in\mathbb R^{N\times3} P ∈ R N × 3
先用对象 crop / detection 得到对象区域;
depth + intrinsics 反投影;
采样为 2,048-point object cloud。
模型并不从整幅 RGB-D 检出对象。CAMERA25 的 AP 还使用文献提供的 detection boxes。训练监督包括:
per-point part labels;
joint pivot / direction;
每个 part 的 rotation / translation / 3D size;
known category topology 与 part count。
“unseen instance”仅表示测试形状未在训练集中出现,并不表示未知类别或未知关节结构。
3. 网络:先分部件,再做同部件 PPF
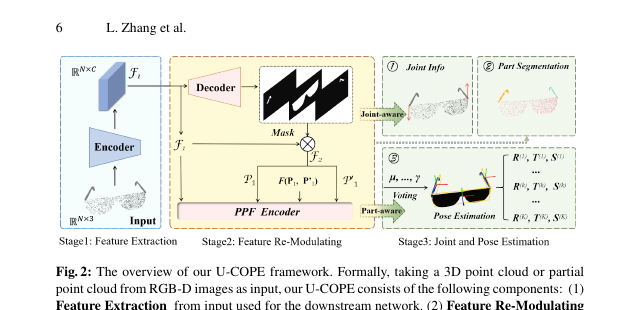
原论文 Figure 2。共享 point feature \(F_1\) 一方面预测 part masks,另一方面与各 mask 相乘得到 part-conditioned \(F_2\);PPF encoder 最终对同部件 point pairs 预测 pose voting parameters。来源:ECVA 正式论文 ;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
PointNet++ 输出 F 1 ∈ R N × C F_1\in\mathbb R^{N\times C} F 1 ∈ R N × C m k ∈ R N × 1 m_k\in\mathbb R^{N\times1} m k ∈ R N × 1
F 2 ( k ) = F 1 ⊙ m k . F_2^{(k)}=F_1\odot m_k. F 2 ( k ) = F 1 ⊙ m k . 这种 feature re-modulation 有两层作用:
part segmentation 显式限制每个 pose branch 的支持区域;
PPF 不再把两个活动部件的点误组成一个刚体 pair。
但它也产生级联风险:mask 边界错、遮挡导致某 part 点数不足时,后续 joint 与 pose 都会受影响。论文在局限中明确承认 part cloud 会因 segmentation 不准而残缺 / 含噪。
4. Joint prediction
joint ϕ = ( q , u ⃗ ) \phi=(q,\vec u) ϕ = ( q , u )
heatmap H i H_i H i
offset O i O_i O i
direction u ^ i \hat u_i u ^ i
joint-awareness score:该点是否属于与此 joint 相连的 part。
pivot loss 不要求落在唯一端点,而度量预测点到 GT joint axis 的垂距:
L p v t = ∥ ( p ^ − q ) × u ⃗ ∥ 2 , L d i r = ∥ u ^ − u ⃗ ∥ 2 . \mathcal L_{\rm pvt}
=\|(\hat p-q)\times\vec u\|_2,
\qquad
\mathcal L_{\rm dir}
=\|\hat u-\vec u\|_2. L pvt = ∥ ( p ^ − q ) × u ∥ 2 , L dir = ∥ u ^ − u ∥ 2 . 这与 revolute / prismatic joint 的轴线几何更一致。推理只聚合 awareness 和 heatmap 均超过 0.5 的 points。刚体 K = 1 K=1 K = 1
5. 9D pose voting
作者将直接回归 R , t , s R,t,s R , t , s
中心位置由 pair-relative distances / angles 生成候选并投票;
orientation 用 right / up 两个轴的 SO(3)-invariant angular parameters,两个 object axes 确定 rotation;
scale 回归相对类别平均 box s ˉ \bar s s ˉ
γ = log s − log s ˉ , s ^ = exp ( γ t o t a l ) ⊙ s ˉ . \gamma=\log s-\log\bar s,\qquad
\hat s=\exp(\gamma_{\rm total})\odot\bar s. γ = log s − log s ˉ , s ^ = exp ( γ total ) ⊙ s ˉ . part-awareness classifier 只保留来自同一 part 的 point pair。它并没有让 PPF 完全“天然”支持关节物体,而是用 learned segmentation / awareness 把对象重新拆回局部刚体。
6. CAMERA25:统一框架的刚体结果
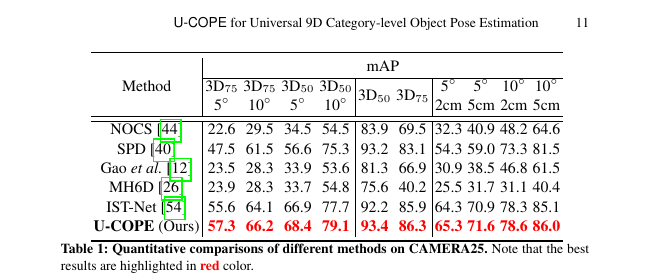
原论文 Table 1。CAMERA25 是 synthetic NOCS benchmark;U-COPE 相比 IST-Net 在下表所列五项指标提升 0.4–1.7 points,完整原表中另有两项联合阈值指标下降,不应只与较早 NOCS baseline 比出巨大增幅。来源:ECVA 正式论文 ;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
方法 3D75+5° 3D50 3D75 5°2cm 10°5cm NOCS 22.6 83.9 69.5 32.3 64.6 IST-Net 55.6 92.2 85.9 64.3 85.1 U-COPE 57.3 93.4 86.3 65.3 86.0
相比强近邻 IST-Net,U-COPE 在所列五项指标上小幅提升;完整原表中的 3D75+10° 为 66.2 对 66.9、3D50+5° 为 68.4 对 69.9,仍有退步。论文正文强调相对 NOCS 的 +34.7 等大增幅,对判断 2024 年真实增益不够公平。
7. ArtImage:逐部件结果与速度
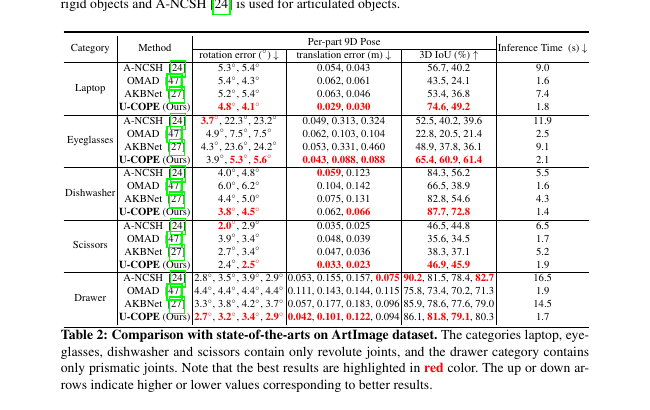
原论文 Table 2。每个逗号分隔数字对应一个 part;因此不能把其中最优数字当成整类单一误差。来源:ECVA 正式论文 ;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
代表性结果:
laptop:4.8° / 4.1°,0.029 / 0.030,IoU 74.6 / 49.2,1.8 s;
eyeglasses:3.9° / 5.3° / 5.6°,IoU 65.4 / 60.9 / 61.4,2.1 s;
dishwasher:3.8° / 4.5°,IoU 87.7 / 72.8,1.4 s;
scissors:2.4° / 2.5°,IoU 46.9 / 45.9,1.9 s;
drawer:2.7° / 3.2° / 3.4° / 2.9°,1.7 s。
U-COPE 对 rotation 和 translation 基本占优,但 drawer 的第 1 / 3 / 4 part IoU 分别为 86.1 / 79.1 / 80.3,对应 A-NCSH 的 90.2 / 78.4 / 82.7:第 1、4 部件更低,第 3 部件更高,存在 part-level mixed outcomes。整对象耗时 1.4–2.1 s,远非实时。
8. Point-pair 数量与 awareness 消融
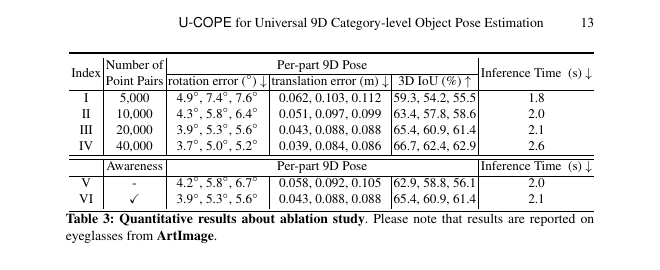
原论文 Table 3,ArtImage eyeglasses。5K→40K pairs 精度持续增加,但时间由 1.8 s 增至 2.6 s;作者默认 20K。来源:ECVA 正式论文 ;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
Point pairs Rotation(3 parts) IoU(3 parts) 时间 5K 4.9 / 7.4 / 7.6 59.3 / 54.2 / 55.5 1.8 s 20K 3.9 / 5.3 / 5.6 65.4 / 60.9 / 61.4 2.1 s 40K 3.7 / 5.0 / 5.2 66.7 / 62.4 / 62.9 2.6 s
20K 是 speed–accuracy 折中,不是饱和最优。加入 joint / part awareness 相比未加入版本,第三 part rotation 6.7→5.6、IoU 56.1→61.4,说明跨 part pairs 确实是主要噪声源。
9. “真实泛化”证据的边界
ReArtMix 与 RobotArm 只展示 qualitative overlays,没有:
定量 rotation / translation / joint error;
真实数据数量和完整 split;
failure rate;
与 baseline 的统一实测表。
因此主 SOTA 证据仍来自 synthetic CAMERA25 / ArtImage。论文可说明模型“能在若干真实例子上运行”,不足以证明稳定 sim-to-real。
10. 局限
上游 object crop / depth error 未计入;
category、part count、joint topology 预定义;
unseen instance 不是 unseen category;
part segmentation 错误会污染全部下游分支;
PPF 20K sampling 带来秒级推理;
rigid / articulated 使用不同数据集,缺少同一混合场景内统一评测;
ReArtMix / RobotArm 仅定性;
symmetry handling 与 equivalent rotations 说明不充分;
未验证动态视频、temporal consistency 或多传感器;
未核实到专用公开代码。
11. 复现检查表
固定 object crop、depth back-projection 与 2,048-point sampling;
为每类记录 K K K
复现 part mask、joint heatmap / offset / direction supervision;
只对同 part pairs 训练 pose parameters;
分别报告 5K / 10K / 20K / 40K pairs 的精度与 latency;
CAMERA25 使用完全相同 detection boxes 和 metric implementation;
ArtImage 按 part 顺序报告,不只做 category average;
增加真实数据 quantitative metrics;
计入 detection、point-cloud preprocessing 和网络的端到端时间;
对 segmentation corruption、missing depth、unknown topology 做鲁棒性测试。
12. 最终评价
U-COPE 最值得保留的是任务抽象:将 rigid object 看作单 part articulated object,并用 part segmentation / joint / pose 三个目标共同约束 point-pair voting。CAMERA25 所列指标对 IST-Net 的提升与 ArtImage 上活动部件的明显改善表明,这种统一结构确实可行。
但“universal”不能外推到开放类别和未知 topology。它依赖已裁 point cloud、预定义 part / joint semantics,真实泛化只有定性图,20K pairs 又使推理约 2 s。它是一篇有价值的 统一建模论文 ,而不是已经具备通用部署能力的实时系统。