论文精读笔记:UA-Pose: Uncertainty-Aware 6D Object Pose Estimation and Online Object Completion with Partial References
1. 核心判断
- 论文:CVF Open Access
- 关键问题:partial reference 缺少对象背面或纹理,不应把未观测区域当作“错误表面”;同时 pose 和 completion 的迭代会出现 error feedback。
- 核心回答:给 hybrid object representation 加 uncertainty,使 pose alignment 优先利用已观测可靠区域,再把高质量的新观测用于在线补全。
2. 一句话定位
UA-Pose 用 uncertainty 将不完整 reference 从一个被动缺陷变成系统的显式状态变量,串接 pose confidence、sampling 与 online completion。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
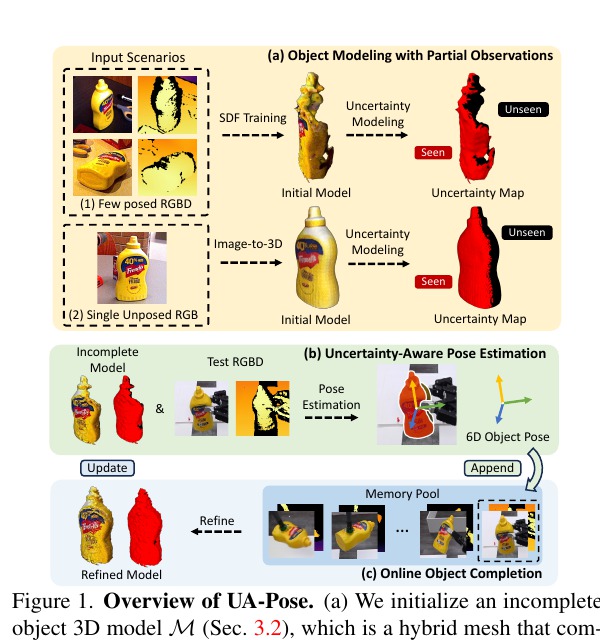
| Figure 1 | partial RGB-D 与 single RGB 两种初始对象建模条件,以及 pose–memory–completion 的闭环。 |
| Figure 2–4 | hybrid representation、uncertainty-aware pose、memory pool 与 image-to-3D 初始化的分工。 |
| Table 1–3 | YCB-V、YCBInEOAT、HO3D 的遮挡 / 手物交互难度不同。 |
| Table 4–5 | uncertainty 与 object completion 是否各自带来独立收益。 |
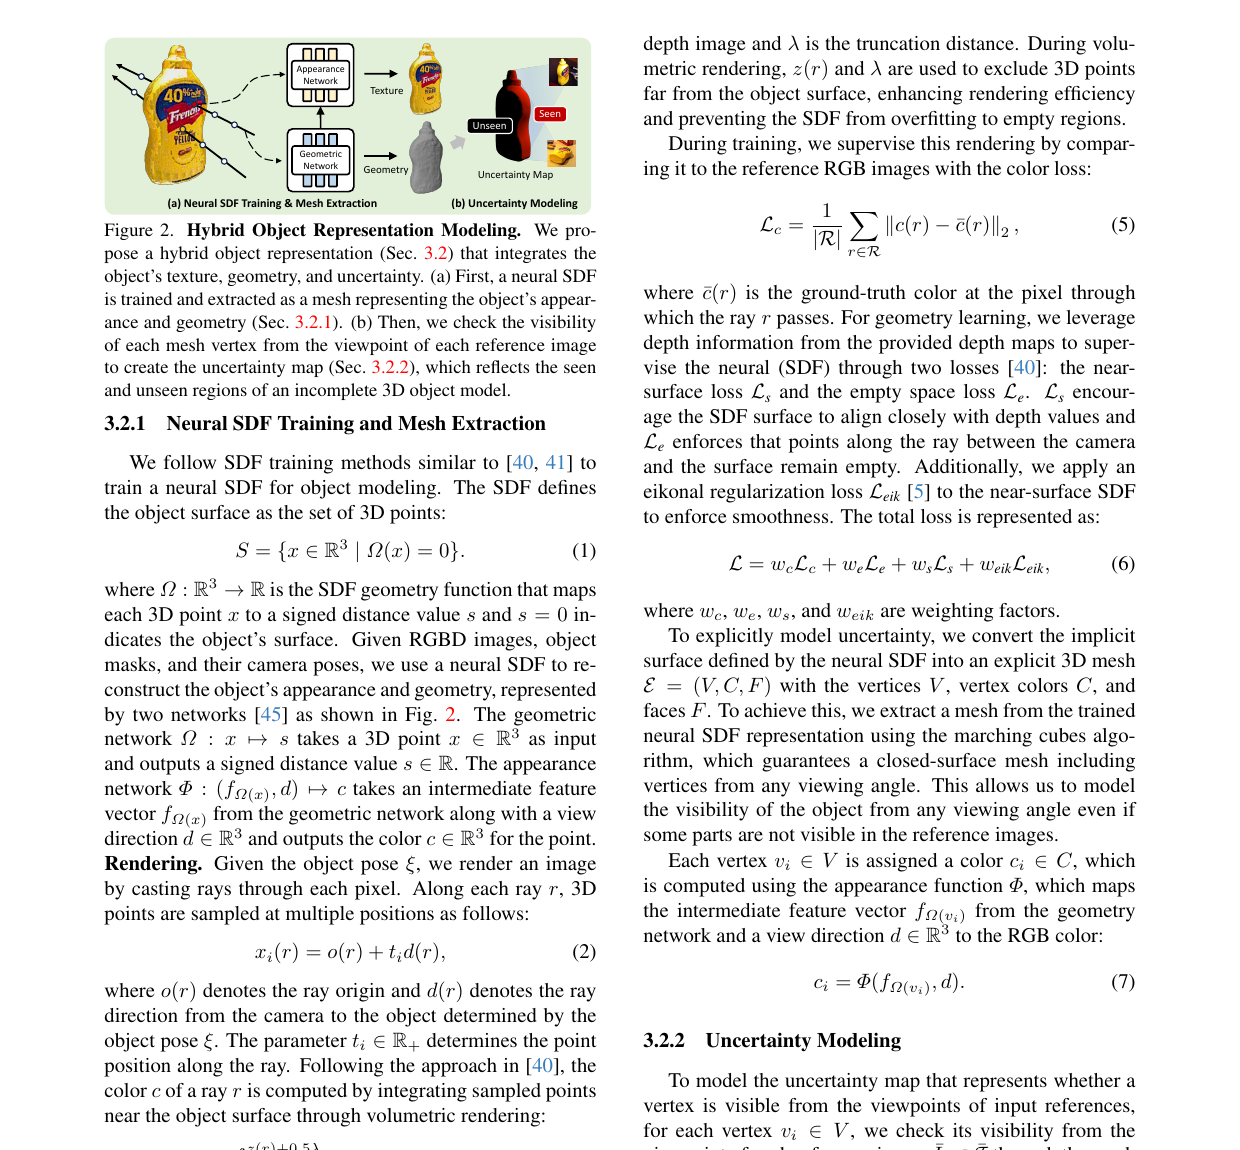 原论文 Figure 2 与相邻正文:neural SDF 提取带纹理 / 几何的 mesh,再根据参考视角可见性构建 seen / unseen uncertainty map;该裁图不展示完整位姿估计或在线补全流程。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 两类 initial reference:少量带 pose 的 RGB-D,或单张未设姿 RGB 经 image-to-3D 生成初始模型。
- query 可形成 RGB-D sequence,输出每帧 pose 并逐渐补全模型;因此不是严格 single-frame only benchmark。
- 需要对象关联、camera calibration 和合理的 initial partial model,不能视为对任意场景从零发现对象。
4. 方法详解
- Hybrid model:融合 texture、geometry、uncertainty,明确标出模型哪些部分被 reference 真正观察到。
- Uncertainty-aware pose:匹配 / sampling 对低不确定区域赋予更高可信度,避免未见 surface 的 hallucination 误导 pose。
- Online completion:将 query 和已估 pose 写入 memory pool,选择信息性观测更新对象表示,反过来改善后续 pose。
5. 实验分析
| YCB-Video 输入 | 方法 | ADD | ADD-S | CD↓ |
|---|
| 2 references | FoundationPose | 87.4 | 94.3 | 0.57 |
| 2 references | UA-Pose | 92.8 | 96.5 | 0.53 |
| single RGB + Image-to-3D | FoundationPose | 88.9 | 93.6 | 0.67 |
| single RGB + Image-to-3D | UA-Pose | 93.2 | 96.9 | 0.62 |
同一初始参考条件下,UA-Pose 的 pose 与重建 CD 都改善;值得注意的是,使用单张 RGB 生成模型时 CD 仍比两张真实 RGB-D reference 更差,但 ADD / ADD-S 反而略高。这说明“生成几何越接近真值,pose 就必然越好”并不成立,适合匹配的纹理、可见面覆盖与 uncertainty weighting 更直接决定 pose。
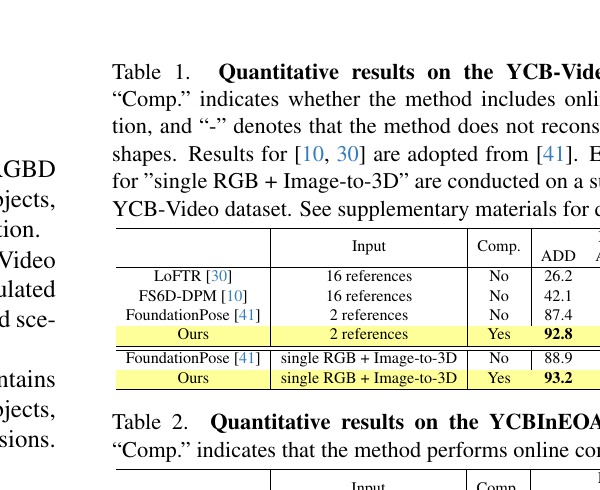 原论文 Table 1 左侧与 Table 2 标题:可见 YCB-Video 的输入 / Comp. / ADD 列,但右侧 ADD-S / CD 以及 YCBInEOAT 表体未包含在裁图中;正文的完整数值另据原表。“Comp.” 表示是否执行在线补全。来源:CVPR 2025 论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
YCBInEOAT 上,两参考输入从 FoundationPose 的 ADD / ADD-S 68.52 / 84.80 提至 89.99 / 94.35;单 RGB 初始化也从 83.39 / 90.66 提至 89.24 / 93.99。与 YCB-Video 相比增益更大,符合机器人操作序列中遮挡和新视角更多、在线补全更有价值的预期。
HO3D 的差异更极端:两参考条件下 FoundationPose 为 45.67 / 61.57,UA-Pose 为 91.51 / 95.56;单 RGB生成模型条件下为 72.06 / 87.87 对 83.23 / 93.59。手部遮挡下仅依赖不完整模型容易发生错误对齐,而 uncertainty-aware sampling 能避免把 unseen 区域当作可靠证据。
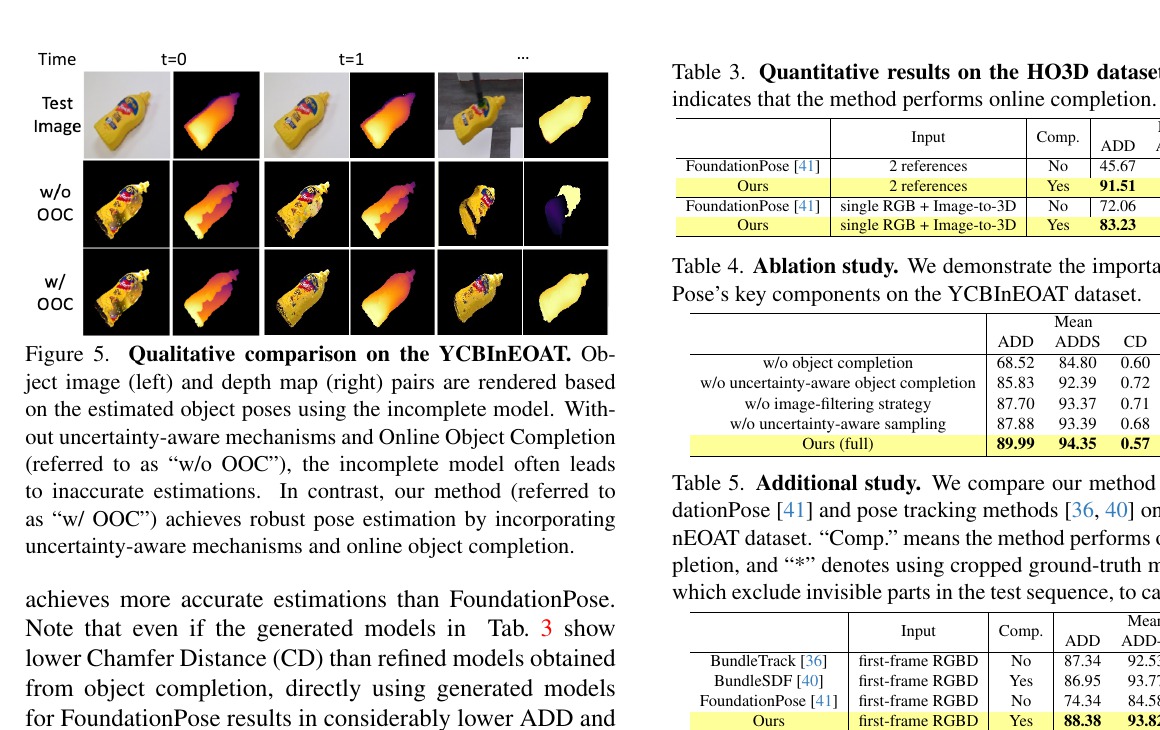 原论文 Figure 5 与 Table 3–5:展示开启在线补全前后的渲染对齐、HO3D 结果、四项关键组件消融以及与 RGB-D pose tracking 方法的补充比较。来源:CVPR 2025 论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Table 4 的因果链更清楚:不做 object completion 时 ADD / ADD-S 为 68.52 / 84.80;去掉 uncertainty-aware completion 为 85.83 / 92.39 且要重建 181 次;去掉 image filtering 为 87.70 / 93.37、87 次;去掉 uncertainty-aware sampling 为 87.88 / 93.39、59 次;完整模型为 89.99 / 94.35、58 次。也就是说 uncertainty 既用于“选哪些面做 pose”,也用于“何时、用哪些帧补模型”,两条路径都有独立贡献。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| uncertainty 提升 partial-reference pose | HO3D 的 45.67→91.51 和 Table 4 多个去除实验给出很强支持;仍应按初始可见比例分桶,排除场景构成影响。 |
| online completion 会越看越准 | 完整模型以 58 次更新取得最佳分数,而无 uncertainty-aware 调度需 181 次且更差,说明“选择性补全”比盲目累积更关键。 |
7. 复现要点与限制
- 记录 initial model 的 coverage、uncertainty parameterization、sampling policy、memory admission threshold 和 object update schedule。
- 模型若把 unseen 区域错误标为高置信,系统会同时损害 pose 和 completion;这是闭环的主要失效模式。
- 对快速运动、强镜面 / 透明和频繁遮挡,时间一致性与深度质量仍是基本瓶颈。