论文精读笔记:Uncertainty-Aware KD
1. 核心判断
这篇论文针对一个常被忽略的 knowledge distillation 假设:teacher 并非对每个 2D 关键点都同样可靠。遮挡、局部纹理弱或视角退化时,teacher 对某些点的预测会随初始化显著变化;若把这些点与稳定点等权送给 student,蒸馏可能强化错误知识。
作者提出两层耦合机制:
- UAKD:把 teacher keypoint variance 转成 OT 中的 confidence mass;
- PFKD:不独立做全图 feature matching,而是沿 UAKD 已建立的 keypoint transport plan 对齐对应感受野。
这种“同一 correspondence 同时约束输出和特征”的一致性,是方法最清楚的贡献。LINEMOD 上三种 student 均超过无蒸馏 student 和 ADLP+FKD,但更轻的 SPNv2 student 与 teacher 仍差 6.2 点,说明蒸馏没有消除容量差距。
2. 基础 pose pipeline 与任务边界
论文不提出新的 PnP 或 pose head,而是压缩已有两阶段 RGB pose estimator:
- 网络从单幅 RGB 预测对象的 2D 关键点;
- 已知 3D 关键点 / bounding-box corners 与 2D 预测建立对应;
- PnP 恢复对象相对相机的旋转和平移。
两套基础网络:
- WDRNet:DarkNet + FPN,在多个尺度输出局部 2D 关键点 clusters,并有 keypoint existence score;
- SPNv2:EfficientDet + BiFPN 的多任务网络,本文只蒸馏 2D keypoint heatmap head。
学生训练仍有真值关键点 loss。KD 是额外监督,不是无标注压缩;已知对象的 3D keypoint 和相机内参等 PnP 先验保持不变。
3. Teacher uncertainty 是怎样估计的
作者只估计 epistemic uncertainty:训练 E=4 或 6 个架构相同、初始化不同的 teacher。对输入图像和第 i 个关键点,收集 E 个二维预测:
{k^iTj}j=1E.
分别计算 x,y 的均值与方差,将 ensemble mean 作为 teacher target,并定义:
σi2=σx,i2+σy,i2,ui=tanh(σi2).
teacher 的 uncertainty confidence 为:
αT,c=1−u.
若 WDRNet 自带 existence probability αT,e,则:
αT=λαT,c+(1−λ)αT,e,
默认 λ=0.5。作者试过乘法但经验结果较差;具体数字未给。
这里有三个边界:
- 方差同时受模型初始化、训练随机性和预测坐标尺度影响;
tanh 没有温度或尺度校准,输入分辨率和坐标归一化会改变饱和速度;- 它没有建模图像噪声导致的 aleatoric uncertainty,也不是 pose covariance。
若 ensemble 成员的关键点数量不同,作者多数投票保留可对齐点,其他点 uncertainty 设为 1。该分支没有单独实验。
4. UAKD:不平衡最优传输
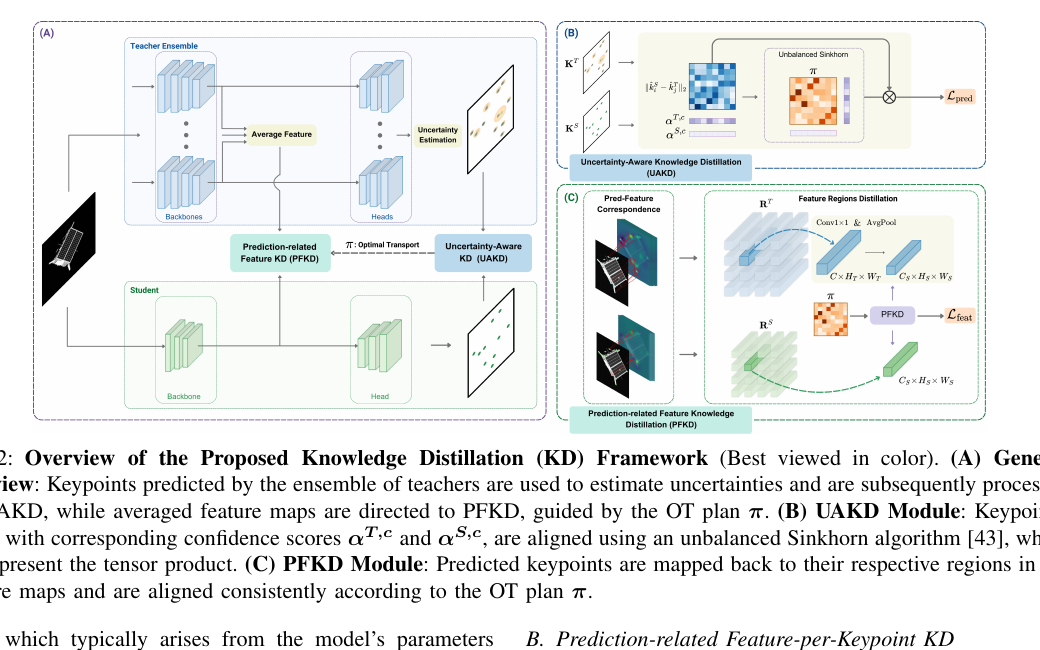 原论文 Figure 2。右上 UAKD 对齐 teacher / student keypoint distributions;右下 PFKD 将点映射回 feature receptive fields,并沿同一 \(\pi\) 蒸馏。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
teacher 有 N 个点、student 有 M 个点时,OT 允许 N=M。代价为二维欧氏距离:
Lpred=πmini=1∑Mj=1∑Nπij∥k^iS−k^jT∥2.
π 的行、列边缘质量由 student / teacher confidence 决定,并用 unbalanced Sinkhorn 求解。高 uncertainty teacher 点的 αjT 小,能转移给 student 的质量下降。
“unbalanced”很关键:如果要求严格质量守恒,不可靠 teacher 点仍必须把全部质量分配出去。论文没有系统报告 Sinkhorn regularization、unbalanced penalty 和迭代次数对结果的敏感性,是复现风险。
5. PFKD:从关键点追踪到感受野
普通 feature KD 往往直接对齐整张 teacher / student feature map,与 prediction-level correspondence 无关。PFKD 根据 keypoint head 的卷积结构,把预测坐标映射回 feature map:
- 中心由输出坐标乘 spatial scale δ 后取整;
- region 大小由 head 中每层 kernel κl 和 stride sl 推导的 receptive field 决定;
- teacher channel 用 1×1 conv 对齐 student;
- 空间大小用 average pooling 对齐。
对 teacher region RiT 与 student region RjS,使用 UAKD 的 πij 加权 feature MSE。ensemble teacher 的 feature regions 先跨模型平均。
最终:
Ldistill=γpLpred+γfLfeat,γp=5, γf=0.1.
PFKD 的优点是输出与特征共享匹配关系;代价是它假设 keypoint head 保持清晰空间对应。对于 transformer token、全局 attention 或 deformable sampling,按卷积 receptive field 反推 region 未必直接适用。
6. 模型规模:效率的证据与缺口
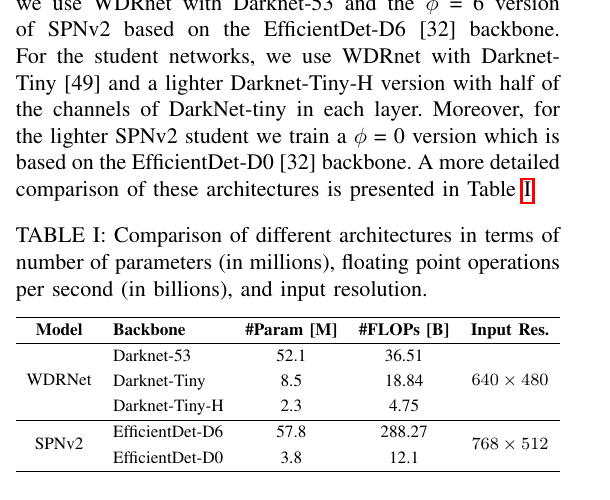 原论文 Table I:列出 teacher / student backbone 的参数、FLOPs 与输入分辨率。论文没有报告 GPU、CPU 或 edge device 的实测 latency。来源:作者公开稿;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
| 模型 | Backbone | 参数 | FLOPs | 输入 |
|---|
| WDRNet teacher | DarkNet-53 | 52.1M | 36.51B | 640×480 |
| WDRNet student | DarkNet-Tiny | 8.5M | 18.84B | 640×480 |
| WDRNet tiny-H | DarkNet-Tiny-H | 2.3M | 4.75B | 640×480 |
| SPNv2 teacher | EfficientDet-D6 | 57.8M | 288.27B | 768×512 |
| SPNv2 student | EfficientDet-D0 | 3.8M | 12.1B | 768×512 |
参数 / FLOPs 的下降明确,但“real-time”“efficient inference”没有 latency、FPS、峰值显存或能耗支撑。蒸馏训练需要 4–6 个完整 teacher,还要平均 feature regions,训练资源成本显著增加;部署时则只保留 student。
7. LINEMOD 主结果
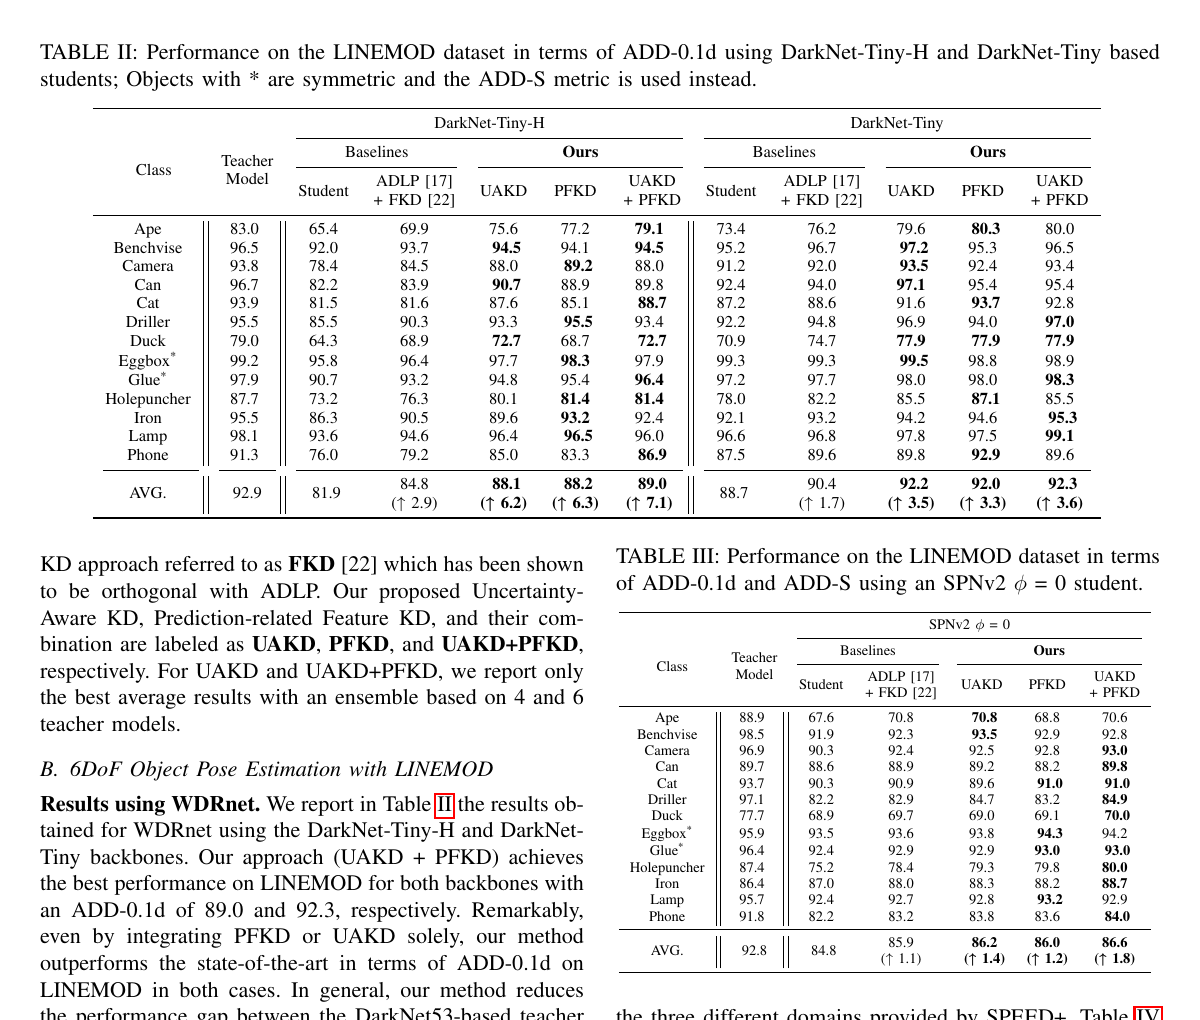 原论文 Table II–III。星号对象用 ADD-S,其余用 ADD;平均值不能解释为严格统一的 symmetry-aware BOP AR。来源:作者公开稿;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
平均 ADD(-S)-0.1d:
| Student | Teacher | Student | ADLP+FKD | UAKD | PFKD | UAKD+PFKD |
|---|
| DarkNet-Tiny-H | 92.9 | 81.9 | 84.8 | 88.1 | 88.2 | 89.0 |
| DarkNet-Tiny | 92.9 | 88.7 | 90.4 | 92.2 | 92.0 | 92.3 |
| SPNv2 φ=0 | 92.8 | 84.8 | 85.9 | 86.2 | 86.0 | 86.6 |
观察:
- 越弱的 Tiny-H,KD 绝对收益越大:+7.1,但仍低于 teacher 3.9;
- DarkNet-Tiny 几乎追平 teacher:92.3 vs 92.9;
- SPNv2 的 student–teacher gap 最大:蒸馏后仍有 6.2;
- UAKD / PFKD 单独使用都超过 ADLP+FKD 平均值,支持两项设计;
- 组合只比最好单项多 0.8 / 0.1 / 0.4,二者互补但不是线性叠加。
个别类别 student 超过 teacher 并不矛盾,可能来自蒸馏正则化与类别波动;论文没有提供多随机种子方差,0.1–0.5 的小差距需谨慎。
8. SPEED+ 跨域结果
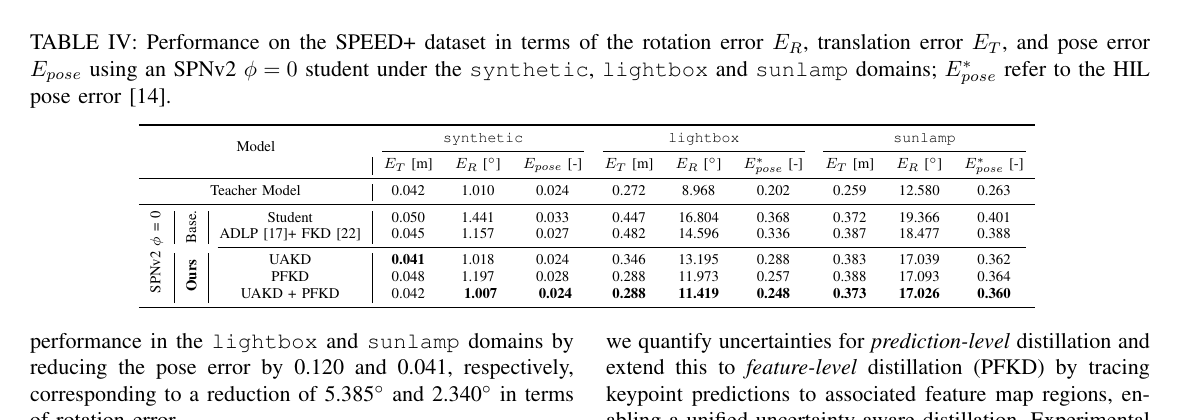 原论文 Table IV:synthetic、lightbox、sunlamp 分别报告 translation、rotation 和 pose error;lightbox / sunlamp 为硬件在环域。来源:作者公开稿;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
SPNv2 φ=0:
| 方法 | synthetic pose | lightbox HIL pose | sunlamp HIL pose |
|---|
| Teacher | 0.024 | 0.202 | 0.263 |
| Student | 0.033 | 0.368 | 0.401 |
| ADLP+FKD | 0.027 | 0.336 | 0.388 |
| UAKD | 0.024 | 0.288 | 0.362 |
| PFKD | 0.028 | 0.257 | 0.364 |
| UAKD+PFKD | 0.024 | 0.248 | 0.360 |
组合在 synthetic 追平 teacher,在 lightbox / sunlamp 相对 student 改善 0.120 / 0.041,但仍差于 teacher 0.046 / 0.097。PFKD 在 lightbox 单项 0.257,接近组合 0.248,说明 feature alignment 对合成到真实光照域迁移尤其有帮助。
9. Additional analysis
作者把 ensemble 的平均增益与 uncertainty weighting 分开:
- 只做 ensemble、不用 uncertainty(λ=0):Tiny-H +0.2,Tiny +0.5;
- 完整 UAKD:对应 +6.2 / +3.5。
这支持主要收益来自加权蒸馏,而非简单多个 teacher 更准。
λ 曲线在 0.5 最好,即 uncertainty confidence 与 WDRNet existence score 各半。该实验只有一次曲线,没有 calibration metric、关键点级相关性或 pose error 分桶,仍不能证明 ui 是校准良好的概率。
10. 局限与复现风险
作者把 uncertainty-guided PnP 和其他 compression techniques 留作未来工作。当前边界:
- uncertainty 没有传到 PnP;部署输出不含 pose uncertainty;
- ensemble 只估 epistemic variance,4–6 个 teacher 的训练成本没有统计;
tanh(variance)、坐标尺度、ensemble seed 和成员数会直接影响权重;- 没有公开代码,OT / receptive-field 实现细节需从公式重建;
- 只评估 LINEMOD 和单航天器 SPEED+,缺少遮挡更强的 LM-O、YCB-V、T-LESS;
- 没有检测 / crop 前端说明与端到端 latency;
- LINEMOD 只有 ADD(-S)-0.1d,不含更严格阈值、AUC 或 BOP AR;
- 小数点级差异没有多种子均值 / 方差。
11. 复现检查表
- 固定每个 teacher 的数据、增强和训练配置,只改变初始化;
- 明确 keypoint coordinates 是像素值还是归一化值;
- 记录 ensemble size 4 / 6 的选取与 keypoint majority voting;
- 核对 variance→
tanh 和 existence score 的 λ=0.5;
- 复现 unbalanced Sinkhorn 的熵正则、mass penalty、迭代数;
- 从 head kernel / stride 正确推导 feature receptive field;
- 区分 teacher feature averaging 与 ensemble mean keypoint;
- 用同一 PnP 与 detector 对比所有 KD baseline;
- 同时报参数、FLOPs、GPU / CPU / edge latency、峰值显存和训练成本。
12. 最终评价
这是一篇“训练成本换部署紧凑性”的方法:它把 teacher disagreement 变成关键点级知识筛选,并让 prediction 与 feature distillation 共用同一个 OT plan。三套 student 的结果说明设计具有一定跨架构性;不过“uncertainty-aware pose”容易被过度解读——当前 uncertainty 只是训练期 teacher epistemic signal,最终 PnP 与部署系统仍是确定性的。
