返回研究文献库

物体位姿估计 · 2025 · AAAI · CCF A

Universal Features Guided Zero-Shot Category-Level Object Pose Estimation

Universal Features Pose 以 2D 通用特征获得稀疏语义对应和粗 pose,再以 3D 通用特征做稠密对齐、形状优化与 pose refinement,实现无需额外微调的零样本类别级估计。

研究方向

物体位姿估计

任务层级

Category-level

物体设定

Unseen objects

输入模态

RGB-D

关键依赖

object mask / cropdepth-derived object point cloudreference object observationscamera intrinsics
完整论文元数据 作者、单位、研究方向、数据集、指标、方法标签和阅读状态 展开
作者
Wentian Qu, Chenyu Meng, Heng Li, Jian Cheng, Cuixia Ma, Hongan Wang, Xiao Zhou, Xiaoming Deng, Ping Tan
作者单位
Institute of Software, Chinese Academy of Sciences / University of Chinese Academy of Sciences / The Hong Kong University of Science and Technology / Aerospace Information Research Institute, Chinese Academy of Sciences
会议 / 期刊
会议 · AAAI · CCF A
研究方向
物体位姿估计
开源状态
未开源 / 未整理
阅读状态
粗读:已生成 精读:已生成
任务设定
Category-level · Unseen objects
评估指标
3D IoU n° mcm

论文原始写法:3D IoU / 5° 2cm / 5° 5cm / 10° 2cm / 10° 5cm

关键依赖
object mask / cropdepth-derived object point cloudreference object observationscamera intrinsics

Reading Notes

粗读 / 精读

已生成 src/paper-notes/universal-features-zero-shot-pose/coarse.md

论文粗读笔记

用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。

粗读:Universal Features Guided Zero-Shot Category-Level Object Pose Estimation

一句话

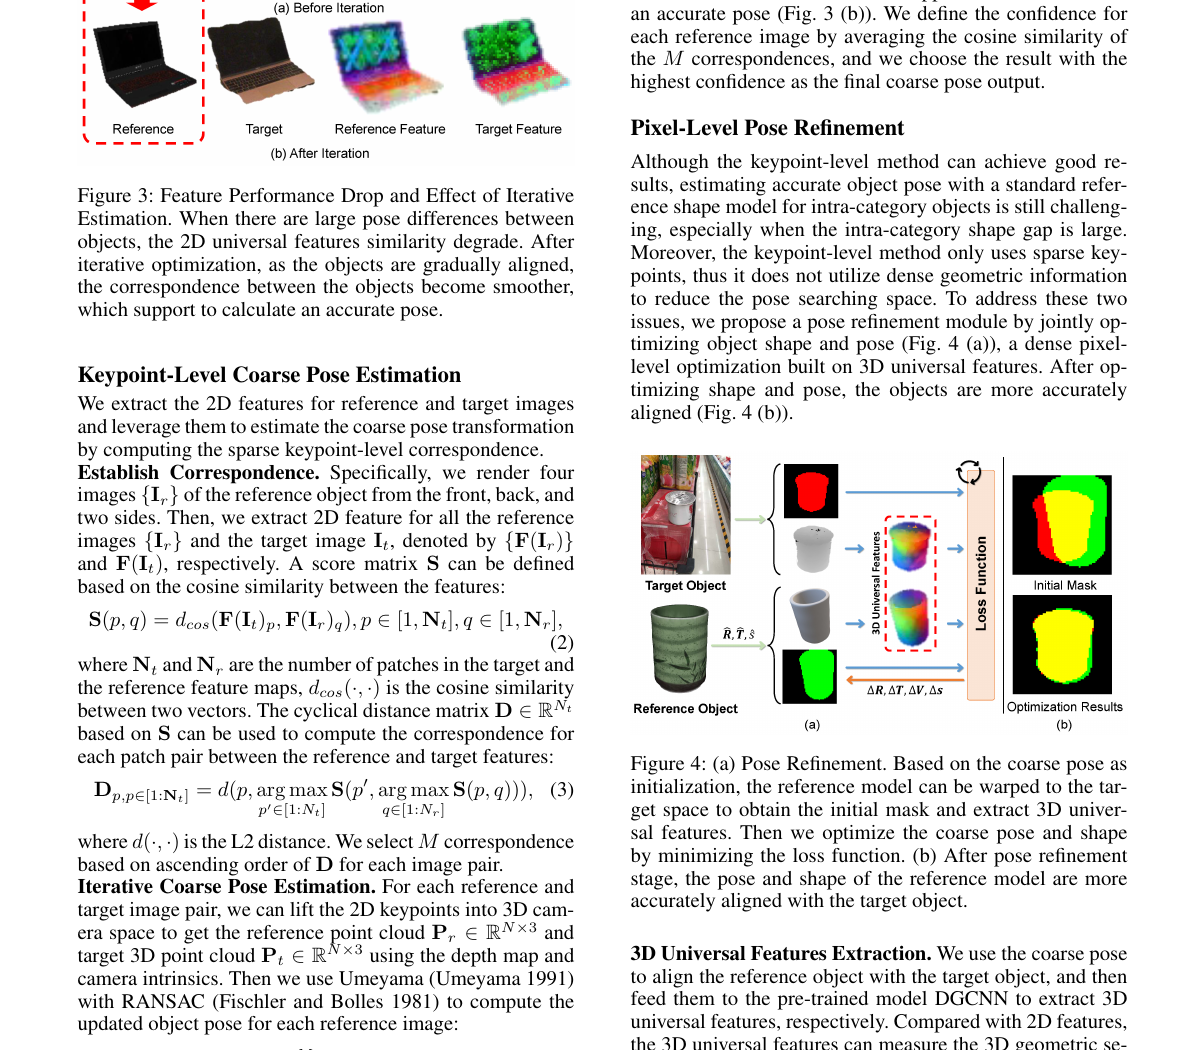
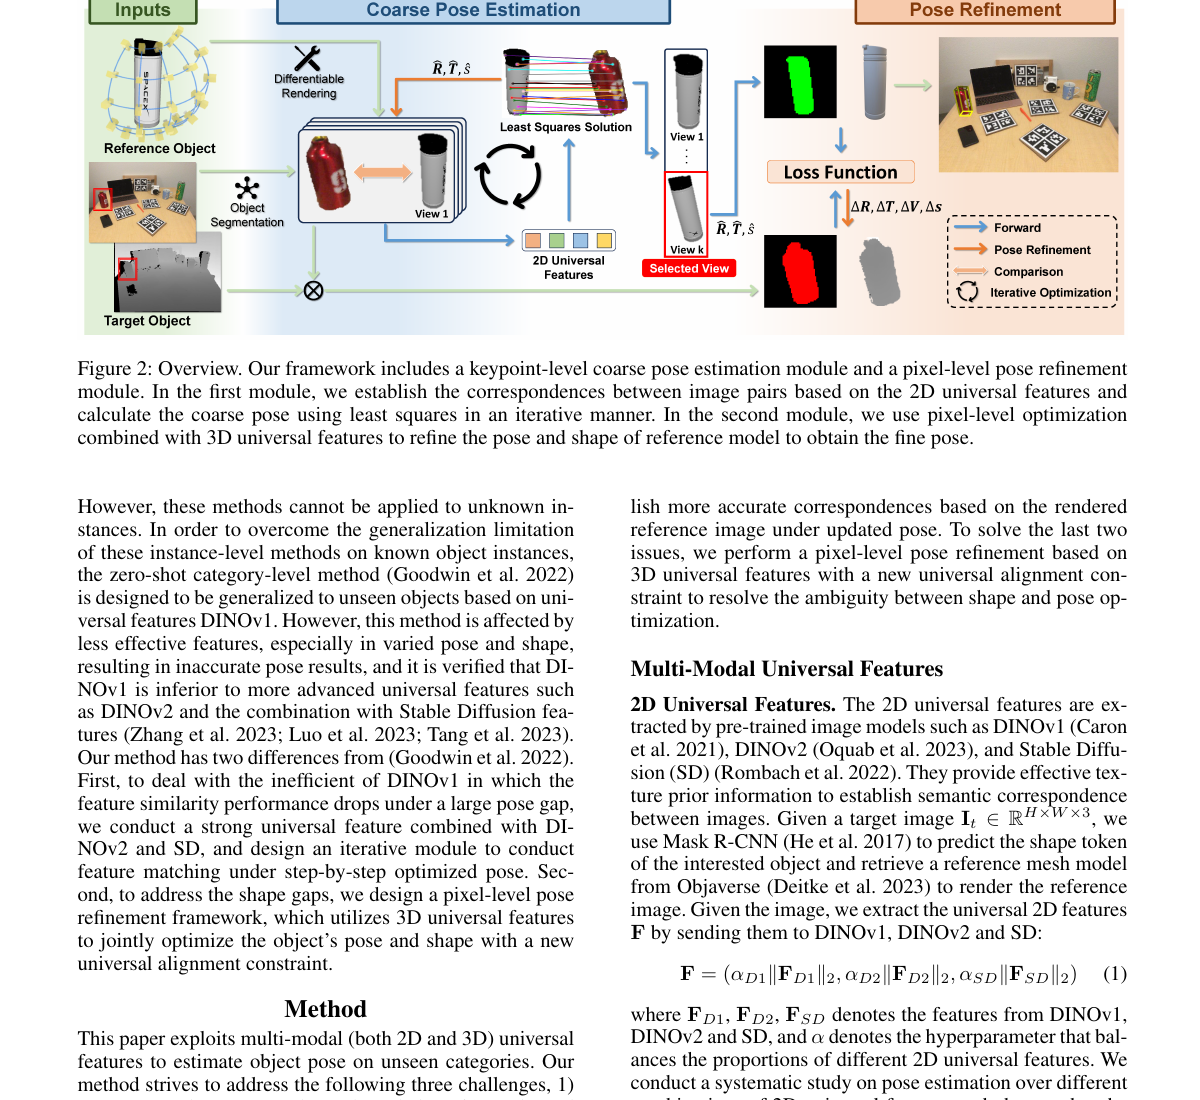
把通用 2D / 3D 特征接到“稀疏对应求粗 pose → 稠密对齐做 refinement”的 RGB-D pipeline 中,用 reference object 支持训练外类别的类别级 6D pose。

问题与输入输出

  • 输入:目标 RGB-D、目标 mask / 点云、reference object 观测与相机内参。
  • 输出:目标的相似变换与 6D pose;shape optimization 同时缩小 reference 与 target 的形状差。
  • 重点:论文的 zero-shot 是不为目标新类别额外训练 / 微调,不是无 reference、无几何先验的单图 pose。

方法速览

  1. 用 2D universal features 在 reference / target RGB 间建立 sparse semantic correspondences,迭代求粗 pose。
  2. 将 coarse pose 对齐后的点云送入 3D universal features,建立更密集、更几何化的对应。
  3. 联合优化 shape deformation 与 pose refinement,减轻类别内形状差和局部遮挡带来的漂移。

实验抓手

  • REAL275:论文报告 3D IoU@0.5 为 63.49,5°5cm 为 33.23。
  • Wild6D:3D IoU@0.5 为 67.16,5°5cm 为 60.58,10°5cm 为 80.47。
  • 其比较对象含 Zero-Pose;Table 1 的 Speed 列为 3.83 s / frame,不是 FPS;Section 4.2 使用单张 GeForce RTX 4090。

读后判断

它的贡献在于将 foundation-style feature 的跨类别语义能力和传统几何迭代对齐结合;实际落地时,mask、深度质量和 reference 覆盖仍是决定上限的外部条件。
原文

Related Papers

相关论文