YOLO-6D-Pose 精读
1. 设计目标:删除中间表示
常见单目 6D pose 链路是“检测/分割 → 关键点或坐标图 → PnP/RANSAC → refinement”。它可解释,但多对象时每一步都有额外延迟、超参数和失败模式。YOLO-6D-Pose 选择相反路线:以 YOLOX/CSPDarknet + PANet 为检测骨架,在检测 head 旁增加 rotation 与 translation head,让每个正样本位置直接回归完整 pose。
这篇论文应被理解为工程取舍:它用端到端监督换掉显式几何求解器,减少部署组件;并不意味着 PnP 不再有价值。
2. 位姿参数化
2.1 Rotation
网络预测旋转矩阵前两列的连续 6D representation。部署时得到 r1,r2,再计算 r3=r1×r2 组成旋转矩阵。相较四元数的双覆盖和欧拉角不连续,6D 表示对神经网络优化更平滑。实际实现还应注意前两列的归一化/正交化;公开后处理明确使用叉乘恢复第三列。
2.2 Translation
translation head 输出三维平移。论文正文的公开摘要与实现说明它采用可解码的 pose 参数化,把目标中心/深度相关量恢复到相机坐标;最终可视化仍需要相机内参和对象 CAD 尺寸。
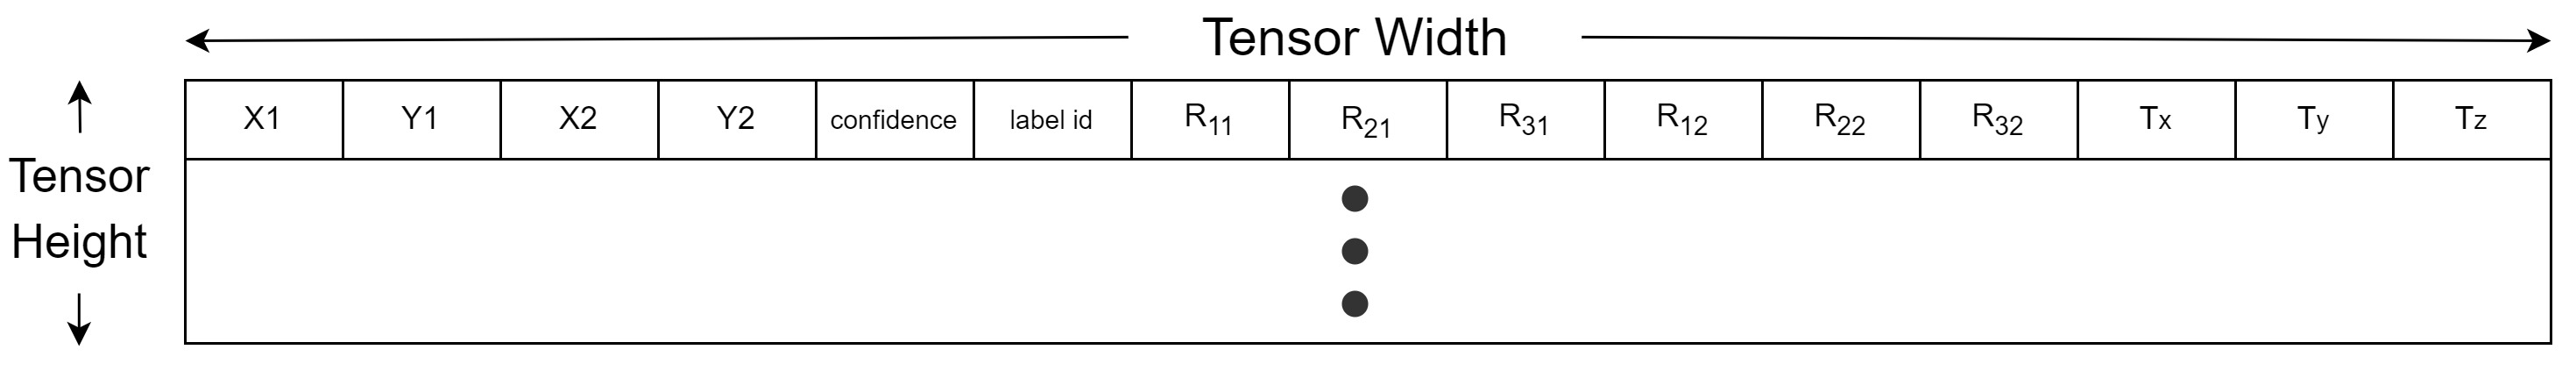 默认 ONNX 模型对每个目标输出 15 维;这使后处理成为确定性解码,而不是另一套学习模型或迭代优化。来源:Texas Instruments 作者公开实现;版权归原作者所有,本站仅作学术解读。
3. 从网络输出到图像立方体
已知对象模型角点 xo、预测 R,t 后:
xc=Rxo+t,u∼Kxc
其中 K 为相机内参。公开实现支持 YCB-V 与 LINEMOD 的对象尺寸表,将八个角点投影后按固定拓扑连线。这个后处理只用于解码和展示,不会像 PnP 或 ICP 那样修改预测 pose。
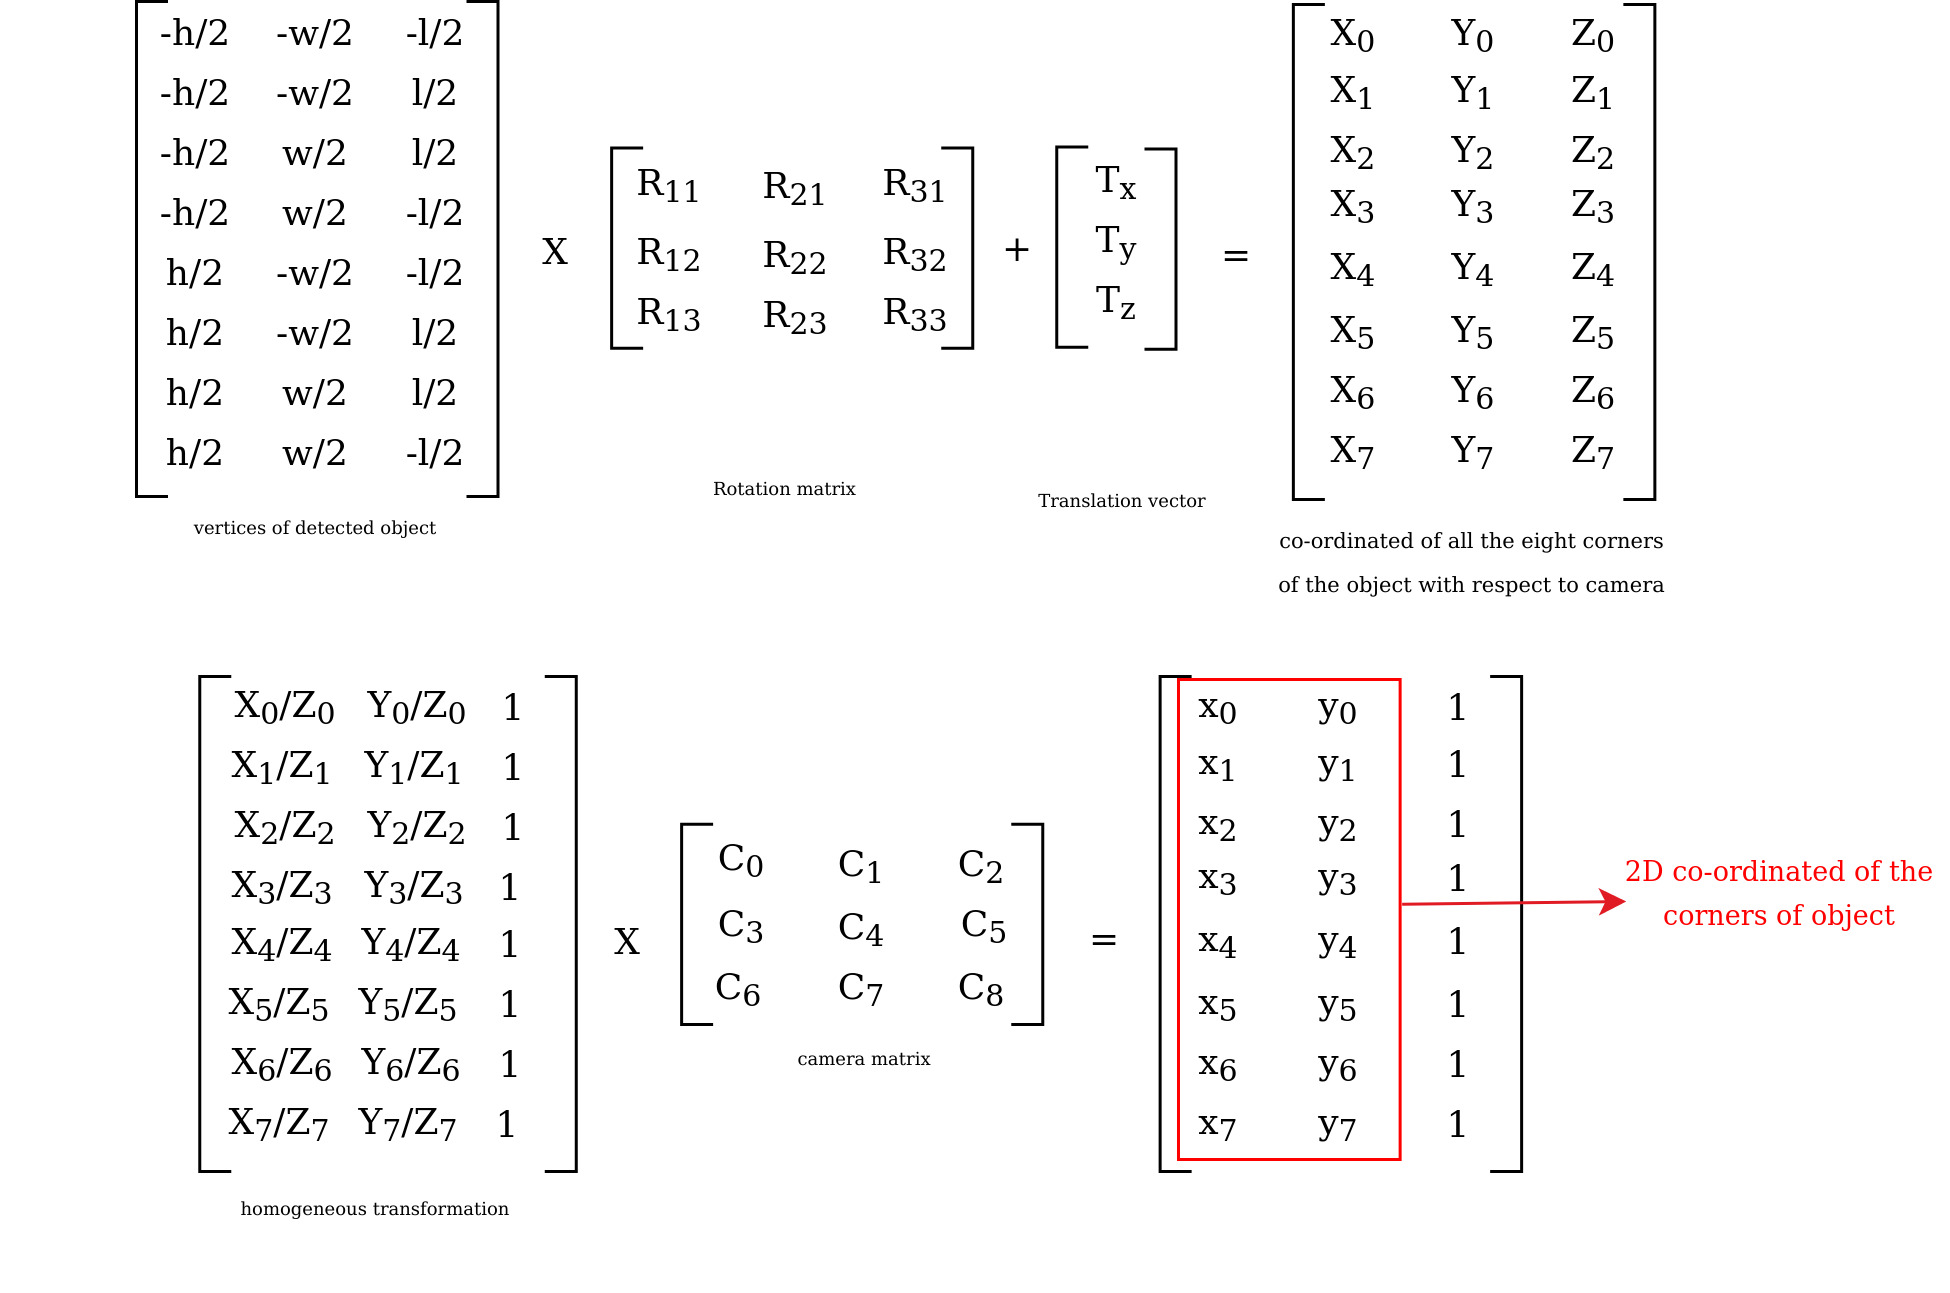 直接回归并不等于“不需要几何”:相机内参、对象坐标系和尺寸仍决定预测如何投影与评测。来源:Texas Instruments 作者公开实现 docs_data/3dto2d.jpg;版权归原作者所有,本站仅作学术解读。
4. 如何评价这条路线
4.1 有利场景
- 类别和对象集合固定,训练数据充足;
- 需要单帧、多对象、低延迟;
- 部署环境不方便集成 RANSAC、PnP 或迭代渲染;
- 硬件编译链对标准 CNN/ONNX 支持成熟。作者仓库给出 640×480 输入的模型和 TI TIDL 全硬件加速路径。
4.2 风险场景
- 未见物体:网络没有 CAD/template 条件输入,不能自然迁移到新实例;
- 强遮挡:缺少显式局部对应和几何一致性检查;
- 对称物体:直接监督单一 rotation 可能和观测等价类冲突;
- 域变化:端到端回归容易把背景、纹理和数据集相机统计吸收到位姿先验中。
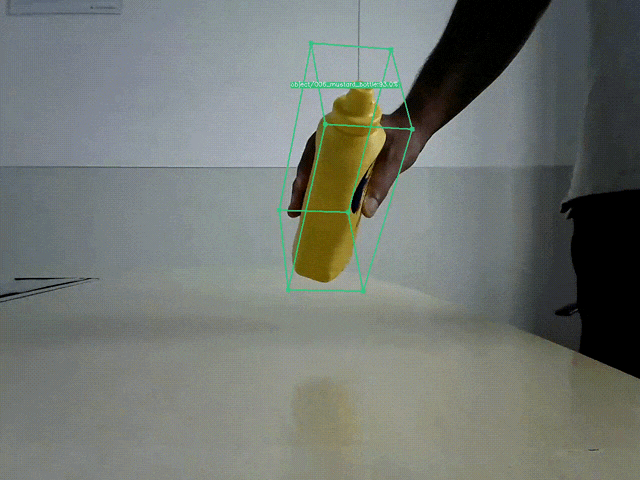 设备演示体现的是短推理链和多目标输出能力;视觉上对齐的 cuboid 不能替代 ADD-S/AUC 的严格定量评测。来源:Texas Instruments 作者公开演示;版权归原作者所有,本站仅作学术解读。
5. 证据边界
本次整理能够确认 DOI、作者、会议、页码、YOLOX 基础、单阶段多对象设定、15 维公开输出和无 PnP/refinement 的部署路径;但 IEEE 正文 PDF 未能稳定取得,因此没有把搜索摘要中的零散数字写成实验结论。这个处理有意保守:详情页的“精读”应区分已核验事实与推断,而不是为凑完整度生成无法追溯的精度表。
6. 复现与公平比较清单
复现时至少要锁定四类约定。第一是对象坐标系和长度单位:CAD 若用毫米、translation 却按米训练,投影可能看似合理但 ADD 会整体失真。第二是 rotation 后处理:前两列不能只做叉乘,还应先归一化并以 Gram–Schmidt 保证正交,否则输出未必属于 SO(3)。第三是可见性与正样本分配:检测 head 的 box / class target 与 pose target 必须指向同一实例,重遮挡下若标签分配漂移,pose loss 会监督到错误对象。第四是对称性:评测可用 ADD-S,并不自动解决训练时多个等价 rotation 标签相互冲突的问题。
与 correspondence + PnP 方法做速度比较时,应计入完整链路:YOLO-6D-Pose 包括图像预处理、NMS、15 维解码和投影;对手则包括检测、关键点 / 坐标预测、RANSAC/PnP 与可能的 refinement。只比较主干网络 FLOPs 会夸大或掩盖单阶段方案的实际优势。精度比较也必须使用相同检测框、输入分辨率、YCB-V / LM-O 划分和对称物协议。
7. 可改进方向
一个自然扩展是把直接回归作为 proposal,再预测 pose uncertainty:高置信目标直接输出,低置信或对称目标进入 PnP / refinement。这样保留大多数帧的短路径,同时不要求单一 head 在所有困难条件下都承担最终几何判决。另一个方向是加入 CAD / template 条件,使网络从“每个训练对象一个隐式类别记忆”转向可泛化的对象条件 pose;代价是重新引入匹配与渲染成本。
8. 我的判断
YOLO-6D-Pose 的长期意义是证明标准 detector head 可以承载 6D pose,并进入工业边缘编译链。若你优先考虑速度和维护成本,它是值得复现的基线;若优先考虑新物体泛化、强遮挡或精细操作,建议把它作为快速 proposal/initial pose,再接显式 correspondence 或 refinement,而不是要求一个直接回归头承担全部几何推理。
