论文精读笔记:You Only Pose Once
1. 核心判断
- 论文:arXiv 2508.14965
- 项目 / 代码:项目页 · 官方实现
- 核心问题:类别级 9DoF pose 是否必须经过“检测 / 分割 → 裁剪 → 伪深度或形状先验 → 单对象 pose 网络”这一长链条?
- 核心回答:不必。把 9DoF 参数绑定到 detection transformer 的 object query,并让 3D pose 参与 query matching,单个 set-prediction 网络就能同时检测和估计场景内所有实例。
- 我的判断:YOPO 的价值在于建立了一个强、简洁且可扩展的 RGB-only baseline。它没有消除单目几何歧义,而是证明良好的 query 表征、参数化与 assignment 足以大幅缩小和复杂多阶段系统的差距。
2. 一句话定位
YOPO 是“检测即位姿”的类别级实现:DINO query 一次预测 c,R,t,s,box-conditioned translation 负责把图像几何接回三维,6D-aware Hungarian cost 负责让正确 query 得到正确监督。
2.1 图表导读
| 图表 | 应该看什么 |
|---|
| Figure 1 | “无 CAD / mask / pseudo-depth”描述的是输入和外部模块,不等于无 9D 标签。 |
| Figure 2 | 检测头与四个 pose MLP 如何共享 query;平移并非直接裸回归三维向量。 |
| Table II / VII | CAMERA25、REAL275、HouseCat6D 的训练域和类别数不同,不应只取一个最好数字概括。 |
| Inference Time & Bottleneck Analysis | R50 / Swin-L 的速度见正文计时段;pose head 很轻,主干与 transformer 才是瓶颈。 |
| Table III–VI | 组件、6D-aware matching / loss、box-conditioned center/depth 与 2D box 监督消融。 |
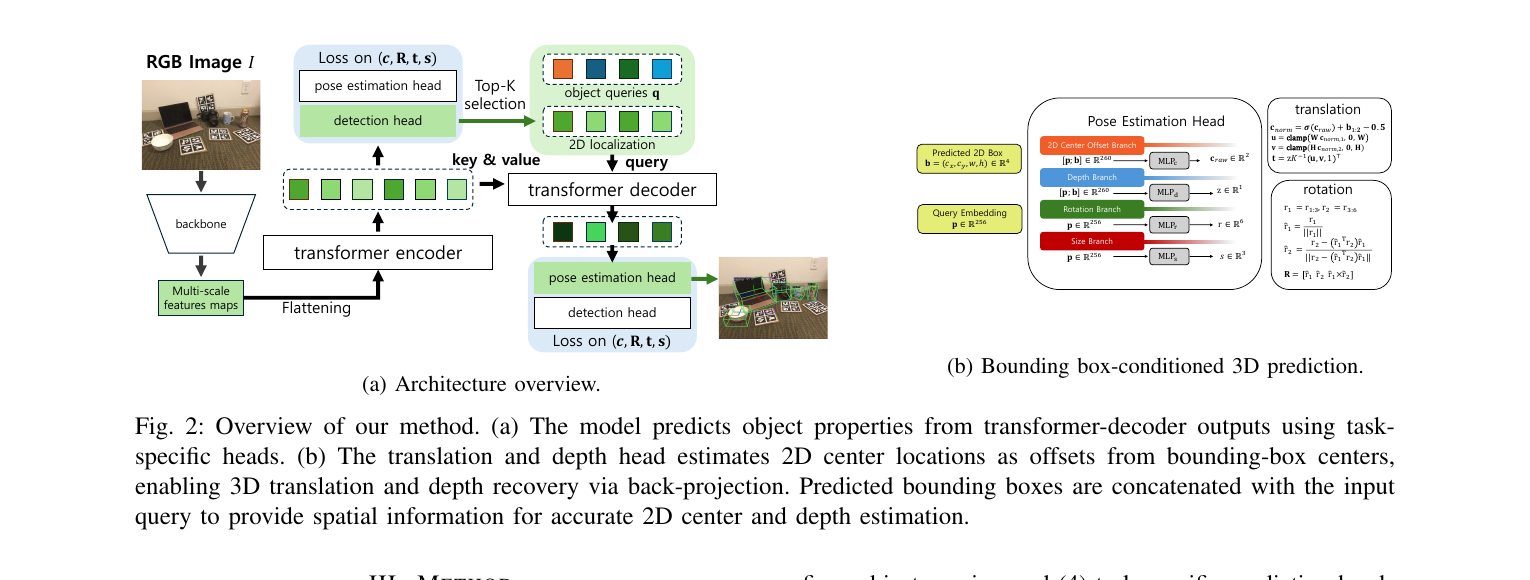 原论文 Figure 2:DINO 特征与 object query 进入检测头和 pose head;中心 offset、深度、旋转、尺度分别回归,训练时 6D pose 也参与 Hungarian assignment。来源:YOPO 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
3. 问题设定
给定单张单目 RGB I 和相机内参 K,模型输出无序集合
{(cj,Rj,tj,sj)}j=1M,
其中 cj 是类别,Rj∈SO(3),tj∈R3,sj∈R>03 是沿三个规范轴的 metric size。因为测试对象是训练类别内的新实例,不同实例尺寸不同,完整状态常被称为 9DoF。
“minimalist”的准确边界如下:
- 推理不需要 CAD、实例 mask、深度或 pseudo-depth。
- 不需要先检测再逐对象 crop,所有 query 在一张图上并行输出。
- 训练仍需要类别、9D pose、相机内参;2D box 可以由标注的 3D cuboid 投影产生,因此不必另行人工框标注。
- 这是封闭类别集合内的 category-level 泛化,不是任意开放词汇对象。
4. 从 DETR 到 9DoF pose
4.1 共享 object query
YOPO 采用 DINO 式 detection transformer。backbone 产生多尺度图像特征,encoder / decoder 维护一组 object query;每个 query 本来输出 class 和 box,现在再接四个 MLP 分支。关键是检测和 pose 不再由两个模型通过 crop 传递,而在 query 表征上共享上下文。
这种设计有两个工程收益:
- 多对象计算几乎不随实例数量线性增加,避免逐框运行 pose 网络。
- 检测与 pose 可以共同塑造 query,使一个 query 既知道“图中哪里有物体”,也知道“该实例的三维状态”。
4.2 旋转与尺度
旋转头使用连续 6D representation,再正交化为旋转矩阵,避免欧拉角周期断点和单位四元数双覆盖带来的训练不连续。尺度头回归 sx,sy,sz,因此输出的不只是中心 pose,而是可投影的定向三维包围盒。
4.3 box-conditioned translation
直接从全局 query 回归 tx,ty,tz 很难,因为单目图像中的像素位置、物体成像尺寸和真实尺寸互相耦合。YOPO 将平移拆成:
- 三维中心投影相对预测 2D box 中心的二维 offset;
- 相机光轴方向的 depth;
- 由内参 K 将像素中心和 depth 反投影得到 t。
center 和 depth 分支都显式拼接预测 box。box 提供图像尺度、长宽比和位置,是不增加外部模态的廉价几何条件。消融中同时条件化 center 和 depth 相对仅 center 改善主指标,作者将其作为折中默认配置;其他分支组合仍可能在个别指标更高,不能说它在所有指标都最优。
4.4 6D-aware Hungarian matching
DETR 训练需要在固定数量预测 query 与真值对象之间寻找一一对应。若 cost 只看 class 和 2D box,两个重叠或相邻对象可能在二维上近似等价,却有完全不同的 rotation / translation;assignment 一旦错,pose head 就收到矛盾监督。
YOPO 在 Hungarian cost 中加入:
- 预测与真值 translation 的欧氏距离;
- 考虑对象对称性的 rotation geodesic distance。
对称性处理很重要:瓶、碗等物体绕轴旋转可能外观 / 几何等价,不能强迫 query 区分不可观察的角度。论文还单独缩放 matching cost 与最终 loss 的权重;消融说明二者需要共同调节,收益随指标与配置变化,不能概括为组合在所有指标都优于只改其中一处。
5. 主结果
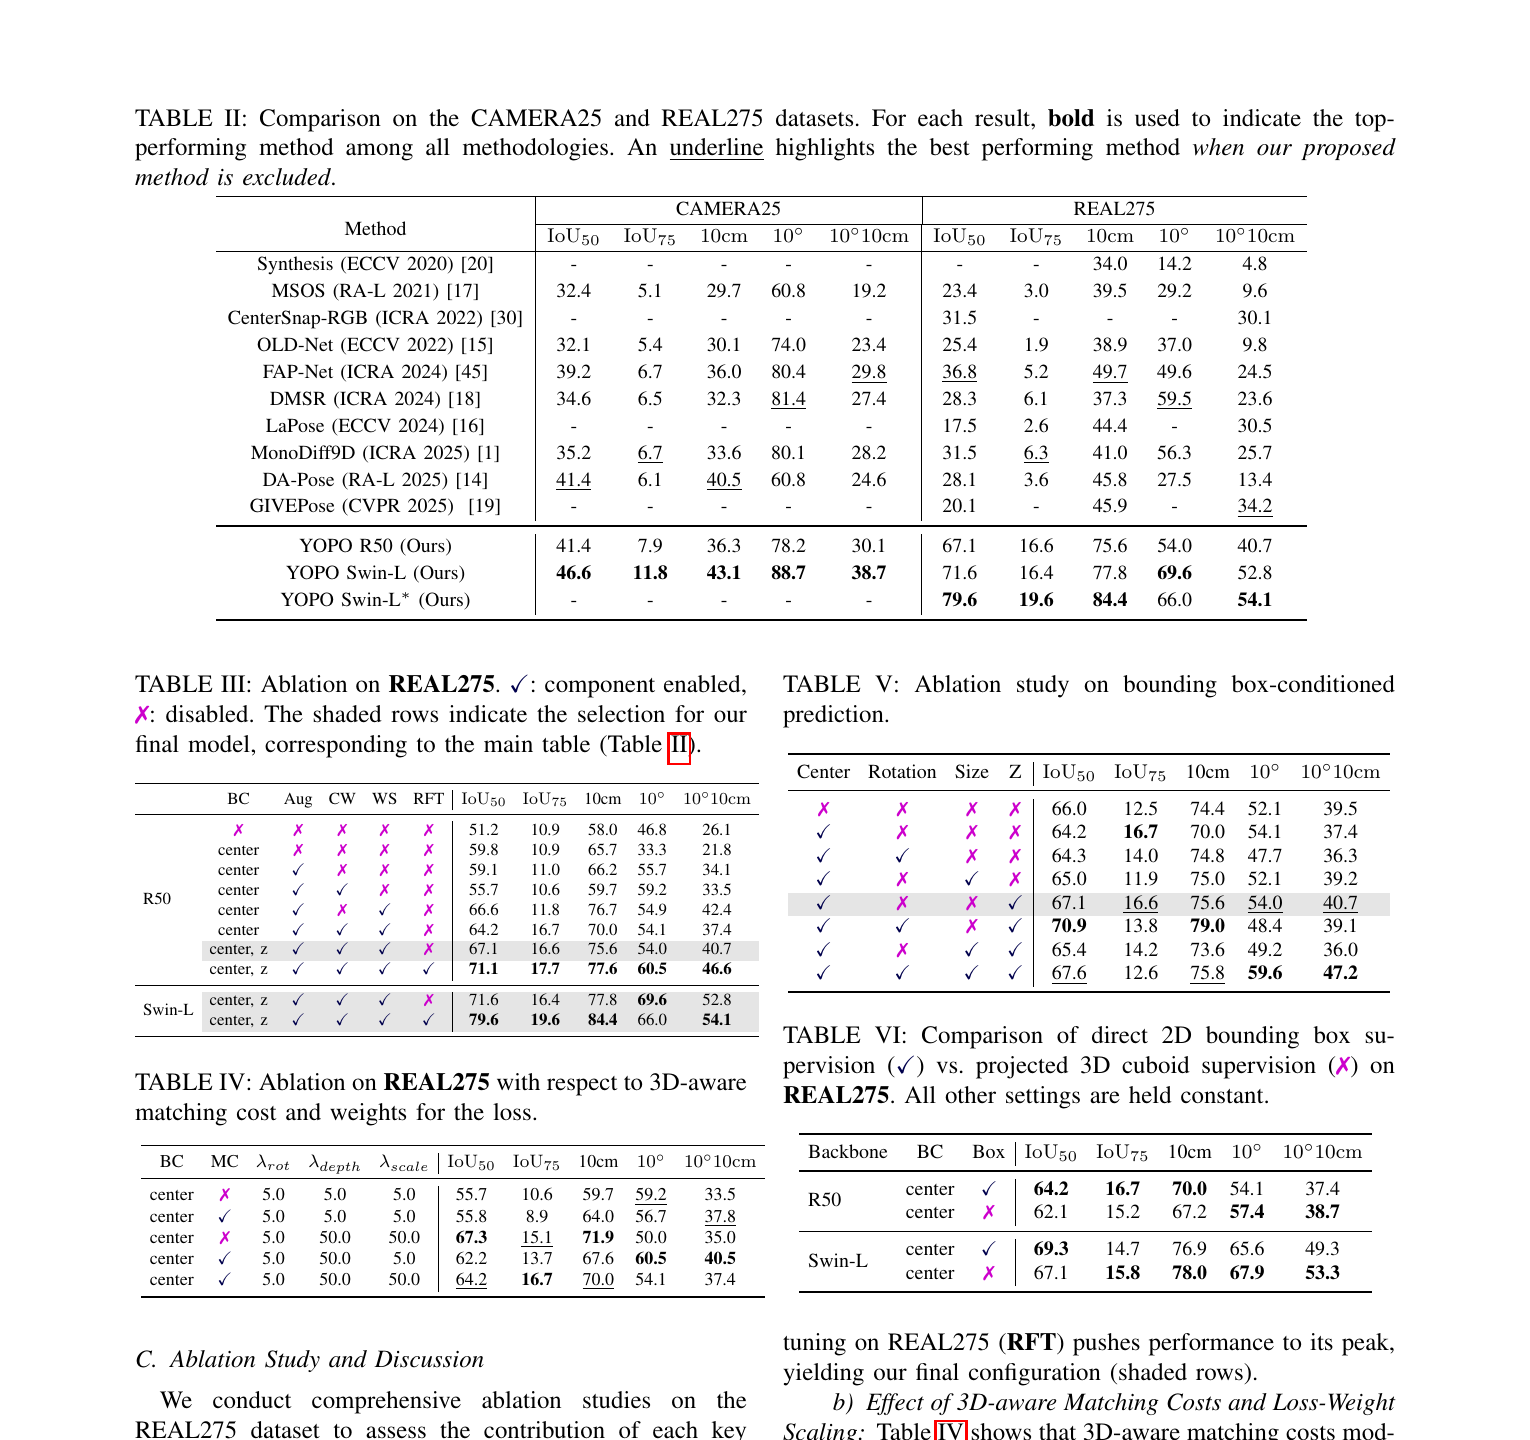 原论文 Table II–VI:CAMERA25 / REAL275 主结果和组件、matching / loss、box conditioning、2D box 监督消融;本裁图没有 HouseCat6D 或速度结果。主模型使用 CAMERA25 与 REAL275 联合训练,星号版本再在 REAL275 上继续微调,需按训练阶段区分。来源:YOPO 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
5.1 CAMERA25 与 REAL275
使用 Swin-L、完成 CAMERA25 与 REAL275 联合训练但未做额外真实集微调时,YOPO 在 CAMERA25 得到:
- IoU50 / IoU75:46.6 / 11.8
- 10 cm:43.1
- 10°:88.7
- 10°10 cm:38.7
在 REAL275 上,同一模型为:
- IoU50 / IoU75:71.6 / 16.4
- 10 cm:77.8
- 10°:69.6(项目页当前展示的复现表为 67.6,论文版本与网页存在小版本差异,应以所用 checkpoint / PDF 版本为准)
- 10°10 cm:52.8
在联合训练主模型上,再用 REAL275 真实训练划分微调的 YOPO* 达到 79.6 IoU50 与 54.1 的 10°10 cm。星号表示额外真实集微调阶段;主模型本来已使用 REAL275,二者都不能被用于证明“只用合成 CAMERA25 也达到 79.6”。站内摘要保留微调条件。
R50 版本在 REAL275 已有 67.1 IoU50、40.7 的 10°10 cm,说明收益不只来自更大的 Swin-L backbone。与论文列出的 RGB-only 基线相比,YOPO 在 IoU50 和组合阈值上均有明显优势。
5.2 与 RGB-D 方法的关系
“closing much of the gap”比“全面超过 RGB-D”更准确。YOPO 的 IoU50 很强,但 IoU75 仅约 16–20%,严格 rotation–translation 联合阈值也仍有空间。SpotPose 等强 RGB-D 方法在细粒度几何指标上明显更好。单目 RGB 缺少直接深度观测,YOPO 靠类别先验和图像尺度统计估计 metric depth / size;在训练分布相近的数据集有效,但不是几何上可观测性的根本改变。
5.3 HouseCat6D
HouseCat6D 有更多类别、更复杂真实背景和类别内形状变化,是比 NOCS 更困难的测试。YOPO 仍取得有竞争力结果,但相对 RGB-D 系统差距扩大。这说明“统一架构”有扩展性,类别 / 场景分布变化仍是 RGB-only 的主要风险。
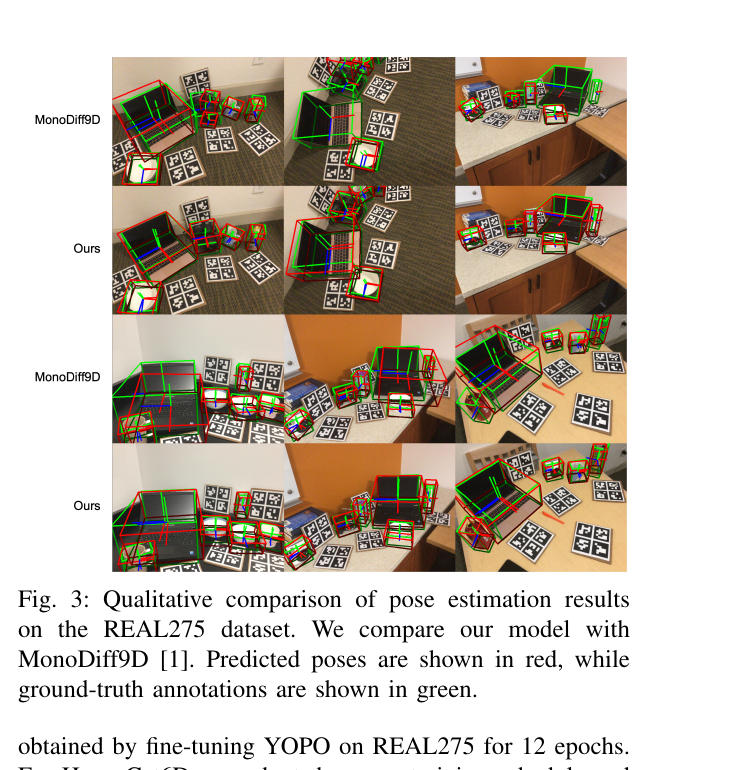 原论文 Figure 3:REAL275 定性结果,红色为预测 pose 投影,绿色为真值;YOPO 能在同一张图中同时输出多个对象,但遮挡和相似外观下仍可见局部偏差。来源:YOPO 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
6. 速度与“只做一次”
论文在 A6000 上报告:
| 骨干 | 总延迟 | 约合帧率 |
|---|
| ResNet-50 | 49.7 ms | 约 20 FPS |
| Swin-L | 124.5 ms | 约 8 FPS |
pose head 约 9.1 ms,主要耗时来自 backbone 与 transformer。因此,“You Only Pose Once”主要表达单阶段 / 单次 forward,不应被理解成所有配置都高帧率。若机器人控制需要 30–60 Hz,R50 仍需进一步优化;若场景对象数量很多,它相比逐对象方法的并行优势会更明显。
7. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| 无 CAD、mask、pseudo-depth 的端到端 RGB-only 9DoF | 推理链条确实满足;训练仍需 9D 标签、固定类别和内参,应把“无额外数据”理解为不额外依赖几何资产 / 辅助模块。 |
| 三个 benchmark 达到 SOTA | 对论文定义的 RGB-only 比较成立;跨 RGB-D 模态或不同真实微调条件时需重新分组。 |
| 结构 minimalist | 成立:pose 扩展主要是轻量 MLP、参数化和 matching cost;底座 DINO / Swin-L 本身仍是大型 detector。 |
| 适合机器人实时感知 | R50 约 20 FPS 有可用性;Swin-L 约 8 FPS,且结果未包含后续抓取规划。 |
8. 复现要点
- 使用官方仓库中的 NOCS / HouseCat6D 数据预处理与坐标约定,尤其检查轴顺序、尺度单位与对称类别。
- 区分
YOPO Swin-L 和 YOPO* Swin-L;后者加载前者后在 NOCS real 上继续 fine-tune。
- 2D box 虽由 3D cuboid 自动投影,也要处理截断、图像边界和不可见角点。
- Hungarian matching 的 translation / symmetry rotation cost 权重与训练 loss 权重不是同一超参数。
- 推理时相机内参必须和 resize / crop 后图像尺度一致,否则 box-conditioned center 正确也会反投影出错误平移。
- 报告速度时写明 backbone、输入分辨率、GPU、对象数量和是否包含数据加载 / NMS;DETR 虽无传统 NMS,前后处理仍有开销。
9. 局限与研究启发
- 单目尺度—深度耦合:类别先验能学习统计规律,却会对超出训练尺寸分布的实例产生系统偏差。
- 固定类别:query 可以检测多个实例,但类别词表仍由训练集限定;与 open-vocabulary 目标发现结合是自然下一步。
- 检测和 pose 的梯度冲突:共享 query 简洁,也可能让 2D AP 与精细 3D pose 优化方向不一致,可考虑不确定性加权或分阶段冻结。
- 没有显式几何验证:预测一次完成,部署方便;若需要高精度,可在 YOPO 后接轻量 RGB-D / render-and-compare refinement,把它作为初始化器而不是最终答案。
- 很好的研究基线:任何声称“辅助深度 / CAD / mask 必不可少”的新方法,都应至少和 YOPO 这种无外部几何资产的统一 detector 比较,证明新增复杂度换来了什么。
YOPO 最重要的结论不是“DETR 已经解决类别级 9DoF”,而是:过去不少性能损失来自模块边界和 assignment,而非任务必然要求复杂级联。把 3D 状态纳入 query 训练后,一条很简单的 RGB-only 路线已经足够强。
