论文精读笔记:Zero123-6D
1. 核心判断
Zero123-6D 探索的不是“扩散直接生成 pose”,而是把新视图生成当作参考库扩增器。它用生成视图填补少量真实 reference 的方位空洞,再用 DINO 做跨实例语义匹配,用 NeUS 几何把 2D matches 提升为 2D–3D 对应并优化 pose。
“zero-shot”指 EscherNet、DINO 等模型无需在目标类别上重新训练;但每个参考集合仍要离线重建 NeUS,且 reference camera poses 已知。因此它不是完全无需对象 / 类别准备的单图 pose。
2. 任务设定
输入:
- 同一类别内一个 reference instance 的 N 张 RGB 与相机 pose;
- 一个不同实例的 query RGB;
- 不要求 query / reference depth。
输出 query 相对 reference 类别坐标的 6D pose。实验在 CO3D bicycle、car、chair、laptop、motorcycle 五类上评测 1 / 3 / 5 reference views。
类别级跨实例匹配比实例级更难,因为相同语义部件在形状、比例和纹理上变化。论文依赖 DINO 的语义对应,而非传统局部纹理特征。
3. 方法流程
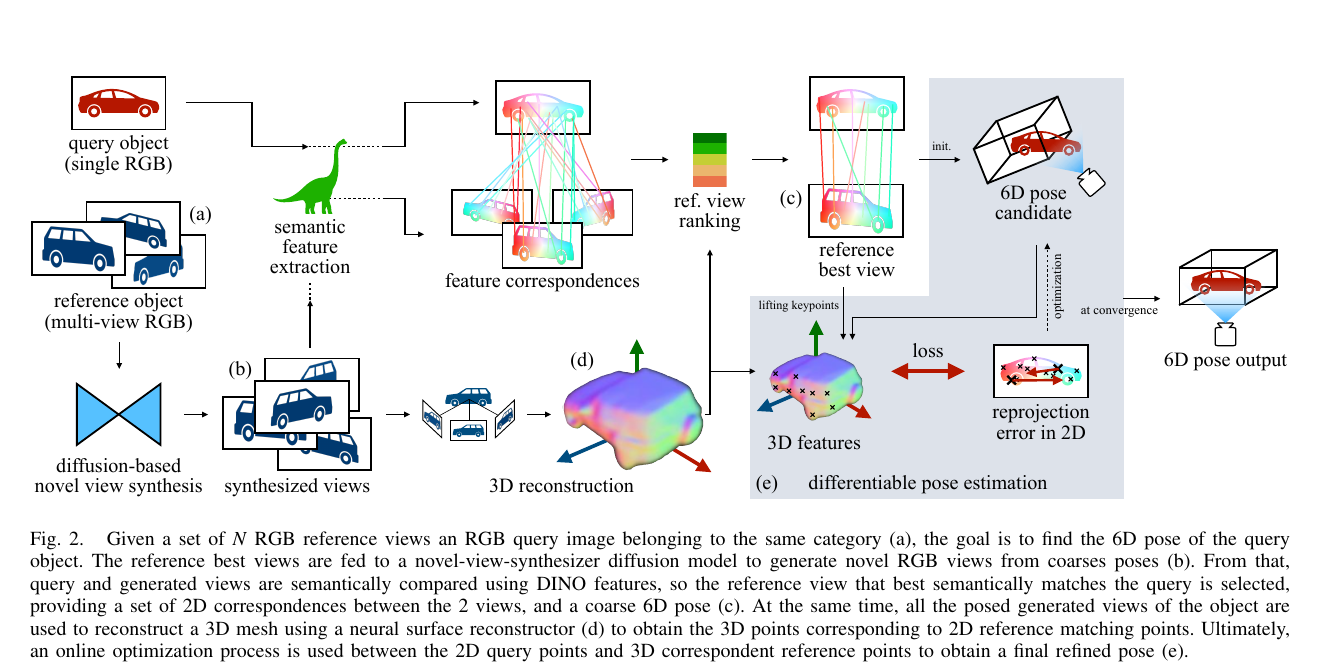 原论文 Figure 2。生成视图既用于扩大匹配候选,也与真实 reference 一起构建 NeUS 类别几何。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
3.1 Novel-view synthesis
EscherNet 根据输入 reference RGB、其相机姿态与目标球面相机姿态生成新视角。相机由 azimuth、elevation、radius 控制;从稀疏真实视图扩展到较密的方位集合。
生成图的作用有两个:
- 提高 query 附近有相似 reference view 的概率;
- 为 NeUS 提供更完整的多视图外观和隐式 depth。
风险是扩散模型会改变细节 / 几何,尤其类别内新实例与 reference 不同;生成图越多不一定意味着对应越可靠。
3.2 Best-view matching 与 coarse pose
Query 和 reference set 提取 DINO feature,计算跨图语义对应与相似度;将最佳 reference view 的已知相机姿态作为 coarse query pose。
这个阶段把 pose 搜索转化成离散 viewpoint retrieval。若参考库覆盖足够密,初值较好;若最佳匹配来自语义相似但几何不同的生成视图,后续优化可能落入局部极值。
3.3 NeUS 与在线 refinement
真实 / 生成 reference 及相机 pose 用于重建 NeUS。对最佳视图上的匹配点,NeUS 渲染 depth 并反投影为 3D reference points。优化 query pose,使这些 3D 点在 query 中的投影接近 DINO 匹配像素。
论文运行最多 1000 次迭代,并以 loss 早停;单次约 2–4 s(RTX 3090)。三维重建是离线一次性成本,不计入每 query 时间。
4. CO3D 结果
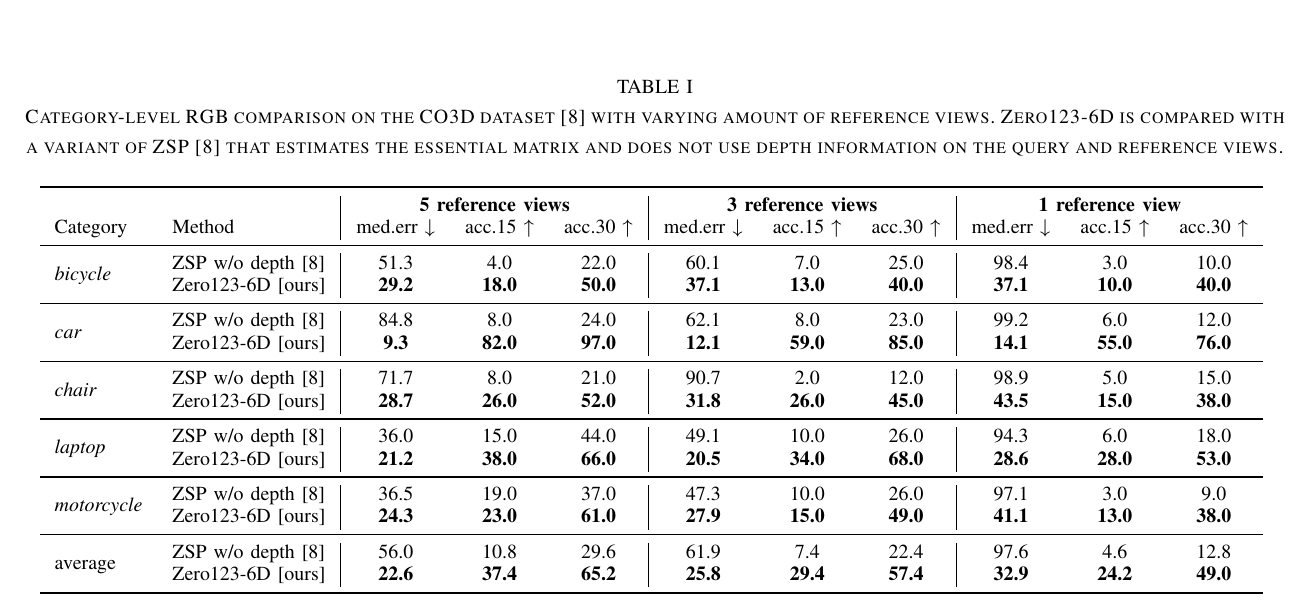 原论文 Table I。ZSP w/o depth 使用 essential matrix;Zero123-6D 通过生成参考和隐式几何降低旋转误差。来源:作者公开稿;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
平均结果:
| 原始 reference 数 | 方法 | median rot. error↓ | acc15↑ | acc30↑ |
|---|
| 5 | ZSP w/o depth | 56.0 | 10.8 | 29.6 |
| 5 | Zero123-6D | 22.6 | 37.4 | 65.2 |
| 3 | ZSP w/o depth | 61.9 | 7.4 | 22.4 |
| 3 | Zero123-6D | 25.8 | 29.4 | 57.4 |
| 1 | ZSP w/o depth | 97.6 | 4.6 | 12.8 |
| 1 | Zero123-6D | 32.9 | 24.2 | 49.0 |
即使 1 张真实 reference,生成参考仍把平均中位旋转误差从 97.6° 降至 32.9°。car 类收益尤其大:5 refs 为 9.3°,1 ref 为 14.1°;chair 形状变化更大,1 ref 仍为 43.5°。
论文另与带 depth 的 ZSP 比较:真实 query/reference depth 足够时,ZSP 可更强;Zero123-6D 的贡献是取消 depth 仍保持接近性能。消融也显示,仅 best-view selection 已受益于生成视图,NeUS 2D–3D refinement 进一步提升。
5. 批判性分析
- 优势:将预训练生成模型用于 pose reference coverage,问题清晰;RGB-only;1-view 设置收益显著。
- 限制:离线 NeUS 按 reference set 构建;2–4 s 在线优化;reference pose 需已知;扩散 / NeUS 几何幻觉未量化。
- 任务边界:是已知类别跨实例 pose,不是开放类别,也不是单 reference instance-level 绝对 pose。
- 公平性:与 depth 方法比较时必须说明传感器条件;在线时间也应与离线重建分开。
6. 复现清单
- 固定 EscherNet 版本、目标视角网格与生成随机种子;
- 保存每个生成视图的 DINO matching score,分析幻觉视图是否被选中;
- 记录 NeUS 训练时间、尺度和 coordinate frame;
- 明确 correspondence 数量、outlier filtering、优化 learning rate 和早停;
- 按类别报告 reference 数量敏感性和 symmetry;
- 评测加入平移、尺度与生成几何误差,而不只看旋转。
7. 最终评价
Zero123-6D 证明生成式 novel view 可以成为 pose 系统的“参考数据增广”,尤其在单张真实参考时价值明显。它的下一步不是生成更多图,而是为生成视图建立几何置信度,并把 2–4 秒优化压缩成可部署求解器。
