论文精读笔记:FoundationPose: Unified 6D Pose Estimation and Tracking of Novel Objects
1. 基本信息
- 标题:FoundationPose: Unified 6D Pose Estimation and Tracking of Novel Objects
- 作者 / 机构:Bowen Wen、Wei Yang、Jan Kautz、Stan Birchfield;NVIDIA
- 年份 / 会议:2024 / CVPR Highlight
- 论文链接:arXiv:2312.08344
- 代码 / 项目页:NVlabs/FoundationPose / 项目页
- 阅读模式:精读
2. 一句话定位
FoundationPose 用“给定任意候选 T=(R,t) 都能渲染对象 RGB-D”作为统一接口:CAD 已知时直接 rasterize,CAD 缺失时由少量 posed RGB-D references 拟合 object-centric SDF / appearance field 并提取可渲染 mesh。由此,同一个 Transformer RefineNet 可以修正多组全局 pose hypotheses,同一个带跨候选 self-attention 的 ScoreNet 可以从中选择最优 pose;视频中只保留精修,获得约 32 Hz 的 tracking。
方法输入与输出
| 项目 | 内容(本站整理) |
|---|
| 推理输入 | 当前 RGB-D、K、可渲染物体表示;全局 estimation 用外部检测区域初始化候选,tracking 由上一帧 TCO 初始化精修,不要求每帧重新提供 GT mask。 |
| 最终输出 | 最佳物体到相机变换 TCO∈SE(3);tracking 输出逐帧的 TCO,t。RefineNet 的修正量和 ScoreNet 的候选得分是内部输出。 |
| 训练输入 | 合成 RGB-D、训练 CAD、GT object poses / masks,以及扰动候选 pose 对应的 renderings;LLM / diffusion 用于生成训练纹理,不是在线输入。 |
| 训练目标 | 共享 RefineNet 学位姿更新,ScoreNet 学候选排序。model-free 另有每物体建模优化:以 posed RGB-D references 监督 SDF / appearance field,输出可渲染 mesh,这不等同于微调 pose networks。 |
| 输出细节 | TCO 的旋转为 R∈SO(3)、平移为 t∈R3;坐标由 CAD 或重建物体定义,深度与 mesh 长度单位需统一。没有独立预测类别 size,也不直接输出分割或动作。 |
| 必要条件 | model-based 必需目标 CAD;model-free 必需带可信 pose、标定与目标区域的 RGB-D references 及离线 field fitting。两条分支都需要 renderer、在线 RGB-D 和相机内参。 |
2.1 论文图表导读
| 图表 | 在论文中的位置 | 它证明 / 解释什么 | 阅读注意 |
|---|
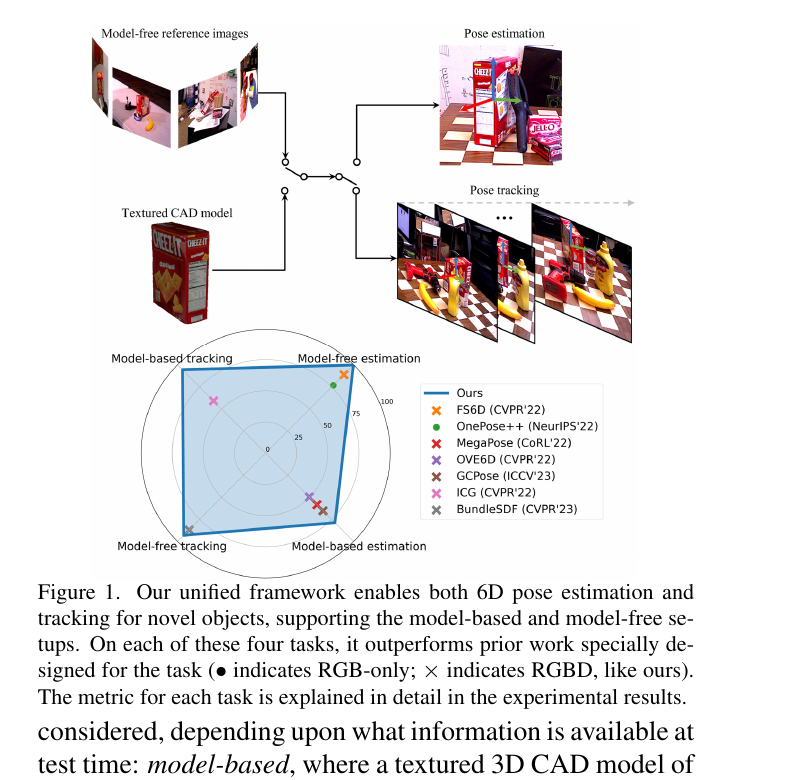
| Figure 1 | 动机与总览 | 一套系统覆盖 model-free / model-based 以及 estimation / tracking | 雷达图的四个轴是不同任务和协议,不能把面积当统一指标 |
| Figure 2 | 端到端框图 | 训练数据、object field、RefineNet、ScoreNet 的依赖关系 | LLM 和 diffusion 在最上方,仅用于合成训练集构造 |
| Figure 3 | 纹理增强 | LLM 生成 prompt 后的 TexFusion 纹理比随机贴图更自然 | 它提升训练外观多样性,不替代对象几何建模 |
| Figure 4 | pose ranking | 第一层比单候选对齐,第二层让所有候选互相比较 | 正确 pose 是相对排序而非独立绝对分类 |
| Tables 1—3 | 单帧估计 | model-free YCB-V / LINEMOD 和 model-based BOP 结果 | 三张表的输入先验和 metric 不同 |
| Tables 4—6 | tracking 与消融 | 统一能力、关键结构和速度-精度边界 | 消融默认是 model-free、16 references,而不是全部任务的平均 |
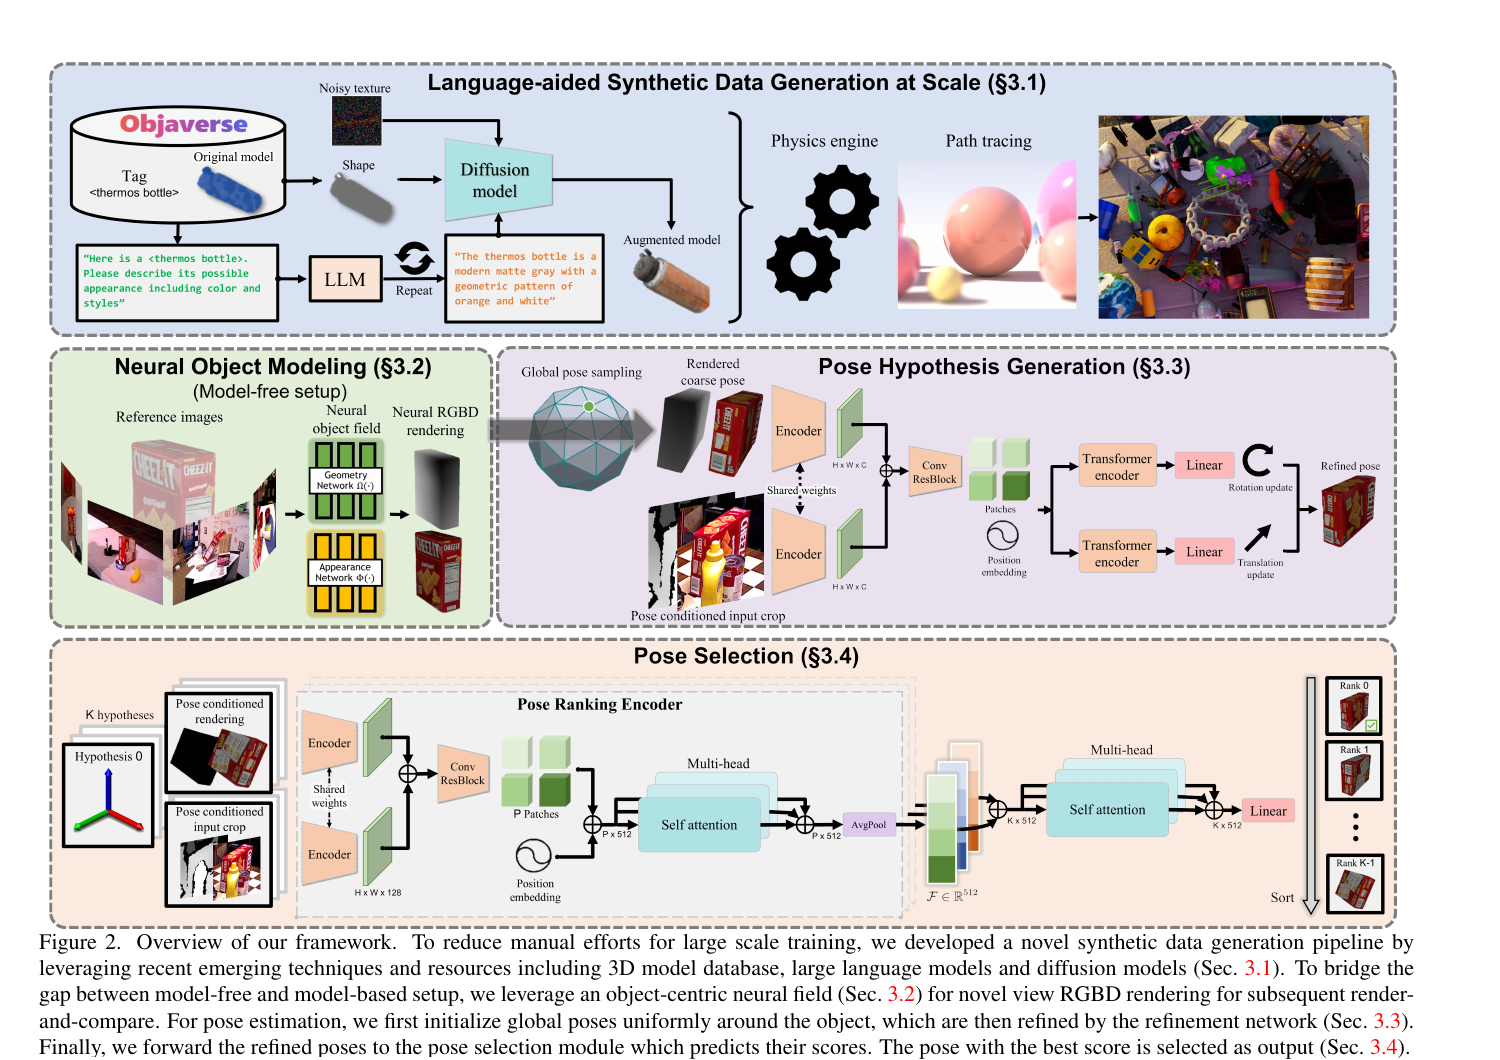 原论文 Figure 2:从离线合成数据生成到 model-free neural object field、候选精修、层级 pose selection 的全流程。CAD-based 模式可跳过左下 neural field,直接提供 render-and-compare 所需渲染。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题定义与前提
对物体坐标中的点 xobj,目标是在相机坐标系预测刚体变换:
xcam=Rxobj+t,R∈SO(3), t∈R3.
FoundationPose 的主张不是“不需要对象先验”,而是同一共享 pose 模型对两种先验工作:
| 设置 | 可用对象先验 | 额外对象准备 | downstream 输入 |
|---|
| model-based | 纹理 CAD mesh | 准备 / 校验 mesh 坐标和尺度 | 由 CAD 在候选 T 下渲染 RGB-D |
| model-free | 少量 reference RGB-D 和每张 object pose | 每对象拟合一次 neural object field,再提取渲染 mesh | 由 field 导出的 mesh 在候选 T 下渲染 RGB-D |
- 共享训练,不做 target fine-tuning:RefineNet 与 ScoreNet 在大规模合成数据上训练,测试新物体不更新其网络权重。
- model-free 的边界:论文称 object field 的 per-object optimization 可在秒级完成且只做一次;它依然是测试对象的建模步骤,reference images 也必须带可信 object-to-camera pose。不能等价为“拿一张未标定图片零准备上线”。
- 检测与深度前提:输入为 RGB-D。单帧初始化时先以 Mask R-CNN 或 CNOS 等现成方法检测目标;论文本身不是 detector。model-based BOP 比较中所有方法使用 Mask R-CNN 2D detections。
- 四项任务:model-based estimation、model-free estimation、model-based tracking、model-free tracking。后两者使用时间连续性,但不是类别级学习或 multi-object 联合 pose solver。
4. 研究脉络与核心切口
4.1 两种历史输入契约
- instance-level CAD pose:训练和测试围绕同一对象实例,CAD 可渲染、可建立 2D-3D 或 3D-3D 对应,但新增对象常需要对象级训练或明确资产。
- model-based novel-object pose:允许测试对象未在训练中见过,只要给 CAD;瓶颈是对未见形状 / 纹理的 render-and-compare 泛化。
- few-shot model-free pose:给 posed reference images 而非 CAD,例如 Gen6D、OnePose、FS6D。它避免显式 mesh,但常依赖 SfM、2D-3D correspondence 或测试时 object-specific adaptation。
- object tracking:有上一帧初值时可减少搜索;传统方法往往仍受 CAD、对象训练或类别先验限制。
4.2 FoundationPose 的选择
它没有为两类先验训练两套 pose networks,而是将差异压缩到渲染器:
R(O,T)→(Irender,Drender).
其中 O 可以是 CAD,也可以是由 neural field 提取的 textured mesh。之后的网络只估计渲染和真实观测在候选 T 下是否一致、应如何更新。这一设计带来可复用性,但渲染质量是整个 model-free 路线的瓶颈。
5. 离线合成数据:LLM 只在训练前出现
5.1 资产和场景
- 训练物体来自 Objaverse 与 Google Scanned Objects (GSO)。Objaverse 选用 Objaverse-LVIS 子集,包含 4 万余对象、1156 个 LVIS 类别。
- 在 NVIDIA Isaac Sim 中做重力 / 物理仿真,随机对象、材质、尺寸、相机、光照,并通过 path tracing 生成 photo-realistic RGB-D 场景和 pose / mask 标签。
- 每个样本可得到 RGB、depth、object pose、camera pose、instance segmentation 和 2D bounding box,供 refinement 与 ranking 训练。
5.2 LLM-aided texture augmentation
随机把 ImageNet / COCO 图贴到 UV 上容易产生接缝,也常把完整背景错误贴到物体上。作者使用两级 prompt:
- 将 Objaverse-LVIS 的类别 tag 填入模板,询问 ChatGPT 该物体可能有的颜色与风格描述。
- 把回答作为 TexFusion 的 text prompt,并与原始 shape、随机噪声纹理一起生成增强材质。
因此语言模型帮助扩大训练外观分布,但不进入测试输入,也不为目标对象生成 pose、mask 或 CAD。Table 6 证明它有增益,但不是最大增益来源:移除后 ADD AUC 从 91.52 到 90.83,ADD-S 从 97.40 到 97.38。
6. Model-free neural object modeling
6.1 表示
若没有 CAD,需要从 posed reference images 得到在任意候选 pose 下的 RGB-D rendering。作者以 object-centric field 表示对象:
- 几何函数 Ω:R3→R 输出 signed distance value;零水平集是物体表面。
- 外观函数 Φ 接收几何网络的中间 feature、表面 normal 和 view direction,输出颜色 c∈R3。
- 3D point 先经过 two-resolution hash encoding,normal 与方向由二阶 spherical harmonics 编码。
它不同于只预测 density 的 NeRF:SDF 对 depth surface 更直接,后续也能用 marching cubes 获取 mesh。模型以每个对象独立优化,无跨物体 shape prior。
6.2 用 RGB-D reference 的监督
射线 r 在深度观测附近的截断表面区域做 volumetric rendering。颜色以 reference RGB 的 L2 监督;几何部分采用 hybrid SDF 的 empty-space、near-surface 与 eikonal regularization。总损失可概括为:
Lfield=wcLc+weLe+wsLs+weikLeik.
这不是 pose 网络的训练损失,而是 model-free 模式的每对象资产准备。论文强调该优化可在 seconds 内完成,之后的 object field 只需训练一次。
6.3 为什么不是每次直接 neural render
优化完 field 后,作者用 marching cubes 从 SDF 零水平集提取 textured mesh,再在推理时以 rasterization 并行渲染多个 pose hypotheses 的 RGB-D。直接用 sphere tracing 在线渲染 depth 的代价在多候选并行时更高。
工程含义:model-free 的核心优势是“unseen object 不需 CAD 与 pose-network fine-tune”,但它把成本移到了 references 的采集、pose 标定和 field fitting;真实系统必须测量这些成本,而不能只报 refinement 网络耗时。
7. Pose hypothesis generation 与 RefineNet
7.1 全局初始化
给定当前 RGB-D:
- detector 给出 2D bbox / mask;bbox 内 median depth 对应的 3D point 给平移初值。
- 以物体为中心构建 icosphere,均匀采样 Ns 个“相机看向中心”的 viewpoints。
- 每个 viewpoint 加 Ni 个离散 in-plane rotations,得到 K=NsNi 个初始 poses。
这种采样把大旋转误差变为候选集覆盖问题;translation 仍是局部初值。tracking 场景已有前一帧结果时,可直接跳过此昂贵步骤。
7.2 Pose-conditioned crop 与精修
对每个粗 pose T:
- 使用 R(O,T) 渲染 RGB-D;
- 将 object origin 投影到 image plane 作为 crop center,以物体直径的略放大投影确定 crop size;
- 从真实观测取同样由候选 pose 条件化的 crop,而不是固定用 detector bbox;
- 两个 RGB-D 输入经共享 CNN encoder,拼接后过 residual block、patch tokenize 和 position embedding;
- 两个 Transformer encoder 分别预测 translation update Δt 与 rotation update ΔR。
更新为:
t+=t+Δt,R+=ΔR⊗R.
Δt 与 ΔR 都在 camera frame 定义,旋转使用 axis-angle。pose-conditioned crop 是该设计的重要细节:当粗 pose 的投影中心不对,crop 本身会产生指向平移误差的反馈;固定 detection crop 则难以做到这点。RefineNet 可重复执行,把更新 pose 再输入下一轮。
7.3 精修监督
RefineNet 使用 L2 回归真实的 translation 和 rotation update:
Lrefine=w1∥Δt−Δtˉ∥2+w2∥ΔR−ΔRˉ∥2.
论文设置两个权重为 1。它不是从图像直接回归全局 pose,而是学习小幅 update,因此与多假设初始化、tracking warm start 天然兼容。
8. ScoreNet:从局部匹配到相对排序
8.1 两级比较
RefineNet 后仍有 K 个 refined poses。ScoreNet 的第一级把每个候选的 rendering 与 observation crop 送入 pose-ranking encoder,得到 Fi∈R512,表示该候选的局部 alignment。
若直接对每个 Fi 做线性投影,就要求网络独立预测绝对 score,容易被相似轮廓、纹理重复和遮挡误导。作者的第二级将
F=[F0,…,FK−1]T∈RK×512
当作 sequence 做 multi-head self-attention,再线性投影出 K 个 scores。该序列无 position encoding,故对候选输入次序不敏感,也可扩展到不同 K。
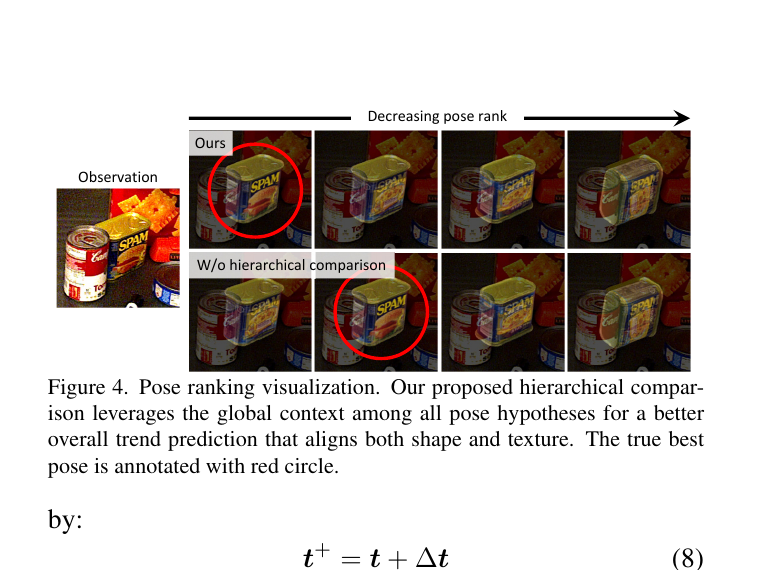 原论文 Figure 4:层级比较能在整个候选集里挑出正确 pose;取消第二层时,局部外观很像但姿态不对的候选可能被置顶。红圈是 GT 最佳候选。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8.2 Pose-conditioned triplet loss
对于 pose pairs,作者按旋转与 GT 的 geodesic distance 定义正、负候选,并用:
L(i+,i−)=max(S(i−)−S(i+)+α,0).
与常规 triplet loss 不同,正负 pair 不共享 anchor,因为每个 pose hypothesis 都对应不同 crop,translation 也会改变输入。为避免“两个候选都远离 GT”时比较没有意义,只有正样本 rotation 足够接近 GT 的 pairs 被保留。论文还测试 InfoNCE;其隐含的 perfect-translation 假设不适合本设定。
9. 实验设计与结果
9.1 数据集、任务组合与协议
| 数据集 | 用途 | 主要难点 / 指标 |
|---|
| YCB-Video | model-free 单帧、tracking、消融 | ADD / ADD-S AUC,物体实例多、对称物体存在 |
| LINEMOD | model-free 单帧 | ADD-0.1d,检验 CAD-free 参考图输入 |
| Occluded-LINEMOD | BOP model-based | clutter / occlusion,BOP AR |
| T-LESS | BOP model-based | textureless、对称 / 工业件,BOP AR |
| YCBInEOAT | model-based tracking | 动态机器人操作、外部遮挡、相机运动 |
model-free setup 中,references 从数据集训练 split 选取,并带 object-pose GT,遵循 FS6D 协议。这是研究用的干净初始化条件,真实部署时参考位姿要由 fiducial、robot calibration、SLAM / SfM 等外部系统获取。
9.2 Model-free 单帧:YCB-Video
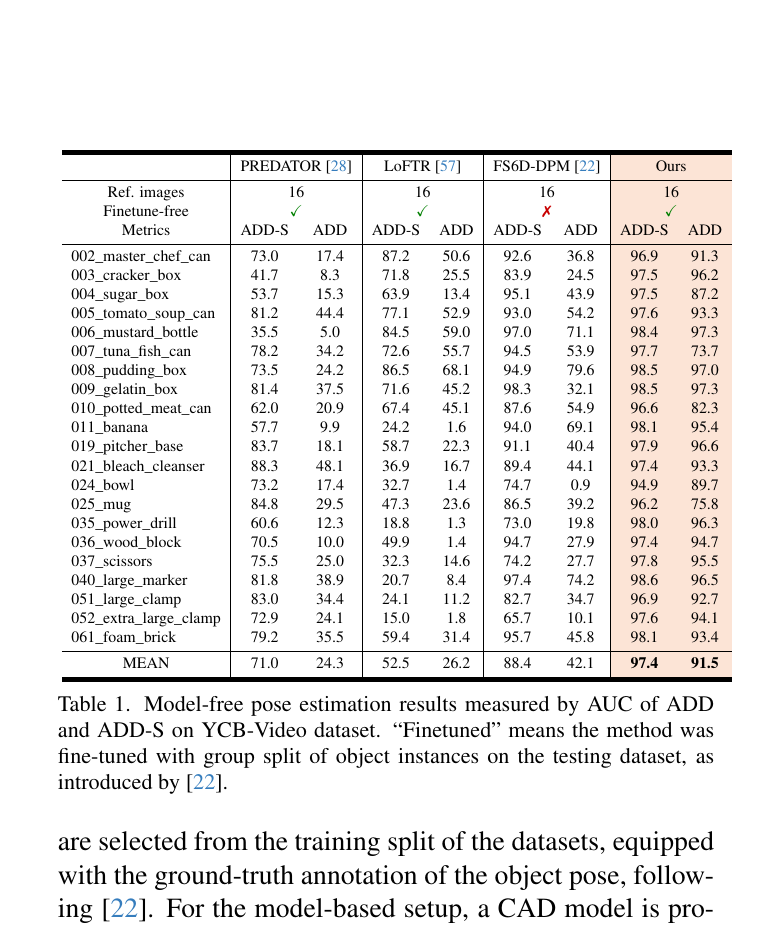 原论文 Table 1:YCB-Video model-free RGB-D pose estimation 的 ADD-S / ADD AUC。FoundationPose 使用 16 refs、免对象 fine-tuning,平均为 97.4 / 91.5。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 方法 | modality | references | target fine-tuning | ADD-S AUC | ADD AUC |
|---|
| PREDATOR | RGB-D | 16 | 否 | 71.0 | 24.3 |
| LoFTR | RGB-D | 16 | 否 | 52.5 | 26.2 |
| FS6D-DPM | RGB-D | 16 | 是 | 88.4 | 42.1 |
| FoundationPose | RGB-D | 16 | 否 | 97.4 | 91.5 |
对应关系式 baseline 在弱纹理或遮挡时更脆弱;FoundationPose 使用 rendering alignment 和全局 ranking,减少对可辨识局部匹配的依赖。但 AUC 上限、reference pose GT、detector / crop 协议仍是这张表的一部分,不能将它解释成开放环境的全链路胜率。
9.3 Model-free LINEMOD 与 model-based BOP
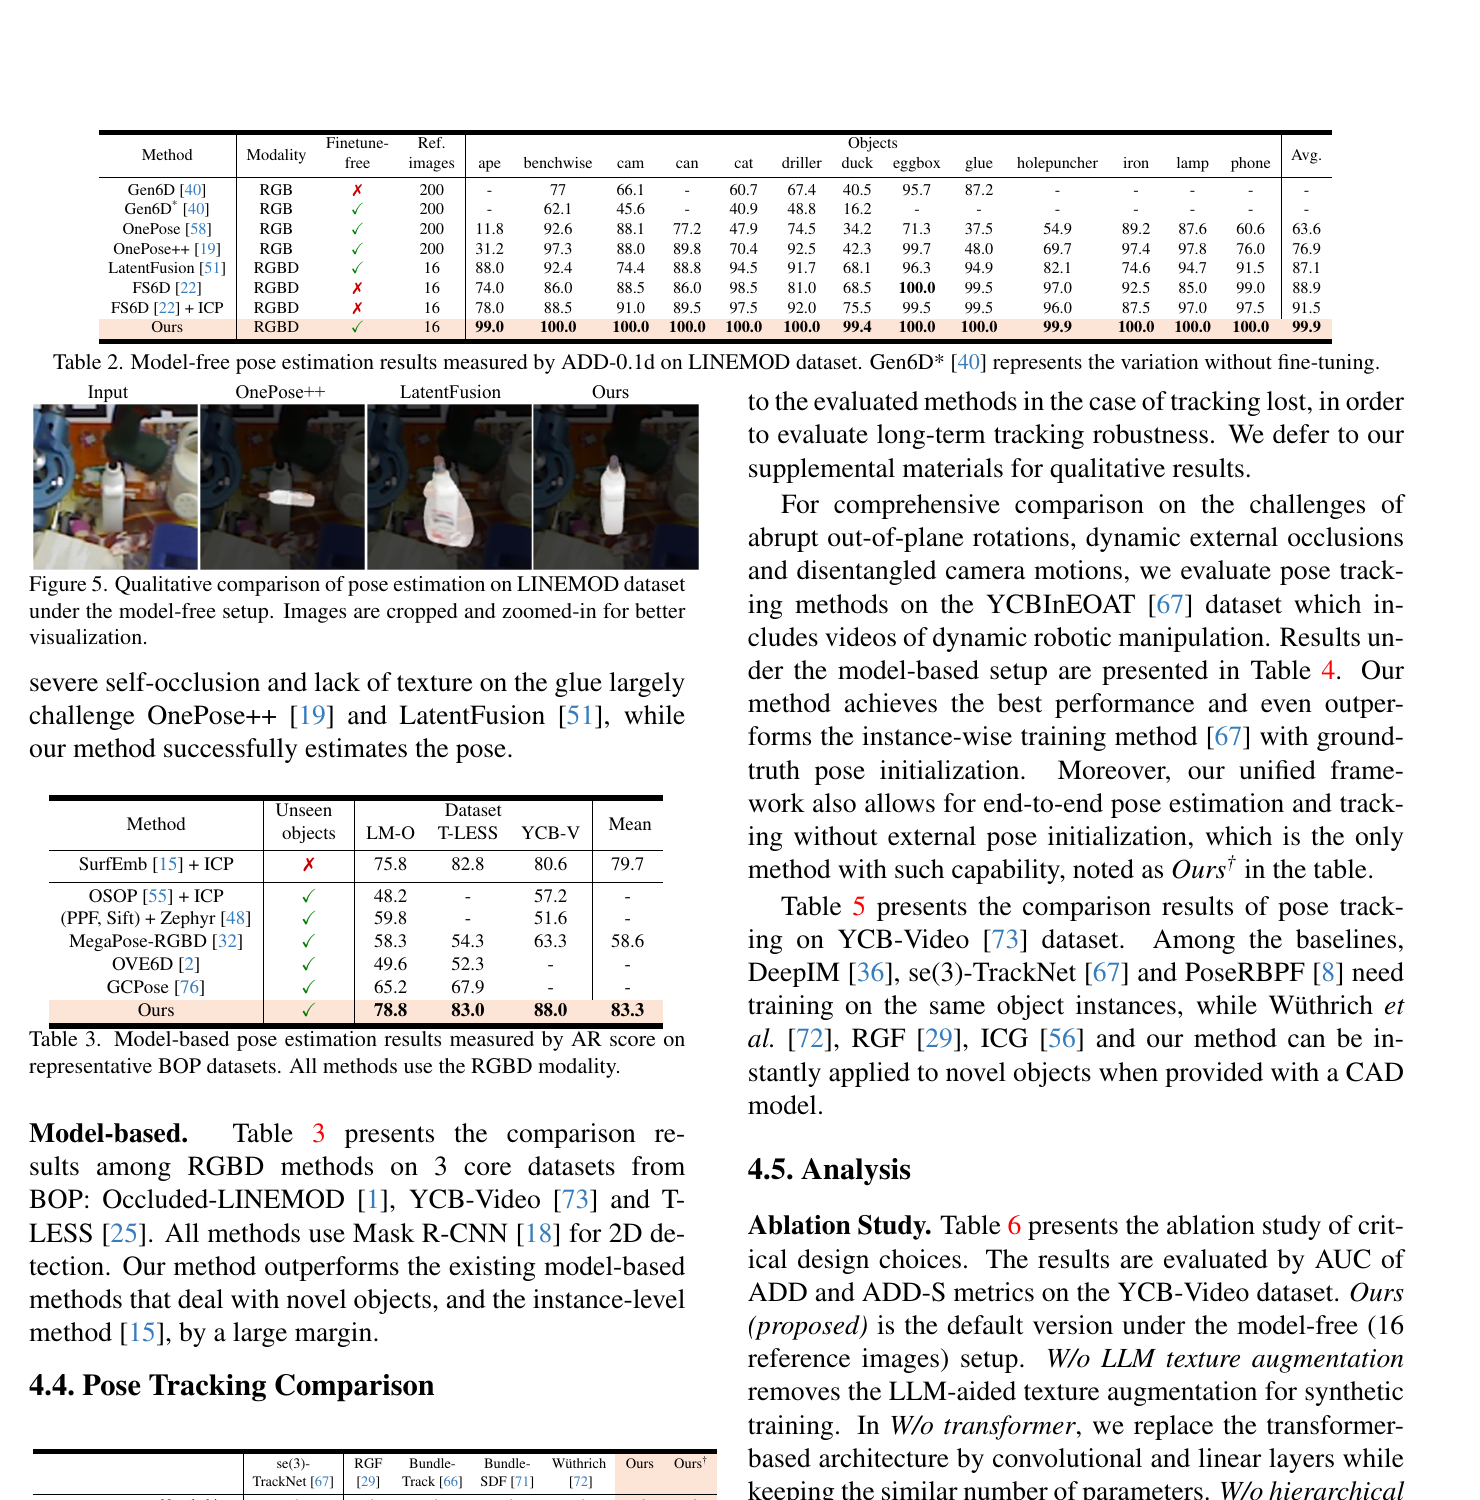 原论文 Tables 2--3:Table 2 的 model-free FoundationPose 使用 RGB-D、16 references,LINEMOD ADD-0.1d 均值为 99.9;Table 3 的 model-based BOP AR 在 LM-O / T-LESS / YCB-V 是 78.8 / 83.0 / 88.0,均值 83.3。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
- Table 2:FoundationPose 的 99.9 是 LINEMOD 13 类别的 ADD-0.1d 平均成功率。OnePose / OnePose++ 报告为 63.6 / 76.0,但用 RGB 和 200 refs;LatentFusion / FS6D 用 RGB-D 16 refs,分别为 87.1 / 88.9。多种输入条件并存,最稳妥的读取是“论文 protocol 下证明了 model-free RGB-D 的能力”,而非脱离条件的统一排行榜。
- Table 3:在 RGB-D、Mask R-CNN 2D detection 下,FoundationPose 的 BOP AR 均值 83.3,高于表内 model-based novel-object methods,如 MegaPose-RGBD 58.6。这个 AR 是 VSD、MSSD、MSPD 的 aggregate recall,不能同 ADD AUC 数值横比。
9.4 Tracking:首次全局估计与后续精修的分工
Table 4 在 YCBInEOAT 上评估 model-based tracking:FoundationPose 的所有帧 ADD-S / ADD AUC 为 96.42 / 93.22;其 model-free unified pipeline 为 96.40 / 93.09,后者会由 pose estimation module 提供初始 pose。
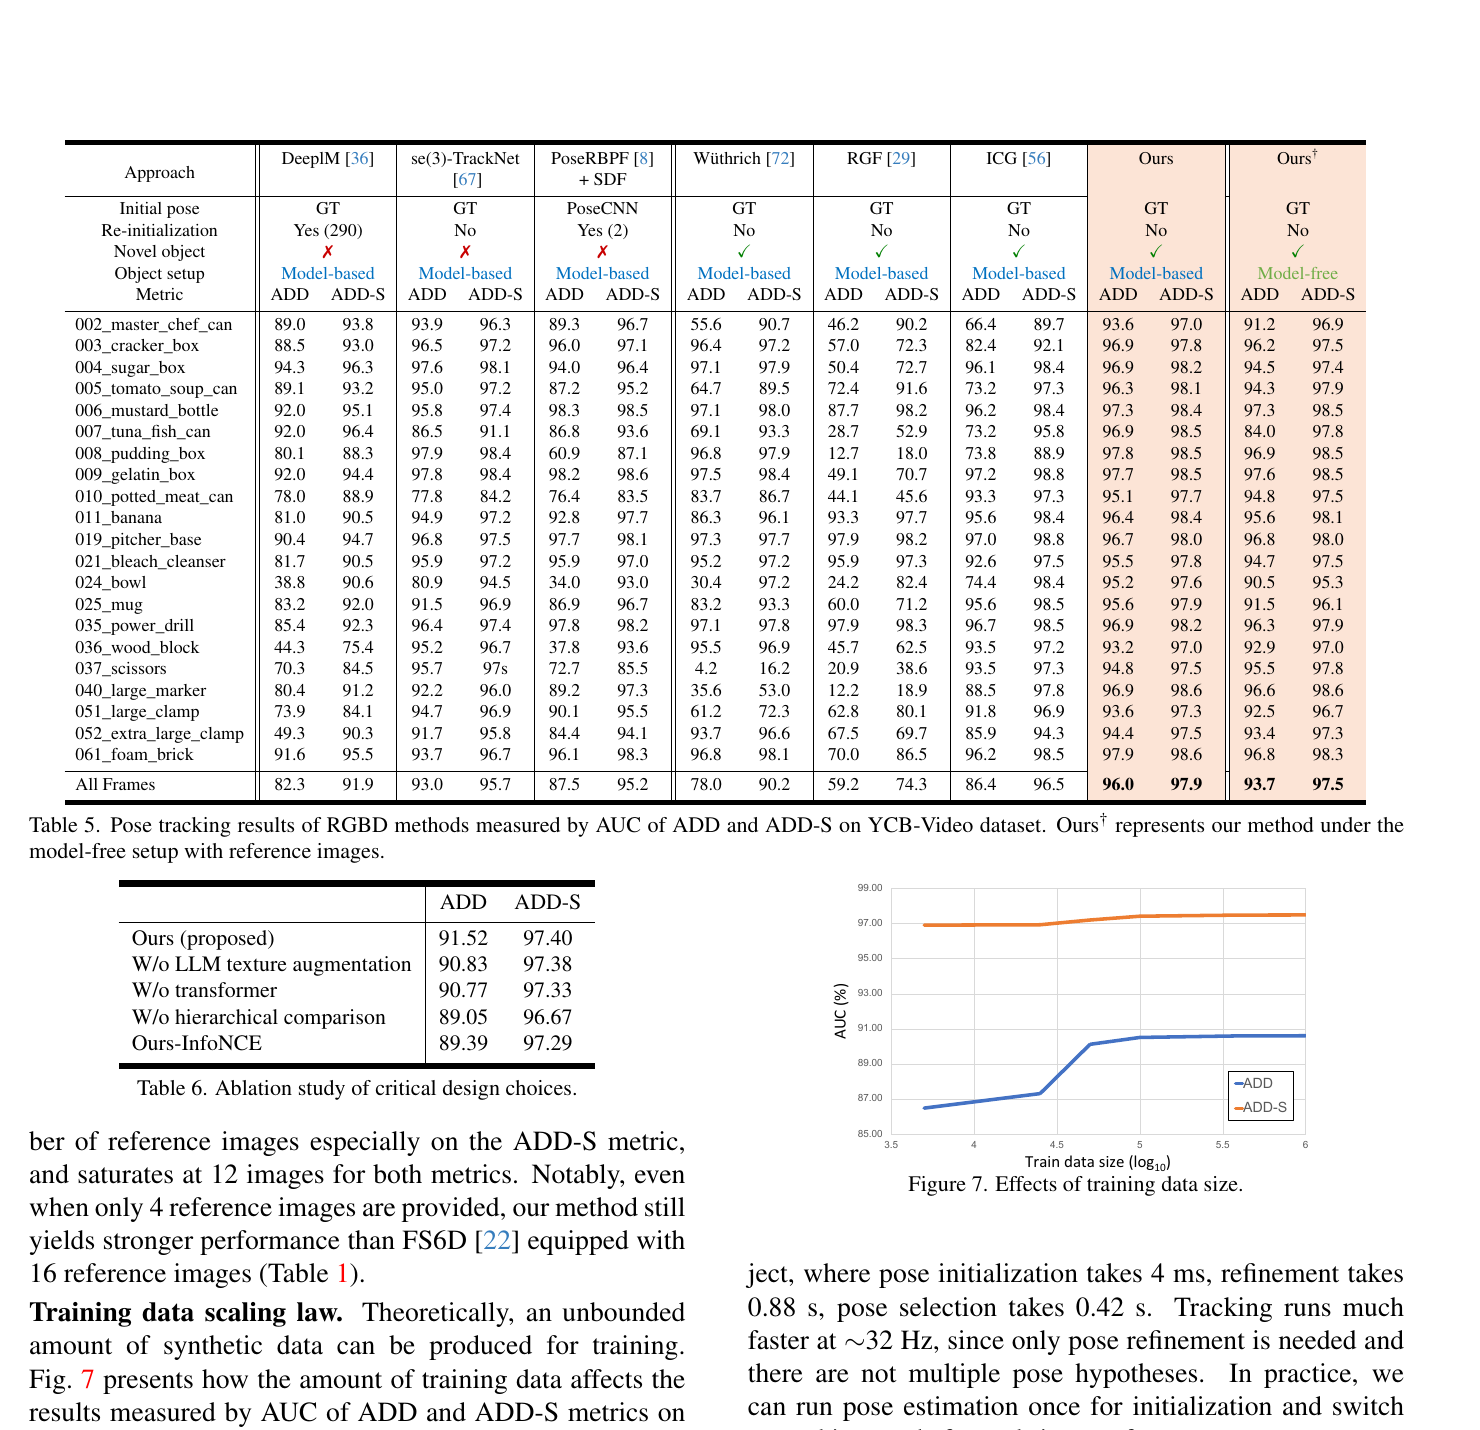 原论文 Tables 5--6:YCB-Video tracking 的 model-based FoundationPose 为 ADD / ADD-S 96.0 / 97.9,model-free 版本为 93.7 / 97.5;下方是 model-free、16-reference 默认设置的关键消融。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Table 5 的 YCB-Video tracking 全帧结果为:
| 方法设置 | ADD AUC | ADD-S AUC | 解读 |
|---|
| Ours, model-based | 96.0 | 97.9 | CAD rendering,tracking 中只需 refinement |
| Ours, model-free | 93.7 | 97.5 | neural-field rendering 也可支持稳定 tracking |
| BundleSDF | 86.4 | 96.5 | 经典 model-free RGB-D tracking 参照 |
| se(3)-TrackNet | 93.0 | 95.7 | model-based、需要同对象训练 |
这支持“首次昂贵 global estimation + 后续轻量精修”的工程结构。它没有证明系统自动从长时间丢失、遮挡后重新找到对象,因为 tracking 失效后的 re-initialization 在各协议中有额外假设。
9.5 消融和 scaling law
默认是 model-free、16 references,YCB-Video ADD / ADD-S AUC:
| 变体 | ADD | ADD-S | 相对默认的解释 |
|---|
| Ours | 91.52 | 97.40 | 全部设计 |
| 无 LLM texture augmentation | 90.83 | 97.38 | 外观多样性对 ADD 有小幅贡献 |
| 无 Transformer | 90.77 | 97.33 | transformer token interaction 有明确贡献 |
| 无 hierarchical comparison | 89.05 | 96.67 | ADD 下降最大,候选集上下文最关键 |
| InfoNCE 替代 ranking loss | 89.39 | 97.29 | perfect translation 假设不匹配本问题 |
- reference count:性能随 references 增加而升,约 12 张后趋于饱和;论文还称只有 4 refs 时已优于使用 16 refs 的 FS6D。它说明 field + ranking 对 reference coverage 敏感,但也表明 few-shot 不是 1-shot。
- training data size:合成数据增大提升 YCB-Video AUC,约 1M 样本后收益饱和。可泛化性很大程度来自数据规模、资产多样性和纹理扩增的共同作用,而非只由网络结构带来。
- latency:Intel i9-10980XE + RTX 3090 上,global estimation 单物体约 1.3 s,由 initialization 4 ms、refinement 0.88 s、selection 0.42 s 构成;tracking 约 32 Hz。应分开报告初始化时延与稳态跟踪帧率。
10. 贡献与证据是否匹配
| 作者声称 | 对应证据 | 判断 |
|---|
| 一套模型支持 model-based / model-free pose 和 tracking | Figure 1、Tables 1—5 | 基本充分;四类任务均有实验,但各自前端和协议不完全相同 |
| neural field 统一无 CAD 与 CAD 渲染 | Section 3.2、model-free tables | 机制合理;真实部署还需量化 reference pose 噪声和 field fitting wall-clock |
| 合成训练下对新物体泛化强 | LINEMOD、BOP、YCB-V | 较充分;训练资产、LLM texture 和扩散模型都参与,归因不能只给 foundation architecture |
| 层级 ranking 是关键设计 | Table 6、Figure 4 | 充分;移除后 ADD 降 2.47 点,是表中最大退化 |
| 可实时 tracking | 32 Hz 报告、Tables 4—5 | 有条件成立;仅后续 refinement 是实时,首次 global estimation 仍约 1.3 s / object |
11. 批判性分析
优点
- 统一点选得对:把“对象如何表示”与“pose 后端如何比较渲染和观测”解耦。CAD、reconstruction mesh、SDF field 都可以复用后面的 Transformer modules。
- 几何而非纯回归:多假设覆盖 + render-and-compare + iterative update 使错误来源可诊断,适合处理新物体时的分布变化。
- ranking 设计合乎任务结构:选择的是候选集中相对最优 pose;self-attention 比每个候选独立 binary score 更贴合这个决策。
- 任务覆盖广:既不只展示单帧 model-free,也不回避 CAD route 和 tracking;结果表把系统的适用范围说得比较完整。
局限与隐含假设
- reference pose 是强先验:model-free references 要有 object poses,benchmark 直接使用 GT。现实里若 pose recovery 有尺度或坐标系漂移,field 和下游 rendering 都会受影响;论文没有系统量化这一误差传播。
- 分割 / 检测不是小问题:初始化平移来自目标 bbox 与深度,遮挡或 detector 误框会让后续 global sampling 的中心偏离。BOP 使用统一 Mask R-CNN 协议并不等于开放词汇、未知对象的 detection 已解决。
- 首次延迟与多物体吞吐:1.3 s 是单 object 的全局初始化。杂乱场景若有多个候选实例,如何调度采样、渲染和 ranking,论文没有给端到端帧预算。
- single rigid object 假设:结论也将超越单刚体 state estimation 列为未来工作;关节、软体、透明、高镜面对象的 neural field 和 pose ambiguity 都未系统验证。
- 训练资产可复现性:LLM / diffusion augmentation 的完整数据链受模型与许可限制影响。复现实验时应明确使用了哪些公开权重 / 数据,而不是把全部效果默认归为开源仓库可直接复现。
不应误读的结论
- 不是“LLM 在测试时让 pose 更准”:LLM 只产出训练用材质 prompts。
- 不是“model-free 完全无需对象建模”:它以 per-object field fitting 替代 CAD 准备。
- 不是“32 Hz 的端到端首次定位”:32 Hz 来自已有初值时只跑 refinement;单帧全局估计为约 1.3 s。
- 不是“所有背景下都优于所有 instance-level 方法”:各表的 reference、depth、detector、初始 pose 和 metric 协议不同,比较须逐任务进行。
12. 真实部署建议
- 资产路径选择:已有可靠 CAD 时优先 model-based;无 CAD 但可在上架 / 标定阶段获得多视角 RGB-D 和 poses 时使用 model-free。
- 初始化与追踪分层:把 1.3 s 的全局估计作为新目标进入或 tracking 丢失时的恢复动作;常态采用轻量 refinement。需要为 detector conf、crop inlier、ranking margin 设计 re-initialization 触发器。
- 必须记录的系统指标:reference count 和覆盖、reference pose 来源 / 误差、neural field fitting 时长、mesh extraction 成功率、detector mask IoU、首次初始化成功率、tracking 丢失后的恢复率和总 wall-clock。
- 风险场景压测:纹理重复、近似对称、透明 / 金属反光、深度空洞、快速外部遮挡、reference pose systematic drift、多个相邻同类对象。
13. 对我的研究的启发
- 可直接借鉴:以“可在任意 pose 渲染 RGB-D”的对象表示接口解耦 model source 和 pose backend;pose-conditioned crop;通过多候选 self-attention 做 relative ranking;首次全局初始化与稳态 tracking 分离。
- 可做的改进:把 field / render uncertainty 显式送入 ScoreNet;让 ranking 输出 calibrated confidence 来驱动重初始化;用 symmetry-aware multi-hypothesis 表示替代单一 R;用更稳健的 reference pose / depth noise augmentation 缩小 GT-reference 与真实采集的差距。
- baseline 配置:比较时至少分别报告 FoundationPose 的 model-based 和 model-free,固定 RGB-D、reference count、reference pose 获得方式、detector、是否 GT initialization、是否允许 per-object field fitting,并将 single-frame latency 与 tracking FPS 分开。
- 待验证问题:若 reference poses 由 SfM / robot hand-eye calibration 而非 GT 给出,field 与 pose AUC 的退化曲线如何?若不使用受限 diffusion augmentation,LLM texture 的增益是否仍稳定?多物体共享 GPU 渲染时,global ranking 的吞吐是否能满足机器人节拍?