论文精读笔记:Learning Better Keypoints for Multi-Object 6DoF Pose Estimation
1. 基本信息
2. 一句话定位
KeyGNet 把关键点式 6DoF pose estimator 中通常由 FPS 或 3D bounding box 固定的关键点布局改成离线学习问题:用 EdgeConv 网络在一个数据集的对象可见表面上生成一套 3D 关键点,使各关键点对应的投票目标分布更相似、关键点又足够分散,再用它替换 PVNet、PVN3D、RCVPose 的原始关键点监督;最大收益集中在多个对象共享一个回归器的 MIMO 设置。
论文真正回答的是:给定一个 voting-based pose network,什么样的 3D keypoints 更容易被同一个网络同时回归?
2.1 论文图表导读
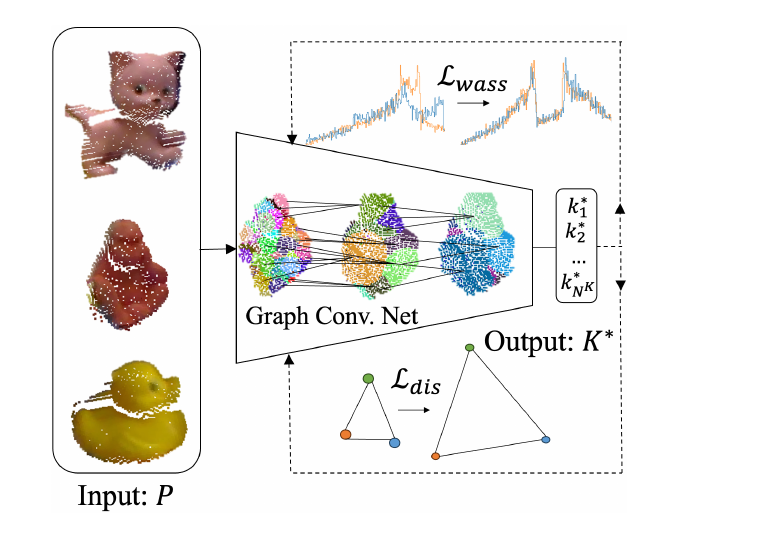
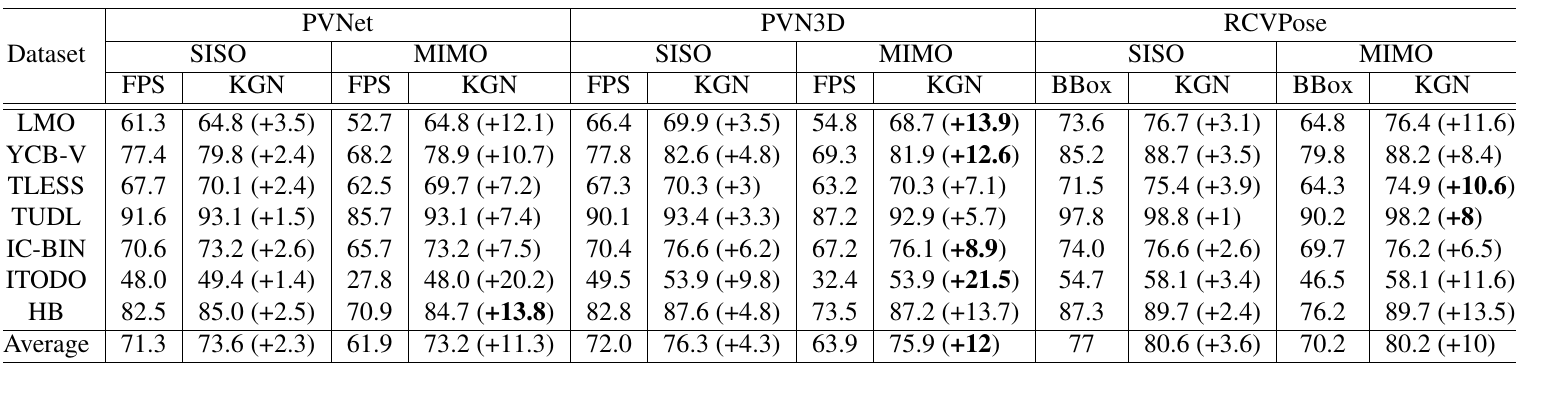
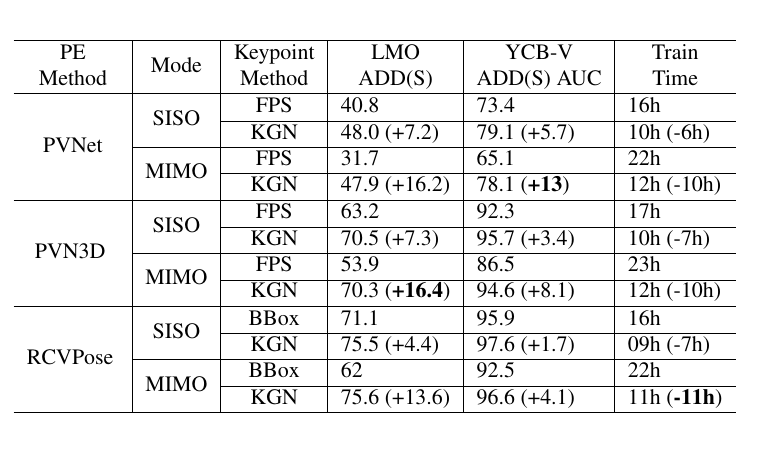
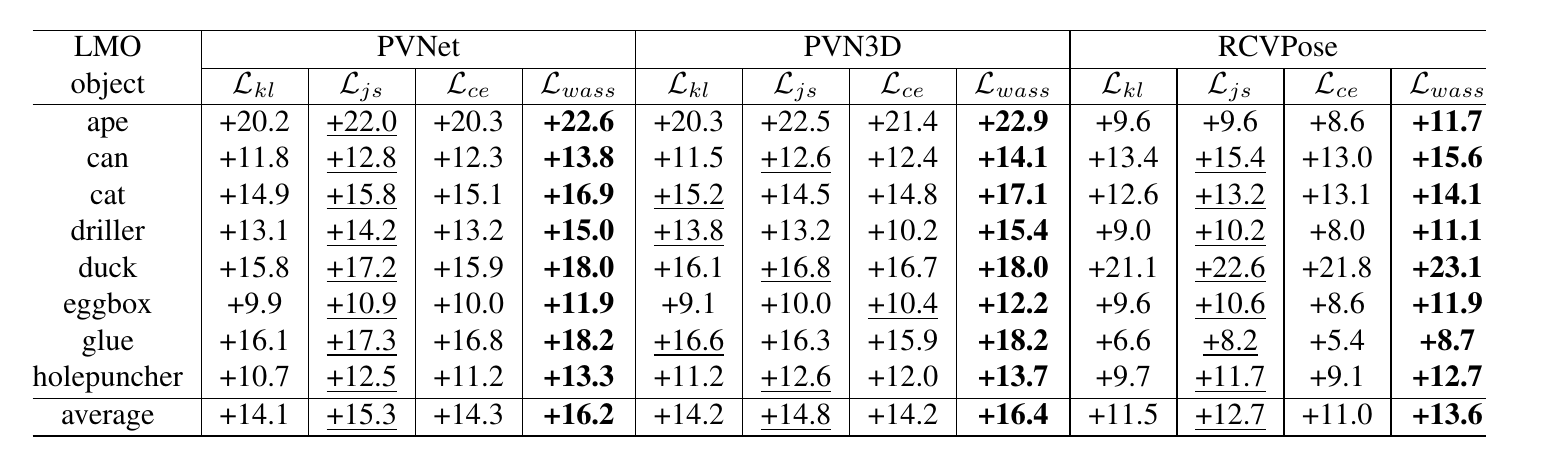
图表 对应主张 本页如何使用 Figure 3 可见表面点经过图网络输出关键点,distribution similarity 与 dispersion 是两个相互制约的目标。 解释输入 / 输出、损失以及 KeyGNet 与下游 pose estimator 的边界。 Table 1 关键点学习的收益不局限于一个数据集或一种 voting representation。 核对七个 BOP core datasets、三个 backbone 和 SISO / MIMO 的完整结果。 Table 2 优化后的关键点既提高 ADD(S),也缩短下游训练时间。 分开讨论准确率收益、收敛收益和不可直接外推的工程条件。 Table 5 Wasserstein loss 相对 KL / JS / cross entropy 更适合比较可能不重叠的 vote distributions。 判断核心损失是否有消融支撑。
原论文 Figure 3:KeyGNet 接收训练数据中对象可见表面的点集合,输出归一化对象坐标中的关键点集合。上方的 Wasserstein 项拉近不同关键点投票分布,下方的 dispersion 项拉开关键点空间位置。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
3.1 论文优化的不是“场景关键点检测器”
这里的 keypoint 有两个层次,容易混淆:
对象坐标系中的预定义 3D keypoints :训练前先决定,例如 FPS 表面点或 BBox corners;图像 / 点云中的 keypoint estimates :下游网络根据像素或点的 votes 在当前场景中恢复这些关键点的位置。
KeyGNet 学习的是第 1 层。它不是直接在测试图像中检测兴趣点,也不替代下游的 voting、RANSAC、PnP 或刚体变换估计。
3.2 输入、输出与先验
阶段 输入 输出 必要先验 KeyGNet 训练 一个数据集内对象的非遮挡可见彩色表面点;这些点由训练图像、相机内参、GT pose 和对象几何恢复 N K N_K N K 已知对象模型、GT pose、相机标定、可见表面 / segment 下游 pose 网络训练 原方法的 RGB 或 RGB-D 输入;把 FPS / BBox 关键点标签换成 KeyGNet 输出 投票回归器参数 对象身份、关键点坐标、原方法所需监督 下游推理 PVNet 的 RGB,或 PVN3D / RCVPose 所需的 RGB-D / point cloud 等 对象 rotation 与 translation 原方法的 detector / mask、intrinsics、depth 等依赖保持不变
3.3 实例级、已知对象,而非开放世界
论文属于 instance-level、seen-object 6DoF pose。
KeyGNet 在训练时见过目标数据集的对象表面;没有验证 novel object 上直接生成可用关键点。
“multi-object” 指多个已知对象共享一条网络,而不是无类别标签的开放世界检测。
同一数据集 MIMO 模式下输出一组可供全部对象共享的关键点布局,但不同 dataset、不同 voting representation 仍分别训练 KeyGNet。
3.4 SISO / MIMO 的定义
SISO:Single Instance of a Single Object。每个对象独立训练一套下游网络。MIMO:Multiple Instances of Multiple Objects。一个下游网络同时回归多个对象、多个关键点。
MIMO 更节约部署模型数量,也更接近复杂场景,但共享回归器需要拟合更异质的目标分布。论文的关键观察是:启发式关键点会放大这种异质性,而 KeyGNet 能显著缩小 SISO→MIMO gap。
4. 研究脉络
4.1 关键点式 6DoF pose 的常见结构
关键点式方法通常包含:
在对象坐标系定义若干 3D keypoints;
网络从场景 RGB / RGB-D 对每个像素或 3D 点预测与这些 keypoints 的关系;
通过 voting 聚合出场景中的 keypoint positions;
用 2D–3D PnP 或 3D–3D rigid alignment 求 pose。
论文选择三种有代表性的 vote:
下游方法 输入模态(概括) 网络回归的 vote 原关键点规则 PVNet RGB pixel-to-keypoint direction vector FPS PVN3D RGB-D / point cloud fusion point-to-keypoint 3D offset FPS RCVPose RGB-D / point cloud point-to-keypoint radial distance BBox
这三种方法的回归量不同,因此对应的“易学关键点”也不同。论文明确说明 Wasserstein loss 中的分布 D ( ⋅ ) D(\cdot) D ( ⋅ )
4.2 与启发式关键点的区别
FPS 追求点间几何距离大;BBox 角点则具有稳定、简单的对象坐标定义。两者没有显式考虑:
表面颜色与可见外观;
每个关键点产生的监督值分布是否容易联合回归;
多个对象放进同一网络后,分布差异是否扩大;
关键点布局对训练收敛速度的影响。
KeyGNet 仍保留“关键点要分散”的几何原则,但额外把 vote distribution similarity 作为优化目标。
4.3 是否是开山工作
作者声称这是首个不靠启发式规则、而是学习 6DoF pose 预定义关键点位置 的工作。更稳妥的理解是:它把已有的可学习 keypoint / landmark 思路明确应用到 voting-based rigid pose 的 3D target design,并用多 backbone、多数据集实验系统验证。论文不应被理解为首个所有意义上的 learned keypoints 工作。
5. 研究动机:为什么“投票分布相似”可能有用
5.1 Vote 的统一表示
设对象可见表面点云为:
S = { p i } i = 1 N S , S=\{p_i\}_{i=1}^{N_S}, S = { p i } i = 1 N S , 对象坐标关键点为:
K = { k j } j = 1 N K . K=\{k_j\}_{j=1}^{N_K}. K = { k j } j = 1 N K . 对每个表面点 p i p_i p i k j k_j k j v i j v_{ij} v ij
RCVPose:标量径向距离;
PVNet:2D direction vector;
PVN3D:3D offset vector。
固定第 j j j
V j = { v i j ∣ p i ∈ S } . V^j=\{v_{ij}\mid p_i\in S\}. V j = { v ij ∣ p i ∈ S } . KeyGNet 希望任意两个关键点的 vote distributions 满足:
V j ∼ V i , ∀ i , j ∈ [ 1 , N K ] . V^j\sim V^i,\qquad \forall i,j\in[1,N_K]. V j ∼ V i , ∀ i , j ∈ [ 1 , N K ] . 5.2 与“类别不平衡”的类比
下游网络通常用一个共享主干同时预测全部关键点。如果某些关键点的目标值集中、另一些跨度很大,优化器要同时拟合尺度与形态明显不同的 regression targets,类似分类中的 class imbalance 或多任务中的 gradient imbalance。
作者用 LINEMOD driller 的径向距离直方图展示:三个 BBox corners 若选得合适,Wasserstein distance 可从 36.8M 降至 6.4M;较相似的直方图对应更容易学习的共同回归问题。这只是动机实验,不是直接的 pose error 证明,但它构成后续设计的合理起点。
5.3 为什么还必须分散
如果只优化分布相似度,最简单的解可能是把多个关键点聚到同一区域,甚至近似重合;此时各关键点 votes 很相似,却导致 PnP / rigid alignment 几何条件变差。
因此还要求:
arg max ∑ i = 1 N K ∑ j = i + 1 N K ∥ k i ∗ − k j ∗ ∥ . \arg\max \sum_{i=1}^{N_K}\sum_{j=i+1}^{N_K}\lVert k_i^*-k_j^*\rVert. arg max i = 1 ∑ N K j = i + 1 ∑ N K ∥ k i ∗ − k j ∗ ∥ . 这揭示了 KeyGNet 的核心张力:统计上想让目标分布接近,几何上又要让观测基线拉开。
6. 方法详解
6.1 总体 Pipeline
根据 GT pose、camera intrinsics 和对象模型,把训练图像中的非遮挡对象部分恢复为 colored surface points。
将一个数据集内多个对象表面的并集 P = { S 1 , S 2 , … , S N P } P=\{S_1,S_2,\ldots,S_{N_P}\} P = { S 1 , S 2 , … , S N P }
EdgeConv 动态构建 KNN graph,编码局部几何与颜色特征。
把原 DGCNN 分类头的 3 × C 3\times C 3 × C N K N_K N K
根据下游方法的 vote definition 计算每对 keypoints 的 distribution similarity。
用 Wasserstein loss 与 dispersion loss 联合优化。
冻结优化后的 keypoints,用它们重新生成下游网络监督并训练 PVNet / PVN3D / RCVPose。
推理流程沿用各下游 estimator;SISO 的速度不变,MIMO 因共享关键点与网络而减少重复计算。
6.2 模块与接口
模块 输入 输出 作用 与下一阶段如何衔接 Visible-surface construction RGB、depth / geometry、GT pose、intrinsics colored surface segments 把训练观测转换到对象几何空间 合并为图网络输入 EdgeConv backbone 多对象表面点 point / graph features 编码局部几何和颜色 回归归一化关键点坐标 Keypoint head graph features K ∗ K^* K ∗ 生成数据集级关键点集合 计算各类 votes Vote-distribution critic V i , V j V^i,V^j V i , V j Wasserstein estimate 让不同关键点目标分布接近 构成 L w a s s \mathcal L_{wass} L w a ss Dispersion constraint keypoint pairs 距离惩罚 防止关键点坍缩 构成 L d i s \mathcal L_{dis} L d i s Downstream PE network RGB / RGB-D + KGN labels scene keypoints / pose 验证关键点是否更易学习 由原方法完成 pose 求解
6.3 Wasserstein loss
论文受 WGAN-GP 启发,将两个关键点 vote distributions 的差异写成:
L w a s s = E V i [ D ( V i ) ] − E V j [ D ( V j ) ] + λ E V [ ( ∥ ∇ V D ( V ) ∥ − 1 ) 2 ] . \mathcal L_{wass}=\mathbb E_{V^i}[D(V^i)]-\mathbb E_{V^j}[D(V^j)]
+\lambda\,\mathbb E_V\left[(\lVert\nabla_V D(V)\rVert-1)^2\right]. L w a ss = E V i [ D ( V i )] − E V j [ D ( V j )] + λ E V [ (∥ ∇ V D ( V )∥ − 1 ) 2 ] . 其中:
D ( V i ) D(V^i) D ( V i ) D ( V j ) D(V^j) D ( V j ) V V V gradient penalty 不只作用于生成器仿真 GT 的情形,而是用于全部 votes;
λ = 10 \lambda=10 λ = 10
选择 Wasserstein distance 的理由是:当两个分布支撑集不重叠时,KL / JS 可能难以提供平滑有效的优化信号,而 Wasserstein 仍能度量它们之间的“搬运距离”。
6.4 Dispersion loss
论文使用:
L d i s = e − γ ∥ k i − k j ∥ , \mathcal L_{dis}=e^{-\gamma\lVert k_i-k_j\rVert}, L d i s = e − γ ∥ k i − k j ∥ , 最小化该项会增大关键点间距。γ = 0.5 \gamma=0.5 γ = 0.5 ( 0 , 1 ] (0,1] ( 0 , 1 ]
总损失:
L = α L w a s s + β L d i s . \mathcal L=\alpha\mathcal L_{wass}+\beta\mathcal L_{dis}. L = α L w a ss + β L d i s . 固定均衡权重容易陷入局部聚集。作者的动态 schedule 是:
前 50 epochs:α = 0.7 , β = 0.3 \alpha=0.7,\beta=0.3 α = 0.7 , β = 0.3
第 50 epoch 后:α = 0.3 , β = 0.7 \alpha=0.3,\beta=0.7 α = 0.3 , β = 0.7
Figure 6 显示该 schedule 比始终偏向某一项同时具有更快收敛和更低最终 loss,但论文只展示 RCVPose / LMO / 3 keypoints 的曲线,跨方法普适性证据有限。
6.5 训练细节
normalization:LayerNorm,而非 BatchNorm,以适配 Wasserstein gradient penalty;
batch size:32;
hardware:6 × RTX 6000;
optimizer:SGD;
initial learning rate:10 − 3 10^{-3} 1 0 − 3
learning-rate decay:每 50 epochs 乘 0.1;
PVNet / PVN3D:8 keypoints;
RCVPose:3 keypoints。
6.6 推理与工程复杂度
KeyGNet 是离线关键点设计器。生成 K ∗ K^* K ∗
SISO 下游 inference speed 理论上不因关键点来源而变化;
MIMO 可让多个对象共享同一 keypoint set 与一套 network,减少逐对象模型调用;
主要新增成本发生在训练数据构建、KeyGNet 优化和下游重新训练;
不能把论文的下游训练时间下降直接解释成 KeyGNet 整体训练更省,因为表中没有把关键点生成阶段完整计入总成本。
7. 实验设计
7.1 数据集
论文使用七个 BOP core datasets:
数据集 场景特点(与论文分析相关) LMO LINEMOD Occlusion,遮挡较重,八个常用对象 YCB-V 多对象杂乱桌面场景,包含对称与弱纹理对象 T-LESS 工业、弱纹理、相似形状与大量对称性 TUD-L 多视角已知对象,整体基线较高 IC-BIN 工业 bin-picking,杂乱和遮挡明显 ITODD 工业对象、深度 / 几何挑战,表中启发式 MIMO 基线最低 HB HomebrewedDB,真实杂乱环境与多对象
论文还在 LM、LMO、YCB-V 的传统协议上报告 ADD(S) 或 ADD(S) AUC,以便与既有关键点 pose 文献对比。
7.2 指标
指标 含义 注意事项 VSD recall 比较估计 / GT pose 下可见表面差异 考虑可见性与遮挡 MSSD recall symmetry-aware 最大表面距离 显式处理等价对称 pose MSPD recall symmetry-aware 最大投影距离 更贴近图像平面误差 BOP AR 对 VSD、MSSD、MSPD recall 聚合 Table 1 以 0–100 标度呈现 ADD(S) 非对称用平均对应点距离,对称用最近点距离 阈值协议依数据集 / 文献而定 ADD(S) AUC 多阈值下的面积归一化 不能与单阈值 ADD(S) 直接混读
7.3 对比控制是否公平
作者使用三种下游方法的公开实现,并声明每次对比中保持 loss、hyperparameters、network depth、keypoint count 等因素不变,只修改输出形状以支持 SISO→MIMO,并替换关键点来源。
这是相对公平的“同 backbone 替换 target geometry”实验。不过仍有三点边界:
KGN keypoints 针对每个下游 vote representation 单独优化,因此不是一次训练后跨方法零成本迁移;
下游网络要基于新 labels 从头训练,无法判断在已有 checkpoint 上只替换关键点能否收益;
论文没有报告多随机种子均值 / 方差,1–3 points 的小增益是否稳定仍需复核。
8. 主结果:精度、MIMO 与训练时间
原论文 Table 1:完整覆盖七个 BOP core datasets。所有表格单元中 KGN 都高于相应 FPS / BBox;收益在 MIMO 设置普遍大于 SISO,支持论文关于共享回归器的核心动机。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8.1 七个 BOP 数据集的总体趋势
Table 1 的关键数字如下:
下游方法 SISO 平均 AR:启发式→KGN SISO 增益 MIMO 平均 AR:启发式→KGN MIMO 增益 PVNet 71.3→73.6 +2.3 61.9→73.2 +11.3 PVN3D 72.0→76.3 +4.3 63.9→75.9 +12.0 RCVPose 77.0→80.6 +3.6 70.2→80.2 +10.0
观察:
SISO 也有一致收益,说明 KeyGNet 不只是多对象模型容量补丁;
MIMO 增益约为 SISO 的 2.8–4.9 倍,更直接支撑“让共享回归目标分布更均衡”的动机;
最大单格增益是 ITODD 上 PVN3D-MIMO:32.4→53.9,即 +21.5 AR points ;
最小增益出现在若干高基线 SISO 条目,例如 TUD-L 的 RCVPose 97.8→98.8,即 +1.0 point;
摘要中的 “+1% 到 +21.5%” 实际应按表理解为 0–100 AR 标度上的绝对百分点,而不是相对百分比。
8.2 LMO / YCB-V 的经典指标
原论文 Table 2:LMO 与 YCB-V 的传统指标及训练时长。最显著的准确率条目是 PVN3D-MIMO 在 LMO 上从 53.9 到 70.3(+16.4 points);训练时间条目反映论文特定硬件与收敛配置,不应当作任意实现的固定加速倍数。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
方法 / 模式 LMO 指标变化 YCB-V 指标变化 下游训练时长变化 PVNet SISO ADD(S) 40.8→48.0 AUC 73.4→79.1 16h→10h PVNet MIMO 31.7→47.9 65.1→78.1 22h→12h PVN3D SISO 63.2→70.5 92.3→95.7 17h→10h PVN3D MIMO 53.9→70.3 86.5→94.6 23h→12h RCVPose SISO 71.1→75.5 95.9→97.6 16h→9h RCVPose MIMO 62.0→75.6 92.5→96.6 22h→11h
作者声称 :更相似的 regression target distributions 更易学习,因此下游网络更准确、收敛更快。
我的分析 :精度与时间同向改善确实与这一解释一致,但 Table 2 没有说明统一 early-stopping criterion、每轮吞吐是否相同,也没有把 KeyGNet 自身开销计入端到端训练预算。因此“更容易优化”证据较强,“整体训练成本一定更低”证据不足。
8.3 SISO→MIMO gap
论文 Table 3 / Table 4 直接计算从单对象训练转为多对象训练后的下降:
数据集 / 指标 PVNet FPS→KGN PVN3D FPS→KGN RCVPose BBox→KGN LMO ADD(S) 平均 gap -9.1→-0.1 -9.3→-0.2 -6.3→+0.1 YCB-V ADD(S) AUC 平均 gap -6.3→-1.0 -6.7→-1.2 -3.4→-1.0
LMO 中 KGN 的逐对象结果几乎都落在 0 到 -0.4,RCVPose 对 driller / duck / eggbox / glue 甚至有 +0.2 到 +0.4 的小幅提升。考虑到没有多 seed,这些小正值不宜过度解释;真正稳健的结论是 平均 gap 从约 6–9 points 缩小到约 0–1.2 points 。
9. 消融与调参
9.1 分布相似性度量
原论文 Table 5:LMO-MIMO 上比较 KL、JS、cross entropy 与 Wasserstein。表中是相对启发式关键点的 ADD(S) 增益;Wasserstein 在三个下游方法的每个对象上都取得最高值。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Table 5 的 LMO 八对象平均增益:
损失 PVNet PVN3D RCVPose KL divergence +14.1 +14.2 +11.5 JS divergence +15.3 +14.8 +12.7 Cross entropy +14.3 +14.2 +11.0 Wasserstein +16.2 +16.4 +13.6
Wasserstein 对每个对象、每个 estimator 都是最高,消融一致性很强;但四种 loss 都带来大幅收益,这也说明更关键的因素可能是“学习关键点”这一框架,Wasserstein 是进一步提高约 1–2 points 的选择,而不是全部收益来源。
9.2 关键点数量
Figure 5 在 LMO-MIMO 上扫描 3, 4, 8, 12, 32, 64 个关键点:
PVNet 与 PVN3D 从 3 增至 8 时明显改善,8 之后趋于饱和;
RCVPose 从 3 开始基本稳定;
最终配置选择 PVNet / PVN3D 8 点、RCVPose 3 点。
这个结果与 vote representation 有关:方向 / offset voting 可从更多关键点冗余中获益,而径向 voting 的组合求解在 3 点后收益有限。
9.3 动态损失权重
论文 Figure 6 比较三种策略:
固定 α = 0.7 , β = 0.3 \alpha=0.7,\beta=0.3 α = 0.7 , β = 0.3
固定 α = 0.3 , β = 0.7 \alpha=0.3,\beta=0.7 α = 0.3 , β = 0.7
epoch 50 交换权重:兼顾收敛速度与最终 loss。
它验证了 distribution similarity 与 geometric dispersion 会竞争,但只提供一条训练曲线,没有下游 pose metric 的独立多设置表格,证据强度弱于 Table 5。
9.4 KeyGNet 输入初始化
Table 6 在 LMO / RCVPose 上比较:
KeyGNet 输入 / 模式 平均 ADD(S) FPS keypoints 初始化,SISO 74.7 BBox keypoints 初始化,SISO 75.0 visible surface segments,MIMO 75.6
从完整表面输入略优于从少量启发式点出发,但差距只有 0.6–0.9 points,且模式同时从 SISO 变为 MIMO,变量未完全单独控制。它更像工程选择依据,而不是强因果结论。
10. 鲁棒性、失败案例与未覆盖情形
10.1 遮挡
LMO、IC-BIN 等结果说明方法在含遮挡 benchmark 中有效,但 KeyGNet 训练输入明确使用 non-occluded visible surfaces 。论文没有独立扫描可见率,也没有展示关键点优化对极端遮挡的临界点。
10.2 对称物体
BOP AR 中的 MSSD / MSPD 以及 ADD(S) 对 symmetry 有一定处理,因此总体结果包含对称对象。但 KeyGNet loss 本身不是 symmetry-aware pose uncertainty,也没有约束关键点落在对称等价类中;“投票分布相似”不等于“关键点能消除旋转歧义”。
10.3 RGB 与 RGB-D
论文跨 PVNet 与 RGB-D 方法验证,说明概念不绑定单一模态。但不同 estimator 的 keypoints 是分别学习的,不能据此声称一套 KGN points 在 RGB / RGB-D 间直接通用。
10.4 Mask、depth 与 domain gap
未单独测试:
detector / segmentation mask 错误;
depth holes 与边缘飞点;
透明、反光、低信噪工业表面;
synthetic-to-real / cross-camera domain shift;
训练标定与 GT pose 噪声;
未见对象或新增对象在线扩展。
10.5 可能的失败模式
训练表面分布与测试可见区域差异很大时,离线关键点可能对常见视角过拟合;
强对称对象上,不同 keypoints 虽然数值分布相似,但语义 / 几何对应可能仍模糊;
新对象加入 MIMO 系统后,原数据集级共享 keypoints 未必仍是最优,需要重新优化并重新训练下游网络;
关键点被推到对象表面之外或弱可见区域时,下游投票虽统计均衡,物理可观测性可能变差;论文没有显式 visibility-aware constraint。
11. 贡献是否被实验支撑
作者声称 对应证据 是否充分 我的判断 学习关键点优于 FPS / BBox Table 1、2,三种方法、七数据集 较充分 覆盖广、方向一致;缺少多 seed 置信区间 能缩小 SISO–MIMO gap Table 3、4 充分 从约 6–9 points 缩至约 0–1.2,效应大且跨三方法 Wasserstein 比其他分布度量更合适 Table 5 较充分 每个对象都最好,但相对 JS 的边际提升约 1–2 points 训练收敛更快 Table 2、Figure 6 部分充分 下游训练少 6–11h;未计 KeyGNet 成本,停止准则披露有限 推理更高效 正文定性描述 不充分 没有标准化 FPS / latency / memory 表 learned keypoints 可作为通用插件 跨 PVNet / PVN3D / RCVPose 部分充分 概念可插拔,但每种 voting method 需单独训练 KGN
12. 批判性分析
12.1 优点
问题抽象有价值 :把“固定几何标签”从先验变成可优化变量,为后来学习 template、anchor、correspondence target 的工作提供清晰范式。实验矩阵完整 :三个不同 vote types × 七个 datasets × SISO / MIMO,不依赖单一 benchmark 的偶然涨点。核心收益集中且可解释 :MIMO 增益显著高于 SISO,与“共享回归器的目标分布冲突”动机一致。侵入性较低 :不需要重写下游 backbone 或推理 solver,适合插入已有 keypoint pipeline。消融不仅看最终精度 :还讨论 loss、keypoint count、weight schedule、input initialization 和 training time。
12.2 缺点
离线依赖强 :需要 GT pose、camera intrinsics、对象表面模型和可见区域,不能直接用于无 CAD / 未见对象。按 estimator / dataset 重训 :泛化性比“keypoint generator”这一名称给人的直觉更窄。总成本不透明 :Table 2 只列下游训练时长,没有加上 KeyGNet 数据预处理与训练成本。统计报告不足 :没有多随机种子、方差、置信区间;对高基线数据集的 1–2 point 收益需谨慎。可观测性目标不完整 :vote distribution 与 point dispersion 是 surrogate,没有直接优化 PnP condition number、pose covariance、visibility 或 symmetry ambiguity。实机证据缺失 :全部证据来自 benchmark,没有机器人闭环抓取、跨相机或增量对象部署测试。
12.3 隐含假设
训练数据中的可见表面分布能代表测试时的观测分布;
对所有对象共享 normalized keypoint layout 是合理的;
vote target distribution 越相似,下游网络就越容易学习且 pose 更准确;
点间欧氏距离足以近似几何求姿条件;
下游方法的检测 / 分割质量不会抵消关键点设计收益;
新关键点坐标能被原 solver 无偏地使用,不引入新的对称映射问题。
12.4 真实应用可行性
对于对象集合固定、可离线训练的工业场景,KeyGNet 很实用:关键点只需离线生成,推理成本几乎不增加,而一个 MIMO 模型可替代多个 SISO 模型。
离开放世界应用仍有距离:新增 SKU、无 CAD 对象、透明 / 反光物体、动态遮挡、标定误差和 detector failures 都要求更强的条件化与不确定性建模。
13. 复现指南
13.1 最小复现路径
先选一个公开实现稳定的下游方法与 LMO 数据集,例如 PVN3D 或 PVNet。
复现原启发式关键点的 SISO / MIMO 指标,确认数据协议与论文一致。
用 GT pose + intrinsics + CAD mesh 构造对象坐标中的 visible colored surface segments。
实现 EdgeConv keypoint head,输出 8 points(PVNet / PVN3D)或 3 points(RCVPose)。
根据下游 vote definition 生成 V j V^j V j
使用 50 epoch 权重交换 schedule 训练 KGN。
重新生成下游关键点 labels,保持 backbone、augmentation、optimizer 与 epoch 完全相同。
至少跑 3 seeds,分别报告 final metric、best metric、time-to-threshold 与总训练 GPU-hours。
13.2 必须核对的实现细节
表面点是否统一到 normalized object coordinate system;
不同对象尺度如何归一化;
RGB 颜色是否标准化、是否影响跨对象共享布局;
vector / offset votes 的 histogram 或 critic 输入如何构造;
对所有 keypoint pairs 计算 loss 的复杂度;
gradient penalty 的 interpolation / joint distribution 实现;
keypoints 是否限制在对象内部、表面或 bounding volume;
symmetric objects 的 GT keypoint mapping 是否固定;
SISO / MIMO 的数据采样频率是否平衡。
13.3 更严谨的复现实验表
建议增加:
实验 目的 3–5 seeds mean ± std 判断 1–3 point 增益是否稳定 KGN 训练成本 + 下游训练成本 验证总 GPU-hours 是否真的下降 只用 geometry、不用 color 判断颜色信息的独立贡献 只用 L w a s s \mathcal L_{wass} L w a ss L d i s \mathcal L_{dis} L d i s 分解两项 loss 的绝对贡献 PnP condition number / pose covariance 验证 dispersion surrogate 与几何可辨识性的关系 visibility-aware keypoints 测试常见遮挡下的稳定性 train objects→new objects 测试共享布局是否具备类别外泛化 noisy GT / intrinsics / depth 评估训练数据构建误差的敏感性
14. 可改进方向
14.1 直接优化 pose-aware 几何目标
将 L d i s \mathcal L_{dis} L d i s
PnP Jacobian condition number;
Fisher information / pose covariance;
symmetry-aware ADD(S) surrogate;
visibility-weighted reprojection uncertainty。
这样能从“关键点相隔较远”推进到“这些关键点对最终 6DoF pose 真正可辨识”。
14.2 条件化关键点生成
当前是一套 dataset-level points。可以让生成器条件化于:
object geometry / category embedding;
当前相机 viewpoint;
visible mask / occlusion pattern;
downstream estimator type;
RGB / depth reliability map。
从而为每个对象或每次观测动态选择最可见、最稳定的关键点。
14.3 与 foundation features 结合
KeyGNet 使用颜色与几何表面。后续可用 DINO / CLIP 类 dense features 衡量跨视角可匹配性,使关键点既有良好几何基线,也落在跨域稳定的语义 / 局部外观区域。
14.4 处理 symmetry 与不确定性
在对称群上优化等价 keypoint sets;
输出关键点分布而非单点;
将 keypoint covariance 传播到 PnP / rigid alignment;
对不可辨识轴输出多模态 pose hypotheses。
14.5 增量多对象系统
工业部署会持续新增对象。理想系统应在不重训所有旧对象的情况下:
为新对象生成兼容 keypoints;
保持旧对象性能;
动态扩展 MIMO head;
用 rehearsal / parameter-efficient tuning 避免 catastrophic forgetting。
15. 对研究工作的启发
可直接借鉴
把“监督目标怎样定义”与“网络怎样预测”分开研究;
用 distribution alignment 缓解多对象共享回归头的目标冲突;
用几何约束防止纯统计目标产生退化解;
用跨 backbone、跨 modality 的实验判断一个模块是否真正通用。
何时应加入 baseline
方法仍依赖预定义 3D keypoints;
研究 multi-object shared backbone;
声称新的 voting representation 更易学习;
比较 FPS / BBox / learned anchors;
研究 keypoint uncertainty 或 pose-conditioned target design。
可形成新工作的切入点
用可见性、foundation correspondence confidence 和 symmetry-aware pose covariance 联合学习 per-view adaptive 3D keypoints ,在无需为每个数据集重新优化固定布局的情况下,兼顾 MIMO 共享效率与未知对象泛化。
16. 待解决问题
概念问题
一套 normalized keypoint coordinates 如何在几何差异巨大的对象之间保持同一语义?
分布相似究竟是在减少 gradient conflict,还是只在改变 target scale?
颜色特征是否带来对象身份 shortcut,而非真正的可观测性?
公式问题
论文文字中的 histogram distribution 与 WGAN critic 的具体离散实现如何对应?
D ( V ) D(V) D ( V ) γ = 0.5 \gamma=0.5 γ = 0.5
实验问题
Table 2 的训练时长以何种 convergence / stopping criterion 截止?
加上 KeyGNet 自身训练后,总 GPU-hours 是否仍下降?
1–3 points 的 SISO 增益在不同 seed 下是否显著?
KGN points 在 cross-dataset、cross-camera 或新对象上的迁移效果如何?
复现问题
公开代码能否完整复现所有七个 BOP datasets 与三种下游方法?
数据预处理如何获得论文所说的 non-occluded visible surfaces?
MIMO 中对象采样不均衡是否需要额外 reweighting?
17. 最终判断
作者声称
学习得到的关键点能提高三种 voting-based 6DoF pose 方法在七个 BOP core datasets 上的准确率,缩短训练收敛时间,并几乎消除 LMO 上的 SISO–MIMO gap。
我的分析
这一主结论在论文设定内得到较强支持,尤其是 MIMO 平均 AR 提升 +10.0 到 +12.0 points、LMO 平均 gap 从约 -6.3~-9.3 缩至 -0.2~+0.1,效应量大且跨三类 vote representation 一致。需要保留的限定是:KeyGNet 是 已知对象、离线、按数据集和 estimator 定制 的 target-design 模块,不是无需 CAD、可直接泛化到任意对象的在线关键点发现器;训练成本、随机性和真实系统鲁棒性也仍需更严格验证。