论文精读笔记:L4D-Track
1. 核心判断
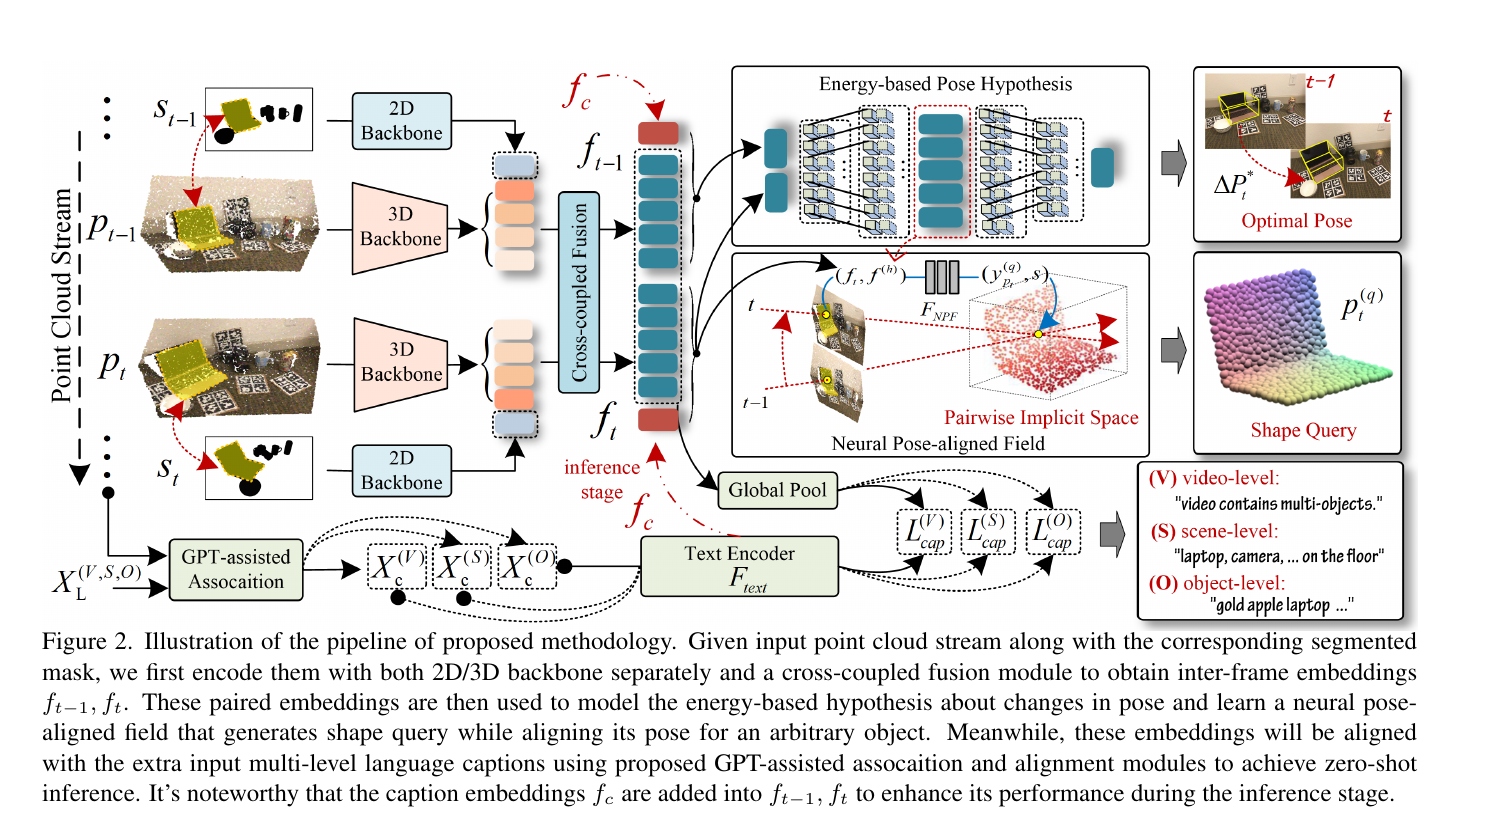
L4D-Track 试图回答的不是单帧 pose,而是一个更接近机器人在线感知的问题:给定已分割对象的连续点云,能否在因果、实时条件下同时维护 pose 与 shape,并通过语言语义迁移到训练外类别。
系统的技术核心其实有三层:
时序几何层 :相邻帧 pairwise representation;任务层 :energy-based pose hypothesis + neural pose-aligned shape field;语义层 :三级 captions 与 3D video representation 的 contrastive alignment。
论文最有价值的证据是跨数据集实验,但“zero-shot”必须带着协议读:首帧 pose 和 size 是真值,点云已分割,语言 captions 已提供;它解决的是后续帧 tracking / reconstruction 的类别迁移,不是从原始场景自动发现未知对象并初始化。
2. 递推 tracking 任务
设连续对象点云为 p t p_t p t s t s_t s t
P t = ( R t , T t ) ∈ S E ( 3 ) . P_t=(R_t,T_t)\in SE(3). P t = ( R t , T t ) ∈ S E ( 3 ) . 网络预测相邻帧 pose change:
P t = Δ P t P t − 1 = Δ P t Δ P t − 1 ⋯ P 0 . P_t=\Delta P_tP_{t-1}
=\Delta P_t\Delta P_{t-1}\cdots P_0. P t = Δ P t P t − 1 = Δ P t Δ P t − 1 ⋯ P 0 . 因此误差会沿时间累积。首帧 P 0 P_0 P 0
3. Pairwise 3D representation
原论文 Figure 2。两个时间步共享 2D / 3D encoder,feature difference \(\Delta\) 进入双向 cross-coupled fusion;同一 pairwise feature 同时服务 pose hypothesis、shape query 和语言对齐。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
PointNet 提取 3D spatial feature,2D backbone 编码 mask 并反投影到点。对相邻特征 f ˉ t − 1 , f ˉ t \bar f_{t-1},\bar f_t f ˉ t − 1 , f ˉ t
Δ = linear ( f ˉ t − f ˉ t − 1 ) , \Delta=\operatorname{linear}(\bar f_t-\bar f_{t-1}), Δ = linear ( f ˉ t − f ˉ t − 1 ) , 再用 cross-attention 构造 f t − 1 , f t f_{t-1},f_t f t − 1 , f t Δ \Delta Δ
Energy-based pose hypothesis
网络不直接用 MLP 回归一个 Δ P t \Delta P_t Δ P t
p ( Δ P t ∣ f t − 1 , f t ) ∝ exp F η ( Δ P t , f t − 1 , f t ) . p(\Delta P_t\mid f_{t-1},f_t)
\propto
\exp F_\eta(\Delta P_t,f_{t-1},f_t). p ( Δ P t ∣ f t − 1 , f t ) ∝ exp F η ( Δ P t , f t − 1 , f t ) . 实现生成 5 × 10 4 5\times10^4 5 × 1 0 4
Neural Pose-aligned Fields
shape prior 采样 N p = 2048 N_p=2048 N p = 2048
4. 语言如何进入 4D
语言数据不是数据集原生标注。作者用 GPT-4 半自动收集 instruction-caption pairs,按三层组织:
video-level:整段视频 / 动态描述;
scene-level:对象与场景关系;
object-level:形状、纹理、颜色等实例描述。
视觉 token 与指令先经 LLaMA association model 生成 response caption;caption 再用预训练 ViT-L/14 text encoder 编码。训练对 pairwise 3D feature 与 caption feature 使用 InfoNCE 风格损失:
L ^ c a p = λ v L c a p ( V ) + λ s L c a p ( S ) + λ o L c a p ( O ) . \hat{\mathcal L}_{cap}
=\lambda_v\mathcal L_{cap}^{(V)}
+\lambda_s\mathcal L_{cap}^{(S)}
+\lambda_o\mathcal L_{cap}^{(O)}. L ^ c a p = λ v L c a p ( V ) + λ s L c a p ( S ) + λ o L c a p ( O ) . 测试时 caption embedding 还直接加到相邻帧 representation。LLaMA 权重冻结,但 linear layer、视觉与语言 encoder 会更新。
需要注意:论文把 LLaMA、GPT-4、GloVe、ViT-L/14 共同放在语言流水线中,组件较多。消融只逐层去 caption loss,没有用“类别名 embedding”“固定 CLIP 文本”“无 LLaMA caption generator”等更简单基线完全隔离收益来源。
5. NOCS pose 与 tracking
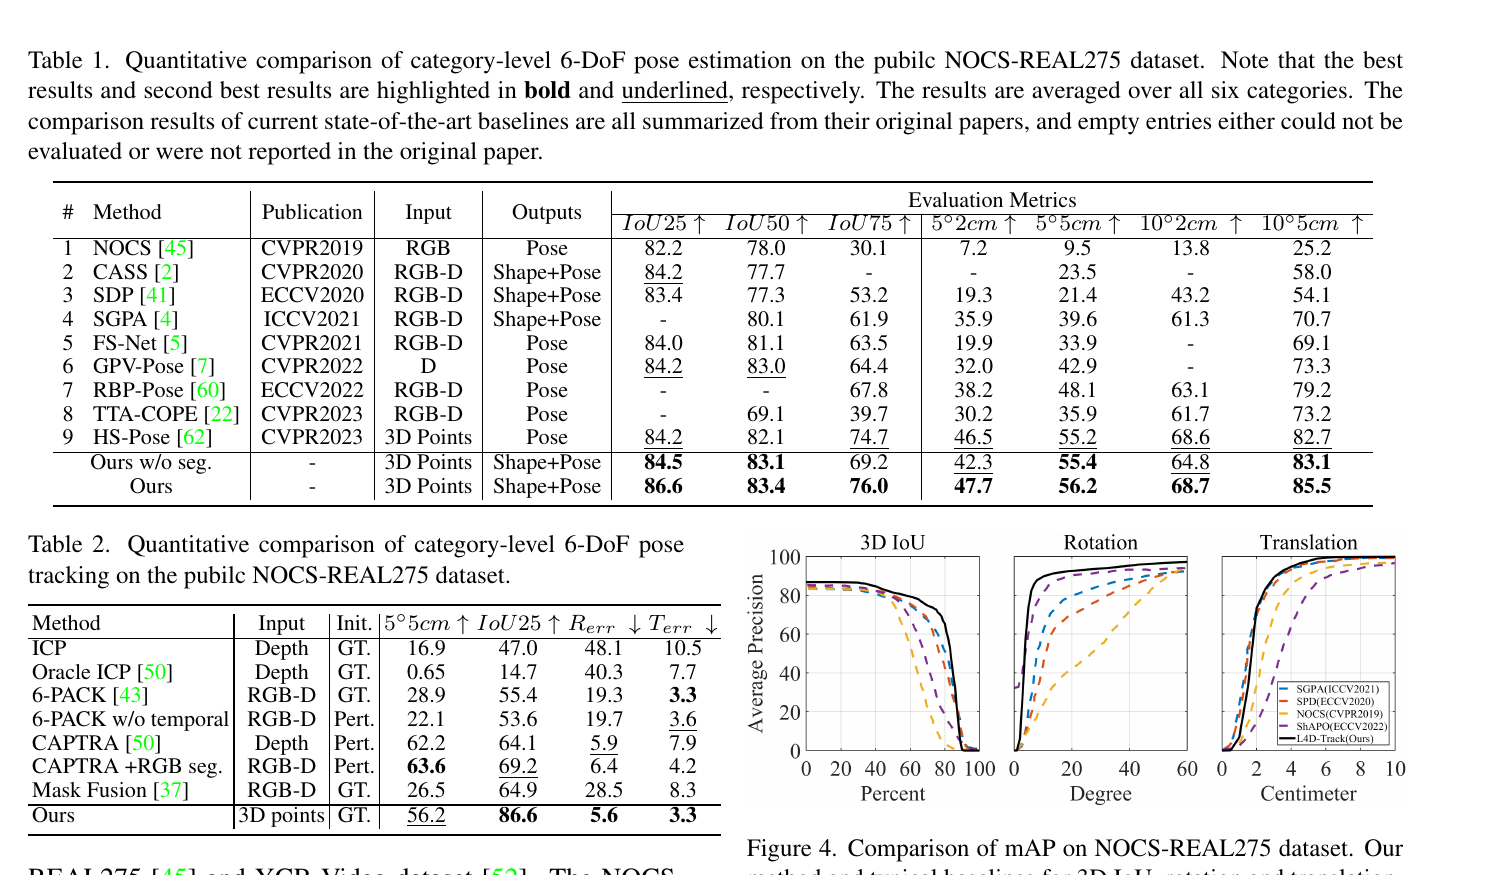
原论文 Table 1–2 与 Figure 4。Table 1 混合比较单帧 estimation 与本文联合 pose+shape 方法;Table 2 才是按首帧初始化的 tracking 对照。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
方法 IoU75 5°2cm 5°5cm 10°5cm HS-Pose 74.7 46.5 55.2 82.7 L4D-Track 无 segmentation 69.2 42.3 55.4 83.1 L4D-Track 完整 76.0 47.7 56.2 85.5
完整模型相对 HS-Pose 的提升不大:IoU75 +1.3、5°2cm +1.2、5°5cm +1.0;价值更多来自同一模型还做 tracking 与 reconstruction,而不是单帧 pose 大幅超越。
tracking Table 2 中:
方法 初始化 5°5cm IoU25 R e r r R_{err} R er r T e r r T_{err} T er r CAPTRA + RGB seg. perturbation 63.6 69.2 6.4° 4.2 cm L4D-Track GT 56.2 86.6 5.6° 3.3 cm
所以论文“outperforms most baselines”成立,但不是全指标领先:CAPTRA 的 5°5cm 更高;两者初始化也不同,不能只看粗体。
6. 跨类别 YCB-Video 与 shape
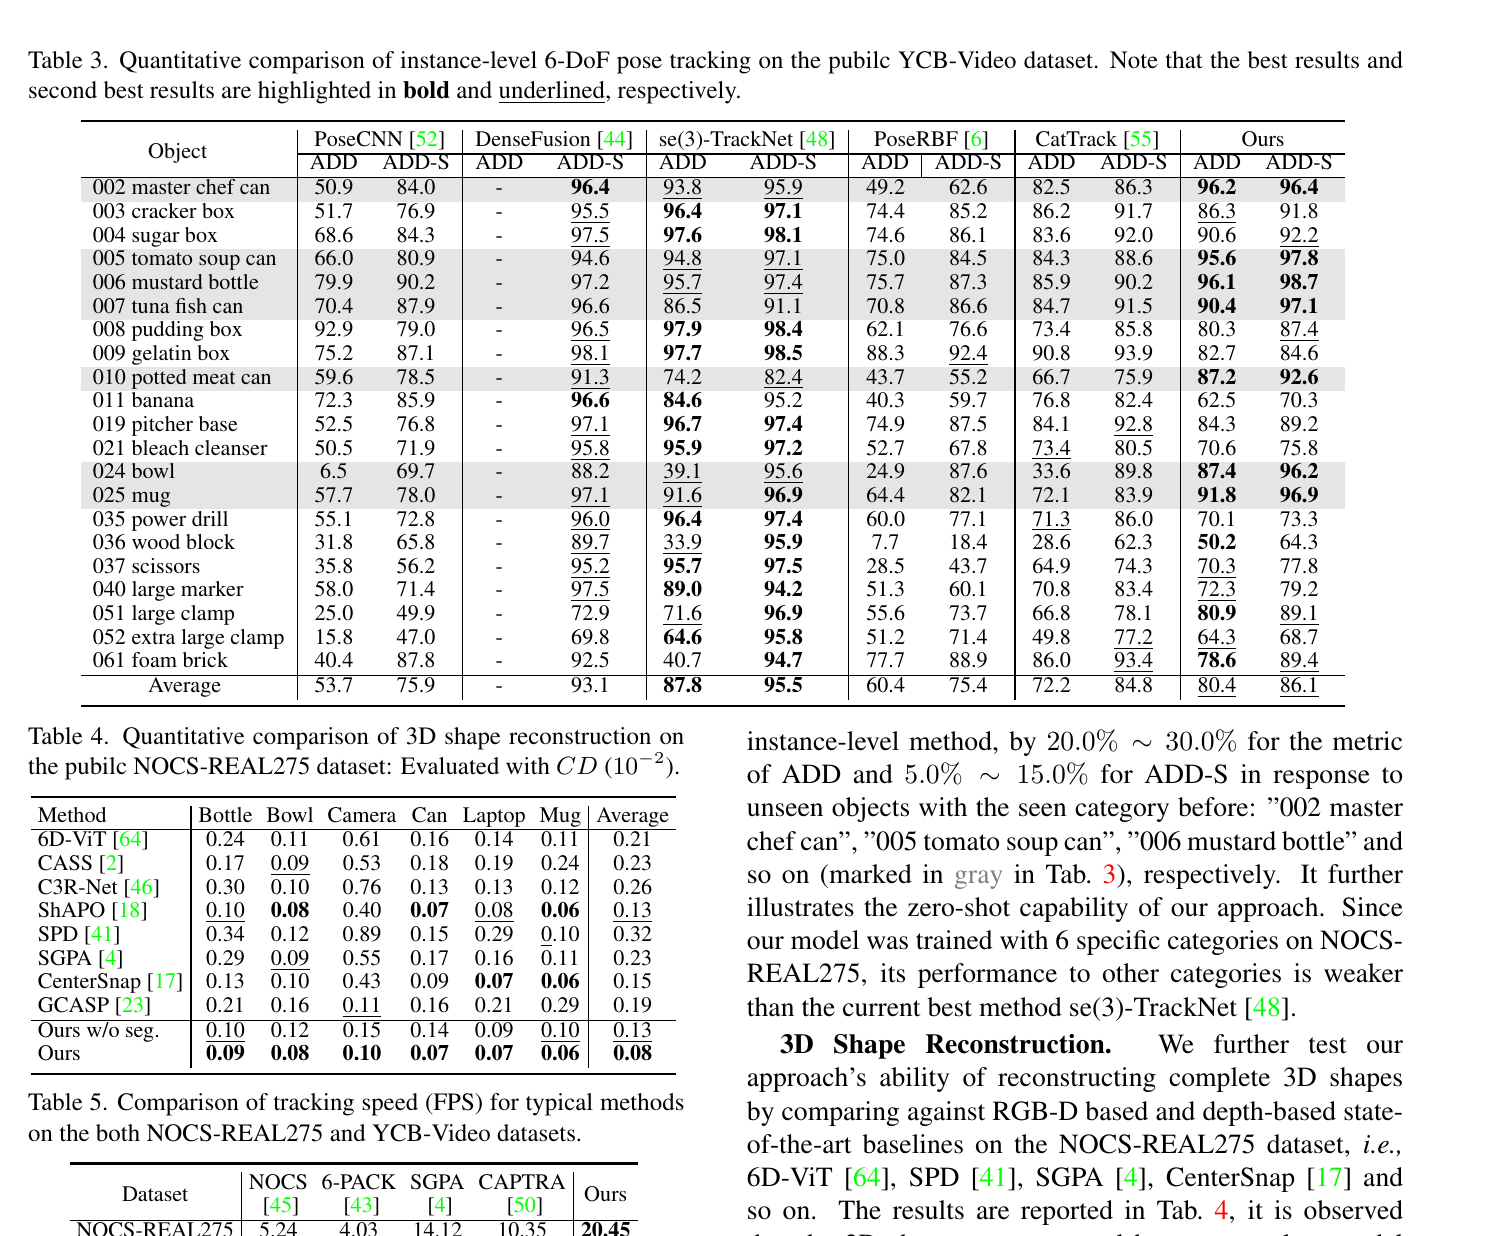
原论文 Table 3–5:Table 3 是从 NOCS 六类直接迁移到 YCB-Video 21 个对象;Table 4 报 NOCS shape CD;Table 5 在同一 RTX A6000 上比较速度。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
YCB-Video 平均:
方法 ADD ADD-S PoseCNN 53.7 75.9 PoseRBF 60.4 75.4 CatTrack 72.2 84.8 L4D-Track 80.4 86.1 se(3)-TrackNet 87.8 95.5
L4D-Track 明显超过 CatTrack,但距 se(3)-TrackNet 仍有 7.4 / 9.4 points。类别差异也很大:mustard bottle 为 96.1 / 98.7,banana 仅 62.5 / 70.3,wood block 50.2 / 64.3。语言带来跨类别能力,但并没有消除 geometry / appearance domain gap。
NOCS shape CD(10 − 2 10^{-2} 1 0 − 2
7. 消融如何解释
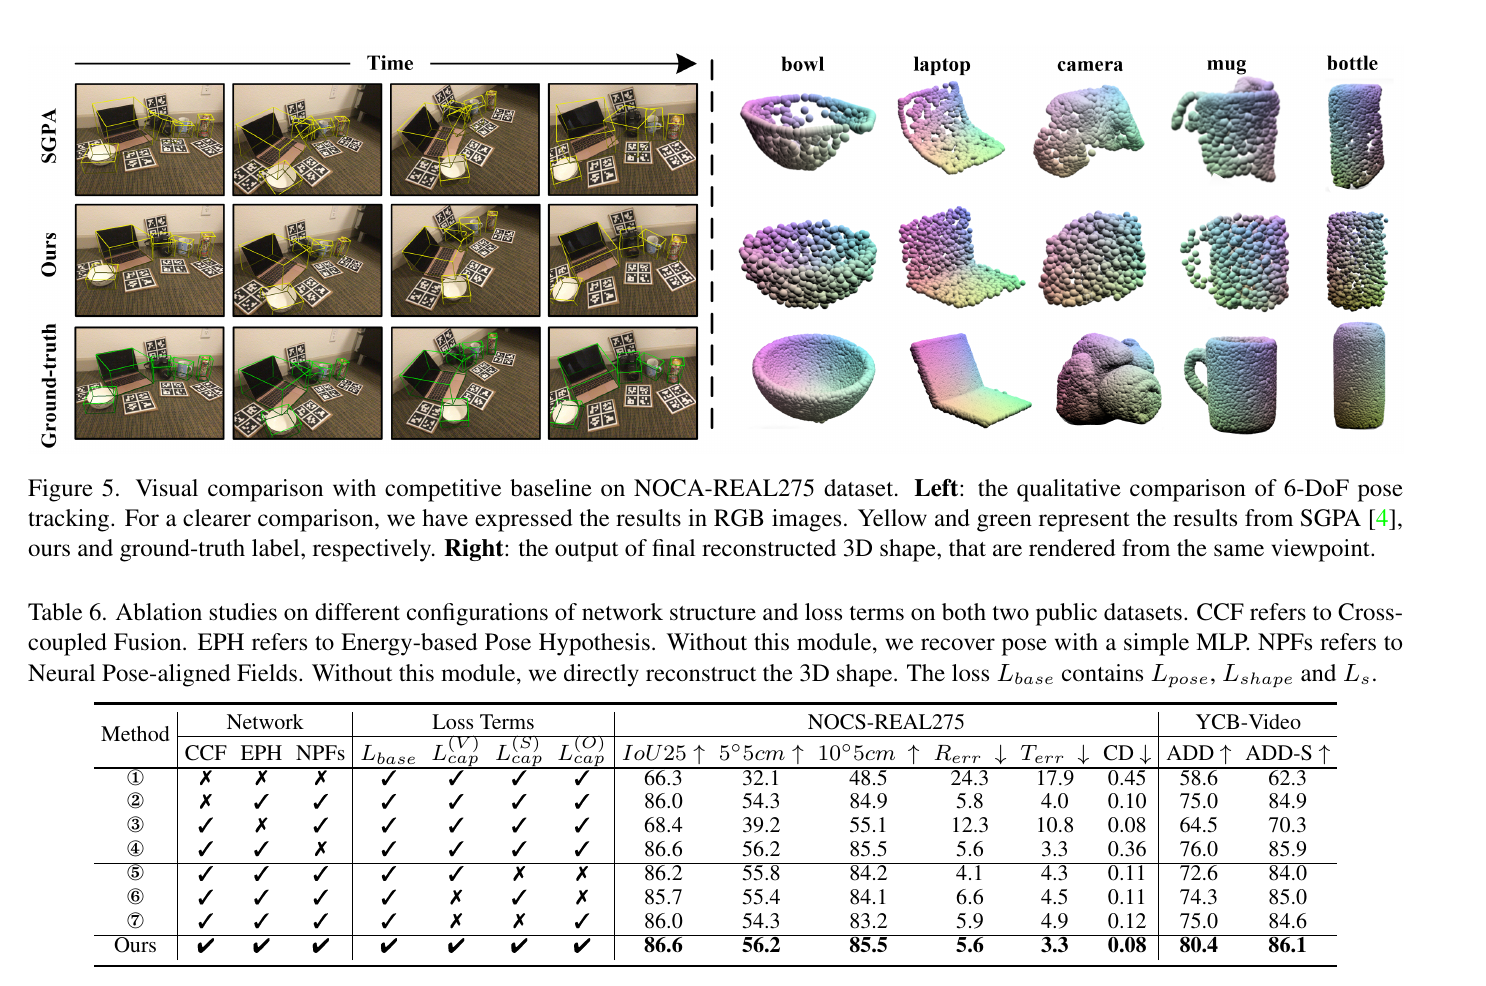
原论文 Figure 5 与 Table 6:上方同时展示 pose tracking 和 shape reconstruction;下方逐项移除 cross-coupled fusion、energy-based hypothesis、pose-aligned fields 及三级 caption loss。来源:CVPR 2024 正式论文 ;图片与表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
结构消融的几个关键点:
全部核心结构都无时,NOCS IoU25 / 5°5cm 只有 66.3 / 32.1,YCB ADD / ADD-S 为 58.6 / 62.3。
有 cross-coupled fusion 与 pose hypothesis、无 NPFs 时,pose 可到 86.6 / 56.2,但 shape CD 恶化到 0.36;NPFs 主要承担 reconstruction。
无 energy-based hypothesis 时 NOCS R e r r R_{err} R er r
仅保留 video / scene / object 之一的 caption loss 时,NOCS 5°5cm 分别为 55.8 / 55.4 / 54.3,完整模型为 56.2;加入另外两级 caption loss 的合计增益约 0.4–1.9 points,不能解释为单项去除消融。
YCB ADD 从相应变体 72.6 / 74.3 / 75.0 提至 80.4,跨域收益比同域 NOCS 更明显,符合语言先验主要服务泛化的设计目标。
8. 训练与可复现性
4× RTX A6000;
batch size 32;
30 epochs + validation early stopping;
learning rate 10 − 7 10^{-7} 1 0 − 7
pose hypotheses 5 × 10 4 5\times10^4 5 × 1 0 4
shape prior 2,048 points;
训练数据只用 NOCS-REAL275;
YCB-Video 不微调;
推理跨域实验关闭 segmentation head 与 2D backbone。
最后一点很重要:跨 YCB 时实际使用的是 points-only 版本,因此输入 point cloud 如何裁出目标、首帧目标如何指定,仍依赖外部系统。
9. 局限与风险
首帧 GT pose / size 显著简化 tracking initialization。
逐帧 object mask 或已裁点云不是开放场景的免费输入。
语言 captions 是半自动生成,不等同于自然用户指令分布。
论文没有长期序列 drift、失跟恢复和跨遮挡重定位评测。
“unknown category”只在 YCB-Video 这一组跨域数据上验证。
需要 shape prior auto-encoder;并非完全无先验重建。
多组件语言栈增加训练和复现复杂度,简化基线不足。
实验表中 single-frame estimation、tracking 与跨域 points-only protocol 不能混为同一设定。
10. 最终评价
L4D-Track 的贡献在系统整合与任务扩展:它展示了 pairwise 3D representation 可以同时承载 pose、shape 与 language alignment,并在约 20 FPS 下实现跨数据集迁移。其 NOCS 单帧增益温和,但 YCB-Video 的无微调结果和 shape reconstruction 更能说明方法价值。
读者应把它视为“已初始化、已分割 point-cloud tracking 的语言增强泛化框架”,而不是通用开放词汇追踪器。后续最关键的验证是去掉首帧真值、接入开放词汇分割,并在长序列遮挡与 relocalization 场景中测量累计 drift。