论文精读笔记:Living Scenes / MoRE²
1. 核心判断
Living Scenes 将 object pose 从“当前相机里对象在哪里”扩展为“这个对象相对上一次扫描移动了多少,并能否在长期观测中越重建越完整”。MoRE² 不把 matching、registration、reconstruction 拼成三个独立模型,而是让同一 SE(3)-equivariant latent representation 服务全部任务,再在测试时共同优化 pose graph 与对象隐式表面。
这项设计在端到端指标上比各子任务单独最强 baseline 的组合更有优势:3RScan 的 matching+registration+reconstruction recall 从 30.77 提到 40.74。它说明共享几何表示的价值主要体现在 误差链路一致性 ,而不只是单项 registration 多几个点。
任务也有清晰边界:输入已经按实例分割,假设对象刚体运动;输出是跨 scan 的相对 6DoF,不是 BOP 单帧绝对 pose。对同形多实例、非刚性变化和大范围场景拓扑变化,论文明确留作未来工作。
2. Living scene 的形式化
给定同一环境在不规则时刻采集的 scan 集合:
{ S t } t = 1 T , S t = { X i t } i = 1 N t , \{S^t\}_{t=1}^{T},\qquad
S^t=\{X_i^t\}_{i=1}^{N_t}, { S t } t = 1 T , S t = { X i t } i = 1 N t , 其中 X i t ∈ R 3 × n i X_i^t\in\mathbb R^{3\times n_i} X i t ∈ R 3 × n i
以 S 1 S^1 S 1 t > 1 t>1 t > 1
判断 X i 1 X_i^1 X i 1 X j t X_j^t X j t
求刚体变换 T i t = ( R i t , t i t ) ∈ S E ( 3 ) T_i^t=(R_i^t,t_i^t)\in SE(3) T i t = ( R i t , t i t ) ∈ S E ( 3 )
将所有观测对齐并累积:
X i 1 : T = X i 1 ∘ T i 2 X i 2 ∘ ⋯ ∘ T i T X i T ; X_i^{1:T}=X_i^1\circ T_i^2X_i^2\circ\cdots\circ T_i^TX_i^T; X i 1 : T = X i 1 ∘ T i 2 X i 2 ∘ ⋯ ∘ T i T X i T ;
从累计点云恢复对象隐式表面 / mesh。
新增或移除的对象允许 unmatched;对象中间如何移动不建模。这里的 relocalization 是 scan endpoint 之间的 object motion estimation。
3. 一套表示服务三项任务
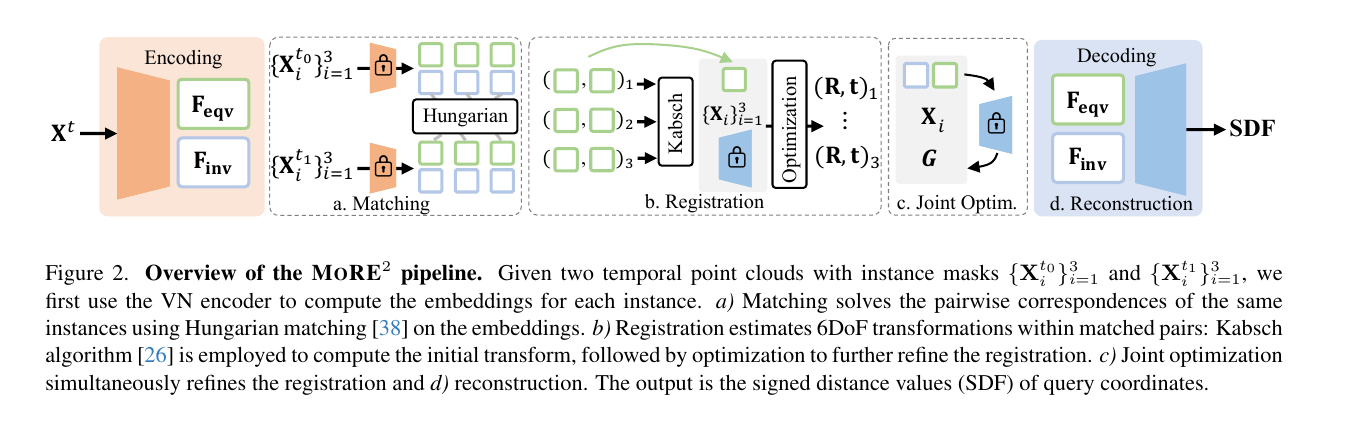
原论文 Figure 2。matching 使用 invariant / equivariant embeddings 的组合分数,registration 从 Kabsch 初值进入隐式表面对齐,joint optimization 同时调整 pose graph 与 latent geometry,decoder 最终输出 SDF。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
encoder 输出:
F inv F_{\text{inv}} F inv F eqv F_{\text{eqv}} F eqv F s F_s F s F c F_c F c
其 SIM(3) equivariance 可写为:
Φ ( s R X + t ) = ( F inv , R F eqv , s F s , F c + t ) . \Phi(sRX+t)=
\left(F_{\text{inv}},RF_{\text{eqv}},sF_s,F_c+t\right). Φ ( s R X + t ) = ( F inv , R F eqv , s F s , F c + t ) . 对 query coordinate p p p
F q = ⟨ F eqv , p − F c F s ⟩ . F_q=\left\langle F_{\text{eqv}},\frac{p-F_c}{F_s}\right\rangle. F q = ⟨ F eqv , F s p − F c ⟩ . DeepSDF-style decoder:
SDF ( p ) = Ψ ( F inv , F q ) . \operatorname{SDF}(p)=\Psi(F_{\text{inv}},F_q). SDF ( p ) = Ψ ( F inv , F q ) . 网络训练时只最小化单形状的 L1 SDF reconstruction loss;matching 与 registration 主要来自该表示的结构和测试时优化,而不是每项都训练专门 head。
4. 实例匹配:身份相似度加旋转可对齐性
对 reference / rescan 的对象集合,先用 invariant embeddings 形成 cosine similarity matrix Λ \Lambda Λ Λ \Lambda Λ
对每个候选 pair 以 Kabsch 求 latent rotation R i j R_{ij} R ij
计算对齐 residual:
E ( i , j ) = ∥ R i j F eqv , i − F eqv , j ∥ 2 ; E(i,j)=\|R_{ij}F_{\text{eqv},i}-F_{\text{eqv},j}\|_2; E ( i , j ) = ∥ R ij F eqv , i − F eqv , j ∥ 2 ;
组合分数:
H = Λ ⊘ E ; H=\Lambda\oslash E; H = Λ ⊘ E ;
Hungarian assignment 最大化全局 pair score。
这相当于要求候选对象既“身份上像”,又能由一个一致旋转解释。未分配对象按时间顺序视为新增 / 移除。
风险在于 Hungarian 的一对一设定:若场景里有多个几何几乎完全相同的椅子,单 pair latent evidence 不足以决定 identity,需要空间上下文或全局 motion consistency,论文尚未处理。
5. Registration:从等变 Kabsch 到连续表面对齐
初始 pose:
F se3 = F eqv + F c , F_{\text{se3}}=F_{\text{eqv}}+F_c, F se3 = F eqv + F c , 在两组 latent vectors 上用 Kabsch 得 R i , t i R_i,t_i R i , t i
随后最小化:
L reg = ∥ Ψ ( F inv t 1 , ⟨ F eqv t 1 , R i X t 2 + t i − F c t 1 F s t 1 ⟩ ) ∥ 1 ⏟ L sdf + CD ( R i X t 2 + t i , X t 1 ) ⏟ L cd . \mathcal L_{\text{reg}}
=
\underbrace{
\left\|
\Psi\!\left(
F_{\text{inv}}^{t_1},
\left\langle
F_{\text{eqv}}^{t_1},
\frac{R_iX^{t_2}+t_i-F_c^{t_1}}{F_s^{t_1}}
\right\rangle
\right)
\right\|_1
}_{\mathcal L_{\text{sdf}}}
+
\underbrace{\operatorname{CD}(R_iX^{t_2}+t_i,X^{t_1})}_{\mathcal L_{\text{cd}}}. L reg = L sdf Ψ ( F inv t 1 , ⟨ F eqv t 1 , F s t 1 R i X t 2 + t i − F c t 1 ⟩ ) 1 + L cd CD ( R i X t 2 + t i , X t 1 ) . 两项作用不同:
SDF loss 把源点推到目标对象的连续零水平集,不要求离散 point-to-point correspondence;
Chamfer 防止仅靠 learned shape prior 漂向不符合当前观测的表面。
pose 在 SE(3) manifold 上优化。相比 GeoTransformer 等离散 correspondence 方法,这在 partiality 变化大、两次扫描露出不同表面时更自然;代价是测试时迭代和 shape-prior bias。
6. Joint optimization 与多时刻累积
对同一对象多个 observations 建 pose graph G G G
L joint = L sdf + L z , L z = ∥ F ′ − F ∥ 2 . \mathcal L_{\text{joint}}
=\mathcal L_{\text{sdf}}+\mathcal L_z,\qquad
\mathcal L_z=\|F'-F\|_2. L joint = L sdf + L z , L z = ∥ F ′ − F ∥ 2 .
G G G latent equivariant embedding F ′ F' F ′
L z \mathcal L_z L z 论文使用 200 iterations。
这允许新 scan 反过来改善旧 scan pose;不是每对独立注册后静态拼接。共同 latent surface 充当多个 partial observations 的几何汇合点。
7. 数据、指标与协议
训练:
ShapeNet subset;
mesh watertight preprocessing;
SDF sampling;
合成 depth rendering 与 point-cloud back-projection;
只用合成对象训练 shared encoder–decoder。
评测:
FlyingShape:作者基于 ShapeNet 生成的 synthetic living-scene benchmark;
3RScan:真实室内 reference / rescan,作者扩展 instance matching 和 reconstruction protocol。
注意:3RScan 官方隐藏 test server 已不再维护;论文的复现实验依赖作者处理后的 split / evaluation code。
指标:
instance matching recall;
scene-level matching recall R @ 25 / 50 / 75 / 100 R@25/50/75/100 R @25/50/75/100
registration recall RR;
median rotation error MedRE;
translation RMSE;
median Chamfer distance MedCD;
reconstruction L1-Chamfer、IoU、SDF recall;
MR:matching 与 registration 都成功;
MRR:matching、registration、reconstruction 都成功。
MR / MRR 以条件事件组合:
P ( R 1 , M ) = P ( R 1 ∣ M ) P ( M ) , P(R_1,M)=P(R_1|M)P(M), P ( R 1 , M ) = P ( R 1 ∣ M ) P ( M ) , P ( M , R 1 , R 2 ) = P ( R 2 ∣ R 1 , M ) P ( R 1 ∣ M ) P ( M ) . P(M,R_1,R_2)=P(R_2|R_1,M)P(R_1|M)P(M). P ( M , R 1 , R 2 ) = P ( R 2 ∣ R 1 , M ) P ( R 1 ∣ M ) P ( M ) . 因此后级任务只在前级成功样本上传递,能反映 pipeline compounding error。
8. 主结果
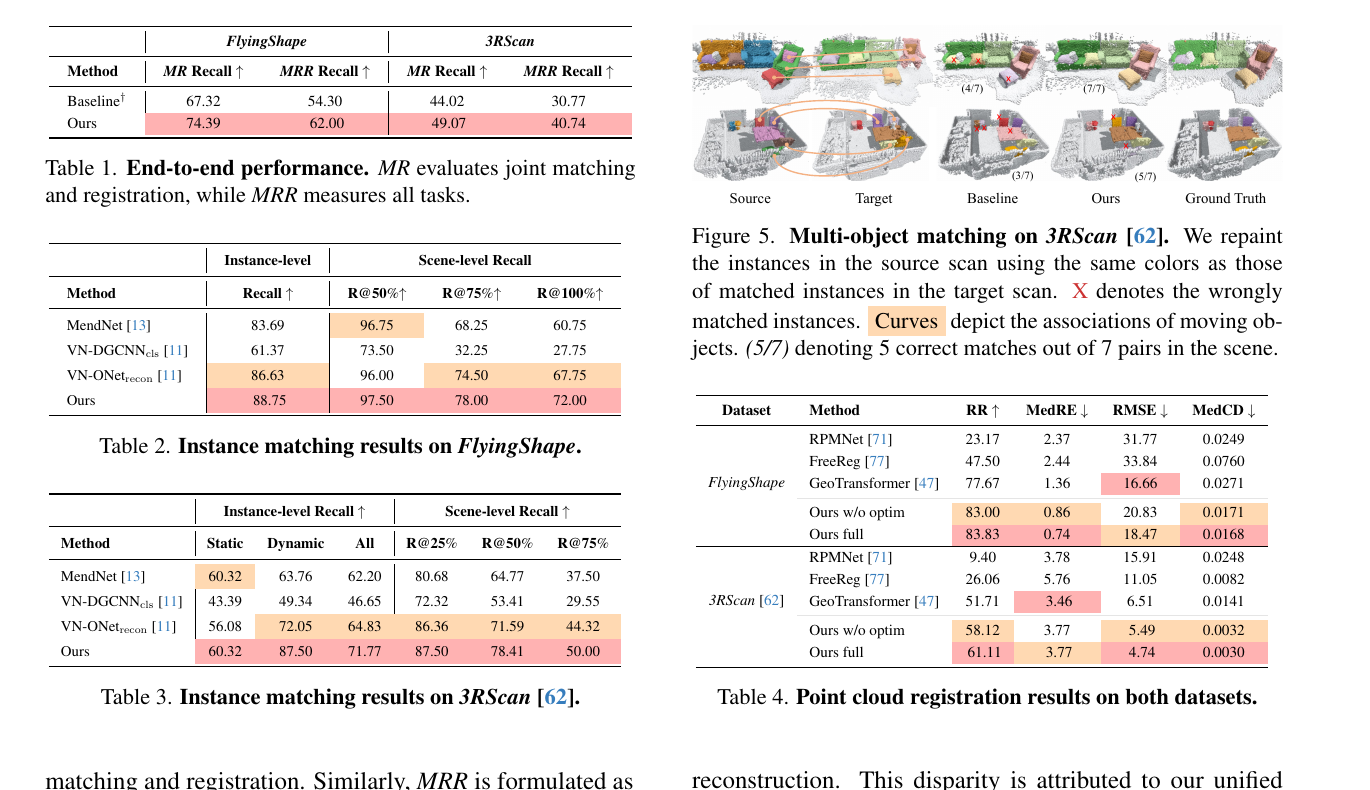
原论文 Table 1–4 与 Figure 5。左侧给出 end-to-end 与 matching,右侧展示真实 3RScan 多对象匹配及 registration;红色为最佳、橙色为次佳。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
端到端:
数据集 方法 MR MRR FlyingShape component-wise baseline 67.32 54.30 FlyingShape MoRE² 74.39 62.00 3RScan component-wise baseline 44.02 30.77 3RScan MoRE² 49.07 40.74
3RScan 的 MRR 提升 9.97,明显大于 MR 的 5.05,说明 unified representation / joint optimization 对最后 reconstruction stage 的误差传递更有价值。
Matching:
FlyingShape instance recall 88.75,scene R@100 72.00;
3RScan static / dynamic / all 为 60.32 / 87.50 / 71.77;
3RScan scene R@25 / 50 / 75 为 87.50 / 78.41 / 50.00。
动态对象反而比 static 更高,可能因为被移动的对象具有更完整、独立的 object crops,而 static objects 与背景 / segmentation 更易混合;不能简单解读为“运动越大越容易”。
Registration:
数据集 方法 RR MedRE RMSE MedCD FlyingShape GeoTransformer 77.67 1.36 16.66 0.0271 FlyingShape MoRE² full 83.83 0.74 18.47 0.0168 3RScan GeoTransformer 51.71 3.46 6.51 0.0141 3RScan MoRE² full 61.11 3.77 4.74 0.0030
MoRE² 并非每个 error 最小:FlyingShape RMSE、3RScan MedRE 由 GeoTransformer 更好。它的优势是更高成功 recall 和更低 geometry distance,符合“连续隐式表面帮助低 overlap 对齐”的主张。
9. Reconstruction 与噪声 segmentation
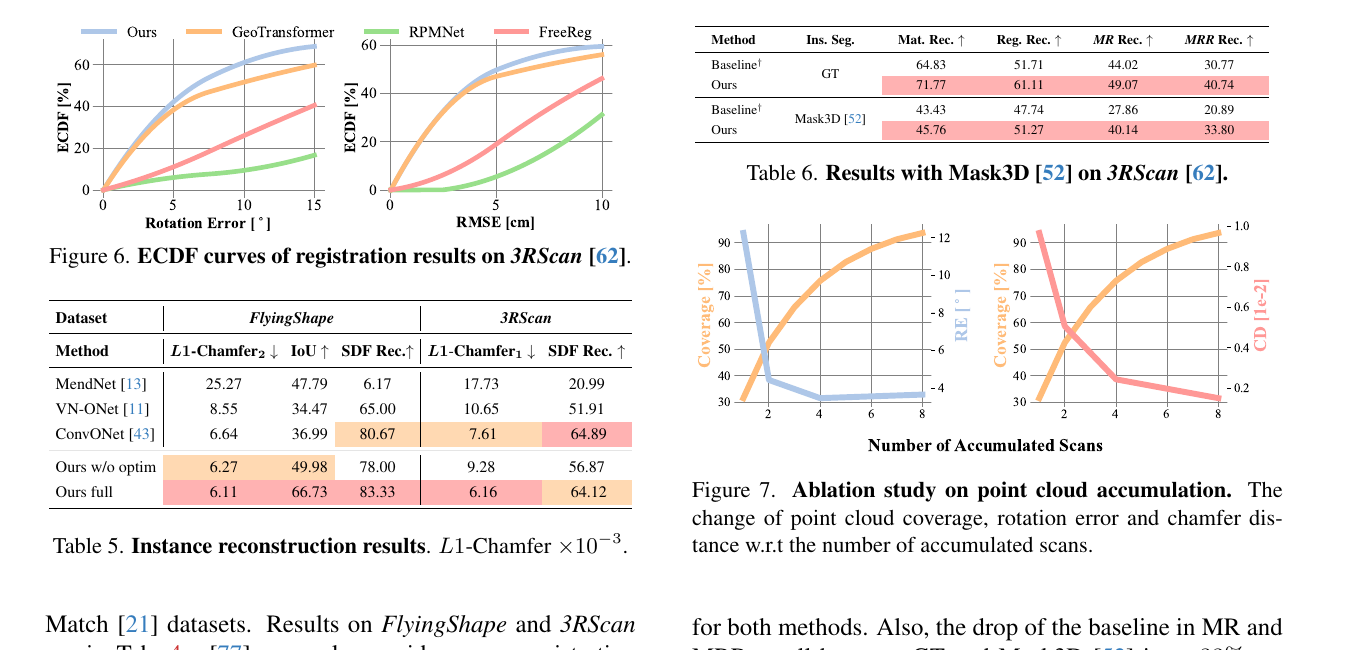
原论文 Figure 6–7 与 Table 5–6。上方比较 registration ECDF、reconstruction 和 Mask3D 条件;右侧显示 scan accumulation 在约四次观测后趋于饱和。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
Reconstruction:
数据集 方法 L1-Chamfer IoU SDF recall FlyingShape ConvONet 6.64 36.99 80.67 FlyingShape MoRE² w/o optim 6.27 49.98 78.00 FlyingShape MoRE² full 6.11 66.73 83.33 3RScan ConvONet 7.61 — 64.89 3RScan MoRE² full 6.16 — 64.12
3RScan 只提供 incomplete non-watertight meshes,所以报告 one-way Chamfer 与 SDF recall,不能和 FlyingShape two-way Chamfer 直接横比。MoRE² 在真实数据的 SDF recall 64.12 略低于 ConvONet 64.89,但 Chamfer 更好。
Mask3D 替代 GT instance segmentation:
方法 Match Reg MR MRR baseline + Mask3D 43.43 47.74 27.86 20.89 MoRE² + Mask3D 45.76 51.27 40.14 33.80
从 GT 到 Mask3D,baseline 的 MR / MRR 相对下降约 33%,MoRE² 约 18%。shared latent shape 对缺失 / noisy point cloud 有缓冲作用,但绝对性能仍明显下降,不能声称 instance segmentation 已解决。
10. 累积何时有效
从 1 个 point cloud 增加到 4 个:
surface coverage 快速上升;
rotation error 与 Chamfer 显著下降;
第四次时 coverage 接近 75%;
之后新增 scan 的边际收益明显变小。
这支持 joint accumulation 的直觉,但建立在新增视角能揭示新表面的前提上。如果重复扫描来自相近视角、或者新的 segmentation 更差,更多 scan 不一定单调改善。
11. 与普通 pose / tracking 的关系
与 BOP absolute pose:
BOP 输入当前图像、已知 target object,输出 object→camera;
MoRE² 输入多个 point-cloud scans,输出 object 在 scan 之间的相对 motion;
MoRE² 不需要 CAD,但需要 reference instance observation 与 segmentation。
与短期 multi-object tracking:
tracking 假设帧率高、运动连续,可利用 velocity / association history;
living scene 两次观察间隔长,中间轨迹未知;
匹配更依赖 object identity geometry,pose 可发生大变化。
与 scene-level registration:
scene registration 主要对齐静态背景;
MoRE² 要识别多个独立移动对象,并为每个对象估计不同 SE(3);
output 不是一个全局 transform,而是一组 object transforms 和 meshes。
12. 局限
instance segmentation 是外部输入;
刚体假设,不能处理布料、软体或结构形变;
多个 identical objects 仍会混淆 identity;
Hungarian one-to-one assignment 不能自然处理分裂 / 合并;
训练 shape prior 来自 ShapeNet,长尾真实物体可能被 prior 平滑;
test-time joint optimization 200 iterations,计算成本高于单次前向;
3RScan ground-truth / server 状态使独立验证困难;
不建模 background change 或全场景 large-scale topology;
只使用几何 point cloud,不利用 RGB / 语义文本辅助同形实例匹配;
新 scan 不一定总带来新表面,累积收益依赖视角。
13. 复现检查表
使用作者 ShapeNet subset 和 watertight mesh preprocessing;
复现 SDF sampling、depth rendering 和 point-cloud partiality;
保持 Vector Neuron equivariance 与 centroid / scale normalization;
分开保存 F inv , F eqv , F s , F c F_{\text{inv}},F_{\text{eqv}},F_s,F_c F inv , F eqv , F s , F c
matching 同时使用 cosine similarity 与 latent Kabsch residual;
Hungarian assignment 允许 unmatched;
registration 从相同 Kabsch initialization 开始;
同时实现 SDF loss 与 Chamfer loss;
pose 更新在 SE(3) manifold,而非直接优化不受约束矩阵;
joint optimization 使用相同 200 iterations 与 latent regularizer;
GT mask 与 Mask3D 各报一套;
FlyingShape / 3RScan 的 Chamfer direction 不要混用;
端到端同时报 MR / MRR,避免只报成功 pair 的子任务误差;
对 identical objects、低 overlap、错误 segmentation 单列失败案例。
14. 最终评价
MoRE² 的研究意义在于把 6DoF registration 从独立 pairwise solver 提升为 object-centric long-term scene understanding 的中间变量。共享的 invariant / equivariant / implicit representation让 identity、pose 与 shape 相互约束,3RScan MRR 40.74 对 baseline 30.77 的提升正是这种系统性收益。
它仍然依赖高质量实例分割、刚体假设与 test-time optimization,也没有解决同形多实例。最可靠的结论是:对于不连续采集的长期室内 3D scans,将对象匹配、相对 SE(3) 和累计重建放在同一等变隐式表示中,比逐项拼接更能抵抗误差传播。