论文精读笔记:Effects of Markers in Training Datasets on the Accuracy of 6D Pose Estimation
1. 研究问题不是“怎么做 pose”,而是“训练数据在教网络看什么”
许多真实 6D pose 数据集依赖复杂标注流程:
人工把 CAD 对齐到 RGB-D 点云,再用 ICP refinement;
机器人运动学、多相机或光学 motion capture 给出对象 pose;
在对象上安装 active / passive marker,自动获得高精度轨迹。
第三种方法采集快、标签准,却产生一个冲突:marker 会出现在训练 RGB 中,部署时通常不存在。如果 marker 与对象保持固定刚性关系,它的二维位置、可见数量和投影形状都与 pose 相关。网络可能把 marker 当作额外关键点,甚至比对象纹理更容易学习。
论文围绕两个问题做控制实验:
固定 marker 到底会让 markerless test 下降多少? “高精度 marker 标签 + 图像去 marker”与“天然 markerless 图像 + 较粗标签”哪个更值得?
这类问题很适合 WACV:贡献不是一个更大的模型,而是对数据生产、shortcut learning 和 ground-truth fidelity 的实证拆解。
2. 因果变量与五组训练条件
作者先在 BlenderProc2 中生成成对图像:同一物体、背景、干扰物、照明、物理落姿与相机 pose 完全相同,只改变 marker 是否存在或如何处理。这种 paired design 比直接比较两个真实数据集更容易隔离因果变量。
Case 训练条件 想回答的问题 I w/o marker 理想 markerless 上限 II w marker 固定 marker shortcut 的直接影响 III inpainting 去掉 marker 后是否恢复上限;artifact 是否成为新 domain gap IV marker augmentation 每张图随机放 1–5 个 marker,是否能让网络学会 marker-invariance V aug. + marker 一半固定 marker、一半随机 marker,模拟真实固定采集 + synthetic augmentation VI / VII 分别用 I / II 训练,在有 marker test 上评估 检查网络是否真的利用 marker,而非仅因 marker 遮挡而退化 VIII 仅 synthetic baseline、未做 real fine-tuning 衡量 200 张真实图微调的收益
作者只改训练数据,不提出新 pose loss。主干网络是 GDR-Net,保留原论文参数和 augmentation;另用 ZebraPose 做 model-dependence check。
3. 数据集构造
3.1 Teabox 控制集
目标是一个 box-shaped tea package;
synthetic training:20,000 images、约 800 unique scenes;
每个 scene 使用随机背景、distractor objects 和 physics simulation 生成落姿,再从 25 个随机 camera positions 渲染;
synthetic test:1,000 images、500 unique scenes,每 scene 两个视角;
real training:marker-based 与 markerless 各 200 张;
real markerless test:59 张、3 个场景。
teabox 的优点是可以快速跑完所有数据条件和标签扰动;缺点是形状简单、纹理强、对象单一,marker shortcut 的量级未必代表无纹理或复杂对称物体。
3.2 YCB-V 子集
作者选择五个 YCB-V 物体:
002 master chef can;
004 sugar box;
008 pudding box;
025 mug;
036 wood block(对称)。
large synthetic set 含约 80,000 张图;synthetic test 1,000 张,每对象约出现 300 次。真实测试来自 BOP / YCB-V,共 975 个对象实例。GDR-Net 用一个网络处理五对象;ZebraPose 每对象单独训练,约 10,000 张 / object。
这组设计既观察跨对象趋势,也暴露明显 synthetic-to-real failure;但五对象规模仍小,而且后续平均值排除了两个失败最严重的对象。
4. Marker removal:已知几何驱动的两阶段 inpainting
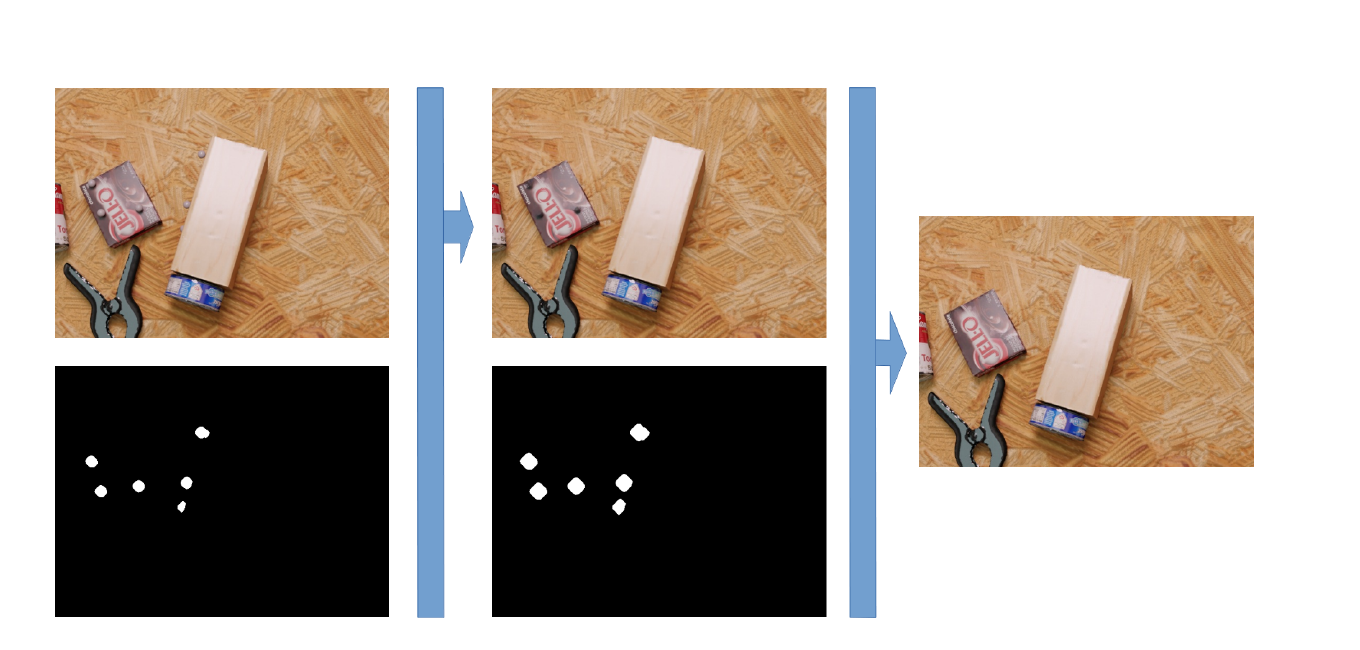
作者使用 LaMa(论文引用 Suvorov et al.)的预训练大 mask inpainting model,不做对象或数据集适配。关键不在生成器,而在 mask 来源:
marker 三维位置已知;
将 marker 投影到当前 camera image;
用 scene depth 验证 marker visibility;
得到精确 marker mask;
对最近邻做 binary dilation,先扩约 4 次;
第一次 inpainting 后,再用扩约 8 次的 mask 做第二次 inpainting。
原论文 Figure 2:较小 mask 先删除 marker,较大 mask 再清理边界 artifact;最终图大体 marker-free。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
这个流程比“拿通用 segmentation 自动找 marker”强得多,因为采集系统本来就知道 marker pose。它也解释了论文的实际适用场景:如果 marker 是为了 motion-capture 标注而专门安装的,应该在采集时同时保存 marker geometry / mask,而不是事后只保留 RGB。
论文展示了 synthetic YCB-V、真实 teabox 和 textureless tool 的修复。少量 artifact 与 elongated shadow 仍存在,作者没有手工清理;这使实验能回答“自动流程是否足够”,而不是“完美图像修图能否无损”。
5. Marker augmentation:随机化相关性,而不是简单遮挡增强
如果固定 marker 在每张图都位于对象同一表面位置,marker projection 与 pose 强相关。作者每张 synthetic image 随机采样 1–5 个 marker 到对象表面,遇到 marker 互相重叠或与对象几何不合适就重新采样。
这里想打破的是 p ( marker appearance ∣ R , t ) p(\text{marker appearance}\mid R,t) p ( marker appearance ∣ R , t )
该方法的优点是无需生成被遮挡纹理;缺点是 synthetic marker 的材质、阴影、接触和镜面反射未必真实,而且随机 marker 仍遮住对象表面。
6. 标签误差如何构造
作者用 BOP toolkit 的手工标注流程模拟 markerless annotation:由 RGB / depth 生成彩色点云,人把 CAD 拖到对象附近,再做 ICP refinement。共手标 37 个 multi-object frames,并和 synthetic exact pose 比较:
误差区间 0–2 2–4 4–6 6+ 平移误差帧数(mm) 79 20 9 2 旋转误差帧数(°) 76 12 14 10
作者称平移误差可用 mean μ = 0.1 \mu=0.1 μ = 0.1 σ = 2.2 \sigma=2.2 σ = 2.2
σ t ∈ { 0 , 2 , 4 , 8 } mm , σ R ∈ { 0 , 2.5 , 5 } ∘ . \sigma_t\in\{0,2,4,8\}\ \text{mm},\qquad
\sigma_R\in\{0,2.5,5\}^{\circ}. σ t ∈ { 0 , 2 , 4 , 8 } mm , σ R ∈ { 0 , 2.5 , 5 } ∘ . 图像保持不变,只扰动 training pose labels;test ground truth 始终精确。
这种实验适合量化“随机标签噪声的敏感度”,但不是完整真实误差模型:marker-to-object registration 往往产生一个对象级系统偏差;深度尺度、外参和 ICP 也会产生随视角相关的 correlated error。
7. 网络、训练与指标
7.1 GDR-Net
RGB-only 6D pose estimator;
teabox:batch size 24、10 epochs;
YCB-V:batch size 24、80 epochs;
所有数据条件使用同一 seed,以减少 initialization 差异;
作者保持 GDR-Net 原始参数与 augmentation。
同一个 seed 让对比更受控,但没有多 seed mean / variance,无法判断 0.5–1 个百分点差异是否超出训练随机波动。
7.2 指标
ADD:同索引 model points 的平均距离;
ADD-S:predicted points 到 GT surface nearest points 的平均距离,适合对称物体;
ADD-(S):对称物体用 ADD-S,其余用 ADD;
ADD-(S) success:误差低于对象直径 10%;
AUC:论文按最大 10 cm threshold 计算 ADD-S / ADD-(S) curve area。
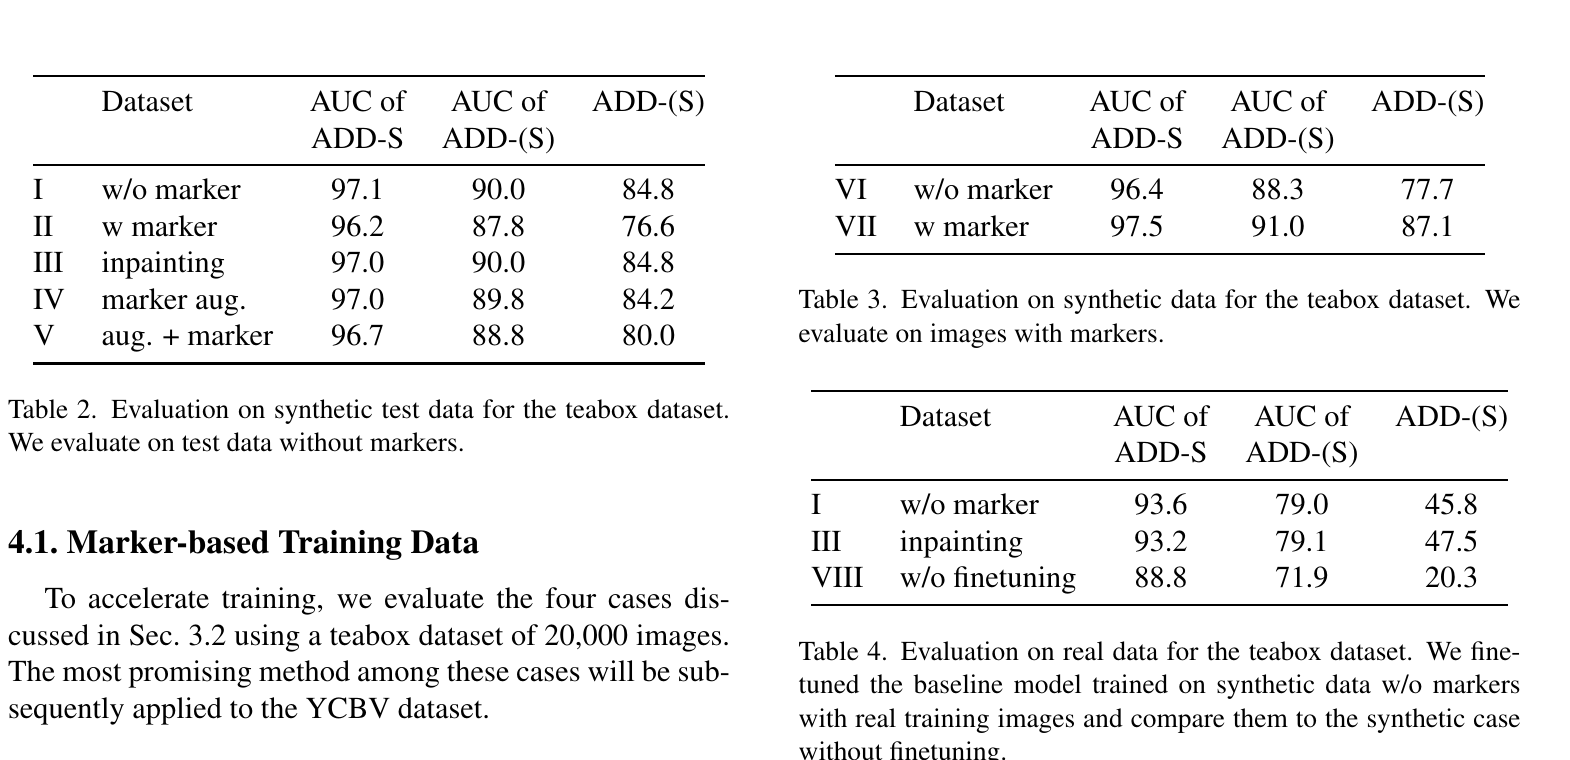
Table 2 同时给出 AUC ADD-S、AUC ADD-(S) 和 ADD-(S)。AUC ADD-S 在不同训练条件间只差约 1 点,ADD-(S) 更敏感,因此作者主要用后者讨论 marker shortcut。
8. Teabox 主结果:shortcut、遮挡与域错配被分开验证
原论文 Tables 2–4:Table 2 是关键受控比较;Table 3 交换 test domain,验证 marker 本身是可利用线索;Table 4 检查 inpainting 是否能用于真实 marker 图像微调。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8.1 Markerless test 上的五种训练条件
Case AUC ADD-S AUC ADD-(S) ADD-(S) I w/o marker 97.1 90.0 84.8 II w marker 96.2 87.8 76.6 III inpainting 97.0 90.0 84.8 IV marker aug. 97.0 89.8 84.2 V aug. + marker 96.7 88.8 80.0
结论非常清晰:
固定 marker 训练、markerless 测试会造成 domain mismatch;
inpainting 完全恢复这张表中的 ADD-(S) baseline;
全随机 marker augmentation 几乎恢复;
固定 + 随机混合仍留下部分 shortcut。
需要指出论文内部数字不一致:Table 2 的 ADD-(S) 差值是 84.8 − 76.6 = 8.2 84.8-76.6=8.2 84.8 − 76.6 = 8.2
Conclusion 所说 augmentation 相比 unedited marker 提升约 3 points,更接近 Case V 的 80.0 − 76.6 = 3.4 80.0-76.6=3.4 80.0 − 76.6 = 3.4
8.2 为什么不是单纯“marker 遮挡了物体”
Table 3 把 test 改成有 marker:
训练 AUC ADD-S AUC ADD-(S) ADD-(S) VI w/o marker 96.4 88.3 77.7 VII w marker 97.5 91.0 87.1
如果 marker 只是遮挡物体表面,有 marker train 不应在 marker test 显著胜出。结果表明网络确实把 marker 当成判别 pose 的特征;训练 / 测试都保留它时反而有益,真正问题是 deployment domain 不一致。
8.3 真实 teabox 微调
在 markerless synthetic model 上用 200 张真实图微调 6 epochs,再在 59 张真实 markerless test 上评估:
真实微调数据 AUC ADD-S AUC ADD-(S) ADD-(S) I markerless real 93.6 79.0 45.8 III inpainted real 93.2 79.1 47.5 VIII no real finetuning 88.8 71.9 20.3
两种真实微调相近,且都比不微调高 25 points 以上。这一结果支持“real marker images 可先自动修复再用于 pose training”,但 test 只有 59 张、单对象、3 个场景,不能估计广泛 domain 下的小差异。
9. YCB-V:平均持平与 object-level failure 同时存在
9.1 Synthetic test
GDR-Net 的五对象平均:
markerless I:AUC ADD-S 79.9,ADD-S 78.0;
inpainting III:AUC ADD-S 81.3,ADD-S 77.5。
不同对象有升有降,没有一致性优势;支持的是“inpainting 没有系统性破坏”,不是“inpainting 提升 pose”。
9.2 Real test
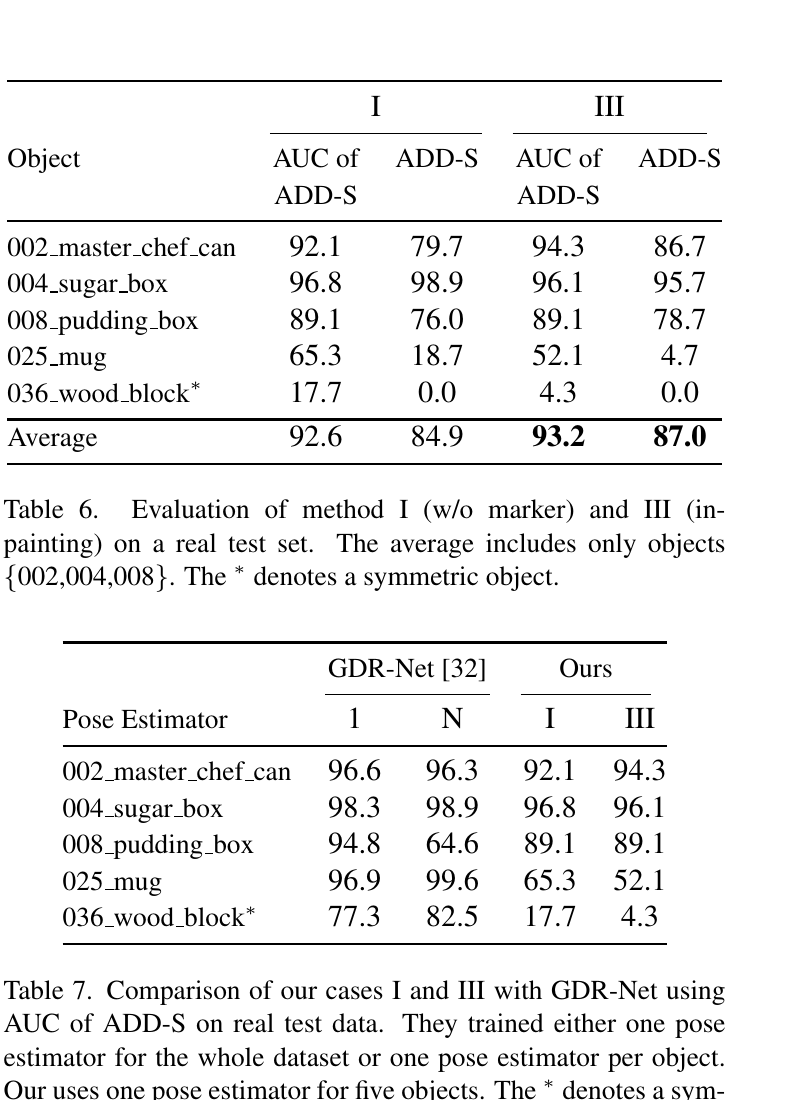
原论文 Tables 6–7:Table 6 的 average 只含 002、004、008;Table 7 显示本文统一五对象网络在 mug 和 wood block 上远弱于 GDR-Net 原论文配置,因此结果更适合比较 I 与 III,而不适合宣称整体 SOTA。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
对象 I AUC ADD-S III AUC ADD-S I ADD-S III ADD-S 002 master chef can 92.1 94.3 79.7 86.7 004 sugar box 96.8 96.1 98.9 95.7 008 pudding box 89.1 89.1 76.0 78.7 025 mug 65.3 52.1 18.7 4.7 036 wood block 17.7 4.3 0.0 0.0
论文平均只统计前三个对象:AUC ADD-S 92.6 → 93.2,ADD-S 84.9 → 87.0。Mug 和 wood block 因 synthetic-to-real gap 被排除。
这种平均口径应明确写出,不能直接说“YCB-V 提升 2.1 points”。如果五对象全部平均,结论会被两个 failure cases 显著改变。作者在正文中坦率展示这些失败,并用 Table 7 说明其统一五对象 estimator 与 GDR-Net 原论文 per-object / alternative training setup 不同;但 post-hoc exclusion 仍会提高平均结果的选择性。
9.3 ZebraPose 复核
为了排除 GDR-Net 特有 shortcut,作者每对象训练 ZebraPose:
测试域 Markerless I Inpainting III Synthetic AUC ADD-S 92.9 92.3 Real AUC ADD-S 60.9 61.8
两种策略继续接近,方向甚至在 synthetic / real 间互换。它加强“没有明显损害”的证据,却也说明 0.6–0.9 point 差异不应解释成稳定提升,尤其论文没有多 seed variance。
10. 标签噪声结果:精确真值可以抵消去 marker 的成本
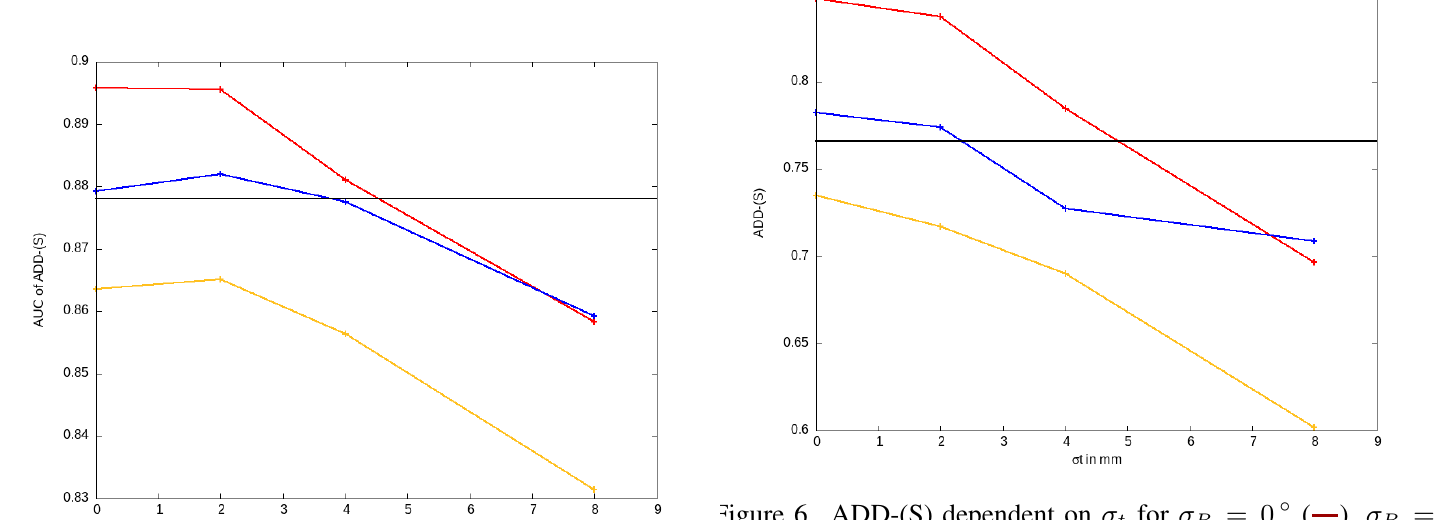
原论文 Figures 5–6(本站并排裁切):横轴为平移噪声标准差,红 / 蓝 / 黄分别为 0° / 2.5° / 5° 旋转噪声;黑线是 Case II 固定 marker 直接训练。AUC 和 threshold recall 对噪声的敏感度不同,但都显示旋转误差与较大平移误差会侵蚀精确标签的收益。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
可读出四点:
σ t = 2 \sigma_t=2 σ t = 2 σ R = 0 \sigma_R=0 σ R = 0 σ t ≥ 4 \sigma_t\ge 4 σ t ≥ 4 单独加入 2.5° rotation noise 就可使 recall 下降约 1.5–7 points;
marker Case II 的黑线提供一个权衡基准:当人工 markerless 标签足够粗时,保留 marker 获得的高精度标签即使有 shortcut,也可能比错误标注更好;最佳方案则是高精度 marker tracking 后再 inpaint。
曲线并非严格单调,例如某些 σ t = 2 \sigma_t=2 σ t = 2 σ t = 8 , σ R = 2.5 ° \sigma_t=8,\sigma_R=2.5° σ t = 8 , σ R = 2.5°
11. 这篇论文真正证明了什么
命题 证据强度 解释 固定 marker 会形成 pose shortcut 强 paired synthetic data + marker test sanity check 同时支持 两阶段 inpainting 能在 teabox 上恢复 baseline 强 Table 2 完全持平,且 real teabox 微调一致 Inpainting 对 YCB-V 总体无害 中等 GDR-Net / ZebraPose 平均接近,但对象少、两对象严重失败、多 seed 缺失 Marker augmentation 有效 中等 全随机 IV 几乎恢复;真实可行的 mixed V 只部分恢复 几毫米 / 几度标签误差显著 中等 controlled parameter sweep 清晰,但 noise model 理想化 Marker-based capture 一定优于 markerless capture 未证明 只在“marker 标签更准、mask 已知、修复适配、标定稳定”条件下成立
12. 局限与潜在偏差
12.1 对象和场景覆盖窄
主因果实验只有 teabox;YCB-V 也只有五对象。纹理、marker 大小占比、marker 附着面和对称性都会改变 shortcut 强度。
12.2 Mask 是近乎 oracle 的
marker 三维位置、camera pose 和 depth visibility 已知,所以 mask 非常准确。若实际采集系统只输出 object pose 而不保存 marker geometry,后处理难度会更高。
12.3 Marker shadow 没有彻底消除
作者明确说 elongated shadows 仍可能残留,只因特定 lighting 下较少见。网络可能从 shadow 学到 marker location;本文实验未显著受影响,不等于任意光照无影响。
12.4 真实测试存在选择性平均
Table 6 在看到 mug / wood block 明显失败后,只用另外三对象算 average。逐对象表仍完整公开,是优点;网站展示时必须保留失败行与平均口径。
12.5 单 seed 与无不确定区间
所有网络使用同一 seed 控制公平性,但没有重复训练。Teabox 的 8.2-point 差异很稳健;YCB-V 的 0.6–2.1-point 差异未必超过训练波动。
12.6 标签噪声不是现实标定误差
独立零均值 Gaussian 主要模拟随机人工误差。实际 marker 系统的对象—marker registration 偏差、相机外参或时钟误差可能对所有帧产生一致的 SE(3) bias,这种 systematic noise 更难由大量样本平均掉。
13. 复现要点
使用作者公开的 6DPoseDataGenTools 记录同一 random seed 下的 paired scenes;
保证 markerless / marker / inpainting / augmentation 只改变目标变量;
保存 marker 3D pose 和 mask,而不只是最终 object ground truth;
分清 AUC ADD-S、AUC ADD-(S) 与 10%d ADD-(S) 三列;
复现 Table 2 时核对原表 8.2-point gap,不采用正文 5.6 的矛盾数字;
YCB-V 真实平均同时报告“3 个保留对象”和“全部 5 对象”,避免选择性汇总;
至少跑 3–5 seeds,给小差异置信区间;
额外测试 systematic SE(3) calibration bias、depth scale bias 和 correlated temporal drift;
用 activation / occlusion attribution 检查网络是否仍关注 inpainting boundary 或 marker shadow。
14. 对数据集建设的直接建议
采集时保留可逆信息 :marker ID、三维几何、每帧 marker pose、visibility mask、object-to-marker transform、标定 covariance。同时发布 raw 与 cleaned RGB :允许后来者重新选择 inpainting 方法并审计 artifact。设置 marker-swap test :把 marker 放到与 GT pose 不一致的位置,直接量化 shortcut reliance。设计跨域四象限 :train / test 分别有无 marker,完整报告四个组合,而不只 marker train → no-marker test。给出 ground-truth uncertainty :不把 motion capture 输出视为无误差;记录 object–marker registration 和同步误差。避免只看平均 :按对象材质、对称性、marker 面积占比、遮挡比例和 pose bin 分层。
15. 最终评价
这篇论文提出的不是一个新的 SOTA estimator,而是一条重要的数据质量原则:
训练图像中的任何用于“获得标签”的装置,都可能同时成为模型预测标签的 shortcut;消除装置外观与保持标签精度必须一起设计。
它通过 paired synthetic control、真实微调、跨对象 YCB-V、第二种 pose network 和 label-noise sweep 建立了比单一结果表更完整的证据链。最可靠的结论是:固定 marker 确实会造成 domain mismatch;两阶段 inpainting 在本文条件下几乎无损;标签精度对最终 pose 很重要。
最需要克制的地方是外推:五对象、单 seed、oracle mask、Gaussian label noise 和 selective average 还不足以证明 marker-based capture 普遍优于 markerless annotation。把这套方法用于新数据集时,应把 marker removal、标定不确定性和 shortcut audit 作为数据协议的一部分,而不是最后一步修图。