论文精读笔记:MemPose: Category-level Object Pose Estimation with Memory
1. 基本信息
标题:MemPose: Category-level Object Pose Estimation with Memory
作者:Xiao Lin、Minghao Zhu、Yun Peng、Liuyi Wang、Qiyi Wang、Chengju Liu、Qijun Chen
机构:Tongji University、State Key Laboratory of Autonomous Intelligent Unmanned Systems
年份 / 会议:ECCV 2026 Poster
论文链接:arXiv:2607.04930 v1
ECCV 条目:官方 Poster 页面
代码 / 项目页:截至本站核验时,论文、arXiv 与 ECCV 页面均未提供公开代码或项目页
阅读模式:精读
阅读重点:外部 memory 里究竟存什么、写入 / 检索是否构成真正的动态记忆、主结果是否使用测试流更新,以及性能提升能否与参数量、backbone 和 mask 设定区分开。
2. 一句话定位
MemPose 是一个 RGB-D category-level 9DoF object pose and size 网络:它沿用 AG-Pose 的实例自适应关键点与几何聚合框架,将每个历史训练实例的 pooled local feature 写入按类别划分、长度 96 的非参数 memory buffer;新 token 通过带 Gumbel noise 的 similarity merge 更新,当前关键点以 attention 读取历史表示并通过 sigmoid gate 融合,最终联合预测 NOCS、旋转、平移与尺寸。
我的核心判断
MemPose 提出的不是新 pose representation 或几何 solver,而是一种类别知识的存储形式 。它试图在两类既有方案之间建立第三条路线:不把类别形状完全固定成一个 average shape prior,也不把全部经验隐式压进静态权重,而是保留一个 checkpoint 可携带、容量固定、可读写的 feature prototype bank。
实验足以说明这种设计在 AG-Pose 风格 baseline 上有效:REAL275、HouseCat6D、CAMERA25 与 Wild6D 多数指标提升,等参数 MLP 不能复现完整收益,多种 memory update / retrieval / fusion 消融也方向一致。尤其是 HouseCat6D IoU 与 Wild6D IoU75 的提升,说明它不只在 synthetic NOCS 域有效。
但论文对 dynamic memory 的叙述必须按阶段拆开:
训练时 buffer 随 mini-batch 更新,确实是动态的;
所有主 benchmark 在推理时冻结 buffer,只做 query-dependent readout;
测试时继续更新只作为 REAL275 附加实验,且缺少 stream order、reset、数据泄漏边界与跨域污染协议。
因此标准 MemPose 不是已经验证完备的 continual learner。更准确的定位是:利用训练期动态压缩得到的类别特征库,为冻结推理提供非参数先验 。
2.1 论文图表导读
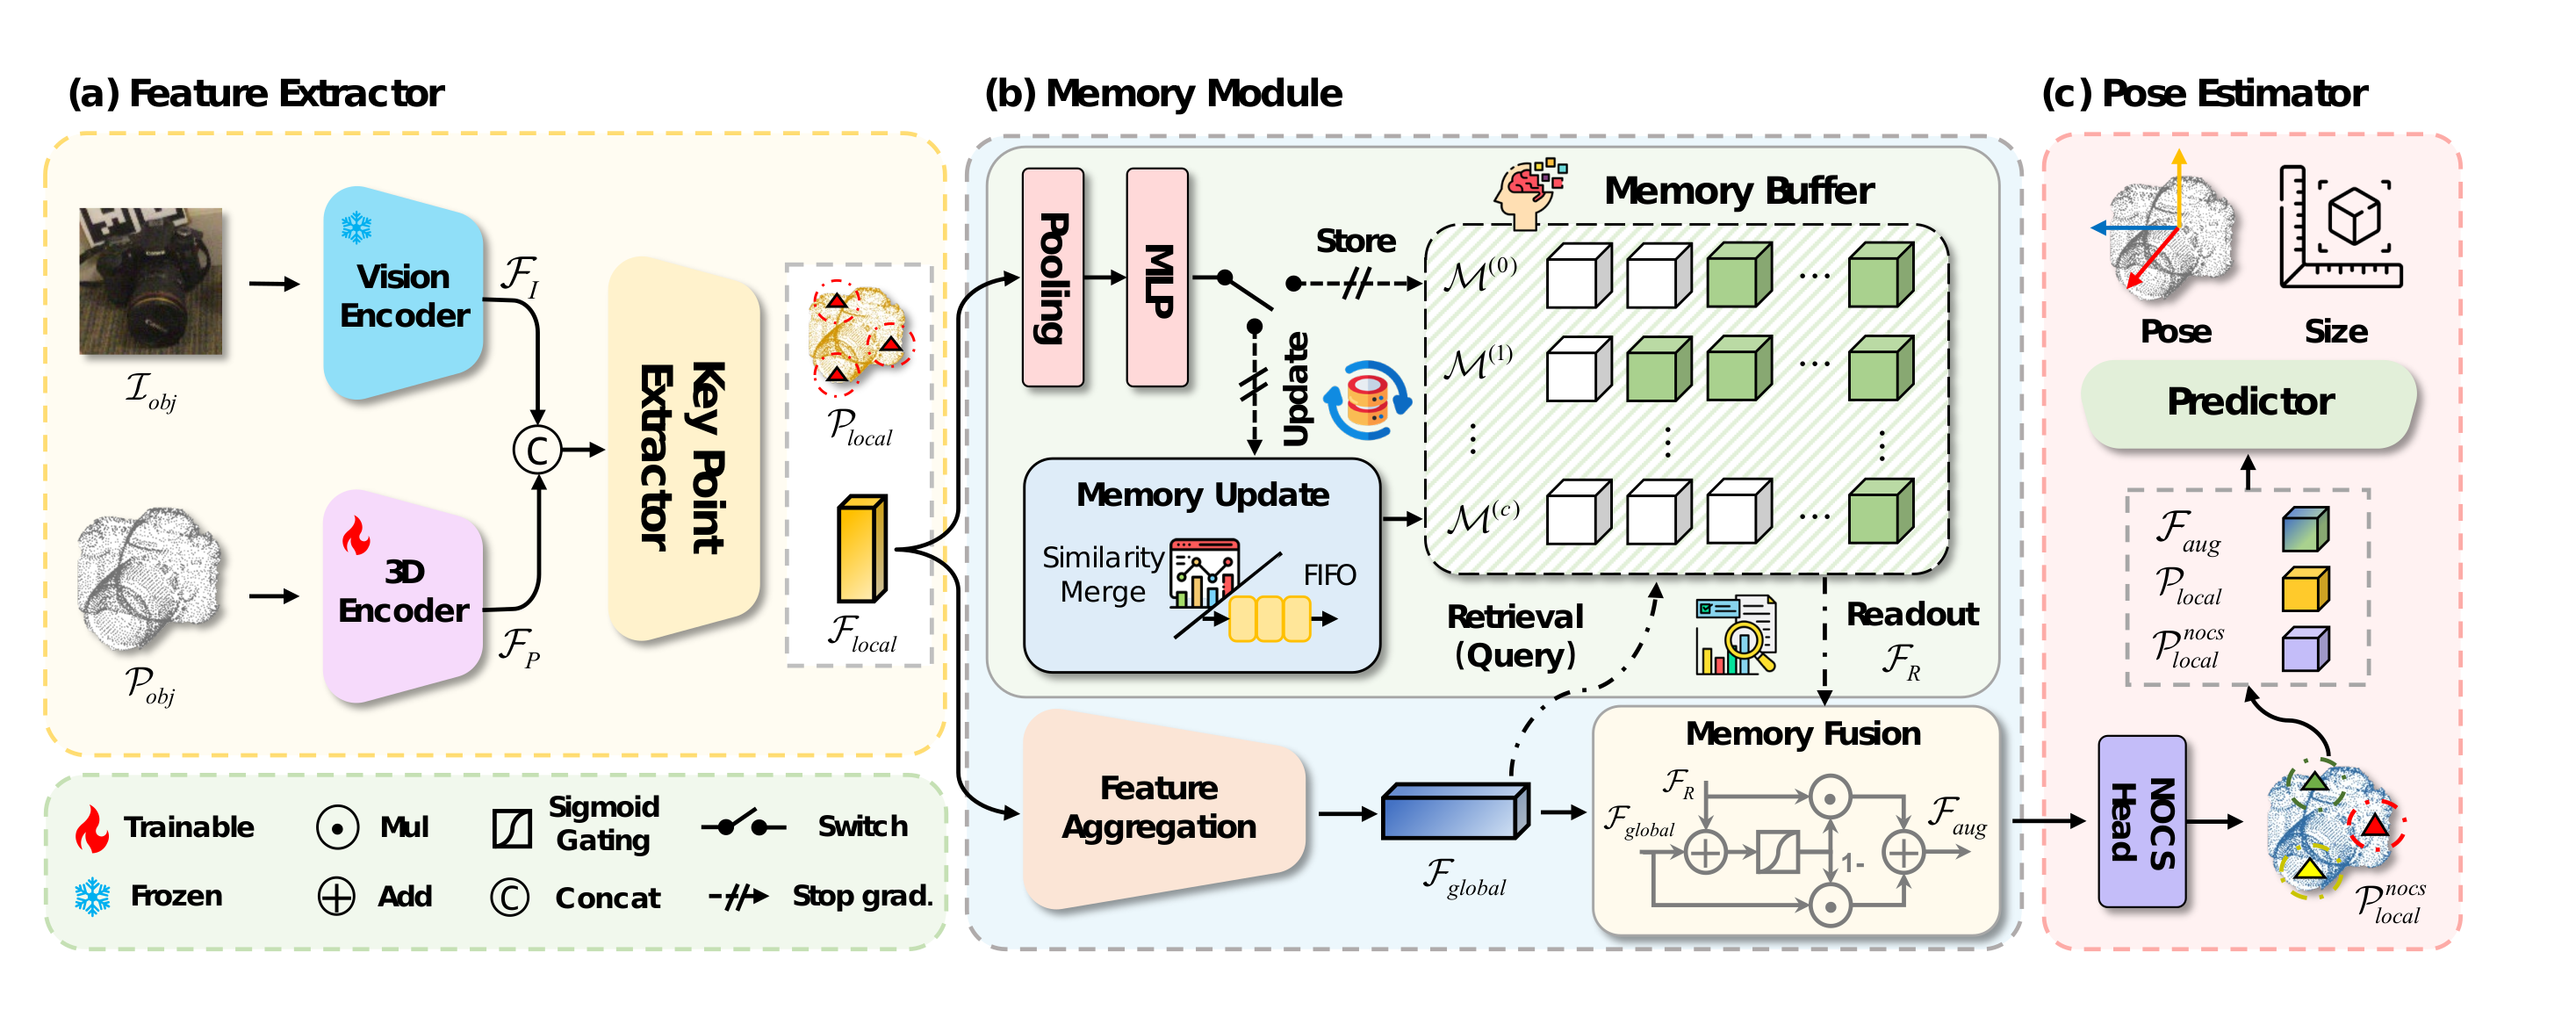
图表 内容 证据作用 需要警惕的解读 Figure 2 RGB / point cloud 双流、96 个关键点、按类 memory、similarity merge、attention readout、gate fusion 与 pose head 完整解释 memory 在 pipeline 中的写入和读取位置 图中的 memory cubes 不是显式 3D shape;实际存的是 256 维 pooled learned feature Table 1 REAL275 与 HouseCat6D 的 prior-based / prior-free 主结果 证明在两个真实 benchmark 上整体提升 baseline 的 backbone、mask、训练代码和可用指标并不全部一致 Table 5 update period、merge balance、retrieved size 与 fusion 对 memory 内部设计给出受控消融 多数差距较小,不能把每个选择都描述为关键突破 Tables 7–8 参数、训练时间、FPS、等参数 MLP、ResNet18、冻结 / 更新 memory 区分参数增量与 memory 机制,并揭示测试更新潜力 原文对 33 vs. 35 FPS 的文字解读写反;测试更新结果不是主表公平设置
原论文 Figure 2:冻结的 DINOv2 与可训练 3D encoder 提取 RGB-D 表示,实例自适应 keypoint extractor 产生局部结构特征;按类别的 memory 负责写入、更新、查询和 gate fusion,增强后的关键点特征再进入 NOCS 与 pose / size predictor。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
3.1 任务定义
给定一张含有预定义类别对象的 RGB-D 图像,方法先使用外部 instance mask 得到对象 crop:
I o b j ∈ R H × W × 3 . I_{obj}\in\mathbb R^{H\times W\times 3}. I o bj ∈ R H × W × 3 . 用 depth、mask 和相机内参反投影,并下采样为:
P o b j ∈ R N × 3 . P_{obj}\in\mathbb R^{N\times 3}. P o bj ∈ R N × 3 . 目标是恢复该未见实例的 9DoF pose and size:
R ∈ S O ( 3 ) , t ∈ R 3 , s ∈ R 3 . R\in SO(3),\qquad t\in\mathbb R^3,\qquad s\in\mathbb R^3. R ∈ S O ( 3 ) , t ∈ R 3 , s ∈ R 3 . 其中 R , t R,t R , t s s s 9DoF 是 rotation、translation 和 anisotropic size 的合称;它不是一个任意仿射变换,也不包含非刚性形变参数。
3.2 Instance-level / category-level 与 seen / unseen
category-level :训练覆盖预定义语义类别,测试对象是这些类别中的新实例。unseen instance :不需要该测试实例的 CAD,也没有针对它单独训练;但其语义类别在训练集内。不是 unseen category :buffer 明确按类别路由,若输入一个训练类别之外的对象,论文没有 unknown detection 或新 buffer 初始化协议。不是 instance-level model-based pose :没有用目标 CAD 做 2D–3D template matching 或 registration。
3.3 输入、输出和依赖
项目 是否需要 证据 / 作用 RGB 是 DINOv2 ViT-S/14 提供 semantic feature depth 是 反投影 1,024 点对象点云;PointNet++ 提供 geometry feature camera intrinsics 是 从 crop depth 建立相机坐标点云 instance mask 是 论文使用与 AG-Pose / DPDN 相同的 Mask R-CNN masks category ID 是 选择对应 category-specific memory buffer target CAD 否 category-level prior-free 设定的主要优势 NOCS / 9DoF GT 训练需要 监督 NOCS、旋转、平移、尺寸及关键点约束 multi-view / video 否 标准输入是单帧已分割 RGB-D;Wild6D 视频仅作为数据来源 test-time optimization 否 主结果是一次前馈 + memory readout,不做迭代 refinement
3.4 model-free 不等于无先验
本文和 category-level pose 社区常把“不依赖实例 CAD”称为 model-free。但 MemPose 仍有明显先验:
类别集合与类别 ID;
带 9DoF / NOCS 标注的训练数据;
Mask R-CNN segmentation;
depth 与相机模型;
训练数据压缩形成的类别 memory;
DINOv2 的大规模视觉预训练。
因此,适合写作的表述是“CAD-free category-level pose”,而不是“无需模型和先验”。
3.5 Pipeline 是否端到端
从 crop RGB-D 到 R , t , s R,t,s R , t , s
4. 研究脉络
4.1 Shape-prior 路线
NOCS 建立 normalized object coordinate space,使同一类别的不同实例可以映射到共享 canonical frame。SPD、SGPA、RBP-Pose、DPDN、GCE-Pose 等方法进一步使用平均类别 shape prior、deformation 和 correspondence,先恢复实例形状或匹配关系,再求 pose。
这条路线的优点是结构先验显式、可与 NOCS / correspondence 对接;局限是 prior 构建与预处理成本高,单个固定模板也难覆盖类别内长尾几何。MemPose 不是在这个 prior 上做 deformation,而是完全不输入显式 shape prior。
4.2 Prior-free 参数化路线
FS-Net、GPV-Pose、VI-Net、SecondPose、AG-Pose、KeyPose、SpherePose 等直接从 RGB-D / point cloud 学习 pose-sensitive representation。AG-Pose 尤其接近本文:它用 instance-adaptive keypoints 与 local / global geometric aggregation 建立 category-level correspondence。
MemPose 的 backbone、关键点提取和 pose head 大量继承 AG-Pose;真正新增的是:
把局部关键点特征池化成 memory entry;
按类别维护固定容量 buffer;
similarity-based merge 与 balance;
attention readout 和 gated fusion。
所以最公平的问题不是“MemPose 是否胜过所有 category-level pose 思路”,而是“在 AG-Pose 这类强 prior-free keypoint baseline 上,外部 memory 是否带来可重复增益”。
4.3 与 temporal memory 的区别
MemFlow、streaming point tracking、3D object tracking、VLA memory 和 video memory 通常依赖时间连续性:memory 记录同一场景或同一对象在前几帧的状态。MemPose 的 memory 不要求同一实例或连续视频;它把不同训练实例的 pooled features 按语义类别聚合,目标是 intra-category analogical retrieval。
因此其 memory 更接近一个类别原型 bank ,而不是 trajectory memory。测试时更新版本才开始具有 stream memory 的性质,但论文没有以 continual sequence 为核心评测。
4.4 与 retrieval / prototype learning 的关系
从机器学习视角看,MemPose 可理解为:
parametric encoder 产生当前 query;
non-parametric buffer 保存训练分布的 prototype tokens;
cross-attention 进行软 kNN / associative retrieval;
gate 决定当前特征与历史原型的混合比例。
论文把它称为 memory 有合理性,但“能写、能读、有容量”本身并不自动等价于人类式记忆。它是否学习到真正的几何语义,需要比单个 attention 案例更系统的检索分析。
5. 研究动机
5.1 为什么固定平均 shape 不够
同一类别可能包含细长与矮胖杯子、不同把手、不同鞋型或不同相机机身。平均 shape 往往模糊少数实例的局部结构,且一个预先构建的 prior 不会随着新数据更新。
5.2 为什么网络参数也不够
理论上,大模型权重可以编码全部类别经验;但权重更新需要反向传播,部署时不会因观察到新实例就立即增加一个结构原型。外部 buffer 允许在不改变参数的情况下调整可检索内容。
5.3 为什么存局部关键点而不是最终 pose feature
作者认为,最终输出特征受当前网络状态与 recent updates 影响较大,检索可能偏向“时间上较新”而非“几何上相关”。MemPose 选择 average-pooled local keypoint features,希望它们更直接表达局部结构。
这个动机合理,但 average pooling 会丢失关键点间的排列、相对位置和多个局部模式。实际 token 是否比 global feature 更几何化,主要由 Table 4a 的性能差异支持,而不是显式 shape reconstruction 或 retrieval precision 指标。
5.4 为什么固定容量
无限保存每个历史实例会让 memory、attention 复杂度与训练样本数一起增长。长度 96 的 category buffer 保持固定计算预算,similarity merge 则试图把相似实例压进同一 token。
6. 方法详解
6.1 总体 Pipeline
Mask R-CNN 提供对象 mask,裁出 RGB 与 depth。
用相机内参将 depth 反投影为 1,024 点对象点云。
冻结 DINOv2 提取 RGB semantic features,PointNet++ 提取 point features。
将图像特征插值到 3D points,与 point features 拼接。
96 个 learnable category embeddings 通过 cross-attention 找到 instance-adaptive keypoints。
关键点局部特征一方面写入对应类别 memory,另一方面做 geometric aggregation。
memory 完成 warm-up 后,先 update,再以 global keypoint features query 全部 entries。
retrieved features 与当前 global features 经 sigmoid gate 融合。
NOCS head 预测关键点 canonical coordinates;pose / size head 联合恢复 R , t , s R,t,s R , t , s
6.2 模块级输入输出
模块 输入 输出 作用 主要风险 DINOv2 encoder 224×224 RGB crop 点对应的 F I F_I F I 提供语义与纹理上下文 frozen backbone 的 domain bias;高光和无纹理仍可能失败 PointNet++ 1,024 点对象点云 F P F_P F P 提供局部 3D 几何 depth 孔洞、mask 混入背景会污染特征 Keypoint extractor 拼接的 F o b j F_{obj} F o bj P l o c a l , F l o c a l P_{local},F_{local} P l oc a l , F l oc a l 选稳定且区分性强的对象区域 keypoints 不具跨实例固定语义保证 Memory writer pooled F l o c a l F_{local} F l oc a l 单个 F m e m F_{mem} F m e m 将一个实例压成一个 token average pooling 丢失空间结构 Similarity merge 新 token + 类别 buffer 更新后的固定容量 buffer 去冗余并保留新经验 0.5 均值无计数,顺序敏感、可能覆盖稀有形状 Geometric aggregation 当前局部 keypoint features / neighborhoods F g l o b a l F_{global} F g l o ba l 建立局部和全局结构上下文 继承 AG-Pose 假设与复杂度 Memory retrieval F g l o b a l F_{global} F g l o ba l F R F_R F R 读取与当前对象相关的类别经验 attention 可能按 pose / appearance 而非 shape 检索 Gate fusion F R , F g l o b a l F_R,F_{global} F R , F g l o ba l F a u g F_{aug} F a ug 自适应控制历史与当前贡献 gate 缺少显式可信度或 out-of-distribution rejection NOCS / pose head F a u g , P l o c a l , P l o c a l n o c s F_{aug},P_{local},P^{nocs}_{local} F a ug , P l oc a l , P l oc a l n ocs R , t , s R,t,s R , t , s 形成 9DoF 预测 依赖 NOCS 监督与外部 mask
PointNet++ 得到:
F P ∈ R N × C 1 . F_P\in\mathbb R^{N\times C_1}. F P ∈ R N × C 1 . DINOv2 ViT-S/14 的 image features 通过像素对应与线性插值投到 3D points:
F I ∈ R N × C 2 . F_I\in\mathbb R^{N\times C_2}. F I ∈ R N × C 2 . 拼接后:
F o b j = [ F P ; F I ] ∈ R N × C , F_{obj}=[F_P;F_I]\in\mathbb R^{N\times C}, F o bj = [ F P ; F I ] ∈ R N × C , 实验设置 C 1 = C 2 = 128 C_1=C_2=128 C 1 = C 2 = 128 C = 256 C=256 C = 256
6.4 Instance-adaptive keypoints
模型初始化 M = 96 M=96 M = 96
F c a t ∈ R M × C . F_{cat}\in\mathbb R^{M\times C}. F c a t ∈ R M × C . 它们以 F o b j F_{obj} F o bj
F i n s = CrossAttn ( F c a t , F o b j ) . F_{ins}=\operatorname{CrossAttn}(F_{cat},F_{obj}). F in s = CrossAttn ( F c a t , F o bj ) . 再计算 F i n s F_{ins} F in s
H ∈ R M × N . H\in\mathbb R^{M\times N}. H ∈ R M × N . 以 softmax 权重对坐标和特征加权:
P l o c a l = softmax ( H ) P o b j , P_{local}=\operatorname{softmax}(H)P_{obj}, P l oc a l = softmax ( H ) P o bj , F l o c a l = softmax ( H ) F o b j . F_{local}=\operatorname{softmax}(H)F_{obj}. F l oc a l = softmax ( H ) F o bj . 这些 keypoints 是数据驱动的软位置,不是传统 FPS,也不是由人工定义的语义 landmarks。它们能随实例形状移动,但跨实例是否保持同一部件含义,需要 NOCS、pose、diversity 和 reconstruction losses 共同约束。
6.5 Category-specific memory
论文定义按类别划分的 buffer:
M = { M ( c ) ∣ c = 0 , … , k } , M ( c ) ∈ R L × C . \mathcal M=\{\mathcal M^{(c)}\mid c=0,\dots,k\},\qquad
\mathcal M^{(c)}\in\mathbb R^{L\times C}. M = { M ( c ) ∣ c = 0 , … , k } , M ( c ) ∈ R L × C . 这里 L = 96 L=96 L = 96 6 × 96 × 256 6\times96\times256 6 × 96 × 256 10 × 96 × 256 10\times96\times256 10 × 96 × 256
Entry construction
对一个实例的 96 个 local features 做 average pooling:
F l o c a l a v g = AvgPool ( F l o c a l ) , F^{avg}_{local}=\operatorname{AvgPool}(F_{local}), F l oc a l a v g = AvgPool ( F l oc a l ) , 再经 MLP 和 normalization:
F m e m = Norm ( MLP ( F l o c a l a v g ) ) . F_{mem}=\operatorname{Norm}(\operatorname{MLP}(F^{avg}_{local})). F m e m = Norm ( MLP ( F l oc a l a v g )) . 一个实例最终只贡献一个 256 维 token。这使读取便宜,却把多个局部 keypoints 的配置压成 unordered mean。所谓“structural representation”主要存在于 encoder 特征,而不是 token 自身保存了点坐标或邻接关系。
6.6 Warm-up、更新和 Gumbel balance
每个类别 buffer 从空开始。在装满 L L L
装满后,对新 token 与已有 entries 计算 cosine similarity:
i ∗ = arg max i cos ( F m e m , M i ( c ) ) . i^*=\arg\max_i\cos(F_{mem},\mathcal M_i^{(c)}). i ∗ = arg i max cos ( F m e m , M i ( c ) ) . 基础 merge 为:
M i ∗ ( c ) ← 1 2 ( M i ∗ ( c ) + F m e m ) . \mathcal M_{i^*}^{(c)}\leftarrow
\frac{1}{2}(\mathcal M_{i^*}^{(c)}+F_{mem}). M i ∗ ( c ) ← 2 1 ( M i ∗ ( c ) + F m e m ) . 为避免少数高频槽位反复被选,最终配置向 similarity 加 Gumbel noise:
g = − log ( − log u ) , u ∼ U ( 0 , 1 ) , g=-\log(-\log u),\qquad u\sim U(0,1), g = − log ( − log u ) , u ∼ U ( 0 , 1 ) , sim i ← sim i + λ g , q q u a d λ = 0.1. \operatorname{sim}_i\leftarrow
\operatorname{sim}_i+\lambda g,qquad \lambda=0.1. sim i ← sim i + λ g , q q u a d λ = 0.1. 这相当于对“最相似 entry”做轻微随机平衡。论文也比较 FIFO 和 top-k k k
我的分析:0.5 merge 的统计含义
若一个槽位连续吸收 x 1 , x 2 , … x_1,x_2,\dots x 1 , x 2 , … m ← ( m + x ) / 2 m\leftarrow(m+x)/2 m ← ( m + x ) /2
论文没有报告多种数据顺序下 memory 方差,也没有把 entry 的年龄、更新次数或 cluster occupancy 可视化。若要把它扩展为长期 memory,计数均值、EMA decay、reservoir sampling、coreset 或 uncertainty-aware replacement 都值得比较。
6.7 Update-before-retrieve
最终设置在当前样本上先更新 memory,再做 retrieval。这意味着训练时当前实例的 token 可能已经直接或间接进入它随后读取的 buffer。作者将其解释为使用最新上下文,Table 5a 也优于 post-update。
但这和“从 previously observed instances 读取历史经验”的叙述并不完全相同:当前样本具有一条短路径回到自身增强特征。由于 token 经 stop-gradient / non-trainable buffer 保存,它不是普通 residual connection,却可能让 retrieval 更容易匹配当前实例。更严格的验证可比较 leave-current-out retrieval,确认收益来自跨实例 memory 而非 self-entry。
6.8 Memory retrieval
当前关键点先通过 AG-Pose 风格 geometric aggregation,融合 kNN 局部细节与全部 keypoints 的全局关系:
F g l o b a l ∈ R M × C . F_{global}\in\mathbb R^{M\times C}. F g l o ba l ∈ R M × C . 对当前类别的 L L L
q = F g l o b a l W q , k = F m e m ′ W k , v = F m e m ′ W v , q=F_{global}W_q,\qquad
k=F'_{mem}W_k,\qquad
v=F'_{mem}W_v, q = F g l o ba l W q , k = F m e m ′ W k , v = F m e m ′ W v , F R = Softmax ( q k T D k ) v . F_R=\operatorname{Softmax}\left(
\frac{qk^T}{\sqrt{D_k}}
\right)v. F R = Softmax ( D k q k T ) v . 每个 current keypoint 都可对 96 个类别 entries 分配不同 attention。虽然 memory entry 是实例级 pooled token,query 仍是 keypoint-level,因此输出 F R F_R F R F g l o b a l F_{global} F g l o ba l
6.9 Adaptive gate fusion
直接相加假设 memory 永远可靠,concat 则把融合责任完全交给后续层。MemPose 显式预测 gate:
w a = σ ( F R W R + F g l o b a l W f ) , w_a=\sigma(F_RW_R+F_{global}W_f), w a = σ ( F R W R + F g l o ba l W f ) , F a u g = w a ⊙ F R + ( 1 − w a ) ⊙ F g l o b a l . F_{aug}=w_a\odot F_R+(1-w_a)\odot F_{global}. F a ug = w a ⊙ F R + ( 1 − w a ) ⊙ F g l o ba l . W R , W f ∈ R C × 1 W_R,W_f\in\mathbb R^{C\times1} W R , W f ∈ R C × 1
6.10 NOCS、pose 与 size prediction
F a u g F_{aug} F a ug
P l o c a l n o c s ∈ R M × 3 . P^{nocs}_{local}\in\mathbb R^{M\times3}. P l oc a l n ocs ∈ R M × 3 . 最终 predictor 同时读取 P l o c a l P_{local} P l oc a l P l o c a l n o c s P^{nocs}_{local} P l oc a l n ocs F a u g F_{aug} F a ug R , t , s R,t,s R , t , s
7. 训练目标与工程复杂度
7.1 Pose loss
L p o s e = ∥ R g t − R ∥ 2 + ∥ t g t − t ∥ 2 + ∥ s g t − s ∥ 2 . \mathcal L_{pose}=
\|R_{gt}-R\|_2+
\|t_{gt}-t\|_2+
\|s_{gt}-s\|_2. L p ose = ∥ R g t − R ∥ 2 + ∥ t g t − t ∥ 2 + ∥ s g t − s ∥ 2 . 直接对 rotation matrix 做 L2 简单稳定,但不是 S O ( 3 ) SO(3) S O ( 3 )
7.2 Keypoint diversity loss
对于距离小于阈值 t h 1 = 0.01 th_1=0.01 t h 1 = 0.01
d ( P i , P j ) = max { t h 1 − ∥ P i − P j ∥ 2 , 0 } . d(P_i,P_j)=\max\{th_1-\|P_i-P_j\|_2,0\}. d ( P i , P j ) = max { t h 1 − ∥ P i − P j ∥ 2 , 0 } . 求和得到 L d i v \mathcal L_{div} L d i v
7.3 Object-aware Chamfer loss
L o c d = 1 ∣ P l o c a l ∣ ∑ x i ∈ P l o c a l min y j ∈ P o b j ′ ∥ x i − y j ∥ 2 . \mathcal L_{ocd}=
\frac{1}{|P_{local}|}
\sum_{x_i\in P_{local}}
\min_{y_j\in P'_{obj}}\|x_i-y_j\|_2. L oc d = ∣ P l oc a l ∣ 1 x i ∈ P l oc a l ∑ y j ∈ P o bj ′ min ∥ x i − y j ∥ 2 . P o b j ′ P'_{obj} P o bj ′
7.4 NOCS supervision
论文用 GT R , t , s R,t,s R , t , s P l o c a l g t P^{gt}_{local} P l oc a l g t P l o c a l n o c s P^{nocs}_{local} P l oc a l n ocs
7.5 Partial reconstruction
模型还根据 keypoint positions 与 features 解码 partial point cloud,并用 object-aware Chamfer distance 约束。这是辅助 representation learning,而不是最终输出完整 shape。论文没有报告 reconstruction quality,也没有将 memory 用于显式 shape completion。
7.6 总损失
L a l l = α 1 L p o s e + α 2 L d i v + α 3 L o c d + α 4 L r e c + α 5 L n o c s , \mathcal L_{all}=
\alpha_1\mathcal L_{pose}+
\alpha_2\mathcal L_{div}+
\alpha_3\mathcal L_{ocd}+
\alpha_4\mathcal L_{rec}+
\alpha_5\mathcal L_{nocs}, L a l l = α 1 L p ose + α 2 L d i v + α 3 L oc d + α 4 L r ec + α 5 L n ocs , 权重依次为:
( α 1 , α 2 , α 3 , α 4 , α 5 ) = ( 0.3 , 10.0 , 2.0 , 15.0 , 2.0 ) . (\alpha_1,\alpha_2,\alpha_3,\alpha_4,\alpha_5)
=(0.3,10.0,2.0,15.0,2.0). ( α 1 , α 2 , α 3 , α 4 , α 5 ) = ( 0.3 , 10.0 , 2.0 , 15.0 , 2.0 ) . 论文没有提供 loss-term ablation,因此我们无法知道 memory 增益是否依赖 reconstruction 或 keypoint losses 的特定组合。
7.7 训练配置
crop:224×224;
points:N = 1024 N=1024 N = 1024 M = 96 M=96 M = 96
feature:C 1 = C 2 = 128 C_1=C_2=128 C 1 = C 2 = 128 C = 256 C=256 C = 256
buffer length:每类别 96;
optimizer:Adam;
训练:120K iterations、batch 36、单张 NVIDIA L40;
cyclical learning rate:2 × 10 − 5 2\times10^{-5} 2 × 1 0 − 5 5 × 10 − 4 5\times10^{-4} 5 × 1 0 − 4
augmentation:沿用 DPDN / AG-Pose,论文列随机 rotation、translation 与 scale 范围;原文 scale 区间排版为 U ( − 0.18 , 1.2 ) U(-0.18,1.2) U ( − 0.18 , 1.2 )
7.8 Memory 的参数与存储
buffer 通过 register_buffer 保存:
随 checkpoint 保存 / 恢复;
不被 optimizer 更新;
不参加 gradient backpropagation;
entries 由当前 encoder feature 在线写入。
因此它是 non-parametric state,但整个系统仍有 225M trainable parameters。把方法称为“非参数方法”是不准确的;只有 memory bank 本身非参数。
8. 推理协议:最关键的证据边界
8.1 Frozen-memory 主结果
训练结束后保存各类别 buffer,测试时只读取、不写入。Table 1–3、与 SOTA 的所有主比较都使用这个设置。它具有三点好处:
每个测试样本相互独立,结果不依赖顺序;
不把测试分布的信息写回模型状态;
能和既有静态网络公平比较。
虽然 buffer 内容固定,但 retrieval attention 和 gate 仍随当前 query 改变,所以“读取是动态的”,只是“记忆内容不更新”。
8.2 Updating-memory 附加实验
作者也允许测试时把新对象 feature 写回 memory。REAL275 结果为:
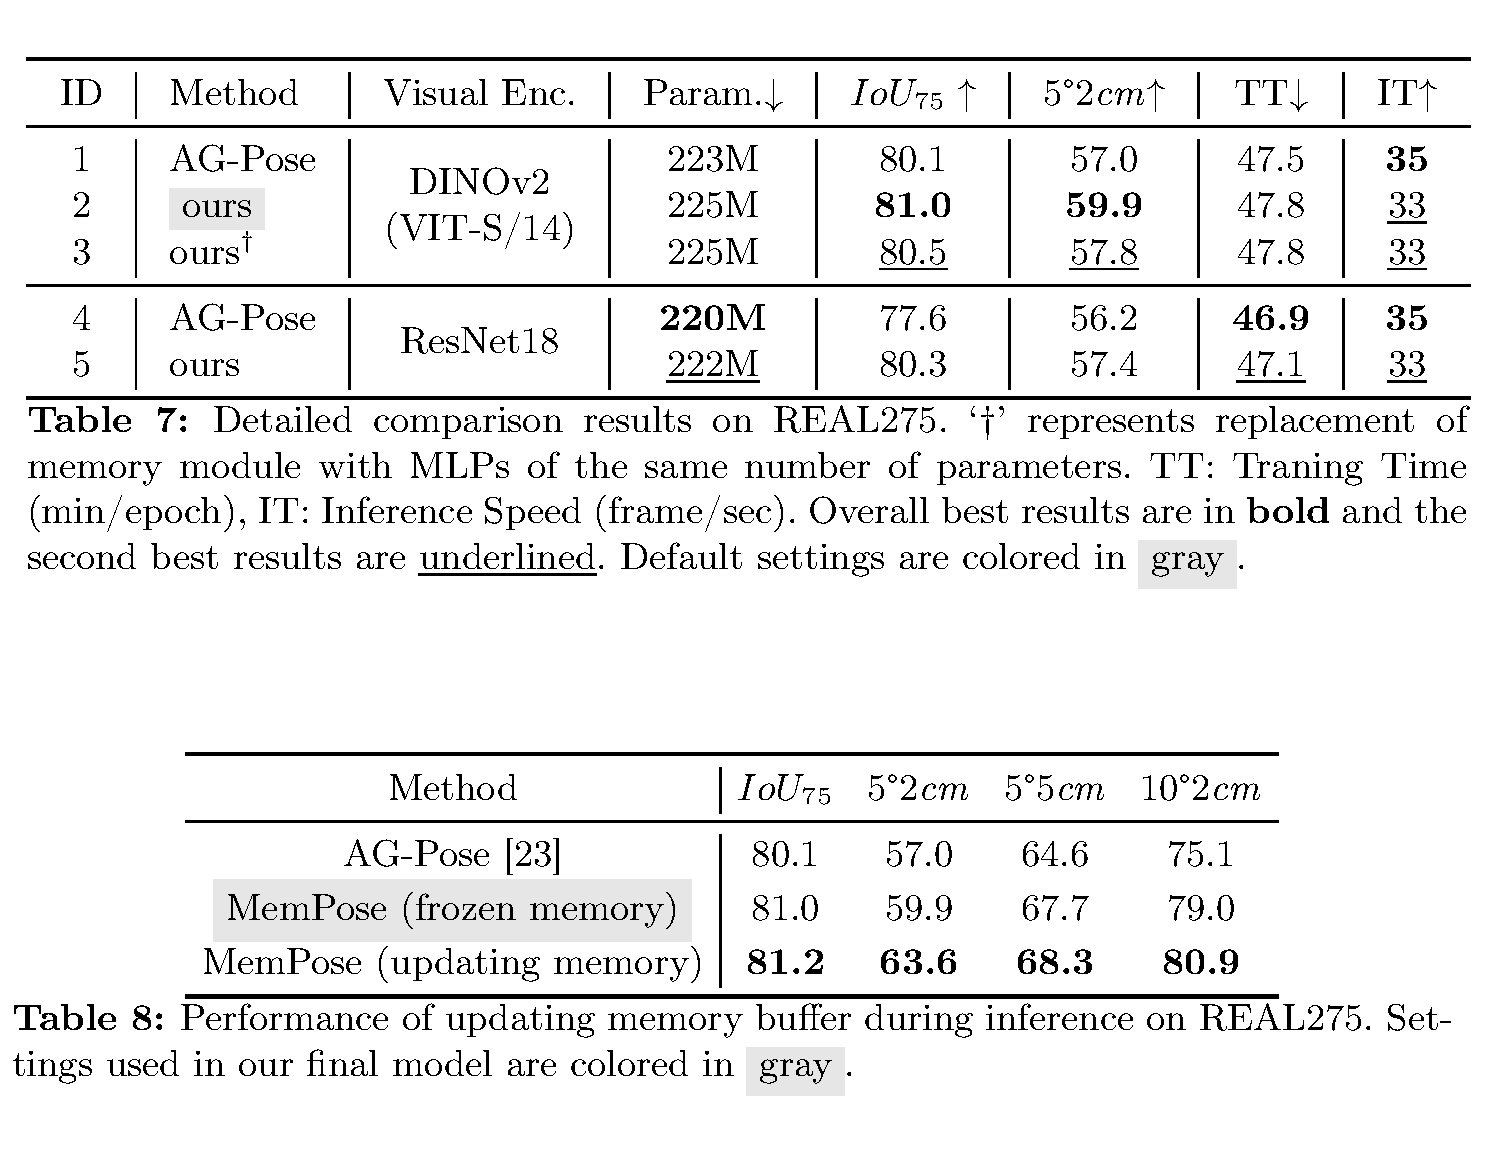
设置 IoU75 5°2 cm5°5 cm10°2 cmAG-Pose 80.1 57.0 64.6 75.1 MemPose frozen 81.0 59.9 67.7 79.0 MemPose updating 81.2 63.6 68.3 80.9
更新对 5°2 cm 带来 +3.7 点,是一个值得继续研究的信号。但论文没有充分交代:
test samples 的遍历顺序;
每个 scene / category / sequence 是否重置;
多种随机顺序的均值与方差;
是否允许使用已知 category label;
一次测试样本在更新后是否影响自身 prediction;
不同数据域连续出现时是否发生 memory contamination;
是否有错误预测导致自强化。
因此它更像 transductive / online adaptation proof-of-concept,不应与 frozen baseline 混为同一协议。
9. 实验分析
9.1 数据集
REAL275 / CAMERA25
REAL275 是 NOCS 的真实测试集,覆盖六个类别;论文列出训练 4.3K images / 7 scenes,测试 2.75K images / 6 scenes,每类 3 个测试对象。CAMERA25 是相同类别的 300K synthetic RGB-D 数据,25K 留作 synthetic test。REAL275 评测使用 CAMERA25 参与训练。
HouseCat6D
HouseCat6D 覆盖十个家庭类别,包含玻璃、餐具等 photometrically challenging objects,并有明显遮挡。它比 NOCS 六类更能检验类别数量扩展与复杂真实材质,但仍依赖提供的 mask / depth。
Wild6D
Wild6D 有五类、162 个对象与 486 个不同背景视频。论文只使用其 test set,训练使用 CAMERA25 与 REAL275。虽然数据来自视频,MemPose 标准推理并不做 temporal tracking;每帧仍作为已分割 RGB-D observation 处理。
论文自己的计数措辞
摘要称实验覆盖四个 benchmarks,正文也列 REAL275、CAMERA25、HouseCat6D、Wild6D;contribution / conclusion 又写“三个 challenging benchmarks”。这可能把 CAMERA25 与 REAL275 共同视为 NOCS family,但论文没有解释。本站按四个具名数据集记录,同时把真实 benchmark 理解为 REAL275、HouseCat6D 和 Wild6D 三组。
9.2 指标
3D IoU mAP
预测 R , t , s R,t,s R , t , s
联合旋转 / 平移阈值
5°2 cm 表示旋转误差小于 5°且平移误差小于 2 cm 才算正确;其他阈值同理。它同时约束 orientation 与 center,但不直接约束 size,因此需与 IoU 一起看。
指标局限
没有 ADD(-S)、MSSD、MSPD 或真实抓取成功率;
对称对象如何计算 rotation error,正文只说 following previous works,没有给完整规则;
mAP 阈值不能反映误差分布尾部与 calibration;
segmentation failure 被固定 mask protocol 部分隔离,不能代表端到端系统成功率。
9.3 REAL275 与 HouseCat6D 主结果
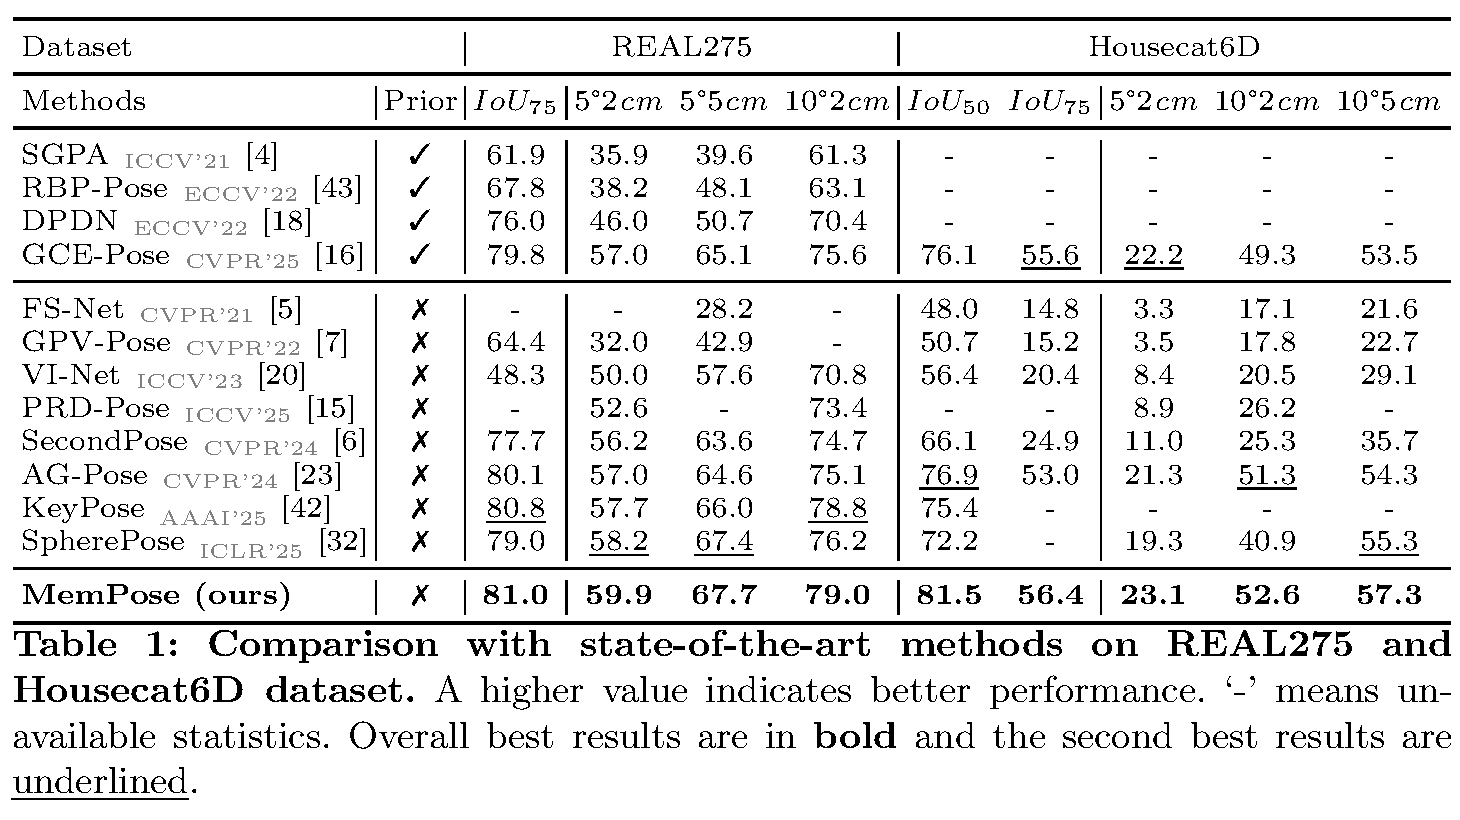
原论文 Table 1:MemPose 在 REAL275 的四项已列指标和 HouseCat6D 的五项指标上均为表中最佳;但不同 baseline 的可用指标、显式 prior 和 backbone 并非完全统一。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
REAL275
方法 Prior IoU75 5°2 cm5°5 cm10°2 cmGCE-Pose 是 79.8 57.0 65.1 75.6 AG-Pose 否 80.1 57.0 64.6 75.1 KeyPose 否 80.8 57.7 66.0 78.8 SpherePose 否 79.0 58.2 67.4 76.2 MemPose 否 81.0 59.9 67.7 79.0
相对最接近的强 prior-free 方法,提升主要在 1–3 points。严格 5°2 cm 从 SpherePose 58.2 到 59.9,表明 memory 对精度有帮助,但不是数量级变化。
HouseCat6D
方法 Prior IoU50 IoU75 5°2 cm10°2 cm10°5 cmGCE-Pose 是 76.1 55.6 22.2 49.3 53.5 AG-Pose 否 76.9 53.0 21.3 51.3 54.3 SpherePose 否 72.2 未报 19.3 40.9 55.3 MemPose 否 81.5 56.4 23.1 52.6 57.3
HouseCat6D 的 IoU50 / IoU75 相对 AG-Pose 提升 4.6 / 3.4 points,比 REAL275 更明显。这符合 memory 帮助类别形状多样性的动机,但严格 pose 5°2 cm 仍只有 23.1,说明复杂材质与遮挡远未解决。
9.4 CAMERA25
MemPose 为:IoU50 94.2、IoU75 92.5、5°2 cm 78.4、5°5 cm 84.6、10°2 cm 87.0、10°5 cm 92.6。
它在五项指标上略高于 SpherePose,但 IoU50 为 94.2,低于 SpherePose 的 94.8。作者使用“achieves the best performance”可以理解为总体领先,不能改写成“所有指标第一”。synthetic CAMERA25 上整体接近饱和,0.1–2.2 points 的差距也更易受训练配置影响。
9.5 Wild6D
方法 IoU75 5°2 cm5°5 cm10°2 cm10°5 cmAG-Pose 36.2 21.4 27.3 29.1 40.1 Diff9D 38.2 25.5 30.5 32.5 40.9 MH6D 41.9 27.0 31.2 34.4 40.5 MemPose 46.2 29.7 33.5 35.8 43.2
IoU75 相对 MH6D 提升 4.3 points,四个 pose thresholds 平均约提升 2.5 points。因为 Wild6D test 来自大量真实视频与背景,这组结果是跨场景泛化的较强证据;但训练使用 REAL275,类别与标注协议的重叠需要按 Wild6D 标准设置理解,不能称为未见类别 zero-shot。
10. 消融实验
10.1 存什么:local / global / fused
Entry 类型 IoU75 5°2 cm5°5 cmLocal 81.0 59.9 67.7 Global 80.5 58.0 66.5 Fused 80.4 58.1 66.8
local pooled features 最好,支持作者“memory 应强调结构而非最终任务状态”的设计。不过三个候选都来自同一网络,没有和显式 NOCS keypoints、canonical point descriptors 或 raw geometry prototypes 比较。
10.2 Warm-up
构建策略 IoU75 5°2 cm5°5 cmwarm-up 81.0 59.9 67.7 无 warm-up 80.8 59.0 66.0 random initialization 80.4 58.0 65.0
early features 的确不适合立即检索,但 warm-up 与无 warm-up 的 IoU 差 0.2,主要收益在严格 pose。论文未报告 warm-up 期间是否禁用全部 memory branch,或如何保持优化尺度稳定。
10.3 更新、merge、读取和 fusion
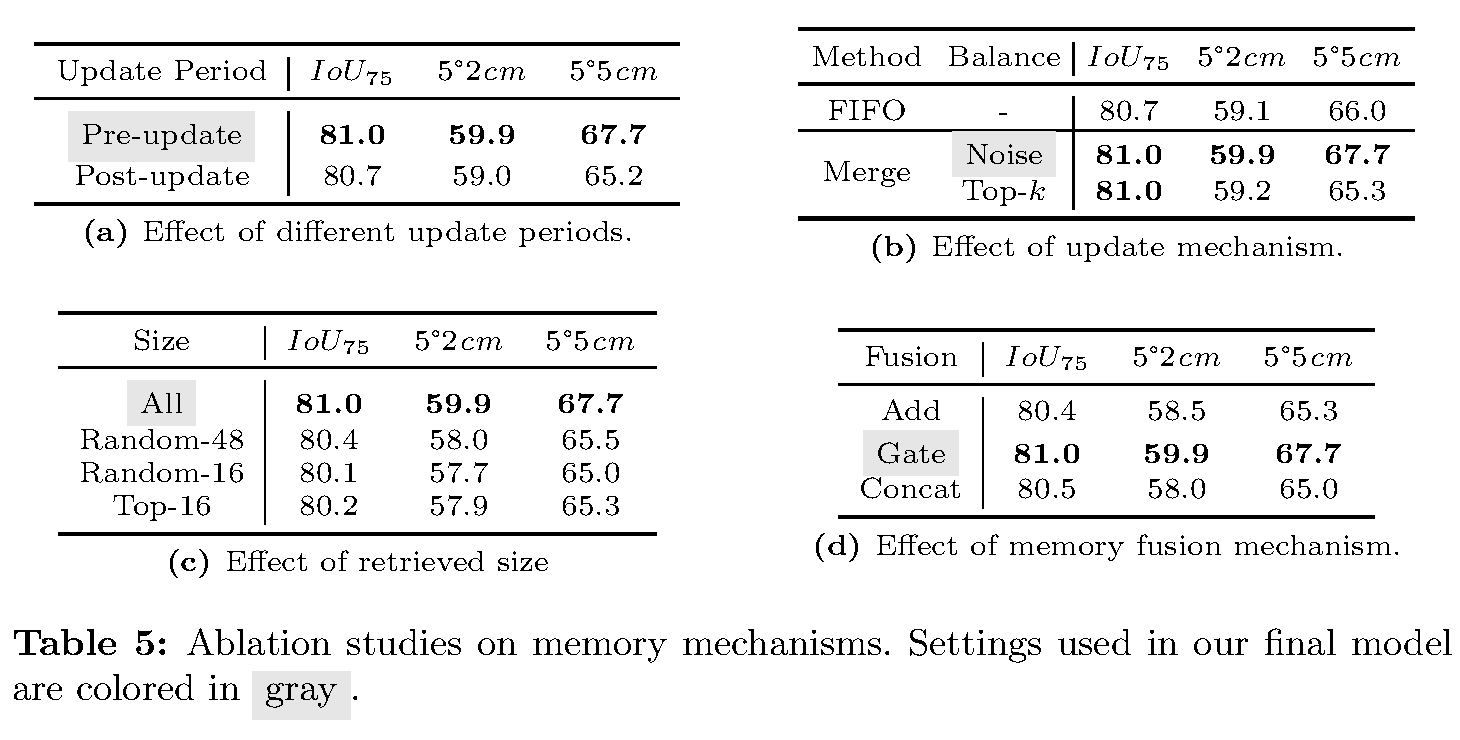
原论文 Table 5:最终使用 pre-update、Gumbel-noise balanced merge、读取全部 entries 和 gate fusion。表中最好设置方向一致,但不少差距低于 1 point。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Update timing
pre-update:81.0 / 59.9 / 67.7;
post-update:80.7 / 59.0 / 65.2。
5°5 cm 差 2.5 points,但 pre-update 可能把当前样本 token 引入自身 retrieval;需要 leave-one-out 控制才能完全归因于“更及时的历史 memory”。
Merge strategy
FIFO:80.7 / 59.1 / 66.0;
similarity merge + noise:81.0 / 59.9 / 67.7;
similarity merge + top-k k k
Gumbel noise 在严格 pose 上明显优于 top-k k k λ = 0.1 \lambda=0.1 λ = 0.1
Retrieval size
all 96:81.0 / 59.9 / 67.7;
random 48:80.4 / 58.0 / 65.5;
random 16:80.1 / 57.7 / 65.0;
attention Top-16:80.2 / 57.9 / 65.3。
全量读取最好,但 Top-16 仅略优于 Random-16,说明当前 attention ranking 的强度有限。若追求低延迟,可考虑 product quantization、prototype clustering 或先粗筛再 attention;论文没有报告这些 retrieval size 的实测 FPS。
Fusion
Add:80.4 / 58.5 / 65.3;
Gate:81.0 / 59.9 / 67.7;
Concat:80.5 / 58.0 / 65.0。
gate 在 5°5 cm 上比 concat 高 2.7 points,是较有说服力的模块对照。仍可继续可视化 gate 与遮挡率、shape novelty 和 memory similarity 的关系,验证它是否真的在不可靠 memory 时降低权重。
10.4 Buffer length
Buffer length IoU75 5°2 cm5°5 cm10°2 cm0 79.5 57.0 64.6 75.1 16 79.6 57.2 64.9 77.1 48 80.0 58.5 66.5 78.3 96 81.0 59.9 67.7 79.0 256 80.8 59.1 67.9 78.6
长度 96 提供总体最佳折中;256 并未稳定增益,说明“更多 memory 一定更好”并不成立。可能原因包括冗余 token、注意力稀释、长尾噪声或训练不足。
值得注意,length 0 被称为 AG-Pose baseline,但 IoU75 是 79.5;Table 1 / 7 的 AG-Pose 是 80.1。0.6-point 差异可能来自重新训练随机性,却没有方差或 seed 说明。考虑到一些 ablation 差距也只有 0.3–0.6 point,这个不一致很重要。
10.5 Retrieval 可视化
Figure 4 展示一个 query 对 96 个 memory entries 的 attention;高分 entries 的实例 pose / size 更相似,低分 entries 方向不同。它表明 attention 不是均匀读取,但证据仍是单案例:
没有 top-k k k
相似的是 pose、size 还是 shape 没有分离;
如果 memory 主要检索同 pose 观测,它可能是 viewpoint prototype,而非 canonical geometry memory;
没有展示失败 query、不同类别或 OOD shape。
10.6 参数与等参数控制
原论文 Tables 7–8(本站仅将两张原表纵向组合,未修改数值):同 DINOv2 时 MemPose 增加约 2M 参数、速度从 35 降至 33 FPS;等参数 MLP 低于 memory 版本。主结果冻结 memory,测试更新只作为附加设置。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
模型 Backbone 参数 IoU75 5°2 cm训练 min / epoch FPS AG-Pose DINOv2 ViT-S/14 223M 80.1 57.0 47.5 35 MemPose DINOv2 ViT-S/14 225M 81.0 59.9 47.8 33 等参数 MLP 替代 memory DINOv2 ViT-S/14 225M 80.5 57.8 47.8 33 AG-Pose ResNet18 220M 77.6 56.2 46.9 35 MemPose ResNet18 222M 80.3 57.4 47.1 33
等参数 MLP 对照说明 memory gain 不是纯粹增加 2M weights,但 MLP 自身也把 AG-Pose 的 IoU75 从 80.1 提到 80.5、5°2 cm 从 57.0 提到 57.8;真正可归于 memory organization 的额外增量约为 0.5 / 2.1 points。
原文称 33 vs. 35 FPS 是“even slightly higher throughput”,与 Table 7 明显矛盾。按数值,MemPose 比 AG-Pose 慢 2 FPS,约 5.7%。这很可能是写作笔误,详情页应保留表格事实而不是复述错误句子。
11. 鲁棒性与失败边界
11.1 遮挡
HouseCat6D 与 Wild6D 的结果说明方法能在真实遮挡域工作,但论文没有按 visible ratio 分桶。Memory 可能在 partial observation 时补充类别经验,也可能在可见局部与错误 prototype 相似时产生 negative transfer。
11.2 无纹理 / 弱纹理
RGB-D 双流使模型不完全依赖纹理,PointNet++ 和 local geometry 是优势。但它要求 depth 有效;对金属、玻璃、透明对象的 depth hole / multipath 没有专门实验。
11.3 对称对象
NOCS 类别包含轴对称或近对称对象。论文没有在方法或 loss 中详细讨论 symmetry-aware rotation supervision,也没有按对称类型报告结果。即使 benchmark evaluator 沿用标准对称处理,memory 检索仍可能把多个等价朝向聚为不同 prototype。
11.4 Mask 噪声
所有方法尽量使用相同 Mask R-CNN masks,有助于公平比较;但没有 GT-mask upper bound、mask erosion / dilation、相邻实例混入或错类别实验。实际部署中,category-specific buffer routing 对 detector 错误会非常敏感。
11.5 Depth 噪声
没有 random depth dropout、Gaussian noise、quantization、misalignment 或 sensor-to-sensor 实验。因为 point cloud 同时参与 keypoint、memory write 和 query,深度污染可能被写进类别 memory,并在测试更新模式下传播。
11.6 Domain gap
REAL275 和 Wild6D 训练使用 CAMERA25 synthetic 数据,结果支持一定 sim-to-real 泛化;但 DINOv2、真实训练部分和 memory prototypes 的贡献没有拆开。也没有“只用 synthetic memory”“只用 real memory”“跨域 memory 替换”的控制。
11.7 Category imbalance 与 long tail
每类别 buffer 长度固定为 96,避免高频类别占用更多全局容量;但类别内部常见形状仍可能反复 merge,挤压稀有实例。Gumbel noise 只平衡相似槽位更新,没有显式 rarity weight 或 diversity objective。
12. 贡献是否被实验支撑
作者声称的贡献 对应证据 充分性 我的判断 外部 category-level geometric memory 能增强 pose 四个具名数据集、AG-Pose / SpherePose 等对比 较充分 frozen-memory 主结果方向一致;提升从小幅到中等,不是全面跃迁 similarity-based update 使 memory 自适应 FIFO / merge-noise / top-k k k 中等 证明其在 REAL275 有效;缺少训练顺序、跨域更新和长期稳定性 增益来自 memory 而非参数增加 等参数 MLP、ResNet18 对照 较充分 memory 版本优于等参数 MLP,但 MLP 也有小幅增益 memory 能检索 pose-relevant category knowledge Figure 4 单 query attention 较弱 可视化直观但样本太少,且 pose similarity 不等同于 geometry similarity 几乎不增加工程成本 225M vs. 223M、47.8 vs. 47.5 min、33 vs. 35 FPS 中等 参数 / 训练开销小,速度实际略降;原文文字误读了 FPS 可在推理中持续更新 REAL275 Table 8 初步 有 +3.7-point 信号,但不构成完整 continual / online evaluation
13. 批判性分析
13.1 优点
插件式设计清楚
MemPose 没有重写 category-level pose 全部模块,而是在强 keypoint baseline 中加入 writer、buffer、readout 和 gate。对研究者而言,这比一个全新、耦合严重的架构更容易迁移和做公平 ablation。
主比较避免 test-set update
论文主动声明 main results 使用 frozen memory,不借测试集顺序获益。这一点对“memory”论文尤其重要,避免把 transductive adaptation 当作普通 inference 与静态 baseline 比较。
多层次消融较完整
除了有无 memory,还比较 entry 类型、warm-up、update timing、merge balance、retrieval count、fusion、buffer length、backbone、等参数 MLP、推理更新和效率。虽然只在 REAL275 上做,大部分核心设计至少有直接证据。
对复杂真实集有收益
HouseCat6D 与 Wild6D 不只是 CAMERA25 synthetic 数据的轻微调参。它们提供不同真实材质、遮挡和背景,整体提升增加了结论可信度。
13.2 缺点
Memory 的“几何”属性未被严格验证
entry 是 average-pooled multimodal learned feature,既含 PointNet++ geometry,也含 DINOv2 appearance。Figure 4 显示高 attention 实例具有相似 pose / size,反而提示它可能编码 observation orientation。没有 canonicalization、shape retrieval label 或 feature disentanglement,无法证明它主要保存几何而非外观 / pose。
训练期 current-entry retrieval 可能形成自增强捷径
最终使用 pre-update;当前 token 先 merge 到 memory,再用于当前 query。这个设计性能更好,却削弱“从历史实例类比”的因果解释。应补充 post-update、pre-update leave-self-out 和只读取前一 batch 的严格对照。
固定 0.5 merge 过于启发式
没有样本计数、置信度、年龄或 cluster size;最近样本占比过高。Gumbel noise 可减少槽位集中,却可能增加随机漂移。长期更新或类别分布偏移时,memory 是否稳定未知。
缺少统计方差
Table 6 baseline 自身有 0.6-point 不一致,而部分 ablation 只有 0.2–0.6-point 差距。没有 multiple seeds、standard deviation 或 significance test,较小差异不能被过度解释。
输入依赖仍重
Mask R-CNN、RGB-D、camera intrinsics 与类别 ID 都是前置条件。对透明 / 反光物体、错误 mask 和未知类别没有防护。论文改进的是已分割 category-level pose,不是完整机器人 perception stack。
在线记忆协议不完整
只在 REAL275 给一个更新结果,没有 stream order、重置、forgetting、domain switch、error accumulation 和 memory corruption。若部署时打开更新,结果可能不可重复,也可能让测试集不同样本互相影响。
开源与复现材料不足
截至核验时没有 code / project page。register_buffer 的 batch 写入顺序、distributed training behavior、Gumbel sampling、类别 routing、memory checkpoint 和 evaluator 细节都可能影响复现。
13.3 隐含假设
detector 已知正确 category 并提供足够干净的单实例 mask;
depth 与 RGB 对齐,相机内参可靠;
训练类别与测试类别一致;
每类别 96 个 prototype 足以覆盖实例变化;
pooled local features 的相似度能代表有帮助的结构相似度;
checkpoint 中的 memory 与 encoder 参数保持一致;
frozen DINOv2 feature 对目标域有效;
标准 NOCS symmetry 与尺寸约定适用于全部数据集。
13.4 真实应用可行性
33 FPS 表明单个 crop 的网络推理有实时潜力,但完整系统还要计算 segmentation、depth back-projection 和多实例循环;论文未说明 FPS 是否包含这些阶段、硬件设置和 batch size。225M parameters 主要来自 DINOv2,嵌入式部署仍需模型压缩。
对于家庭机器人,frozen memory 可作为稳健 prior;对于持续观察新物体的机器人,更新模式更有吸引力,但必须增加 OOD gating、错误回滚和 per-environment memory isolation,不能直接把所有测试观测写入长期 buffer。
14. 复现检查清单
14.1 数据与预处理
使用官方 REAL275 / CAMERA25、HouseCat6D、Wild6D split;
复现与 AG-Pose / DPDN 相同的 Mask R-CNN masks;
核对 RGB crop、depth crop 与相机内参变换;
下采样 1,024 points,并记录单位与去外点规则;
核对类别 ID 到 memory index 的映射;
核对 NOCS、旋转、平移和尺寸坐标 convention;
使用 benchmark 官方 symmetry-aware evaluator,而不是自写近似版本。
14.2 模型
DINOv2 ViT-S/14 是否完全冻结;
图像 token 到 3D point 的 interpolation 方式;
96 个 category embeddings 是每类独立还是共享;
keypoint softmax 的 axis 与温度;
geometric aggregation 与 AG-Pose 的具体实现;
memory MLP、normalization 和 stop-gradient 位置;
attention heads、projection dimensions 与 gate broadcast;
pose / size predictor 的表示与 rotation normalization。
14.3 Memory 状态机
buffer 初始为空,按类别独立记录 occupancy;
未满时是否完全跳过 retrieval;
batch 内多个同类 token 的写入顺序;
装满的判断在 batch 前还是逐 token;
Gumbel noise 的 random seed 与 λ = 0.1 \lambda=0.1 λ = 0.1
merge 后是否重新 normalize;
pre-update 是否允许当前 token 被当前 query 读取;
checkpoint 是否同时保存 occupancy 和 entries;
distributed training 时 buffer 是否跨 GPU 同步;
frozen inference 是否明确关闭全部 write path。
14.4 训练
120K iterations、batch 36、单 L40;
Adam 与 triangular2 cyclic LR;
loss weights 0.3 / 10 / 2 / 15 / 2;
rotation / translation / scale augmentation 的精确实现;
至少 3 个 seeds,报告均值与标准差;
同时复现 AG-Pose、等参数 MLP 与 buffer length 0。
14.5 推理与计时
区分 pose network FPS 与 detector + crop + back-projection + pose 的端到端 FPS;
固定 batch size 与硬件;
frozen memory 每个样本独立;
updating memory 必须预注册 stream order、reset policy、类别已知条件与多顺序方差。
15. 可改进方向
15.1 Canonical geometric memory
当前 entry 可能强烈编码观察 pose。可以先把 keypoint / local feature 通过预测 NOCS 对齐到 canonical frame,再写入 memory;这样检索更有机会按 shape parts,而不是按相机视角匹配。
15.2 带计数与置信度的 prototype update
为每个 slot 保存 count、variance、last-updated time 和 reliability:
m ← n n + 1 m + 1 n + 1 x , m\leftarrow\frac{n}{n+1}m+\frac{1}{n+1}x, m ← n + 1 n m + n + 1 1 x , 或使用置信度加权 EMA。低 mask quality、depth 缺失或 pose uncertainty 高的 observation 不应等权写入。
15.3 Diversity-aware coreset
similarity merge 主要去冗余,却不保证覆盖边界 shape。可用 k-center、determinantal point process、online clustering 或 class-conditional reservoir sampling 保留长尾实例。
15.4 Unknown / OOD gating
在检索前估计 query 到 memory manifold 的距离。若类别标签错、对象超出训练分布或 top attention 仍很低,应降低 w a w_a w a
15.5 Cross-category compositional memory
严格按类别分 buffer 避免干扰,但也阻断“瓶口、把手、圆柱体”等跨类别共享结构。可构建 part-level memory,并以 semantic part / geometry routing 组合,不再把类别 ID 当硬边界。
15.6 Continual protocol
如果要主张推理期动态记忆,应建立:
chronological stream;
domain switch;
repeated / new instances;
category imbalance;
memory reset 与长期不重置两种设置;
online accuracy、forward transfer、forgetting、order variance;
写入错误后的恢复能力。
15.7 Memory interpretability
对每个 slot 找 nearest training instances,统计 shape、pose、size、visibility 和类别属性;用 linear probes 判断 entry 编码了什么。只有这样才能区分“geometric memory”“viewpoint memory”和“appearance memory”。
15.8 Mask / depth robustness
训练时模拟 mask erosion、dilation、相邻实例污染、depth dropout 和 RGB-depth misalignment,并把 corruption score 输入 gate。还应比较 frozen clean memory 与 contaminated updating memory 的差异。
15.9 轻量部署
225M parameters 中 DINOv2 占主要部分。可尝试 distillation、smaller ViT、RGB feature caching、quantized memory 和 Top-k k k
16. 对研究工作的启发
16.1 可直接借鉴的设计
将训练样本的中间表示压成固定容量类别 bank;
update 与 optimizer 解耦,以 checkpoint buffer 保存;
memory readout 使用 query attention,fusion 使用可学习 gate;
主比较冻结 memory,把测试更新单列为另一协议;
使用等参数 MLP 对照,避免“只是参数变多”的质疑。
16.2 必须加入的 baseline
如果研究 category-level memory pose,至少比较:
原始 AG-Pose;
等参数 MLP;
FIFO queue;
random reservoir;
prototype clustering / k-means;
frozen vs. updating;
GT mask vs. predicted mask;
current-entry excluded vs. pre-update self-readable。
16.3 可形成新工作的切入点
一个有潜力的方向是 uncertainty-aware canonical memory for category-level pose :将 observation 先映射到 NOCS,memory 保存带 covariance 的 part prototypes;query 根据可见部件和 depth reliability 检索,输出 pose distribution 而非单点 R , t , s R,t,s R , t , s
16.4 使用论文结果时的推荐表述
推荐写:
MemPose 在 AG-Pose 风格 RGB-D 类别级 pose 网络中引入按类别的外部 feature memory;训练期以 similarity merge 动态更新,标准测试时冻结。其 REAL275 5°2 cm 为 59.9,较 SpherePose 高 1.7 points;HouseCat6D IoU50 为 81.5,较 AG-Pose 高 4.6 points。
不推荐写:
“MemPose 在测试时持续学习并记住所有新物体”——主结果不更新测试 memory;
“Memory 不增加计算开销且速度更快”——表中 33 FPS 低于 AG-Pose 35 FPS;
“所有 benchmark、所有指标全面 SOTA”——CAMERA25 IoU50 低于 SpherePose,且 baseline 报告项不齐;
“不需要任何先验”——仍需类别、mask、RGB-D、相机内参和训练 memory。
17. 待解决问题
概念问题
Memory entry 更接近 shape、pose、size、appearance 还是它们的混合?
测试时更新是否属于 continual learning、test-time adaptation 还是 transductive inference?
按类别固定 buffer 如何处理 unknown category 与错类别?
方法问题
pre-update 是否让当前样本读到自身 token?
0.5 merge 为什么优于 count-aware mean / EMA?
Gumbel noise 是否每个 entry 独立采样,merge 后是否 normalize?
96 keypoints 与 96 memory entries 同数是经验选择还是有结构含义?
gate 是 per-keypoint scalar 还是实现中为 per-channel?
实验问题
Table 6 length 0 的 IoU75 79.5 与 Table 1 / 7 AG-Pose 80.1 为何不同?
多 seed 方差是否大于若干 0.2–0.6-point ablation 差距?
HouseCat6D 各类别、遮挡率和 depth quality 下收益如何?
updating memory 的 stream order、reset 和污染结果如何?
Figure 4 的 attention 是否在全测试集都和 shape similarity 相关?
复现问题
当前无公开代码 / project page;
Mask R-CNN checkpoint 与生成 mask 未给直接链接;
symmetry evaluation、rotation convention 与数据 preprocessing 需对齐 benchmark;
原文 augmentation 的 scale 区间需核验实现;
33 FPS 是否包含 DINOv2、PointNet++ 和 memory,是否排除 detector 未明确。
18. 最终评价
贡献强度
MemPose 是一个清晰、有效但增量式 的 category-level pose 工作。它没有发明新的几何坐标系,却把外部 memory 作为类别知识载体引入成熟 RGB-D keypoint pipeline,并通过相对完整的 ablation 表明这不是简单堆参数。
证据可信度
frozen-memory 主结果:较强,跨四个具名数据集,方向一致;
memory 组件有效性:较强,包含 entry、update、retrieval、fusion、length 和等参数对照;
“几何 memory”解释:中等偏弱,主要依据单个 retrieval 可视化;
online / continual memory:初步,仅一个数据集附加实验,协议不足;
工程效率:中等,参数和训练时间透明,但 FPS 文字出现明显错误且未说明端到端范围;
可复现性:当前偏弱,尚无公开代码。
最简结论
MemPose 证明了:将训练实例的局部 RGB-D keypoint features 压入按类别固定容量的外部 bank,再以 attention 检索与 gate 融合,可以稳定增强 category-level 9DoF pose;但标准模型在测试时读取的是冻结 memory,真正持续更新仍只是尚未充分规范的附加方向。