论文精读笔记:MFOS: Model-Free & One-Shot Object Pose Estimation
1. 基本信息
- 标题:MFOS: Model-Free & One-Shot Object Pose Estimation
- 作者 / 机构:JongMin Lee, Yohann Cabon, Romain Brégier, Sungjoo Yoo, Jerome Revaud;Seoul National University、Naver Labs Europe
- 年份 / 会议或期刊:2024 / AAAI
- 论文链接:arXiv:2310.01897
- 代码 / 项目页:论文与作者公开页面未提供官方实现链接
- 阅读模式:精读
2. 一句话定位
MFOS 以“已知参考图的 pose + 一个粗 cuboid”代替 CAD / SfM object model:CroCo 初始化的 ViT 把多张 posed references 编码成带几何语义的 tokens,decoder 为 query 回归到不可见 proxy cuboid的稠密 2D-3D 坐标和置信度,最后由 RANSAC PnP 解出 query pose;它牺牲表面级精度来换取 CAD-free、RGB-only 和较少参考图下的泛化。
方法输入与输出
| 项目 | 内容(本站整理) |
|---|
| 推理输入 | query RGB crop、K 张 posed reference RGB、相机内参和粗 3D box。reference pose 与 box 经 proxy renderer 转成图像对齐的 cuboid pointmaps,再送入 Pose Encoder。 |
| 最终输出 | RANSAC PnP 得到 query 的 cuboid pose,按 cuboid 与对象的固定坐标关系得到物体到相机的 (R,t)。 |
| 训练输入 | 多对象的 reference / query 图像及位姿、粗 box;训练 query 的 GT pose 用于渲染监督用 proxy coordinate map,而不是交给 query decoder 作为条件。 |
| 训练目标 | 每个 query 像素预测三维 proxy coordinate 与正 confidence;由 GT proxy map 构造置信度加权回归损失,无需真实物体表面的稠密对应标签。 |
| 输出细节 | 网络输出四通道图:3D proxy coordinate + confidence;前三通道属于归一化 cuboid 空间,不是 CAD 表面 / 深度图。PnP 输出的平移需随 proxy 尺寸还原,与参考位姿保持同一长度单位。 |
| 必要条件 | 需外部目标检测 / 裁剪、reference poses、内参和粗尺寸;不需 query mask、目标 depth 或 SfM 表面重建。真实物体与 proxy 的坐标变换不能省略。 |
2.1 论文图表导读
| 图表 | 在论文中的作用 | 本页阅读建议 |
|---|
| Figure 1 | 端到端信息流 | 明确 coordinate map 的 3D 不是物体 mesh 表面,而是 proxy cuboid |
| Figure 2 | reference image 与 cuboid pointmap | 解释 pose 如何被 image-aligned 地输入 Transformer |
| Figure 3 | Pose Encoder | 看视觉 token 与 pose token 的 cross-attention 注入 |
| Figure 4 | decoder cross-attention | 说明网络虽无 correspondence supervision,仍会学到跨图匹配 |
| Table 1 | LINEMOD 主表 | 先看总体,随后用 Table 6 检查相同 K 的公平比较 |
| Tables 2—5 | proxy、数据、reference 数量、pretraining | 论文最有解释力的设计消融 |
| Tables 6—8 | 受限 views、OnePose setting、速度 | 分开理解 strict precision、SfM 依赖和只计 network 的时延 |
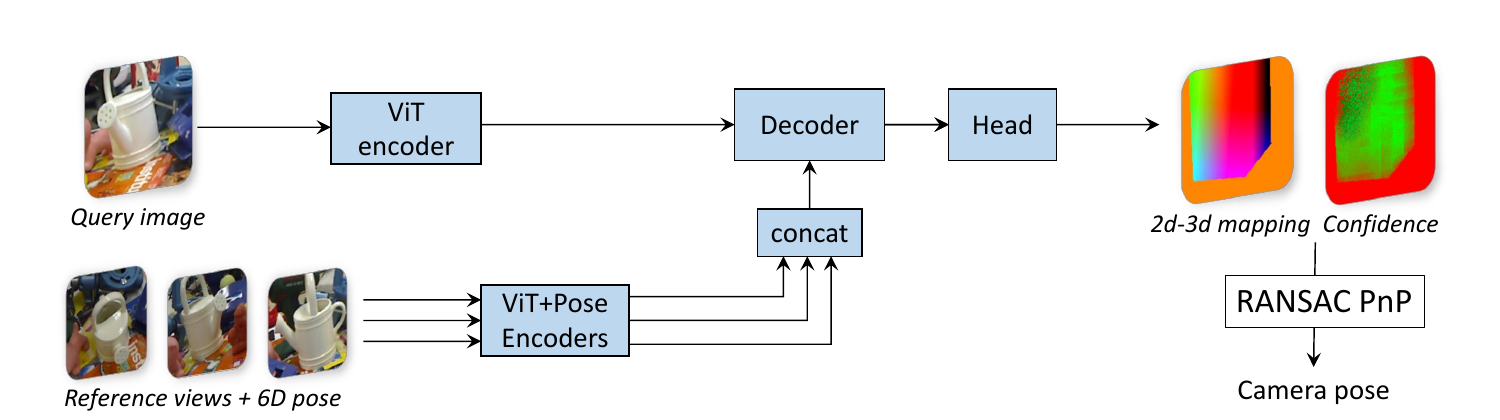 原论文 Figure 1:query feature 与多个带 pose 的 reference features 在 decoder 中交互,输出 query 像素到 proxy shape 的 3D coordinate map 和 confidence,再经 RANSAC PnP 得到 camera pose。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题定义与任务边界
给定一个刚性目标实例 O,目标是估计 query image 中物体相对相机的 pose:
xcam=Rxobj+t.
MFOS 并不需要 xobj 落在真实 mesh 表面。它为对象定义以 bounding box 为尺度的 proxy coordinate system,并令 xproxy 落在一个 cuboid 上;PnP 得到的是该 cuboid 的 pose,因 cuboid 与物体中心 / 尺寸绑定,便可转换为物体 pose。
- 推理输入:query RGB crop Iq;同一对象的 K 张 reference images {Ii};每张 reference 的 pose Pi=(Ri,ti);camera intrinsics;对象的粗位置 / 尺寸或 3D bounding box。
- 推理输出:query 对应的 R,t,以及内部的 dense 2D-to-proxy-3D map 和 confidence map。
- 前端前提:query 中对象身份与近似 bbox 已知,通常由 object detector 或 retrieval system 提供;论文在 LINEMOD 采用 YOLOv5 detections。
- 训练阶段:训练一个跨对象共享模型;测试对象不用于对象专用 training / fine-tuning,因而是 unseen instance-level setting。
- CAD / depth / mask / multi-view:不需 CAD、depth、query mask 或真实 3D reconstruction;需要 RGB multi-view references 且其 poses 已知,需要 camera intrinsics,且 query 与 references 均以 object bbox 为中心裁剪。
- 关键边界:
- 不是 category-level pose:没有类别 NOCS 或 shared category shape prior。
- 不是无准备 one-shot:每个新对象仍需为 reference collection 做 pose annotation;作者提到可用 fiducials 或 SfM 获得。
- 不是 end-to-end detection and pose:detector / retrieval 与 reference pose acquisition 在其 pipeline 之外。
4. 研究脉络
- model-specific CAD pose:为每个物体使用 CAD、rendering 或对象专用训练,精度高但上新物体成本高。
- category-level pose:在固定类别里学习 NOCS / shape prior,能泛化到该类别的新实例,但不能处理未知类别。
- model-agnostic RGB-D / video 路线:BundleTrack、FS6D、OVE6D 等使用 RGB-D、视频或 mesh / point cloud,有更强几何信息但输入门槛更高。
- one-shot RGB reference 路线:Gen6D 使用 posed references 的 detection、view selection 和 volume refinement;OnePose / OnePose++ 不用显式 CAD,但先从 reference video / SfM 建 3D representation 并做 2D-3D matching。
- MFOS 的区别:它不以真实物体表面为坐标目标,也不重建点云,而让 Transformer 在多 reference poses 与一个统一 cuboid 之间隐式传递几何。这使每个新物体的表示简化为 posed RGB references + rough size。
5. 研究动机
- 同一个 Transformer 无法直接从未见物体 RGB 中回归“真实表面坐标”,因为表面拓扑、纹理和形状随对象改变。
- 若用 reference image pose 建立一个与视觉 feature 对齐的 pointmap,pose information 可以像另一张图一样输入 ViT,而不需手工设计 rotation / translation embedding。
- 选择 cuboid 而不是 object mesh,将回归目标变为对象无关、拓扑简单的连续几何体;目标网络是“从 reference pose 推 query pose”,不是“重建对象”。
- CroCo 预训练本身通过跨视角 completion 学几何匹配,刚好适合 query-to-reference cross-attention;作者以消融验证这比普通 MAE 更关键。
6. 方法详解
6.1 总体 Pipeline
- 为当前物体准备 reference RGB views 及其 Pi=(Ri,ti);以粗 object center 和 dimensions 构造 cuboid proxy。
- 在每一个 reference camera 下渲染 cuboid 的 3D reference coordinate map,像素坐标落在约 [−1,1]3 的 proxy coordinate system;cuboid 外部为 null。
- Query / reference RGB 经过共享 ViT image encoder。每张 reference 的 image feature 与其 proxy pointmap feature 经 Pose Encoder 融合。
- Query tokens 对所有 pose-augmented reference tokens 做 cross-attention,从中选择有用 reference 信息,得到 query token feature。
- 线性 head 输出四通道图:前三通道为 y^i∈R3 proxy coordinate,第四通道为正 confidence τi。
- 保留高 confidence pixels,从中按置信度抽取 1024 个 2D-3D correspondences;SQ-PnP + RANSAC(最多 1000 iterations,5 px reprojection threshold)求 R,t。
| 模块 | 输入 | 输出 | 作用 | 与下一模块如何衔接 |
|---|
| Proxy renderer | rough 3D box、reference pose、K | reference-aligned 3D pointmaps | 以统一、无 CAD 的 geometry 表示 pose | 作为 Pose Encoder 的第二个视觉输入 |
| Image Encoder | query / reference RGB crops | ViT patch tokens | 提取可跨对象复用的视觉特征 | reference token 与 pose token 融合 |
| Pose Encoder | reference image tokens、proxy tokens | pose-augmented reference tokens | 将 R,t 变为 image-aligned 条件信息 | 供 query decoder 检索 |
| Query Decoder | query tokens、全部 reference tokens | query tokens | 通过 cross-attention 隐式建立多视角匹配 | 送入 coordinate / confidence head |
| Prediction + PnP | token feature、intrinsics | R,t | 以鲁棒几何 solver 将 dense map 变为 pose | 最终输出 |
6.2 Cuboid proxy:不预测物体表面
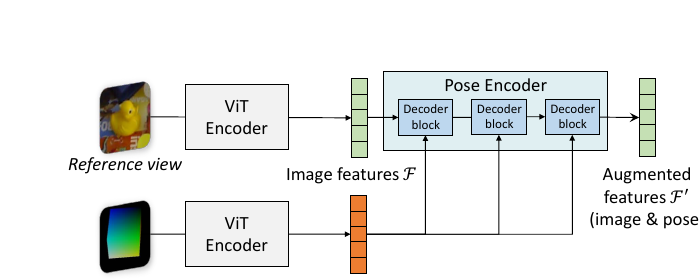 原论文 Figure 3:reference image 和对应的 rendered proxy shape 分别经 ViT 变为 tokens;Pose Encoder 用 decoder blocks 将 pose features 注入 visual features。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
对 reference view,MFOS 不直接输入一个 6D vector,而是将 cuboid / ellipsoid 渲染成每像素含 3D proxy coordinate 的三通道 pointmap,再以 single-layer ViT 提取 pose tokens。这种编码具有三个性质:
- 空间对齐:pose map 和 reference RGB 都是 image-aligned patch grid,可用 cross-attention 对应局部视觉与局部几何。
- 对象无关:不同 object 的 mesh 千差万别,而 cuboid 的拓扑固定;仅 center / scale 随对象变。
- 容错粗尺度:补充实验将 proxy 随机旋转、平移或缩放 10%,LINEMOD / OnePose 主指标仅小幅波动,说明它更需要一个稳定 reference frame 而非精确 box 标注。
作者声称:cuboid 作为 input / output 比 ellipsoid 或以 cuboid 输入、CAD surface 输出更好。
我的分析:Table 2 的 cuboid-to-cuboid(LINEMOD 60.9、OnePose 88.3、ABO 74.4)优于 ellipsoid-to-ellipsoid(58.0 / 79.9 / 70.8),也远高于 cuboid-to-CAD(42.3 / 40.4 / 63.7)。这支持“统一 proxy coordinate 是更容易泛化的学习目标”;但 CAD output 的训练集合因 OnePose 无 mesh 而有所不同,不能把全部差距都归因于 proxy 形状。
6.3 Image Encoder、Pose Encoder 与 Query Decoder
- Image encoder:ViT-Base/16,16 x 16 patches、768-d features、12 heads / 12 blocks,使用 RoPE relative positional encoding。
- Pose encoder:用单层 ViT 编码 rendered proxy pointmap,随后用 4 个 Transformer decoder blocks 使 reference image features cross-attend pose features,输出 Fi′。
- Query decoder:query features Fq 对拼接的 {Fi′}i=1K cross-attend。不是每个 reference 都被同等使用,attention 自行选择对当前 query view 更有帮助的 tokens。
- 隐式匹配:Figure 4 可视化表明 query / reference attention 集中在对应 patch 上,尽管训练目标没有显式的 patch correspondence loss。这解释了 CroCo 的跨视角预训练为何有帮助。
6.4 训练监督与数据
对有 ground-truth 的 query pixel i,回归其 proxy coordinate:
Lregr(i)=∥y^i−yigt∥2.
网络同时预测 confidence τi>0,采用不确定性加权损失:
Lfinal(i)=τiLregr(i)−logτi.
对于 proxy 外的 pixel,作者将 regression error 设为常数 E;−logτi 防止网络以全局低置信度逃避监督。它不是直接优化 ADD 或 PnP inlier,而是让 PnP 读取 confidence 后做鲁棒求解。
- 训练数据:ABO 有 580K images、8209 sequences、576 object categories;BOP 部分使用 T-LESS、HB、HOPE、YCB-V、RU-APC、TUD-L、TYO-L、ICMI,共约 150K PBR + 53K real images、153 objects;还加入 OnePose 的 450+ sequences、150 objects。
- 避免对象泄漏:训练排除对称对象,并排除与 LINEMOD 测试重叠的 3 个 HB objects。
- reference sampling:训练使用 32 references,其中 8 张随机选取,24 张用 farthest sampling 覆盖盲区;proxy pose 还随机平移、旋转、缩放,图片做 224 x 224 crop、shift、scale、rotation augmentation。
- 优化:CroCo v2 初始化,AdamW,40K steps,cosine decay 从 10−4 至 10−6;batch 为 16 个 objects,每 object 16 queries + 32 references。论文报告从头训练 40K steps 需 4 张 A100 约 32 小时。
6.5 推理与工程复杂度
- reference features 可离线预编码;每个 query 根据 reference pool 用 farthest sampling 选 K 个 views,渲染相应 cuboid pointmaps。
- query forward 对 K=16/64 的时间为 20.66 / 62.24 ms(V100):image encoder 3.40 ms,decoder 17.21 / 58.79 ms,head 0.05 ms。
- 这些时间不包括目标 detector、reference pose annotation、reference image capture、proxy size estimation 和 PnP host-side integration,应避免读成完整机器人工程的端到端时延。
- 训练的显存优化靠 in-place reshape:reference token 只按 object 保存一次,避免为每个 query 重复展开;复现时多 reference cross-attention 的 tensor layout 是关键细节。
7. 实验分析
7.1 数据集与指标
| 数据集 | 用途 | 评估重点 |
|---|
| LINEMOD | 13 个刚体模型、约 13K real images | CAD 可用于评测 ADD / ADD-S、Proj2D;论文用 YOLOv5 crop 和约 180 train images 作 references |
| OnePose | 真实 capture sequences、无 CAD model | 检查 CAD-free posed-reference 泛化,使用 cm-degree |
| OnePose-LowTexture | 40 个 household low-texture objects | 检查弱纹理条件 |
| ABO | 大规模商品对象图像 / render 数据 | 测试跨数据源泛化和训练数据多样性 |
- ADD(-S)-0.1d:预测与 GT 变换后的模型点平均距离小于 object diameter 的 10%;对称物体用 ADD-S。
- Proj2D:平均 2D projection error 小于 5 px 的成功率。
- cm-degree:rotation error 与 translation error 同时低于阈值才成功,如 1cm-1deg、3cm-3deg、5cm-5deg。
这些指标共同诊断不同精度需求,但也暴露 MFOS 的 trade-off:proxy correspondence 更适合宽阈值的稳定 pose,而非表面级、像素级高精度对齐。
7.2 LINEMOD 主结果
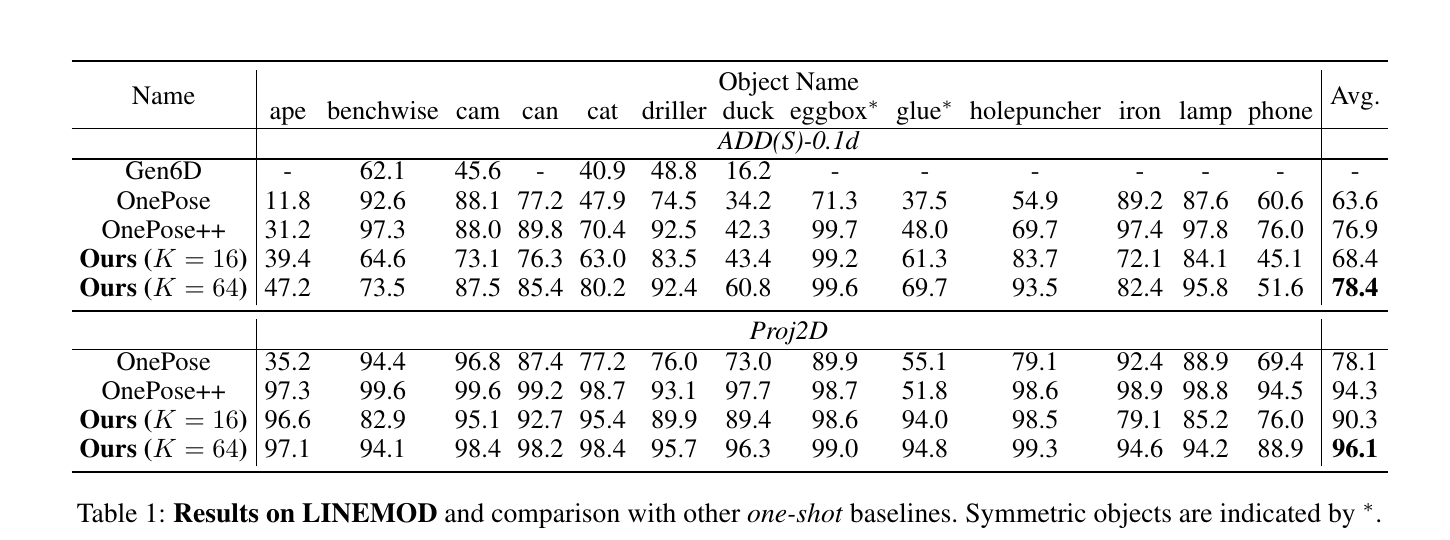 原论文 Table 1:LINEMOD 与 one-shot baselines 的比较。MFOS $K=64$ 平均 ADD(S)-0.1d / Proj2D 为 78.4 / 96.1;OnePose++ 为 76.9 / 94.3。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 方法 | 对象先验 | LINEMOD ADD(S)-0.1d | Proj2D | 读表注意 |
|---|
| Gen6D | posed RGB references | 部分类别报告 | 部分类别报告 | 无 CAD、无 depth,但 pipeline 含 detector / view selector / refiner |
| OnePose | SfM object representation | 63.6 | 78.1 | 需 reference video 的重建 |
| OnePose++ | SfM point cloud / matching | 76.9 | 94.3 | 高精度匹配强,reference 数量与预处理不能忽略 |
| MFOS, K=16 | posed RGB + cuboid | 68.4 | 90.3 | reference 更少时已较强 |
| MFOS, K=64 | posed RGB + cuboid | 78.4 | 96.1 | 论文主行,但不应与未知 K 的 baseline 只看单数字 |
我的分析:论文的主表支持 MFOS 在该 LINEMOD protocol 下很强。但主表的 strongest baseline 与 MFOS 不保证使用同样数量 reference;Table 6 的 matched-K 对比才更接近公平评估。
7.3 核心消融:proxy、数据、views 与 CroCo
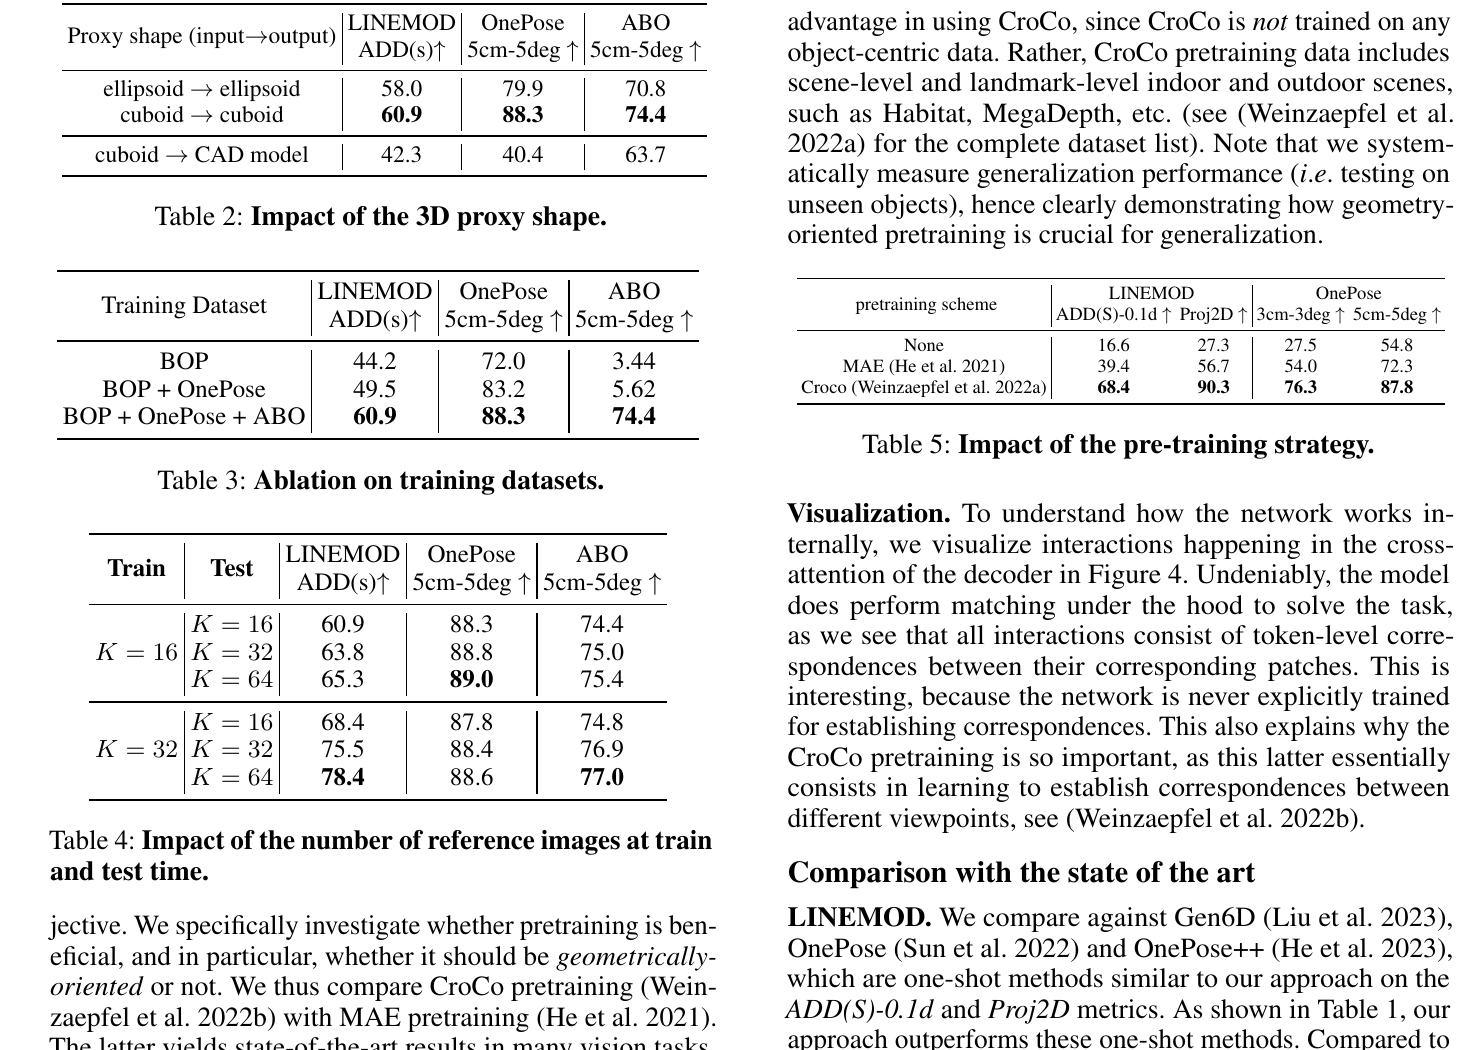 原论文 Tables 2--5:分别比较 proxy shape、训练数据、训练 / 测试 reference 数量与 pretraining scheme。cropped 图中左列为 Tables 2--4,右列为 Table 5。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 消融项 | 关键数值 | 证明的主张 | 我的判断 |
|---|
| ellipsoid / cuboid / CAD output | LINEMOD 58.0 / 60.9 / 42.3;OnePose 79.9 / 88.3 / 40.4 | cuboid proxy 比真实表面坐标更容易泛化 | 证据有力,但 CAD output 的训练集不完全相同 |
| BOP / +OnePose / +ABO | LINEMOD 44.2 / 49.5 / 60.9;ABO 3.44 / 5.62 / 74.4 | 多源对象数据关键 | 很清楚地反驳“只在 BOP 训练就足够”的假设 |
| no pretrain / MAE / CroCo | LINEMOD ADD 16.6 / 39.4 / 68.4;Proj2D 27.3 / 56.7 / 90.3 | geometry-oriented CroCo 最关键 | 强证据,但也说明最终能力高度依赖外部预训练 |
| Ktrain=16,Ktest=16/32/64 | LINEMOD 60.9 / 63.8 / 65.3 | test-time 可接受更多 references | 有用但增益有限;更大 Ktrain 的模型在 LINEMOD 更强 |
| Ktrain=32,Ktest=16/32/64 | LINEMOD 68.4 / 75.5 / 78.4 | 多 reference context 在训练与测试都重要 | 不能把“one-shot”误读为单 reference image |
7.4 相同 reference 数量下的比较
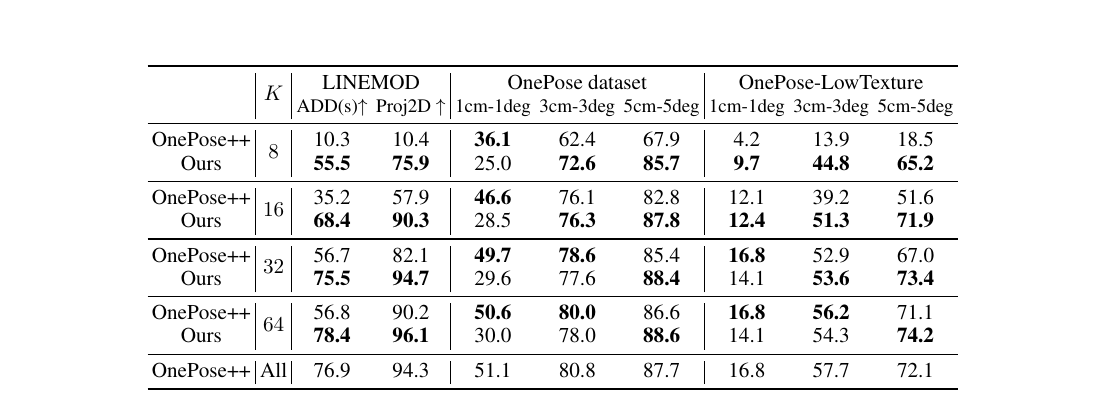 原论文 Table 6:MFOS 与 OnePose++ 在相同 $K$ 下比较。MFOS 在 LINEMOD 和宽松的 3cm / 5cm 阈值经常占优,但 OnePose 的 1cm-1deg 上仍明显落后。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
- 在 K=16,MFOS 的 LINEMOD ADD / Proj2D 为 68.4 / 90.3,优于 OnePose++ 的 35.2 / 57.9。
- OnePose dataset 上,K=16 的 3cm-3deg / 5cm-5deg 为 76.3 / 87.8,略高于 OnePose++ 的 76.1 / 82.8;但 1cm-1deg 是 28.5,显著低于 46.6。
- OnePose-LowTexture 上,K=16 的 5cm-5deg 为 71.9,对比 OnePose++ 的 51.6;但这不说明 MFOS 的每个精度档都更好。
这组表最重要的结论不是“MFOS 全面超越”,而是:proxy target 的精细定位上限较低,却能在 view 受限、纹理弱、较宽姿态容忍度下保持稳定。
7.5 OnePose setting、速度与可用性
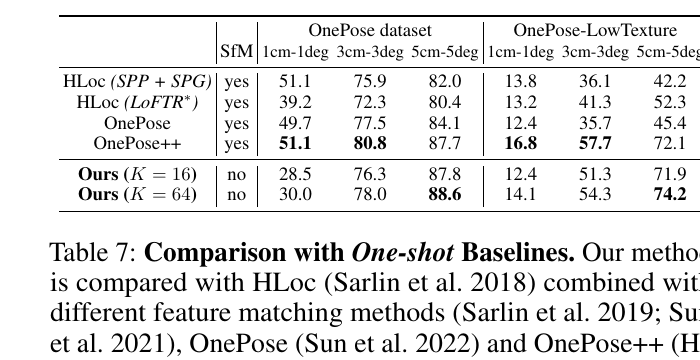 原论文 Table 7:在 OnePose / OnePose-LowTexture 上与 HLoc、OnePose、OnePose++ 对比。表中 `SfM=no` 的 MFOS 不构建显式对象 3D reconstruction;其 $K=64$ 在 5cm-5deg 上为 88.6 / 74.2。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
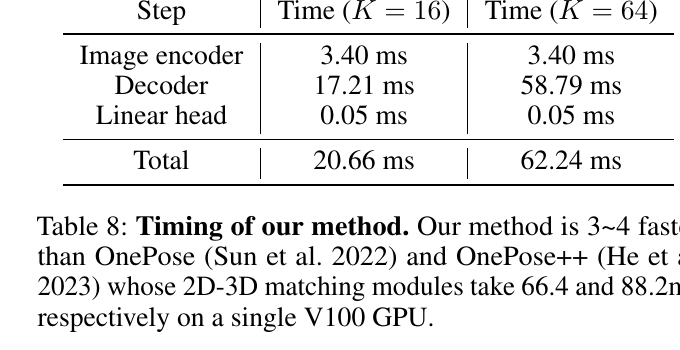 原论文 Table 8:单张 V100 上、reference features 已离线编码时的 network timing。$K=16/64$ 总时间为 20.66 / 62.24 ms;decoder 是随 $K$ 增长的主要部分。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
- Table 7:MFOS K=64 不做 SfM,OnePose 的 5cm-5deg 为 88.6,略高于 OnePose++ 的 87.7;OnePose-LowTexture 为 74.2,高于 72.1。相应的 1cm-1deg 仍较低(30.0 vs 51.1;14.1 vs 16.8)。
- Table 8:作者称 MFOS 比 OnePose / OnePose++ 的 2D-3D matching modules 快约 3—4 倍。但参考库离线编码、detector 与 reference pose acquisition 不在该统计内,应把它看作 pose network latency。
7.6 鲁棒性与失败案例
- 遮挡 / clutter:confidence map 和 RANSAC 能剔除一部分背景 / 错误 correspondence;论文的 cross-attention 可视化显示有稳定 patch match,但没有针对 severe occlusion 的专门 recovery module。
- 低纹理:在 OnePose-LowTexture 的宽阈值表现不错,说明 reference-conditioned CroCo features 可提供一些帮助;但不能证明对完全无纹理或重复纹理稳定。
- 对称性:训练排除了 symmetric objects,补充材料明确对称物体是失败类型之一;虽然 LINEMOD metric 对 eggbox / glue 使用 ADD-S,算法本身没有 symmetry-aware multi-hypothesis。
- 复杂形状:补充材料将 non-symmetric complex shape 也列为失败例。cuboid coordinate 不能表达表面细节,形状复杂时 pose evidence 可能歧义。
- 检测 / pose annotation 噪声:query crop 偏移会影响 image tokens;reference pose 和 proxy scale 的轻微误差有 10% 扰动消融支持其鲁棒性,但 reference pose 的系统偏差或错内参未被系统评估。
7.7 贡献是否被实验支撑
| 作者声称的贡献 | 对应实验 | 是否充分 | 我的判断 |
|---|
| 不用 CAD / mesh / SfM 的 one-shot pose | Table 7、方法输入 | 基本充分 | 输出 proxy cuboid 而非 object surface,确实避免显式对象 3D reconstruction |
| one-shot transformer 在 LINEMOD 达到强结果 | Table 1、Table 6 | 较充分 | 主表好看,matched-K 表更可信;严格阈值不是全面领先 |
| CroCo 几何预训练显著提升泛化 | Table 5 | 充分 | None / MAE / CroCo 的差距很大,论据直接 |
| 少 reference 时更稳 | Table 6 | 部分充分 | 在 LINEMOD 和宽阈值有明显优势;OnePose strict threshold 反例需要同样报告 |
8. 批判性分析
优点
- 将 pose condition 转为 image-aligned proxy pointmap,是简洁且可泛化的 representation design;它避免了直接向 Transformer 塞欧拉角或位移向量。
- dense coordinate + confidence + PnP 的结构既可学习又保持了几何可解释性,适合诊断失败而不是纯 pose regression。
- 对 proxy、数据多样性、CroCo 和 reference count 都做了消融,论证比只展示主表完整。
- 在没有 CAD / depth / explicit SfM model 的条件下仍能跑出强的宽阈值 pose,部署边界清晰。
缺点
- “model-free”易被误读。MFOS 仍需要每个新物体的 posed reference images、粗 bbox 尺寸、内参和 query detector;reference poses 往往本身依赖 ARKit、fiducial 或 SfM。
- 其 main result 在不同 reference count 下比较的可比性有限;真正 matched-K 后,OnePose++ 在 1cm-1deg 上明显更强。
- CAD-free 的代价是精细表面约束缺失。cuboid target 将 pose 的细粒度辨识交给视觉匹配,面对对称、形状复杂或极少纹理对象容易模糊。
- 公开论文 / 作者页面未提供官方 source repository;大规模多源训练、CroCo 权重和 posed reference 数据降低了可复现性。
隐含假设
- 每个新对象都可以被采集足够覆盖的 reference RGB images,并可得到可信 object-to-camera poses。
- 物体是刚性、近似非对称,query / reference 的外观差异、遮挡和 bbox drift 不会完全破坏视觉 correspondence。
- 粗 3D bounding cuboid 与相机内参的尺度 / 坐标系一致;10% 随机扰动不是完整的 calibration error model。
真实应用可行性
- 可以使用的场景:无 CAD、但可在上架阶段用标记或标定采集 posed references 的单物体 AR、机器人取放或小批量商品库;可接受中等精度且目标可以先检测到。
- 离实用还差什么:自动 reference pose acquisition 与质量评估、对象 detection / retrieval、symmetry-aware pose representation、重遮挡恢复、对透明 / 反光材质和错误内参的可靠性测试。
9. 未来工作与可改进方向
- 用不确定性来选择 reference views、输出多个 pose hypotheses,显式处理对称物体与近似对称的 proxy ambiguity。
- 让 proxy 从单一 cuboid 升级为可学习的、但拓扑共享的 coarse geometry,保留 model-free 优点并增强 complex-shape discrimination。
- 用更现代的 foundation matching features 或 cross-view geometry models 替代 CroCo v2,并测试是否减少对大规模 object-centric training 的依赖。
- 把 detector crop、reference pose recovery、view selection 与 PnP inlier quality 纳入端到端系统指标,报告真实 wall-clock latency 与失败率。
- 压力测试:透明 / 反光、强遮挡、背景干扰、对称组、reference pose noise、极少 K、reference-query illumination gap。
10. 对我的研究的启发
- 可直接借鉴:pose-as-pointmap conditioning、proxy coordinate regression、confidence-guided PnP、在 reference set 上用 farthest sampling 避免视角盲区。
- 可复用的思路:把“必须估真实 object surface”拆开思考。对于只需 pose 的任务,一个稳定、不随对象拓扑改变的 proxy target 可能比 CAD coordinate 更可泛化。
- 必须加入的 baseline:CAD-free、RGB-only、posed-reference unseen-object pose 应包括 MFOS、Gen6D、OnePose / OnePose++;务必报告 reference pose 的来源、K、是否 SfM、detector / GT crop、严格与宽松阈值。
- 可能形成的切入点:在保持 cuboid proxy 高鲁棒性的同时,引入局部 surface cues / uncertainty-aware refinement,补足其严格精度与对称 / complex-shape 失败;或降低 posed reference acquisition 成本。
11. 待解决问题
- 概念问题:proxy cuboid 的 R,t 如何与不同 object coordinate convention 精确转换,若 object center 定义不一致会怎样?
- 实验问题:Table 2 的 cuboid-to-CAD setting 因训练集移除 OnePose,若在严格相同训练对象上差距是否仍同样大?
- 工程问题:reference pose 由 fiducial、SfM 或 SLAM 生成时,误差分布和 database coverage 如何影响 PnP inliers?
- 复现问题:未见官方实现与预处理脚本;需要自行重建 CroCo 初始化、BOP / ABO / OnePose 混合训练和 memory-optimized multi-reference attention。
