论文精读笔记:PIZZA: A Powerful Image-only Zero-Shot Zero-CAD Approach to 6 DoF Tracking
1. 基本信息
- 方法:PIZZA(Powerful Image-only Zero-Shot Zero-CAD Approach)
- 作者:Van Nguyen Nguyen、Yuming Du、Yang Xiao、Michaël Ramamonjisoa、Vincent Lepetit
- 机构:LIGM,Ecole des Ponts,Université Gustave Eiffel,CNRS,France
- 年份 / 会议:2022 / International Conference on 3D Vision(3DV,Oral)
- 论文:arXiv:2209.07589
- PDF:arXiv PDF
- 代码:nv-nguyen/pizza(MIT License)
- 阅读模式:精读
2. 一句话定位
PIZZA 把未知物体的 monocular 6D tracking 重新表述为“首帧定义 gauge,之后只估连续帧 relative motion”:它以 unseen-object mask 和共同 crop 消除背景干扰,用 (Δu,Δv,Zt/Zt−1−1) 保持无 CAD 条件下的平移尺度一致性,再用多帧 Transformer 降低逐帧复合造成的 drift。
方法输入与输出
| 项目 | 内容(本站整理) |
|---|
| 推理输入 | RGB 序列、内参 K 和首帧 target bbox;内部 segmentor / RAFT 生成并传播 masks,运动网络读取共同裁剪、去背景的相邻帧或历史帧。 |
| 最终输出 | 帧间旋转 ΔR 与平移变化,再通过初始状态逐帧累积为对象相对相机的轨迹。没有物理初值时,轨迹具有首帧坐标与统一尺度的自由度。 |
| 训练输入 | 其他对象 CAD 渲染的图像对 / 序列、mask 与 GT poses;测试对象的 CAD、深度和 GT motion 不进入常规推理。 |
| 训练目标 | 学习帧间旋转与平移参数;旋转用 axis-angle,平移拆成图像平面位移和相对深度比,而不是回归某个未知对象的绝对尺寸。 |
| 输出细节 | 网络的 (Δu,Δv,s) 经 crop 变换、内参和上一帧深度还原为三维平移变化;s 是相对深度参数,不是对象 size。无 metric 初始化时不能把 t 标成厘米 / 米。 |
| 必要条件 | bbox、标定和前端分割 / 光流仍不可忽略;完整 absolute pose benchmark 另给首帧 GT pose,必须与只给首帧框的 relative tracking 区分。 |
2.1 论文图表导读
| 图表 | 内容 | 关键问题 |
|---|
| Figure 1 | 任务示意与真实序列 | 3D model / 首帧 GT pose 在论文图中扮演什么角色 |
| Figure 2 | mask propagation 与重新分割 | 为什么 2D 前端是 6D tracker 的系统瓶颈 |
| Figure 3 | multi-frame shared crop | 如何避免每帧独立 crop 抹掉真实像平面运动 |
| Figure 4 | 3D translation parameterization | 无物体尺度时如何维持统一的 translation gauge |
| Figure 5 | two-frame / multi-frame 网络 | Transformer 处理的是 pose history 还是 image features |
| Tables 2—5 | synthetic / real 主结果 | 输入信息不一致时如何公平解释数值 |
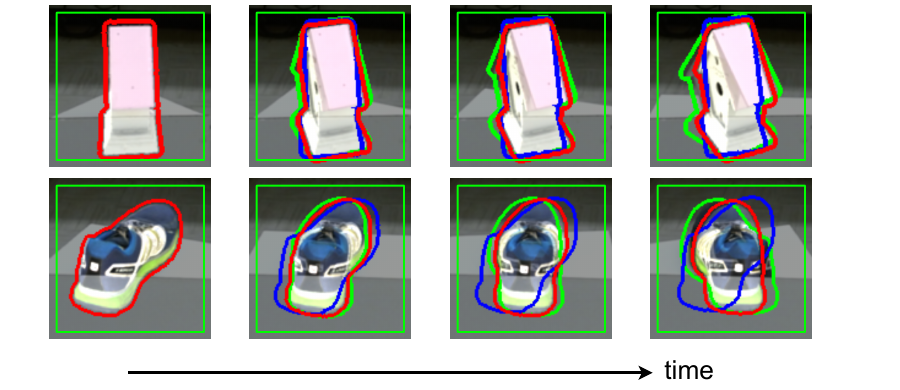
| Figure 7 | Laval 与 MOPED 定性结果 | 红 / 蓝 / 绿轮廓分别表示什么 |
| Figure 11 | 随 tracking 时长的误差累积 | 多帧上下文是否真正消除了漂移 |
| Figure 13 | segmentation failure | 非刚体前景变化如何污染 motion regression |
 原论文 Figure 1:首帧 bounding box 选定目标,后续输出 relative 6D trajectory。论文用首帧 GT pose 与 3D model 绘制轮廓来评估 / 可视化,但它们不是目标序列的常规推理输入。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
3.1 形式化定义
给定 RGB 序列:
S={I1,…,IN},
目标是在每一帧恢复对象相对相机的旋转和平移 (Rt,Tt)。网络本身预测的是相邻帧 motion:
ΔRt−1,t=RtRt−1⊤,ΔTt−1,t=Tt−Tt−1.
然后递归复合:
Rt=ΔRt−1,tRt−1,Tt=Tt−1+ΔTt−1,t.
这个写法看似能得到 absolute camera-frame pose,但其物理含义取决于第一帧:
- 有 R1,T1 的 metric 初始化时,可输出与 baseline 协议一致的 absolute trajectory;
- 无目标 CAD / coordinate frame 时,R1 可任意设为 Identity;
- 无 metric depth / object size 时,Z1 可任取正值,因此 translation 只确定到统一 scale。
3.2 推理输入与依赖
| 输入 / 模块 | 是否需要 | 作用与边界 |
|---|
| RGB video | 是 | 唯一目标序列传感器模态 |
| first-frame target bbox / center | 是 | 指定要跟踪的实例;论文不是自动 object discovery |
| camera intrinsics K | 是 | 将中心投影与 depth gauge 还原为 3D translation |
| class-agnostic segmentor | 是 | 产生每帧 foreground mask;不是用户预先提供的 GT mask |
| RAFT optical flow | 是 | 将当前 mask 传播到下一帧,形成新 ROI |
| target CAD / metric mesh | 否 | 训练可用其他对象 CAD;测试对象不需要 |
| target depth | 否 | PIZZA 的主要设定是 image-only |
| target reference views | 否 | 不需要 Gen6D / OnePose 式 object onboarding |
| initial 6D pose | 条件需要 | 只有要输出 benchmark 意义下的 metric absolute trajectory 时才需要 |
3.3 它是实例级还是类别级
PIZZA 的共享模型能泛化到训练未见类别,但它不是 category-level pose:
- 方法没有学习 NOCS、category canonical frame 或 category shape prior;
- 跟踪对象由首帧框选定,是一个具体 instance;
- 输出 pose 的坐标 gauge 由首帧定义,不是类别共享坐标系。
因此更准确的标签是 instance-level unseen/open-world relative 6D tracking。
3.4 标题中三个限定词
- Zero-Shot:测试对象不重训,不等于模型没有预训练。
- Zero-CAD:推理时没有目标 CAD,不等于 synthetic training 不使用其他 CAD。
- Image-only:目标序列没有 depth,不等于系统只需要一个裸 RGB tensor;相机内参、初始化框和 learned segmentation / flow 仍是必要依赖。
4. 研究脉络
PIZZA 处在 DeepIM、MoveIt、Laval-generic、LatentFusion 等 temporal 6D tracking 路线与 Gen6D、OnePose 等 novel-object pose 路线之间:
| 方法 | 目标信息 | 测试模态 | 输出方式 | 与 PIZZA 的关系 |
|---|
| DeepIM / MultiPath | target CAD | RGB | 从初值迭代 refinement | ModelNet 两帧 baseline |
| Laval-generic | target CAD | RGB-D | 15 帧 tracking | Laval baseline,信息更强 |
| MoveIt | target CAD | RGB | learned frame-to-frame motion | Laval baseline |
| LatentFusion | registered target references | RGB-D | latent 3D reconstruction + pose | ModelNet / MOPED baseline |
| Gen6D / OnePose | posed / registered references | RGB | novel-object absolute pose | CAD-free,但 onboarding 更重 |
| PIZZA | first-frame bbox;absolute 评测时另给 initial pose | RGB video | relative motion recursive composition | 最小化测试对象先验 |
论文发表时的核心新意并不是首个 relative pose regressor,而是把 unseen category、zero target CAD、RGB-only、无 target reference acquisition 同时放进一个可评测的 6D tracking setting。
5. 研究动机
5.1 为什么不做单帧 absolute pose
对于从未见过且没有 CAD 的对象,单帧图像无法定义:
- 对象坐标原点;
- canonical orientation;
- 真实尺寸与 metric depth。
强行回归 absolute 6D pose 会把不可辨识量混入监督。PIZZA 只预测帧间变化,把无法定义的自由度留给首帧 gauge。
5.2 为什么背景是关键干扰
对 known-object network,权重可学习目标外观,即使背景复杂也能忽略无关区域;对 unseen-object generic regressor,背景运动、camera motion 和 clutter 都可能与目标外观变化竞争。论文报告,仅用复杂背景做 domain randomization 不够,显式 masking 才能稳定 motion prediction。
5.3 为什么需要多帧
两帧相对 pose 的微小 bias 会在递归复合中累积。Transformer 不直接优化 pose graph,而是让当前两帧的特征吸收更长历史的 image evidence,从局部观测层面减少每一步误差。
6. 方法详解
6.1 总体 Pipeline
- 用户在第一帧提供 target bbox B0。
- unseen-object segmentor 生成 M0。
- RAFT 把 Mt warp 到 It+1,得到粗 mask M^t+1。
- 由 M^t+1 计算 Bt+1,再次分割得到 Mt+1。
- 对历史 K 帧采用同一个、覆盖全部 boxes 的 crop,并用 masks 去背景。
- ResNet-18 对每个 crop 编码为 256 维 feature。
- 双帧版直接拼接最后两帧特征;多帧版先经过 Transformer Encoder。
- 两个 MLP 分别预测 axis-angle ω 与 (Δu,Δv,s)。
- 结合 crop scale、内参和上一帧 pose 恢复 ΔR,ΔT,再递归更新轨迹。
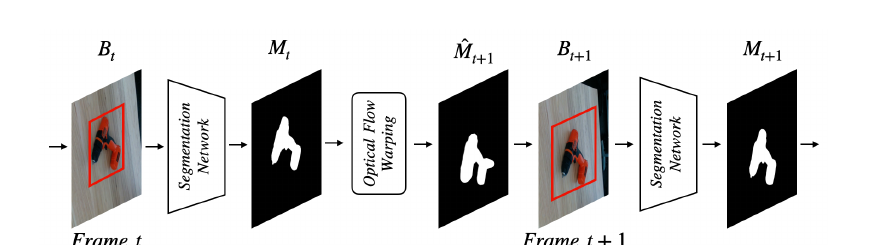 原论文 Figure 2:mask propagation 负责短时关联,重新分割负责纠正 warped mask;这一路级联给 6D 网络提供 box 与 foreground。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
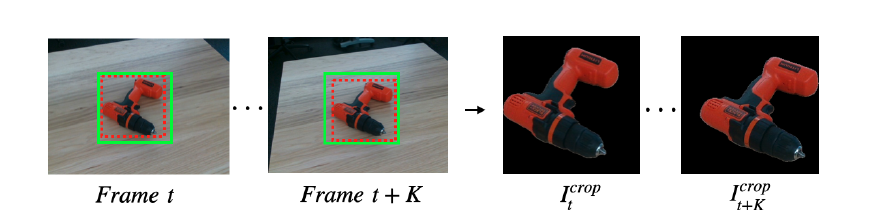 原论文 Figure 3:连续 $K$ 帧使用覆盖所有红框的同一绿色 crop,并对背景 masking;若每帧独立把对象居中缩放,真实 2D translation / scale change 会被预处理消掉。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.2 Translation parameterization
令对象中心在第 t 帧的投影为 (Ut,Vt)、camera-frame depth 为 Zt,则:
Tt=ZtK−1UtVt1.
因此:
ΔTt−1,t=ZtK−1UtVt1−Zt−1K−1Ut−1Vt−11.
网络不直接回归 ΔT,而是回归:
ΔU=Ut−Ut−1,ΔV=Vt−Vt−1,St−1,t=Zt−1Zt−1.
由于网络输入是 resize 后的 crop,输出 (Δu,Δv,s) 还需还原:
ΔU=αuWcropΔu,ΔV=αvHcropΔv,
S=2αu+αvs.
这里的关键不是公式复杂度,而是 所有 Zt 都由同一个 Z1 递推。即使 Z1 是任意值,序列内 translation magnitude 仍共享同一 scale factor,不会每一帧各自漂到不同尺度。
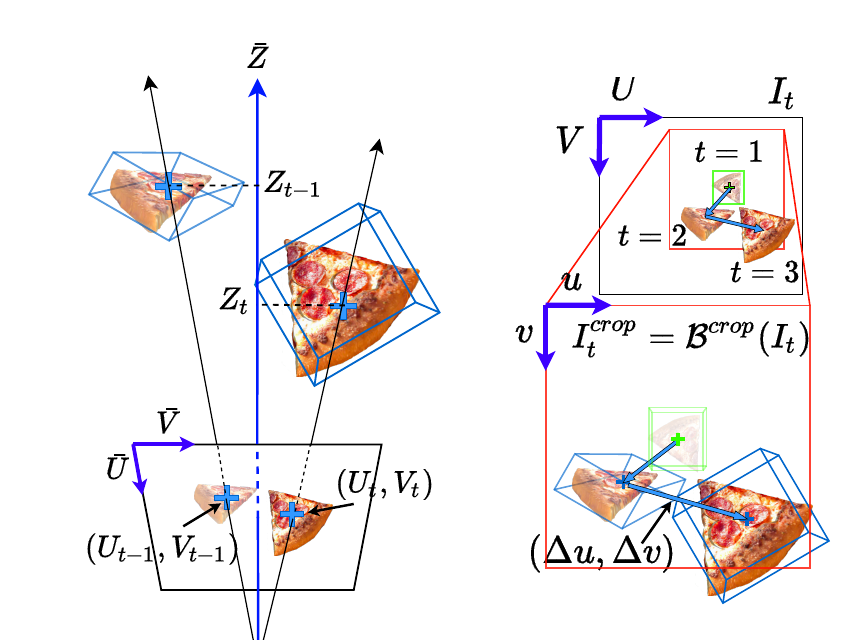 原论文 Figure 4:左侧把 3D center translation 分解为投影中心位移与 $Z$ 变化;右侧说明共同 crop / resize 后的网络输出如何映射回原图坐标。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Translation loss 使用 smooth-L1:
LΔT=ℓ1(Δu,Δu⋆)+ℓ1(Δv,Δv⋆)+λℓ1(s,s⋆),λ=1.
6.3 Rotation parameterization
相对旋转使用 axis-angle:
ω∈R3,∥ω∥ 为角度,ω/∥ω∥ 为旋转轴.
损失为:
Lω=∥ω−ω⋆∥22.
附录比较 Euler、axis-angle、quaternion 与 rotation-6D。小幅 tracking motion 下几种表示最终误差接近,论文采用结构最紧凑的 axis-angle。需要注意,它没有显式处理对称物体的多解标签。
6.4 Two-frame 与 multi-frame
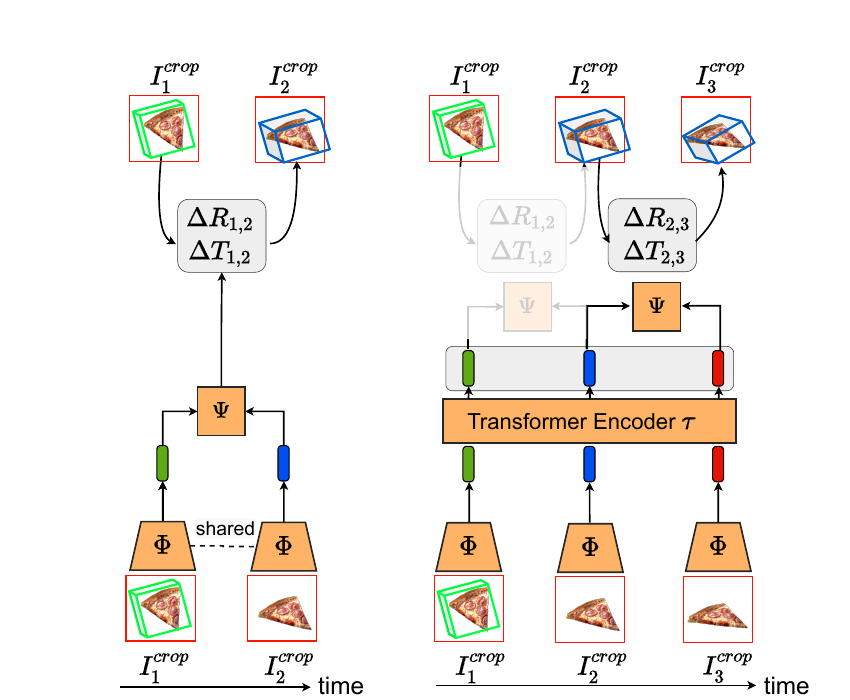 原论文 Figure 5:两种版本共享 image encoder 与 pose regressor;multi-frame 只在 feature sequence 上增加 Transformer,并仍由最后两个 contextualized features 输出相邻帧 motion。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 模块 | 结构 | 输出 | 作用 |
|---|
| Φ | ResNet-18,输入 224×224 | 每帧 256-D feature | 共享外观 / motion encoder |
| T | 1 个 Transformer Encoder layer,12 heads,FFN 512,无 dropout | contextualized feature sequence | 聚合任意数量历史帧 |
| ΨR | 800—400—200 三层 MLP | 3-D axis-angle | relative rotation |
| ΨT | 800—400—200 三层 MLP | Δu,Δv,s | relative translation parameters |
两个 MLP 的中间层使用 BatchNorm + ReLU。可学习模块联合端到端训练,但 segmentation 和 RAFT 是独立前端。 本表按论文声明保留 256-D embedding 与 12 heads;256 不能被 12 整除,不能直接据此配置标准等分多头 attention,实际 hidden dimension 或投影衔接需核对实现,本文不擅自改成另一组参数。
6.5 算法中的两个 gauge
论文 Algorithm 1 显式允许:
- R1=I:轨迹相对该任意初始 orientation;
- Z1>0 任取:translation trajectory 相对该任意 scale。
因此,“首帧只给 bbox”与“输出绝对 6D pose”不能同时无条件成立。更严谨的说法是:
- 首帧 bbox 足以启动 relative motion tracking;
- 首帧 metric 6D pose 才足以得到 benchmark 定义的 absolute metric pose sequence。
7. 训练数据与监督
7.1 三套 synthetic protocol
| 数据 | 规模(论文 Table 1) | 用途 |
|---|
| ModelNet | 420,400 train / 35,000 test images | 与两帧 pose refinement / tracking baseline 比较 |
| ShapeNet | 400,000 train / 100,000 test images,视频 | 评估 15 帧 multi-frame tracking |
| BOP CAD renderings | 22,500 train images,视频 | 训练 real-domain evaluation 使用的模型 |
真实测试为:
- Laval:14,190 test images,297 sequences、11 objects;
- MOPED:3,079 test images、11 household objects。
用于真实实验的 synthetic CAD 来自 BOP challenge 中的 LINEMOD、HomebrewedDB、HOPE、RU-APC 等,由 BlenderProc 渲染。训练与真实测试对象被刻意设为差异较大的类别,验证 category generalization 与 sim-to-real 同时发生。
7.2 运动采样
ModelNet 两帧数据:
- 初始 translation 为 (0,0,500 mm);
- rotation 随机;
- 各轴角扰动服从标准差 15° 的高斯,总角扰动小于 45°;
- Δx,Δy 标准差 10 mm,Δz 标准差 50 mm。
ShapeNet 视频:
- 首帧 Z 在 0.4—2 m 均匀采样;
- 后续各轴 rotation motion 标准差 20°;
- 各轴 translation motion 标准差 20 mm;
- 每个 CAD 生成 100 帧。
这些分布决定了 motion regressor 的有效范围。快速运动、强 motion blur 或大面积出视野并没有被主实验充分覆盖。
8. 实验分析
8.1 指标
- 5°/5cm recall:rotation geodesic error 与 translation error 同时过阈值。
- ADD-0.1d:变换后模型点平均距离小于直径的 10%。
- ADD-S:用最近邻距离处理对称物体。
- Proj2D-5px:投影点误差小于 5 pixels。
- sequence error:每 15 帧统计 rotation / translation error。
ADD、ADD-S 和 Proj2D 都需要目标 3D model 做评测,但这不意味着 PIZZA 推理使用该 model。
8.2 ModelNet 两帧比较
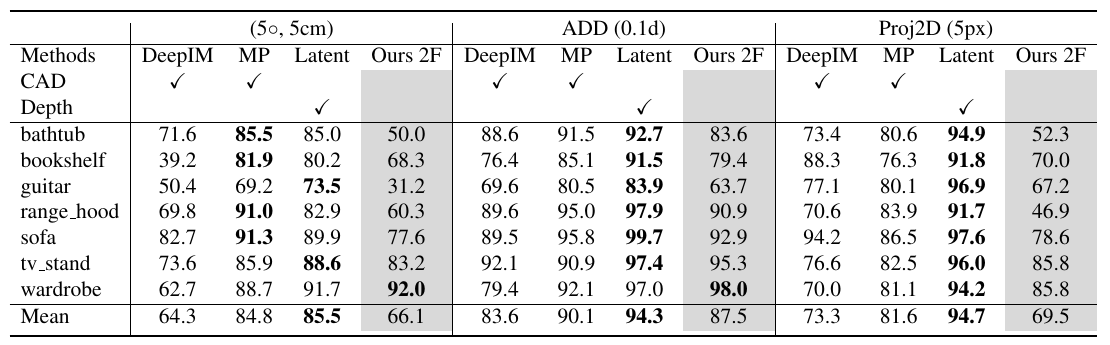 原论文 Table 2:PIZZA 2F 不用 CAD / depth;DeepIM、MP 使用 CAD,LatentFusion 使用 depth 与 reference frames。均值分别按 5°/5cm、ADD-0.1d 与 Proj2D-5px 报告。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 方法 | 额外输入 | 5°/5cm | ADD-0.1d | Proj2D-5px |
|---|
| DeepIM | CAD | 64.3 | 83.6 | 73.3 |
| MultiPath | CAD | 84.8 | 90.1 | 81.6 |
| LatentFusion | depth + references | 85.5 | 94.3 | 94.7 |
| PIZZA 2F | RGB pair | 66.1 | 87.5 | 69.5 |
作者声称:在信息明显更少时,PIZZA 仍有可比性能,并在 5°/5cm 与 ADD 上超过 DeepIM。
我的分析:这个结论成立,但 PIZZA 并非表中 SOTA;其价值主要是 input-prior efficiency。Proj2D 明显落后,也提示 crop / center displacement 和 rotation error 会直接影响轮廓投影。
8.3 ShapeNet 多帧收益
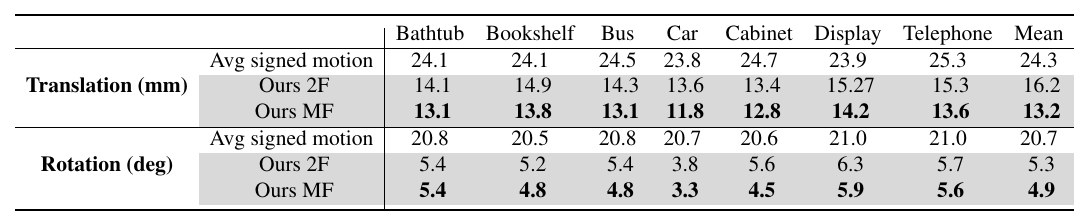 原论文 Table 3:multi-frame 在七个未见类别上均降低误差;平均 translation 由 16.2 mm 降至 13.2 mm,rotation 由 5.3° 降至 4.9°。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
translation 改善约 18.5%,rotation 改善约 7.5%。这说明历史帧对中心 / scale motion 的帮助更明显,而短时间小旋转本身已经较易从相邻帧估计。
8.4 Laval 遮挡
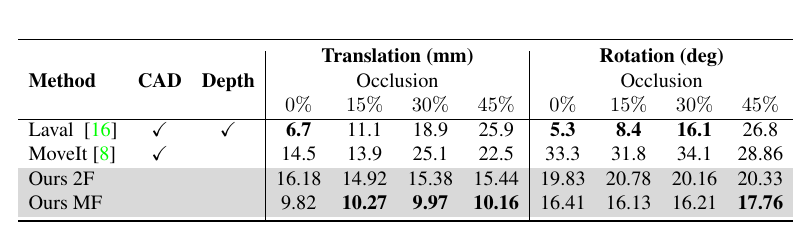 原论文 Table 4:PIZZA multi-frame 在 15%--45% 遮挡下取得最低 translation error,并在 45% 遮挡取得最低 rotation error;0% 遮挡下,使用 CAD + depth 的 Laval-generic 更强。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
高遮挡时 PIZZA MF 的 translation error 基本维持在约 10 mm,说明 multi-frame evidence 与 segmentation 对短时遮挡有效。需要保留两个限制:
- 协议每 15 帧提供一次 GT pose,结果不是无限长 free-running trajectory;
- 表中方法输入不一致,PIZZA 的目标是以更少先验保持竞争力,不是同模态严格排名。
8.5 MOPED
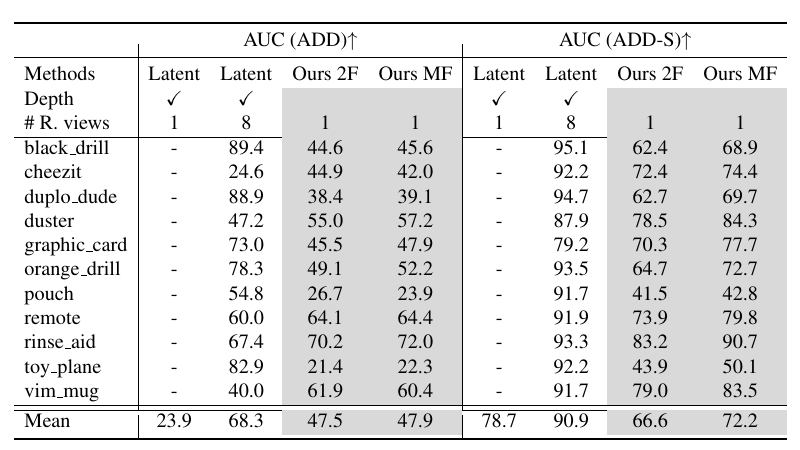 原论文 Table 5:PIZZA 2F / MF 的 ADD AUC 为 47.5 / 47.9,ADD-S AUC 为 66.6 / 72.2;LatentFusion 使用 1 / 8 个 reference views 且需要 depth。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
LatentFusion 单参考图为 23.9 ADD AUC、78.7 ADD-S AUC;8 参考图为 68.3 / 90.9。PIZZA 在 ADD 上超过单参考图配置,但 ADD-S 仍低 6.5—12.1 points;与 8-reference 配置则存在明显差距。因而“comparable to one reference”应按两个指标分别理解。
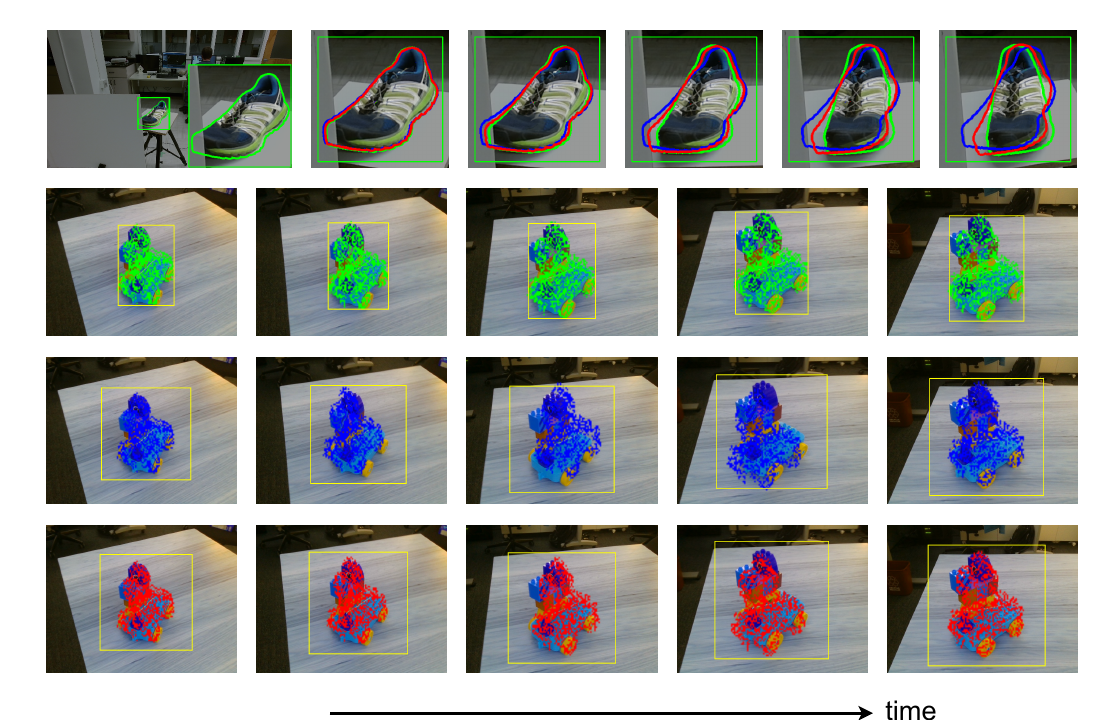 原论文 Figure 7:绿色为 GT,蓝色为 PIZZA two-frame,红色为 multi-frame;首行来自 Laval shoe,后三行来自 MOPED duplo dude。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8.6 Ablation 与证据链
| 主张 | 对应证据 | 是否充分 | 判断 |
|---|
| 多帧减少 drift | Table 3、Figure 11 | 较充分 | 七类均改善,长序列曲线方向一致 |
| 无 CAD / depth 仍有竞争力 | Tables 2、4、5 | 基本充分 | 模态更弱但协议不完全同质,不能当纯架构胜负 |
| 对遮挡更稳 | Table 4 | 中等 | 四档遮挡支持,但只在 Laval 15-frame protocol |
| rotation 表示不关键 | Figure 8 | 有限 | 只在小平均旋转的 synthetic setting 比较 |
| masking 对 unseen object 必要 | 方法动机与失败案例 | 不完整 | 论文缺少一个清晰的 no-mask quantitative table |
9. 误差累积与失败模式
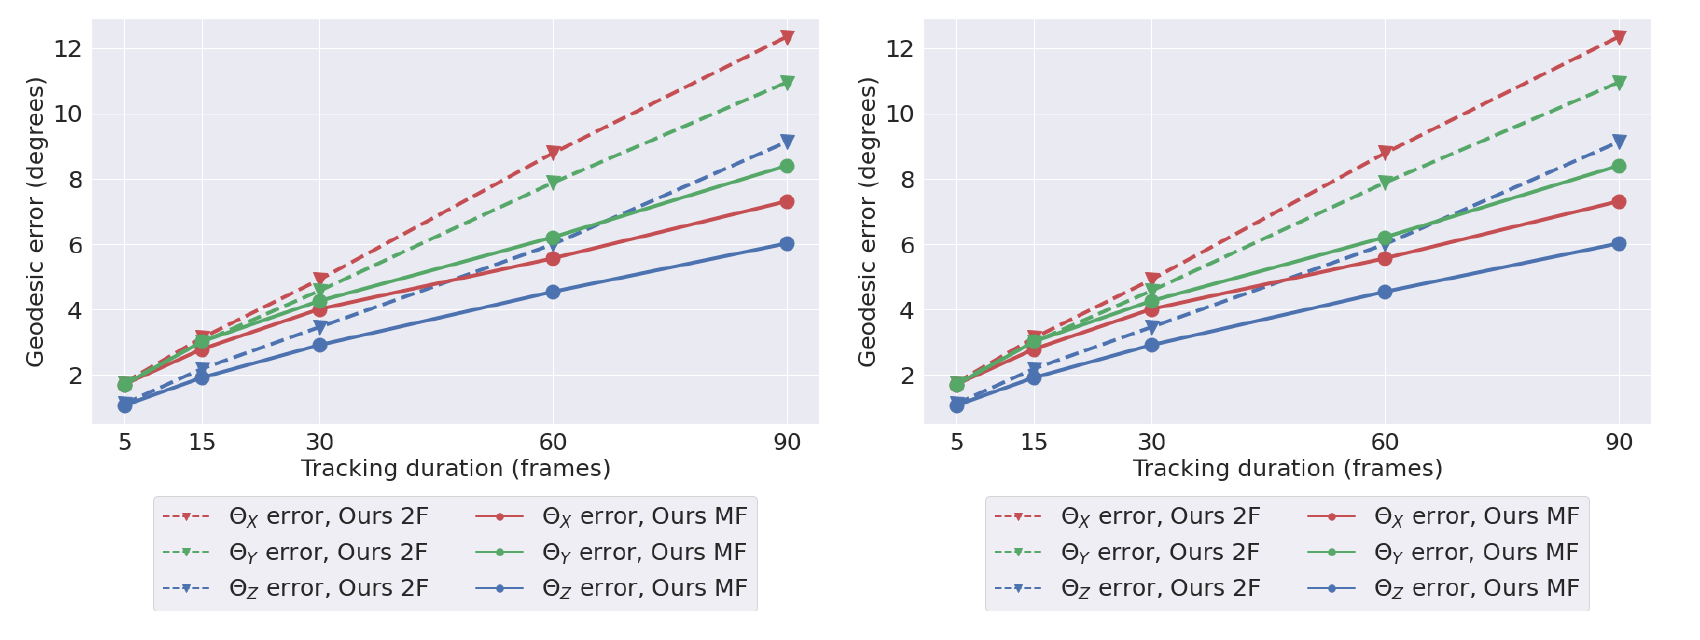 原论文 Figure 11:当前截图左右均为同一组旋转误差曲线(degrees),没有显示作者图注所称的右侧平移曲线。tracking 时长从 5 增至 90 帧时旋转误差持续增长,multi-frame 曲线整体更低;translation 的 $X/Y$ 轴增长更慢是作者正文说明,不能由当前截图直接核验。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
9.1 单目 Z 向运动
论文明确指出,ΔTz 是主要 translation error 来源。物体沿 optical axis 移动时,即使深度变化明显,图像中的 appearance / scale 变化仍可能很小,尤其在 crop resize、弱纹理和近似对称情况下。
9.2 Segmentation-induced motion ambiguity
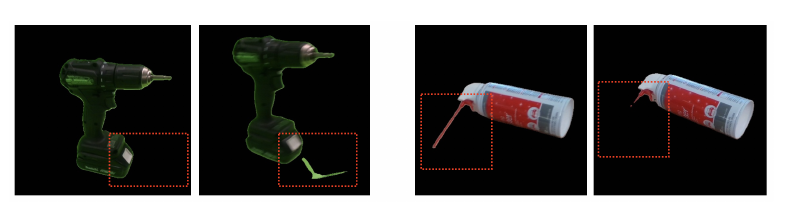 原论文 Figure 13:红框区域展示 segmentor 对钻头配件和软管的包含关系变化;这些非刚体 mask 变化会被 pose network 误认为对象 motion。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
9.3 其他隐含风险
- 跟踪丢失后无重定位:pipeline 依赖前一帧 mask / flow,没有 global object re-detection 与 identity recovery。
- 大运动域外泛化:训练 motion 有明确高斯扰动尺度,极快旋转 / 平移可能超出分布。
- 长时 gauge drift:每步 relative scale / center 的小偏差会积累,没有 bundle adjustment 或 loop closure。
- 对称多解:ADD-S 在评测层面容纳对称性,axis-angle regression 没有显式 symmetry-aware loss。
- 非刚体与附着物:segment composition 改变违反刚体假设。
- 透明 / 反光 / motion blur:论文没有专项实验,不能从 Laval / MOPED 数值推出鲁棒性。
10. 工程复杂度与复现
10.1 推理链路
完整系统并非单网络 forward:
- segmentation;
- RAFT optical flow;
- mask warp 与 bbox update;
- re-segmentation;
- shared crop / resize;
- ResNet + Transformer + MLP;
- pose reconstruction 与 recursive composition。
代码公开且为 MIT License,但官方环境基于较早版本的 PyTorch / MMCV / CUDA,并依赖外部分割与 RAFT 实现。现代环境复现时,最容易出现的并非网络结构问题,而是前端版本、crop conventions 与 pose composition conventions 不一致。
10.2 必须对齐的实现细节
- K 的像素坐标约定与 resize 后 intrinsics;
- shared crop 的 origin、width / height 与 αu,αv;
- mask warp 的 forward / backward flow 方向;
- ΔR=RtRt−1⊤ 的左乘顺序;
- Rodrigues axis-angle 的单位与数值稳定性;
- S=Zt/Zt−1−1 的更新方向;
- 评测时 R1,Z1 使用 GT 还是 arbitrary gauge;
- Laval 是否每 15 帧 reset GT pose。
11. 批判性分析
优点
- 对“没有 target CAD 时 absolute pose 为什么不可定义”处理得诚实,translation parameterization 与任务边界一致。
- 把 background masking、crop coordinate consistency 和 temporal context 连接成完整系统,而不是只展示 pose backbone。
- 多个 synthetic / real benchmark 支持 unseen-category 与 sim-to-real 两种泛化。
- 与信息更强 baseline 比较时明确列出 CAD、depth、reference views。
缺点
- 摘要和标题容易让读者误以为只给 RGB 就能恢复 metric absolute pose;关键 gauge 条件主要在正文 / Algorithm 1 中澄清。
- 缺少针对 masking、flow quality、shared crop 和 sequence length 的完整 quantitative ablation。
- multi-frame 模型仍输出 pairwise motion,没有显式 trajectory-level loss 或 global consistency。
- 真实协议序列短、对象数少,对长期、快速运动、出视野重入和 severe clutter 的覆盖不足。
- segmentation 前端很重,论文没有给端到端速度 / latency 分解。
隐含假设
- 初始框准确覆盖目标;
- 对象刚体且身份不变;
- camera intrinsics 已知且跨帧一致;
- 连续帧 motion 可由 synthetic perturbation 覆盖;
- segmentor 对未知对象有足够稳定的 mask;
- 需要 metric absolute trajectory 时,有外部模块提供首帧 pose。
真实应用可行性
PIZZA 适合 AR interaction、robot tracking 或后续 manipulation 中“目标已被用户 / detector 选中,先验极少,但只需连续 motion”的场景。要成为长期可靠的 absolute 6D tracker,还缺:
- 可校准的首帧 pose / scale initializer;
- 丢失检测与 re-localization;
- uncertainty-aware depth motion;
- sliding-window global optimization;
- 更轻、更稳的视频分割;
- 明确的实时性与硬件 benchmark。
12. 未来工作与可改进方向
- Video foundation segmentation:用 memory-based video segmentation 替代逐帧 flow-warp + re-segmentation,同时输出 mask uncertainty。
- SE(3) temporal model:在 Lie algebra 上预测分布而非独立 ω,Δu,Δv,s,对复合误差加 trajectory loss。
- Multi-hypothesis Z motion:对弱可观测 ΔTz 保留多个深度比例假设,由后续帧消歧。
- Keyframe re-anchoring:定期选高置信帧重设局部 gauge,减少长时漂移。
- Pose graph / bundle adjustment:利用非相邻帧 appearance correspondence 建立 loop constraints。
- Lost-and-found tracking:加入 global re-detection、identity embedding 与恢复后的 pose alignment。
- 更公平实验:固定同一 bbox / mask / first-pose protocol,分别比较 RGB、RGB-D、CAD 与 reference-based tracker。
- 更广鲁棒性:透明反光、motion blur、相机运动、非刚体附着物、对象出视野重入和分钟级序列。
13. 对研究与实现的启发
- 可直接借鉴的表示:image-plane displacement + relative depth ratio 比直接回归 metric XYZ 更适合 unknown-scale monocular tracking。
- 可直接借鉴的预处理:多帧必须共享 crop,才能保留真实 position / scale change。
- baseline 使用条件:论文主问题是 zero-CAD relative tracking;若研究目标是单帧 absolute pose、category-level canonical pose 或 CAD-based refinement,PIZZA 只能作为邻近路线,不能直接横向排名。
- 实验报告规范:始终分开写 target CAD、reference views、depth、initial bbox、initial pose、intrinsics 和 reset interval。
- 最有价值的延伸点:把 PIZZA 的最小目标先验与现代 video segmentation、uncertainty 和 windowed geometric optimization结合,补上丢失恢复与长期一致性。
14. 待解决问题
- 论文未报告完整 pipeline 的端到端 FPS,各前端模块分别占多少时间?
- history 长度在训练 / 测试时如何采样,增加到多长后收益饱和?
- shared crop 在目标快速接近相机时是否会因历史框扩大而损失当前分辨率?
- segmentation confidence 能否用于 motion loss weighting 或帧选择?
- Z 方向误差能否通过 object silhouette scale、defocus 或 learned monocular depth prior 改善?
- 首帧只有 bbox 时,如何在不引入 target CAD 的前提下获得可复现的 metric scale?
