论文精读笔记:PoseGaussian: 6D Pose Estimation for Unseen Objects via Sparse-View Object-Level 3D Gaussian Splatting
1. 核心判断
- 论文:CVF Open Access
- 核心问题:sparse-view 3DGS 常出现 floaters、几何不稳定和训练图像过拟合,直接拿它做 pose prior 会把重建误差传给姿态估计。
- 核心回答:改造 3DGS 的初始化和密度控制,再把 ICP 初始值与可微渲染 refiner 组合起来。
2. 一句话定位
PoseGaussian 先用深度约束得到更规整的 object-level Gaussian,再用学习引导的 ICP 与 RGB-D render-and-compare 在 SE(3) 上逐步精修未知物体姿态。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | 3DGS reconstruction、pose initialization、rendering refinement 如何衔接? |
| Table 1 | 与 Gen6D、OnePose++、Cas6D 等方法相比,少参考时是否稳定? |
| Table 2 | GenMOP 上不同物体是否都受益,还是只改善容易重建的对象? |
| Figure 8 | 参考视图从 4 增加到 8 后,重建与 pose 的收益如何分离? |
| Table 3 | 结构先验、ICP 初始化、appearance/depth refiner 是否互补? |
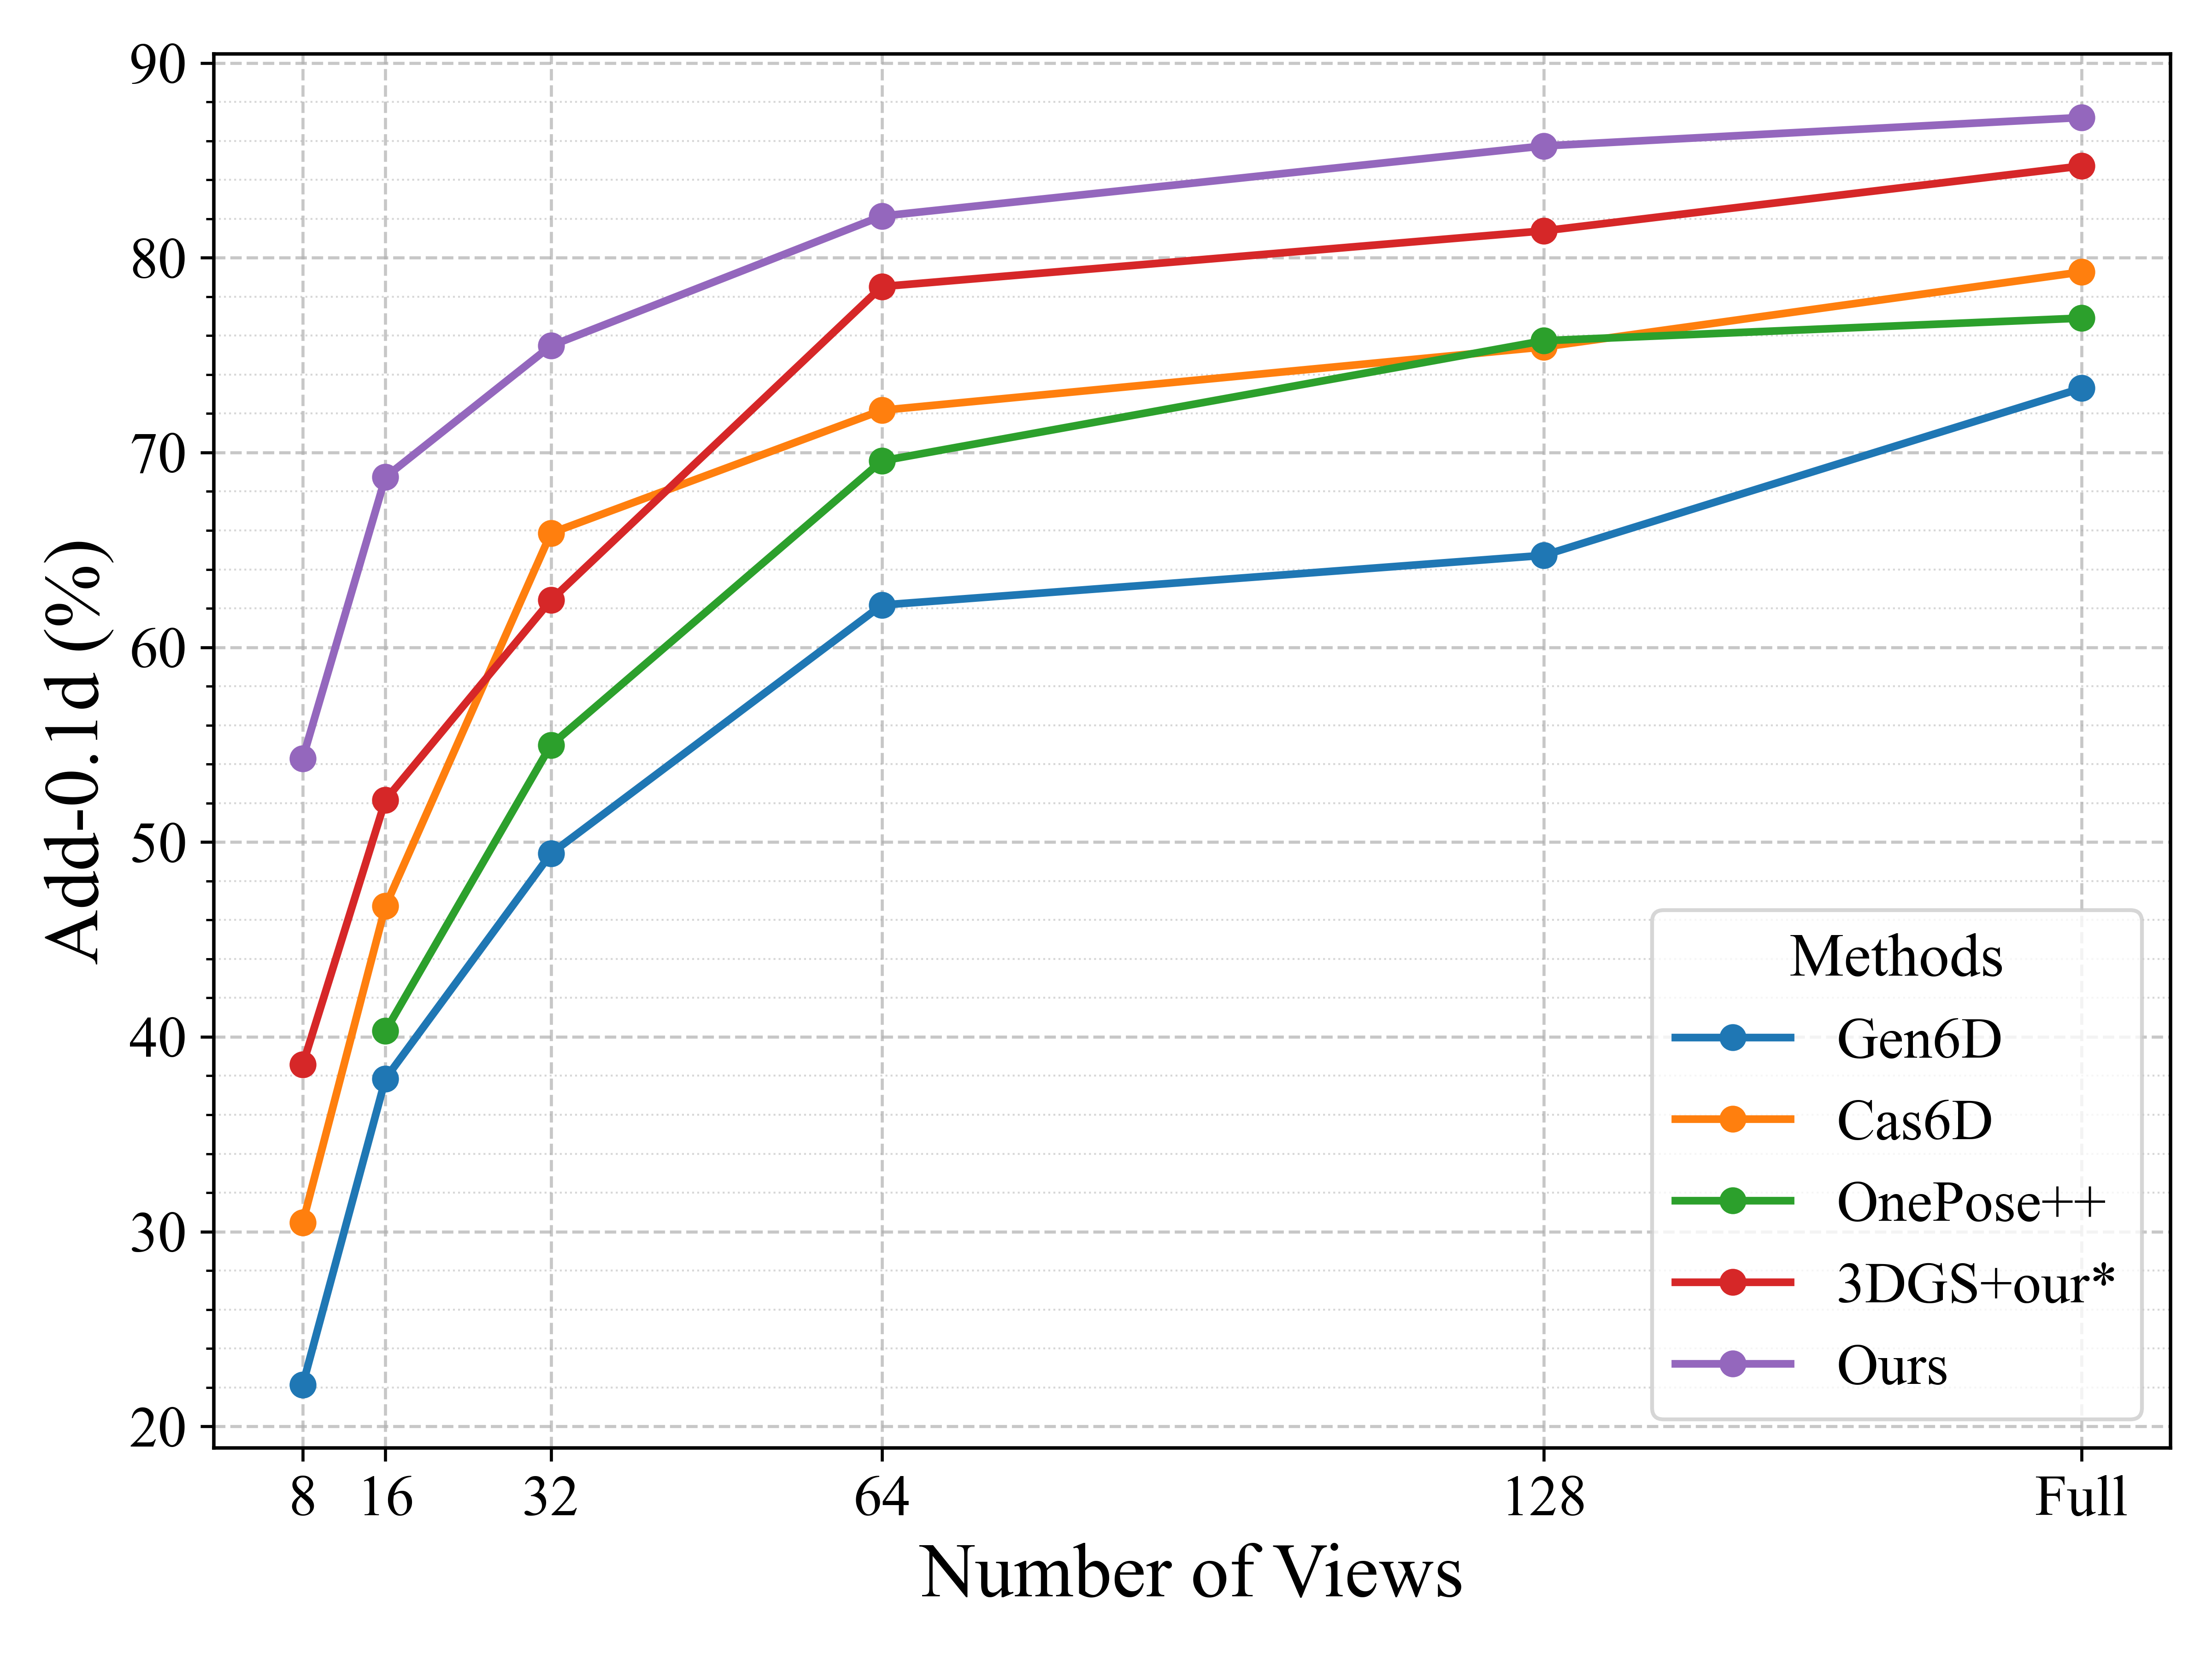 原论文参考视图数量实验曲线:横轴为 8、16、32、64、128 与 Full,纵轴为 ADD-0.1d(%);比较 Gen6D、Cas6D、OnePose++、3DGS+our* 与 Ours。当前截图是性能随视图数量变化的折线图,不是方法流程图。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- reference 阶段:给定约 8 张 RGB-D 视图,重建一个 object-centric 3DGS;query 阶段将新观测与该表示对齐。
- 论文将目标设为 unseen object pose,而不是类别级 canonical pose;每个新物体都需要自己的 sparse reference capture。
- 需要 object mask 和深度。对于没有深度的 RGB 输入,论文实验使用 ZoeDepth 估计深度,因此深度误差会进入重建和 refinement。
- 3DGS 是表示,不是人工 CAD;它保存几何、颜色、尺度和可渲染性。
4. 研究脉络
- OnePose / OnePose++ 用参考图像构建点云并做 correspondence;Gen6D 通过检索和 refinement 泛化;GS-Pose 进一步使用 Gaussian representation。
- 这些路线共同面对 sparse references 下的重建空洞和初始化不稳定。PoseGaussian 的差异是把“改进 3DGS 重建”和“改进 pose 初始化、refinement”同时设计。
- 这是一条典型的 representation-to-pose 路线:先得到可渲染对象表示,再通过渲染到观测的差异优化 pose。
5. 研究动机
- 3DGS 的高效优化适合少视角,但默认场景级初始化并不适合小型物体。
- sparse views 加低纹理会使 SfM 初始化失败,错误 Gaussian 会表现为 floaters。
- 仅靠 RGB photometric loss 会让 Gaussian 过拟合参考外观,生成姿态不正确但像素相似的渲染结果。
- 因此需要深度结构 prior、几何稳定的初始化和同时考虑 appearance / depth 的 refiner。
6. 方法详解
6.1 Improved object-level 3DGS
- 使用 object crop 和深度构造更可靠的初始点 / Gaussian,而不是完全依赖稀疏 SfM 点。
- adaptive density control 在训练过程中控制增殖和裁剪,抑制 floaters,改善 Gaussian 分布的表面覆盖。
- view-warp augmentation 增加从参考视图变换得到的监督,提升非输入视角的几何一致性。
- RGB 与 normalized depth 联合监督,使渲染结果不仅颜色接近,也要拥有合理的相对深度结构。
6.2 Learning-guided ICP 初始化
- 第一阶段从学习到的几何特征或匹配线索得到 coarse alignment。
- 第二阶段用 ICP 在点云 / 几何表示上进行局部对齐,避免随机初始化陷入错误局部最优。
- 这一初始 pose 为后面的 3DGS refiner 提供搜索附近,降低 render-and-compare 的优化难度。
6.3 3DGS pose refiner
- 在候选 pose 下渲染 RGB 与 normalized depth。
- 通过 appearance consistency 和 geometric/depth consistency 计算目标函数。
- 对 pose 做迭代优化,使物体表示的投影与 query 观测对齐。
- 该设计允许 Gaussian 的连续可渲染性直接服务于 pose,而不是先离散化为大量模板。
7. 训练与工程复杂度
- 训练数据包括 MegaPose 和 Google Scanned Objects 的合成物体;评测时泛化到 LINEMOD、GenMOP 和真实物体。
- 实验在 RTX 3090 Ti 上运行;8 张参考图的 3DGS 重建约 10k iterations,平均每个物体约 2.21 分钟。
- 这一成本主要发生在物体 onboarding 阶段;在线 query pose 由已有表示和 refinement 完成。
- 复现关键是保持 mask、深度尺度、相机内参和 object coordinate 的一致,否则 ICP 与渲染损失会混入坐标系误差。
8. 实验分析
8.1 数据与指标
- LINEMOD 有 13 个物体,是经典实例级 benchmark;GenMOP 用于更严格的 unseen-object 泛化;真实场景用于检验部署。
- 主要指标是 ADD(S)-0.1d,同时按不同物体和参考视图数量报告结果。
8.2 主结果
- 在 LINEMOD 上,论文报告 PoseGaussian 相比使用更多参考视图的既有方法仍有约 2.1 个百分点提升,说明 sparse-view 设计并非只依赖 reference 数量。
- 在 GenMOP 上,8 张参考图的结果在多个物体上保持较好的平均表现;参考视图丰富时,方法也接近强 baseline。
- 真实场景定性结果显示,改进后的 3DGS 边界更干净,floaters 减少,渲染对齐能提供更稳定的姿态细化。
8.3 消融结论
- 去掉结构先验或改回 vanilla 3DGS 会降低 pose 精度,说明重建质量直接影响后续姿态。
- 将学习引导 ICP 换成基于相似度的 selector 会下降,说明初始化质量是 render refinement 能否成功的关键。
- 去掉 appearance 或 depth consistency 会削弱细化,二者分别提供外观和几何约束。
- 参考数量增加通常带来重建和 pose 的连续改善,但也伴随物体 onboarding 数据和时间成本上升。
9. 批判性分析与启发
- 优点是 pipeline 中每个模块的作用符合几何直觉,且能将 3DGS 的表示优势转成 pose 优化信号。
- 主要风险是 test-time reconstruction 的时间与显存;对动态物体、强反光、透明材质和深度估计失败场景仍需额外处理。
- 可进一步研究 Gaussian uncertainty、部分可见区域的置信度和多物体共享重建,使 refiner 不会过度相信错误的 floaters。
- 对机器人应用,2.21 分钟的 onboarding 可能可以通过少量主动视角选择、增量 3DGS 或更快的 feed-forward Gaussian 初始化压缩。
11. 精读补充:重建质量如何传递到 pose
11.1 关键实验数字
PoseGaussian 的 LINEMOD 表需要分清 reference budget。论文报告的平均 ADD(S)-0.1d 如下:
| 设定 | Gen6D | OnePose++ | IG-6DoF / Cas6D | PoseGaussian |
|---|
| 充分参考(>200 张) | 76.9 | 85.1 | 87.2(IG-6DoF) | 约 2.1 个百分点高于最新 baseline |
| unseen sparse 参考 | 47.83(16 张) | 40.30(16 张) | — | 54.30(8 张) |
表中第一行的比较不是同一 reference 数量,因此不能简单写成“PoseGaussian 的绝对分数总是最高”;论文真正强调的是:8 张参考图的 PoseGaussian 仍超过部分使用 16 张图的 unseen-object baseline,并且在充分参考条件下比 IG-6DoF 高约 2.1 个百分点。
GenMOP 的 ADD-0.1d 平均值也给出了稀疏设置的细节:200 张参考时 Gen6D / Cas6D / OnePose++ / IG-6DoF / Ours 分别为 49.54 / 53.52 / 44.60 / 56.10 / 59.53;8 张参考时 Ours 为 27.56,16 张参考的 Gen6D / Cas6D / OnePose++ 分别为 34.00 / 37.01 / 24.19。Projection-5 在 200 张参考时 Ours 为 88.42,8 张时为 71.69。
11.2 Table 3 消融的真正结论
| 变体 | ARMSPD | ARMSSD | ARVSD | ARmean |
|---|
| Ours | 87.5 | 71.4 | 55.4 | 71.4 |
| 去掉 adaptive density control | 85.0 | 67.3 | 48.9 | 67.1 |
| 去掉 view-warp augmentation | 85.9 | 68.9 | 50.6 | 68.5 |
| vanilla 3DGS | 82.1 | 64.2 | 45.2 | 63.8 |
| 用 Gen6D selector 替换 initializer | 68.7 | 53.7 | 44.8 | 55.7 |
| 用 Cas6D selector 替换 initializer | 71.4 | 55.6 | 45.3 | 57.4 |
| 用 Gen6D refiner 替换 3DGS refiner | 79.2 | 67.4 | 52.1 | 66.2 |
这个表比“每个模块都有提升”的口号更有信息:初始化替换造成的跌幅最大,说明 render-and-compare 并不能从任意粗 pose 开始工作;vanilla 3DGS 的下降说明 object-level reconstruction 不是可随意替换的前端;去掉 appearance / depth consistency 的细节则需要配合补充材料进一步核对,不能从主表直接夸大。
11.3 工程规格
- 每个物体选择 8 张 RGB-D reference views,并按 viewpoint coverage 排序;每个真实视图做两次小 pose jitter,旋转约 1–3°、平移约为物体尺度的 0.5%–1.5%。
- 3DGS 训练约 10k iterations;adaptive densification 在前 6k steps 中每 500 steps 增殖、每 100 steps pruning,并逐渐降低 densification probability。
- 实验硬件包含 RTX 3090 Ti;平均 object reconstruction 约 2.21 分钟。这是 onboarding 成本,不应误写成每帧 tracking 的延迟。
- 对没有深度的 query,论文讨论以 ZoeDepth 等方式获得深度;这会把 depth estimator 的误差传给 ICP 和 normalized-depth rendering。
11.4 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| sparse-view object-level 3DGS 让未知物体 pose 更稳 | 有 LINEMOD / GenMOP 与 view-count 曲线支撑,但需要将 reconstruction quality、ICP 初值和最终 pose 分开报告。 |
| 深度先验抑制 floaters | 消融中 vanilla 3DGS 的 ARmean 从 71.4 降到 63.8,支持这一说法;但还应按低纹理、反光和深度孔洞分组。 |
| 可微渲染 refiner 优于通用 refiner | Gen6D refiner 替换后的 ARmean 为 66.2,支持专用 refiner;但 refinement 仍依赖较好的 initialization。 |
12. 复现与失败分析
优先记录:参考视图数量、view coverage、depth scale、Gaussian 数量、ICP 初值 residual、render loss 曲线和最终 pose error。最典型的失败是参考视图没有覆盖关键背面、深度估计把背景融入物体、透明 / 反光表面产生错误 Gaussians,以及相似外观导致 ICP 落入错误局部最优。对机器人 onboarding,值得加入“重建质量低于阈值就主动补拍”的闭环,而不是盲目增加训练迭代。
