论文精读笔记:RKHSPose
1. 核心判断
RKHSPose 的价值不只是“用 MMD 做域适配”,而是把域适配嵌入可解释的关键点几何链路:
RGB-D → radial maps → 2D keypoints → ePnP → S E ( 3 ) . \text{RGB-D}\rightarrow\text{radial maps}\rightarrow
\text{2D keypoints}\rightarrow\text{ePnP}\rightarrow SE(3). RGB-D → radial maps → 2D keypoints → ePnP → S E ( 3 ) . 真实图像不提供 pose GT。模型先用自身关键点生成 pseudo-pose,再把 CAD 以该 pose 渲染到真实背景;这种 synthetic-over-real 样本与对应真实图像具有近似的场景布局和背景,Adapter 随后在输入及多个中间层对齐两者。主实验表明,320 幅无标签真实图像让纯合成 + ICP 的 LM-O 55.7 提升到 68.7,接近真实 GT 训练的 71.3。
但它并不是无需目标域数据的 zero-shot 方法,也不是未见对象方法。每个评测域都需要 CAD、PBR 合成训练,以及一小批该域真实 RGB-D。
2. 监督边界与训练数据流
训练使用:
已知对象 CAD 与每个对象四个 KeyGNet model keypoints;
BOP PBR synthetic RGB-D、object labels 与 pose GT;
320 幅目标域真实 RGB-D,但不读取其 pose GT;
网络在真实图像上的 pseudo-keypoints / pseudo-poses;
synthetic-over-real renderer 与 camera intrinsics。
训练不使用:
这 320 幅真实图像的 6DoF pose labels;
外部 ROI / detection mask;
真实图像上的人工 keypoint labels。
论文对 LM、LM-O、YCB-V、T-LESS 与 TUD-L 使用训练集真实图像;ITODD 和 HB 没有真实训练图像,因此取 validation real images,并保持 test disjoint。IC-BIN 既无可用 real train 也无 validation,因而未纳入该自监督适配协议。这个细节很重要:方法依赖“目标域可访问的无标签真实样本”,适用性不等同于只拿到测试图和 CAD。
3. Radial regression 与 CNN voting
主网络 M r v M_{rv} M r v M r M_r M r M v M_v M v W × H × 4 W\times H\times4 W × H × 4 M r M_r M r V r V_r V r
Radial representation 的好处是:
大量可见表面点都能对同一关键点提供约束;
关键点可位于对象内部或不可见位置;
depth 让投票量带有实际 3D 几何意义;
相比直接回归少数 2D points,遮挡下有冗余。
作者没有沿用 RCVPose 的解析 radial voting,而用 CNN M v M_v M v V r V_r V r K K K C C C S S S
L = λ r L r + λ k L k + λ c L c + λ s L s + λ A L A . \mathcal L=
\lambda_r\mathcal L_r+
\lambda_k\mathcal L_k+
\lambda_c\mathcal L_c+
\lambda_s\mathcal L_s+
\lambda_A\mathcal L_A . L = λ r L r + λ k L k + λ c L c + λ s L s + λ A L A . 回归项使用 smooth-L1,分类用 cross entropy。每个数据集共用一组四个 KeyGNet keypoints,但类别仍是数据集内已知对象,因此不能迁移到任意新 CAD 而不重新训练。
4. 伪姿态、再渲染与 RKHS Adapter
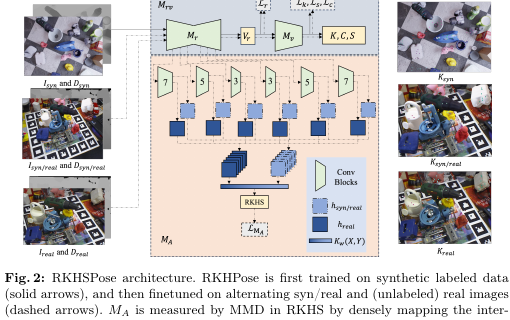
原论文 Figure 2。实线是带标签合成预训练;虚线是 synthetic-over-real / 无标签真实图像的交替适配。Adapter 不只比较最后一层,而是对输入和回归网络多层 feature pairs 做稠密映射。来源:ECVA 正式论文 ;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
第二阶段的数据生成顺序是:
synthetic-pretrained M r v M_{rv} M r v
ePnP 得到 pseudo-pose;
rotation 在约 ± π / 18 \pm\pi/18 ± π /18 ± 0.1 \pm0.1 ± 0.1
CAD 以扰动 pose 渲染并叠加到对应真实背景,形成 I syn/real , D syn/real I_{\text{syn/real}},D_{\text{syn/real}} I syn/real , D syn/real
与 I real , D real I_{\text{real}},D_{\text{real}} I real , D real
Adapter M A M_A M A h syn/real , h real h_{\text{syn/real}},h_{\text{real}} h syn/real , h real
MMD 2 ( X , Y ) = ∥ E x ∼ X ϕ ( x ) − E y ∼ Y ϕ ( y ) ∥ H 2 . \operatorname{MMD}^2(X,Y)=
\left\|
\mathbb E_{x\sim X}\phi(x)-\mathbb E_{y\sim Y}\phi(y)
\right\|_{\mathcal H}^{2}. MMD 2 ( X , Y ) = ∥ E x ∼ X ϕ ( x ) − E y ∼ Y ϕ ( y ) ∥ H 2 . 作者使用带 trainable weights 的 linear product kernel;这让映射与比较尺度能随 pose task 学习。需要注意,MMD 约束的是样本分布的均值嵌入,不直接验证每个 real pixel 的 keypoint identity。若初始 pseudo-pose 错得太多,渲染对象与真实对象并不共位,分布对齐仍可能把错误结构吸收到网络。
5. 两阶段、交替式优化
前 120 epochs:只在带标签 synthetic PBR 上训练主网络。
后 80 epochs:real 与 synthetic epochs 交替;Adapter 在 real epoch 解冻并加入 MMD。
论文描述前 80 epochs 更强调 classification / visibility,随后交换尺度以强化 keypoint localization;120 epoch 后加入域适配。
相比先完整训练 synthetic 再连续 fine-tune real 的 sequential 策略,alternating 能反复注入几何真值,减轻伪标签漂移。
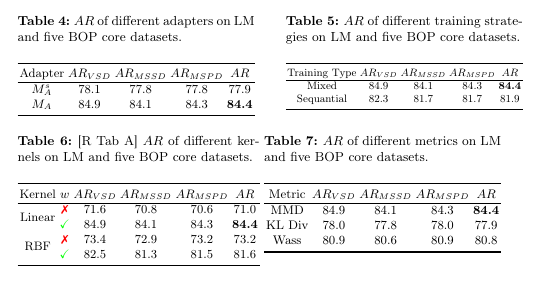
消融验证 mixed / alternating 的平均 AR 为 84.4,sequential 为 81.9。这个 +2.5 说明训练调度是方法的一部分,不只是实现细节。
6. 主结果:应区分三种监督层级
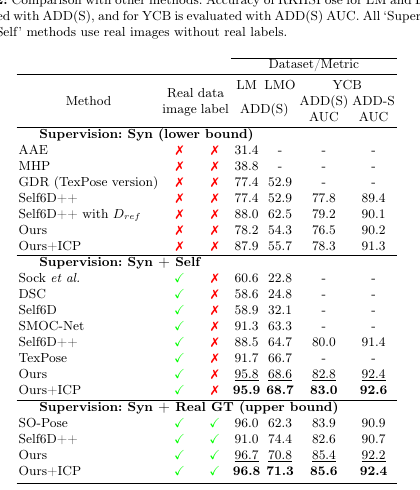
原论文 Table 2。LM / LM-O 使用 ADD(S),YCB 使用 ADD(S) AUC 与 ADD-S AUC。三组结果不可跨列直接平均;“Syn + Self”使用真实图像但没有真实 pose labels。来源:ECVA 正式论文 ;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
训练方式 LM ADD(S) LM-O ADD(S) YCB ADD(S) AUC YCB ADD-S AUC Ours,synthetic only 78.2 54.3 76.5 90.2 Ours + ICP,synthetic only 87.9 55.7 78.3 91.3 Ours,320 real unlabeled 95.8 68.6 82.8 92.4 Ours + ICP,320 real unlabeled 95.9 68.7 83.0 92.6 Ours + ICP,real pose GT 96.8 71.3 85.6 92.4
关键观察:
LM:无标签适配比 synthetic + ICP 高 8.0;已接近 full-GT 的 96.8。
LM-O:55.7→68.7,遮挡场景中适配贡献更明显,但距 full-GT 仍有 2.6。
YCB:ADD(S) AUC 78.3→83.0,仍低于 full-GT 85.6。
self-supervised 的 ADD-S AUC 92.6 比表中 full-GT 92.4 高 0.2,只是单项小波动,不能解释为无标签监督普遍优于真值监督。
self-supervised 后 ICP 只带来 0.1–0.2,说明主模型已经较对齐;而 synthetic-only 的 LM 由 ICP 提升 9.7,反映粗 pose 误差结构不同。
7. BOP 多数据集结果与协议
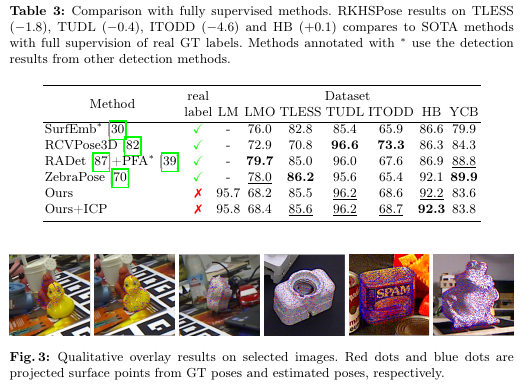
原论文 Table 3 与 Figure 3:表中将 RKHSPose 与 full-real-GT 方法比较;下方红点 / 蓝点分别是 GT / estimated pose 投影后的模型表面点。带星号的方法采用其他 detection 结果,协议并非完全同构。来源:ECVA 正式论文 ;图表版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
RKHSPose + ICP 在论文 Table 3 的结果为:
LM LM-O T-LESS TUD-L ITODD HB YCB-V 95.8 68.4 85.6 96.2 68.7 92.3 83.8
作者概括为相对每列强 fully supervised 方法相差 −11.3 到 +0.2。最接近甚至略高的是 HB,差距最大的是 LM-O。解读时有三项约束:
Table 2 的 LM / LM-O 是 ADD(S),YCB 是 AUC;Table 3 对 BOP 数据使用 BOP 风格结果,不能直接比较同名列的小数。
部分 baseline 使用外部 detector 结果,表中用星号标注;“不用 ROI”是 RKHSPose 的系统优势,但也改变了误差来源。
ITODD / HB 适配使用 validation real images,而不是 train images;虽与 test disjoint,仍要在复现实验中保留相同 split。
8. 消融:什么真正有效
原论文 Table 4–7。AR 是 LM 与五个 BOP core datasets 的平均;稠密 Adapter、交替训练、可学习 linear kernel 和 MMD 组成最终配置。来源:ECVA 正式论文 ;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
变量 对照 平均 AR 最终配置 平均 AR Adapter 密度 sparse single map 77.9 dense multi-map 84.4 调度 sequential 81.9 mixed / alternating 84.4 kernel fixed linear 71.0 trainable linear 84.4 kernel fixed RBF 73.2 trainable RBF 81.6 distance KL 77.9 MMD 84.4 distance Wasserstein 80.8 MMD 84.4
最强消融是 fixed→trainable linear 的 +13.4,以及 sparse→dense 的 +6.5。这支持“task-adaptive、multi-level distribution alignment”而不只是加入任意域损失。
真实图像数量实验从 0 到 640。除 YCB 外,各数据集约 160 images 后饱和;YCB 在 320 后也近似饱和。论文因此选 320,但没有报告不同 320-image subsets 的均值 / 方差,数据选择敏感性仍未知。
9. 速度与系统边界
在 Intel i7 2.5 GHz + RTX 3090 24GB 上,论文报告:
data loading:8.7 ms;
M r v M_{rv} M r v ePnP:16.2 ms;
合计约 29.4 ms,即约 34 FPS。
这组分项没有列出 ICP,因此“RKHSPose + ICP 的精度”不能同时直接配上 34 FPS。ePnP 反而是主网络的 3.6 倍延迟,也说明其效率瓶颈位于关键点实例组织和几何求解,而不是 FCN 本身。
10. 局限与潜在失败模式
已知实例闭集 :每个对象参与 synthetic training,不能处理新 CAD / 新类别。RGB-D 依赖 :depth 空洞、透明 / 反光物体会污染 radial quantity。目标域依赖 :每个新相机、光照或水下域仍需要一批真实无标签图像并重新适配。伪标签确认偏差 :错误 pseudo-keypoints 产生错误 pose,再生成错误 synthetic-over-real 对。边缘分布对齐 :MMD 不显式保证按对象类别、关键点或遮挡状态的条件分布对齐。关键点与类别先验 :一组四关键点由 KeyGNet 预选,模型类别集合固定。指标混杂 :ADD(S)、ADD-S AUC 和 BOP AR 必须分别报告。数据 split 特例 :ITODD / HB 使用 validation images;IC-BIN 无法适配。无专用开源实现 :作者公开可检索的 RCVPose 仓库对应 ECCV 2022 前作,尚不能据此宣称 RKHSPose Adapter 已开源。
11. 复现检查表
为每个 BOP dataset 固定 PBR synthetic 版本、320 real image IDs 与 test-disjoint split;
固定每数据集共用的四个 KeyGNet keypoints;
复现 FCN-ResNet-18 radial maps、CNN voting 与 keypoint grouping;
先做 120 synthetic epochs,再做 80 alternating epochs;
记录 pseudo-pose perturbation、renderer、overlay 与 depth compositing;
Adapter 覆盖输入和所有论文指定 intermediate maps;
trainable linear kernel + MMD,保留 fixed / RBF / KL / Wasserstein 对照;
分别报告不带 / 带 ICP 的精度和速度;
同时报告多个 320-image subsets,检查选择方差;
防止 validation adaptation images 与 test scenes / videos 重叠。
12. 最终评价
RKHSPose 是一篇边界清楚、证据链较完整的 sim-to-real 论文:以少量无标签真实 RGB-D 将 LM-O 从 55.7 提到 68.7,同时用 dense / sparse、mixed / sequential、kernel、distance 和 sample-count 消融定位增益来源。它也保留了 keypoints 与 ePnP 的几何可解释性。
最容易被误读的是“self-supervised”与“接近 fully supervised”。它仍需要已知 CAD、带 GT 的 synthetic PBR、目标域真实图像和逐域 fine-tuning;在 YCB ADD(S) AUC、LM-O 等项仍低于真实 GT 上界。更准确的定位是:针对闭集实例级 RGB-D pose,用 320 幅无 pose 标签的目标域图像换取大部分真实监督收益 。