论文精读笔记:CoordAR: One-Reference 6D Pose Estimation of Novel Objects via Autoregressive Coordinate Map Generation
1. 基本信息
2. 一句话定位
论文把 one-reference pose estimation 转化为“条件生成 query ROC map”的问题:先用离散 tokenizer 把连续 3D 坐标场压缩成 token,再通过 modality-decoupled Transformer 自回归预测 token,最后用几何求解器恢复相对姿态。
2.1 论文图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 1 | 输入 reference/query、ROC map、token prediction 与最终 pose 的整体示意 | 理解论文为何把 pose recovery 拆成 coordinate-map generation + Umeyama |
| Figure 2 | CoordAR 的完整网络 pipeline | 观察 RGB / ROC 两种模态如何分别编码,再在 fusion blocks 中交互 |
| Table 1–3 | Real275、Toyota-Light、YCB-V、LINEMOD 主结果 | 注意 one-reference、multi-view、CAD-assisted 方法之间的输入差异 |
| Table 4–5 | 结构消融和速度分析 | 观察 autoregressive decoding 对精度和速度的实际影响 |
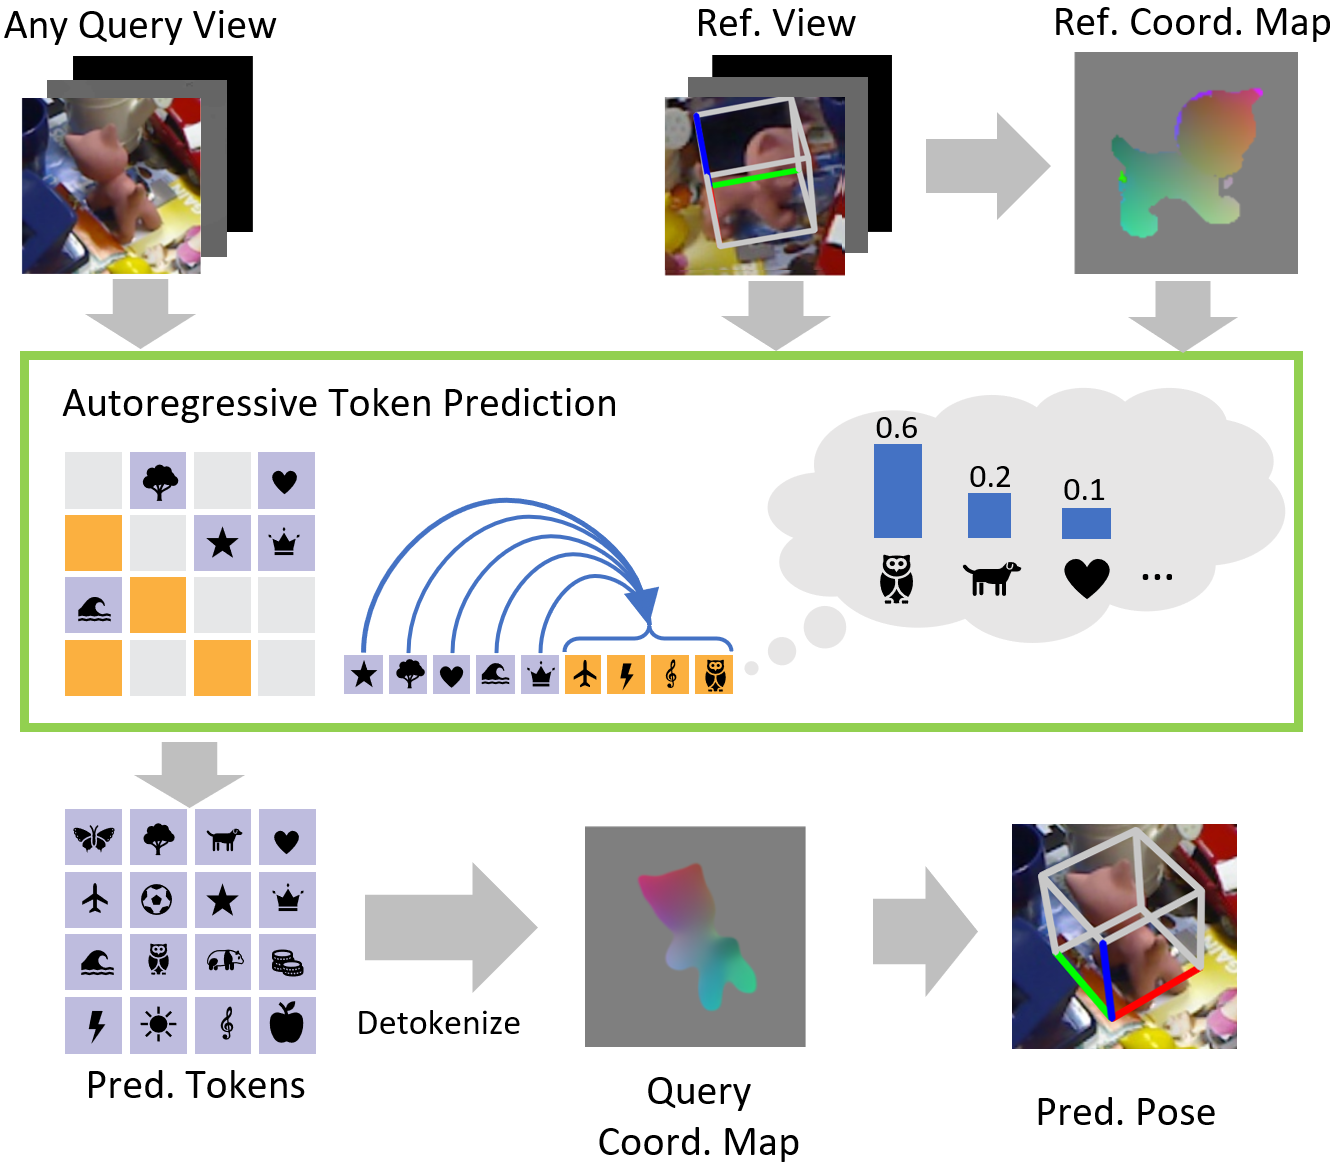 原论文 Figure 1:从 reference/query 观测、ROC map 预测到最终姿态恢复的整体流程。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 估计对象:训练外的刚性物体实例,重点是 novel object,而非类别级跨实例 canonical pose。
- reference 输入:IR=(CR,DR),含 RGB、depth 和 object mask;reference 的绝对物体 pose TRO 已知。
- query 输入:IQ=(CQ,DQ),来自未知视角,同样需要 query mask。
- 目标:估计 query 到 reference 的相对变换 TRQ,再计算 TQO=T^RQ−1TRO。
- 是否需要 CAD:不需要完整 CAD model;需要 reference depth 生成 ROC map。
- 是否需要多视角:推理阶段只需一张 reference,不需要通过多张有姿态图像先重建 3D 模型。
- 是否需要 mask / intrinsics:需要 mask 和 camera intrinsics;论文实验使用的输入设定相对理想,mask 质量是实际部署的重要变量。
- 输出表示:网络输出 query ROC map,不直接输出 quaternion、axis-angle 或 translation。
4. 研究脉络
- 传统 instance-level 方法通常依赖 object-specific training 或已知 CAD;category-level 方法改善了类别内泛化,但不等于任意新类别。
- model-free 路线有两类:一类利用多张有姿态 views 重建物体,再做 render-and-compare;另一类直接从少量 reference 建立 correspondence。
- CoordAR 直接针对 One2Any 的连续 ROC regression 进行改造。它保留 reference object coordinate 的思想,但把 coordinate map 的预测改成离散 token 的自回归生成。
- 与普通 diffusion / image generation 的区别在于:这里的 token sequence 不是生成外观,而是生成用于几何对齐的结构化 3D 坐标。
5. 研究动机
作者试图解决的问题
- 卷积 decoder 的局部感受野可能无法建立跨 patch 的全局空间一致性。
- 连续坐标回归对对称、遮挡和未定义 canonical frame 等歧义缺少显式概率表达。
- 将 RGB 外观和 ROC 坐标直接拼接会混合两个统计性质不同的模态。
我的分析
论文的关键判断是:pose 误差不一定来自最终 Umeyama / PnP 求解器,而可能在 correspondence map 生成阶段已经形成。于是它不改变最后的几何求解器,而是把学习问题改造成更容易表达全局依赖的 conditional autoregressive modeling。
6. 方法详解
6.1 总体 Pipeline
- 利用 reference depth 和 mask 反投影,经过中心化与尺度归一化得到 reference ROC map XR。
- 用相对变换把 query depth 对齐到 reference object frame,得到真实 query ROC map XQ,仅用于训练监督。
- 由共享 RGB encoder 编码 CR,CQ,另一个 encoder 编码 XR。
- 通过多个 fusion blocks 将 reference 条件注入 query pixel-aligned features。
- 使用 VQ-VAE codebook 把 ROC map 压缩为 patch-level token sequence,decoder 按自回归方式预测 query token。
- detokenize 得到 X^Q,再用 query depth 和 normalization inverse 得到 reference-frame 3D points。
- 使用 Umeyama 求解 T^RQ,并组合 reference absolute pose 得到 query absolute pose。
6.2 关键模块
| 模块 | 输入 | 输出 | 作用 | 与下一模块如何衔接 |
|---|
| ROC map construction | depth、mask、intrinsics | normalized 3D coordinate map | 将 depth 变成可比较的 object-frame geometry | reference ROC 送入独立 encoder |
| Modality-decoupled encoding | RGB、reference ROC | RGB / geometry features | 避免 RGB 与 3D 坐标共享同一编码假设 | 同模态特征进入 fusion blocks |
| Fusion blocks | reference features、query features | condition feature | 通过 self-attention + cross-attention 注入 reference 条件 | 作为 token decoder 的 pixel-aligned condition |
| VQ-VAE tokenizer | continuous ROC map | discrete token sequence | 把连续坐标空间压缩为有限 codebook | decoder 预测 token 分布 |
| Autoregressive decoder | query feature、已生成 token | next token probabilities | 建模 token 间长程依赖和不确定性 | detokenize 得到 query ROC |
| Umeyama solver | predicted / observed 3D correspondences | SE(3) transform | 以最小二乘方式恢复刚体变换 | 与 reference pose 组合 |
6.3 训练方式与监督信号
- 需要训练。ROC tokenizer 先把连续坐标图压到离散 codebook;主模型学习条件 token distribution。
- 自回归 decoder 的目标是:
LAR=−k∑logp(Sk∣S<k,CF).
- 训练阶段可用 query depth 构造 ground-truth ROC map;推理时用模型生成的 ROC map 与 query depth 完成恢复。
- 训练数据包含 FoundationPose 数据集和 OO3D-9D 子集;测试覆盖 Real275、Toyota-Light、LINEMOD 与 YCB-V。
- 训练目标与最终指标并不完全相同:token NLL 只约束 coordinate map 的离散生成,最终 ADD(-S) 还受到 mask、depth、归一化和 Umeyama 稳定性的影响。
6.4 推理与工程复杂度
- 主要推理成本是 autoregressive token decoding;论文在 64、16、4、1 steps 之间进行了速度/精度对比。
- 16 steps 达到 75.0 ADD(-S),约 0.25 s;4 steps 约 0.13 s,1 step 约 0.10 s,但性能有小幅下降。
- 论文表格中的参数量约为 0.37B(不含 tokenizer)的 decoder 设定,模型和 tokenizer 的显存、预处理成本需要单独评估。
- 复现难点:VQ-VAE codebook 的训练细节、mask / depth 预处理、不同数据集的 reference protocol,以及对称物体的评价协议。
7. 实验分析
7.1 数据集与输入设定
- Real275:42 个真实物体、6 个类别,评估 novel objects。
- Toyota-Light:21 个刚性家居物体、5 种光照条件。
- YCB-Video:包含遮挡场景,论文关注 reference/query 同时有遮挡时的 ADD / ADD-S AUC。
- LINEMOD:包含 texture-less 物体,测试大视角变化。
- 评测采用第一帧作为 reference 或随机采样 2K reference-query pairs;对比方法的输入 modality 和 reference 数量并不完全一致,阅读表格时需要特别注意。
7.2 主要结果
| 场景 | CoordAR 结果 | 论文含义 |
|---|
| Real275 | AR 71.0,ADD(-S) 82.2 | 超过 One2Any 的 AR 54.9、ADD(-S) 41.0 |
| Toyota-Light | AR 62.5,ADD(-S) 82.6 | 在不同光照下仍保持较强泛化 |
| Occluded YCB-V | ADD AUC 78.5,ADD-S AUC 95.5 | 对几何对称物体的 symmetry-aware 评价更有优势 |
| LINEMOD | ADD(-S) recall 75.0 | 在一张 reference 和大视角变化下仍有较强表现 |
作者声称的 SOTA 基本被表格支持,但多视角方法和 CAD-assisted FoundationPose 的输入资源更多,不能把所有数字视作严格同设定比较。
7.3 消融实验
| 消融项 | 论文结果 | 我的判断 |
|---|
| convolutional vs. autoregressive ROC decoder | full autoregressive ADD(-S) 73.6,卷积 decoder 70.9 | 支持全局 token dependency 有帮助 |
| 去掉训练和测试阶段 autoregression | ADD(-S) 降至 60.7 / 68.0 等设置 | 说明逐步生成与空间 coherence 相关 |
| 去掉 tokenization、直接回归 real-valued ROC | ADD(-S) 降至 60.7 | 支持离散化对歧义建模有帮助 |
| role-specific vs. modality-decoupled encoding | 61.6 vs. 73.6 ADD(-S) | 支持 RGB 与 ROC 分离编码 |
| test-time steps | 64 steps 与 16 steps 精度相同,4 / 1 steps 略降 | 说明存在可用的速度调节旋钮 |
7.4 鲁棒性与失败案例
- 遮挡:对 reference/query 同时存在遮挡的 YCB-V 场景有较好 ADD-S 表现。
- 对称:ADD 和 ADD-S 对 texture-defined symmetry 的敏感性不同,论文提醒了评价指标造成的差异。
- 大视角:LINEMOD 实验显示对 top / side / back view 有较好的恢复能力。
- 依赖风险:论文没有系统展示大面积 mask 错误、深度空洞、反光/透明物体和极端低照度下的结果,这些是工程部署的主要未知点。
8. 批判性分析
优点
- 任务重定义清晰:把 correspondence 的生成质量作为主要瓶颈,而不是继续堆叠末端 refinement。
- 离散 token 让多解和局部歧义有了概率表达,且可通过 steps 控制速度。
- ROC map 与 Umeyama 的组合保留了几何可解释性,比直接回归 pose 参数更容易分析错误来源。
缺点与隐含假设
- 需要 reference depth 和精确 mask,one-reference 的“少先验”并不等于“无传感器依赖”。
- reference pose 已知,实际系统要先完成 reference acquisition 和标定。
- 自回归生成可能受 token order、codebook 质量和错误累积影响;论文的 token 数量、codebook 训练细节对复现很关键。
- 评测中部分 baseline 使用 CAD 或更多 reference,若用于论文比较,需要明确区分 model-free、one-reference 和 multi-view 三类 setting。
真实应用可行性
可以作为 RGB-D 机器人 perception 的候选模块,但还需要:不依赖 GT mask 的前端、深度缺失处理、低延迟 decoder、对透明/反光物体的 stress test,以及基于真实采集 reference 的长期 tracking 实验。
9. 未来工作与可改进方向
- 将 ROC map 生成扩展到 RGB-only 或 monocular depth uncertainty。
- 用 confidence-aware token decoding 处理遮挡和可见区域不足。
- 将 autoregressive map 与 3DGS / neural rendering refinement 结合,形成粗到细的 pose pipeline。
- 研究 codebook 是否可以跨类别、跨传感器和跨数据集迁移。
- 增加 object symmetry group 或 uncertainty-aware pose metric,减少 ADD / ADD-S 对纹理定义不一致造成的误读。
10. 对我的研究的启发
- 可直接借鉴:
dense correspondence → structured token → geometric solver 的三段式设计。
- 必须加入 baseline:One2Any、FoundationPose、Any6D,并严格对齐 reference 数量、CAD 使用、depth 和 mask 来源。
- 可形成的研究切入点:将本站关注的 unseen-object / category-level pose 与 tokenized 3D representation 结合,研究在 noisy depth 和 imperfect mask 下的 uncertainty calibration。
11. 待解决问题
- VQ-VAE tokenizer 是在什么数据分布上训练的,换到低纹理或新类别后是否会产生 codebook collapse?
- 训练时使用的 mask / depth 是否接近测试时真实输入,还是存在较强的 oracle 条件?
- 16-step decoder 的延迟在机器人控制频率下是否可接受?
- 对称物体中,预测的 ROC map 是否真的唯一,还是仅在 ADD-S 意义下等价?
