返回研究文献库

物体位姿估计 · 2024 · ECCV · CCF B

PACE: A Large-Scale Dataset with Pose Annotations in Cluttered Environments

PACE 提供 300 段真实杂乱视频、55K 帧和 258K pose 标注,覆盖 238 个对象、43 类及刚体 / 关节物体,另有 100K 帧 PACE-Sim。PPF 在已知实例上达 52.2 BOP AR,而学习方法仅 4.4–9.0;受控实验进一步区分了 sim-to-real 与全对象规模化造成的两类性能断崖。

研究方向

物体位姿估计

任务层级

Instance / Category

物体设定

Seen / Unseen

输入模态

real RGB-D videosynthetic PBR RGB-Dscanned object CAD modelspart-level articulated annotations

关键依赖

calibrated three-camera capture system for annotationobject scans and canonical alignmentsynthetic training dataGT detections for reported pose baselinesGT first pose for trackingGT masks / sizes for several tracking baselines
完整论文元数据 作者、单位、研究方向、数据集、指标、方法标签和阅读状态 展开
作者
Yang You, Kai Xiong, Zhening Yang, Zhengxiang Huang, Junwei Zhou, Ruoxi Shi, Zhou Fang, Adam W. Harley, Leonidas Guibas, Cewu Lu
作者单位
Stanford University / Shanghai Jiao Tong University / Horizon Robotics / UC San Diego
会议 / 期刊
会议 · ECCV · CCF B
研究方向
物体位姿估计
开源状态
已开源
阅读状态
粗读:已生成 精读:已生成
任务设定
Instance / Category · Seen / Unseen
评估指标
BOP AR VSD MSSD MSPD 3D IoU ADD ADD-S Rotation Error Translation Error ADD / ADD-S AUC

论文原始写法:BOP Average Recall / VSD / MSSD / MSPD / 3D IoU AP / angle-threshold AP / translation-threshold AP / ADD AUC / ADD-S AUC / 5°5cm tracking accuracy

关键依赖
calibrated three-camera capture system for annotationobject scans and canonical alignmentsynthetic training dataGT detections for reported pose baselinesGT first pose for trackingGT masks / sizes for several tracking baselines

Reading Notes

粗读 / 精读

已生成 src/paper-notes/pace-eccv2024/coarse.md

论文粗读笔记

用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。

论文粗读笔记:PACE

1. 基本信息

  • 标题:PACE: A Large-Scale Dataset with Pose Annotations in Cluttered Environments
  • 作者:Yang You, Kai Xiong, Zhening Yang, Zhengxiang Huang, Junwei Zhou, Ruoxi Shi, Zhou Fang, Adam W. Harley, Leonidas Guibas, Cewu Lu
  • 机构:Stanford University;Shanghai Jiao Tong University;Horizon Robotics;UC San Diego
  • 年份 / 会议:2024 / ECCV
  • 论文:ECVA 正式 PDF · ECCV 页面 · 数据与代码
  • 阅读模式:粗读

2. 一句话定位

PACE 用 3 台标定 RealSense D415 采集 300 段真实杂乱视频,提供 55K 帧、258K pose 标注、238 个对象和 43 类,并同时覆盖 instance / category-level estimation、model-based / model-free tracking 与刚体 / 关节物体;它的核心结果不是某个新 SOTA,而是显示 BOP / NOCS 上的高分方法在真实大规模杂乱场景中会剧烈失效。

3. 图表导读

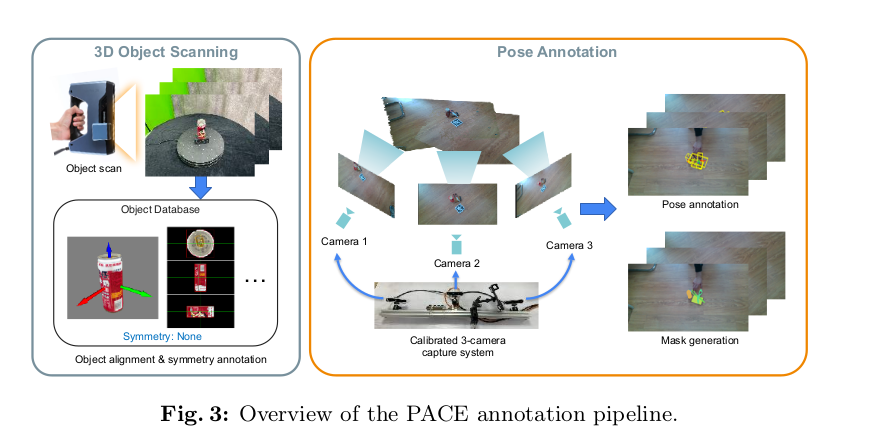
PACE 三维扫描、三相机采集和位姿标注流程
原论文 Figure 3:先扫描对象、统一 canonical frame 并标注 symmetry,再通过标定的三相机系统获得多视角 RGB-D,完成 pose 与 occlusion-aware mask 标注。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
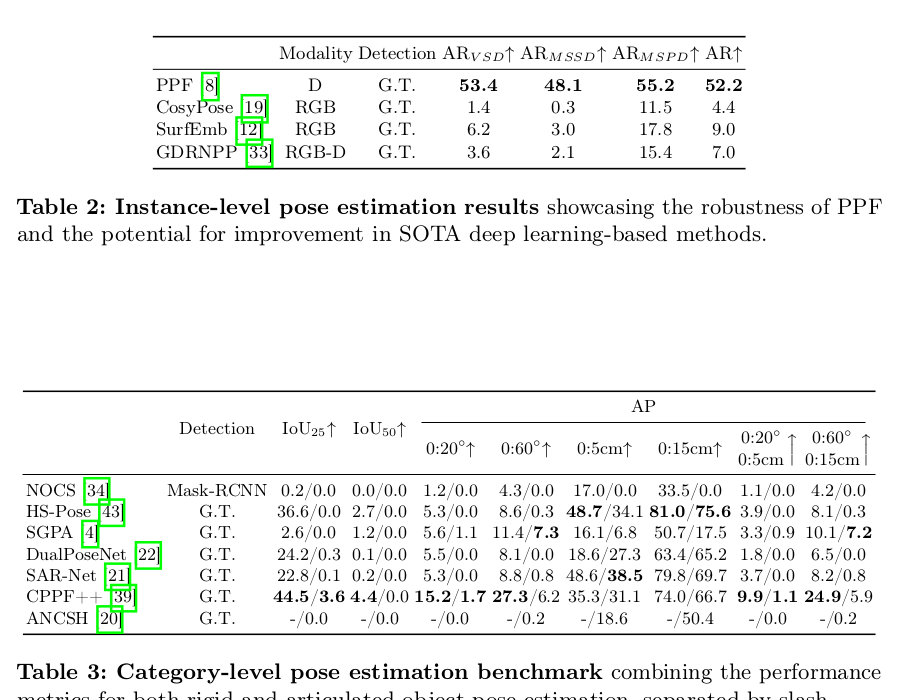
PACE 实例级和类别级位姿估计基线结果
原论文 Table 2–3:instance-level 中传统 RGB-D PPF 达 52.2 BOP AR,远高于 CosyPose / SurfEmb / GDRNPP 的 4.4 / 9.0 / 7.0;category-level 中斜杠前后分别是刚体 / 关节物体,严格 pose 指标普遍很低。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。

4. 数据集组成

  • PACE-Real:300 段视频、55K 帧、258K annotations、238 个 objects、43 categories。
  • 环境:10 个背景 / 光照环境,每条序列 1–7 个对象,距离 0.5–1.5 m,1280×720 RGB-D。
  • 对象类型:普通刚体,以及 scissors、cutters、clips、boxes 等多部件关节物体;提供 CAD、部件层级、canonical alignment 与 rotational symmetry。
  • 动态与遮挡:同时包含静止、移动、堆叠、手部交互和不同 visible ratio。
  • PACE-Sim:100K photorealistic PBR frames、2.4M annotations、931 个对象,分别提供 instance-level 与 category-level synthetic training subsets。
  • 默认切分:真实数据 20% validation / 80% test;category-level 另有 synthetic validation。论文的失效分析另用 80/10/10 real split,不能与默认 leaderboard 混淆。

5. 标注流程

  1. 用 Einscan Pro 2X 扫描对象,单对象约 5–10 分钟;统一包围盒中心 / 方向并标 symmetry。
  2. 三台 RealSense D415 固定在框架上;SuperPoint + SuperGlue、trifocal tensor 与 bundle adjustment 求旋转,ArUco translation 补上 SfM 的 metric scale。
  3. 静态对象借助背景 marker PnP / tracking,并每 40 帧人工纠漂;最终把 marker 区域 inpaint 掉。
  4. 移动物体用 BundleTrack 初始化,每 10 帧检查 3D point-cloud alignment 与三视角 2D agreement,并人工修正。
  5. 渲染 CAD depth 得 occlusion-aware masks;手遮挡时用 SAM hand mask 做扣除。
  6. 在 NOCS-REAL275 Scene 1 上复标核验,平均误差为 0.9° / 2.3 mm。

6. 实验速览

  • Instance-level 统一使用 GT detections:PPF 52.2 AR,SurfEmb 9.0,GDRNPP 7.0,CosyPose 4.4。
  • Category-level 刚体中 CPPF++ 的 IoU25 / joint 0:60°–0:15cm AP 为 44.5 / 24.9;关节物体分别仅 3.6 / 5.9。
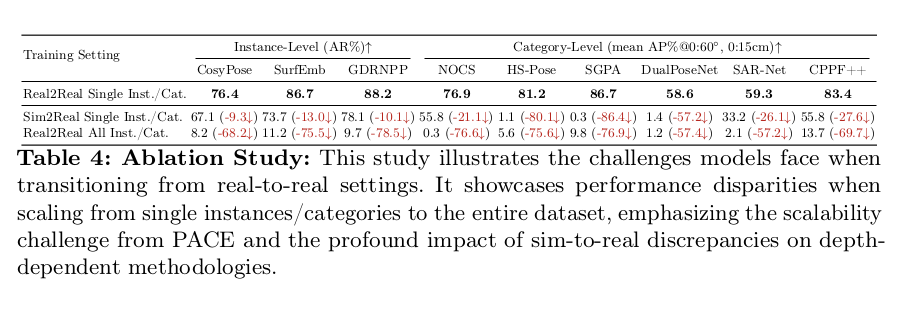
  • Real2Real 单对象 / 单类别 fitting 可达 58.6–88.2,但换成 Sim2Real 单对象 / 类别后下降 9.3–86.4 points;扩展到 Real2Real 全对象 / 类别又下降 57.2–78.5 points。
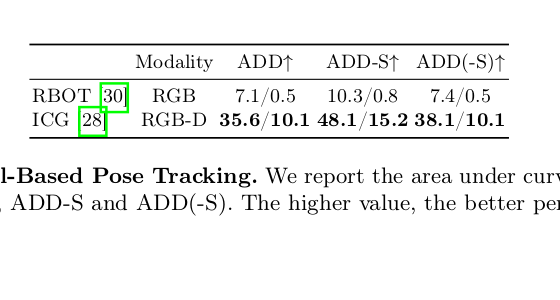
  • Model-based tracking 中 ICG 的 ADD(-S) AUC 为刚体 38.1、关节 10.1。
  • Model-free tracking 最好的刚体 5°5cm 只有 CAPTRA 的 12.9%;关节最好为 BundleTrack 的 11.2%。

7. 快速判断

  • 价值:同一数据里同时连接 known-instance、unseen-instance category pose、tracking、articulation、clutter 与 movement,适合检查方法从静态 benchmark 到真实视频系统的断层。
  • 最重要发现:失败不只有 sim-to-real;即便 Real2Real,模型从单对象 / 单类扩到全部对象 / 类别也会严重 underfit。
  • 限制:默认 pose benchmark 假设 GT detection,多项 tracking 还使用 GT mask / size / first pose;类别级 articulated baseline 的“每个部件当类别”并不是真正 joint-aware;缺少 table、camera、laptop 等大而贵重对象。
  • 适合读者:real-world clutter、pose tracking、articulated objects、dataset annotation、sim-to-real 与 scalable pose learning。

Related Papers

相关论文