论文精读笔记:ConceptPose: Training-Free Zero-Shot Object Pose Estimation using Concept Vectors
1. 核心判断
2. 一句话定位
语言概念提供“这是什么局部”的语义索引,深度提供 3D 位置,二者结合后即可进行零样本 3D-3D correspondence 和相对 pose 求解。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | concept generation、saliency localization、3D matching 的接口是否闭环? |
| Figure 3 | 对称物体上,概念是否能找到比纹理更稳定的部件? |
| Table 1 | training-free 方法的收益是否在所有数据集都一致? |
| Table 2 | 与 Any6D / One2Any 的比较是否使用相同的 pair 采样? |
| Table 4 | geometric、semantic、topological prompts 哪一类概念最有效? |
| Table 5 | voxelization 对准确率和速度的影响是什么? |
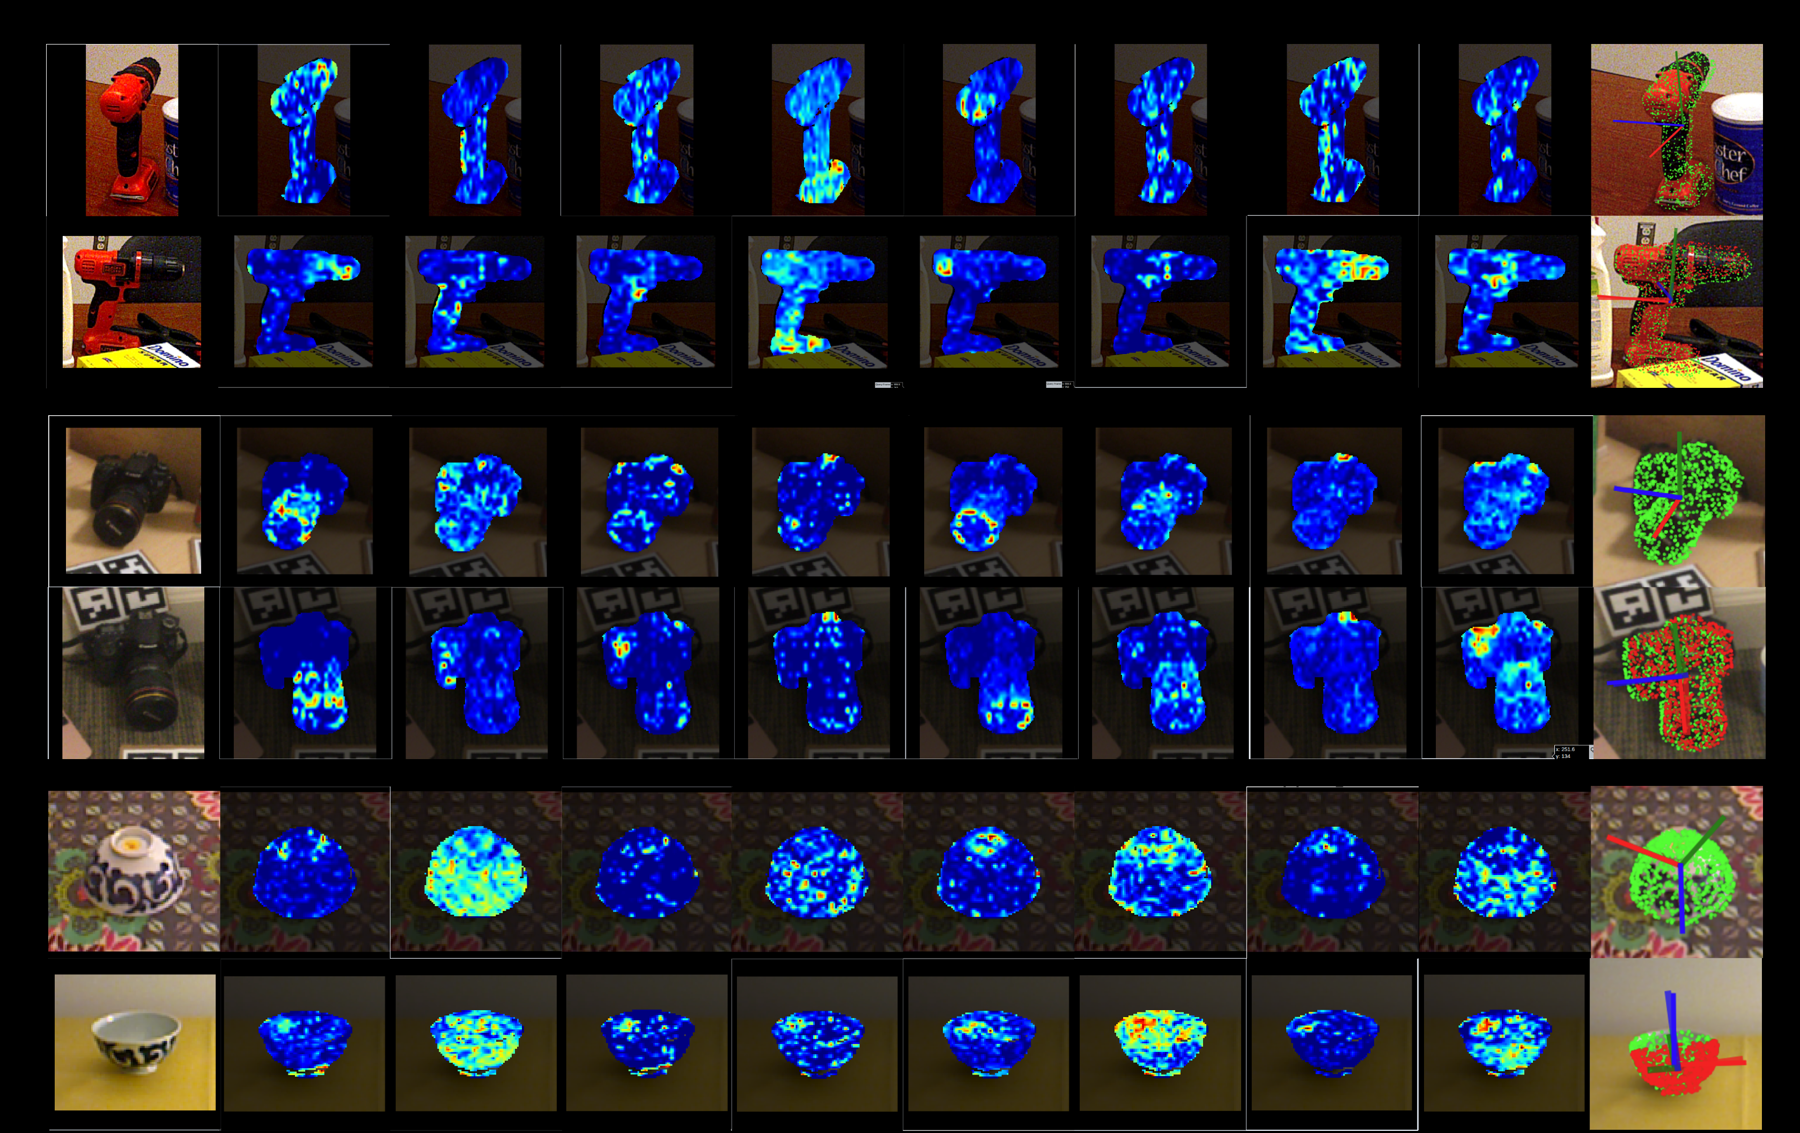 原论文图表中的相关区域:图示从自然语言 concept 到 3D concept map,再到跨视角 correspondence 和姿态恢复。来源:项目页 / CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 给定 anchor/reference 图像 Ia、query 图像 Iq、物体名称或 concept prompt,以及两幅图的深度和 mask。
- 对每个有效像素采样 3D 点,并由 VLM 生成一个 concept vector;点的颜色或纹理不再是唯一匹配线索。
- 估计 reference frame 到 query frame 的 similarity transform;在 benchmark 中通过已知相机关系计算绝对 pose。
- 方法是 training-free,但不是 sensor-free 或 prompt-free:深度、mask 与语义提示仍是系统输入。
4. 研究脉络
- 传统 model-free pose 往往需要 dataset-specific training、CAD 或 reference feature matcher。
- 一些 zero-shot 方法使用 VFM 做直接 feature matching,但对纹理缺失、视角变化和对称目标不够稳定。
- ConceptPose 的观察是:语言可以提供“spout、handle、rim”等跨视角相对稳定的概念描述;只要把概念定位到三维点,就可以将语言 prior 接回几何 solver。
5. 研究动机
- 视觉 embedding 的相似度不一定对应物体部件的语义一致性。
- 开放世界物体通常没有训练集标签,也没有 object-specific CAD。
- VLM 具备开放词汇和部件级描述能力,但需要一个可测量的几何接口。
- 3D concept vector 正好提供“语义可解释 + 几何可求解”的桥梁。
6. 方法详解
6.1 Concept generation
- 先由 LLM 根据 object name 生成一组互补 concept labels。
- 几何 prompt 描述形状、拓扑和空间关系;semantic prompt 描述外观与部件;作者还探索面向不同物体的 prompt 组合。
- 文本 embedding 在多帧之间缓存,减少重复 VLM 计算。
6.2 Concept localization
- VLM 通过对图像和文本 concept 的响应生成 dense saliency map。
- saliency map 与物体 mask、深度相乘,得到每个 3D 点对应的 concept vector。
- 这样同一个空间部件在不同视角中,即使像素外观变化,也可能因为 concept 语义相近而保持匹配。
6.3 3D correspondence 与 Umeyama
- 对 query 点 pqi,在 anchor 点集里寻找 concept vector KL divergence 最小的点 paj。
- 可选 voxelization 降低点数量和相似度计算开销。
- 用 RANSAC 过滤错误 3D-3D pairs,再用 Umeyama closed-form solution 求解旋转与平移。
- 对称物体使用 ADD-S 或对称感知 BOP 指标,以避免把等价旋转视为错误。
7. 实验分析
7.1 数据与指标
- REAL275:2754 个 RGB-D test frames,覆盖 bottle、bowl、camera、can、laptop、mug 等 6 类。
- Toyota-Light:杂乱、遮挡与不同光照下的真实物体。
- YCB-V:21 个日常物体的 cluttered RGB-D 场景;LINEMOD:15 个经典物体。
- 报告 ADD(-S) recall、ADD-AUC、ADD-S-AUC、3D IoU,以及 BOP 的 VSD、MSSD、MSPD 和 AR。
7.2 主结果
- Table 1 在四个数据集上比较 ConceptPose 与 trained / training-free baseline;论文报告相对最强 baseline 的平均 ADD(-S) 提升超过 62%。
- 该提升的意义不只是数值,因为 ConceptPose 没有使用 dataset-specific training、CAD 或推理时 GT pose。
- Figure 3 显示 concept localization 在语义简单、对称性较强的物体上仍能找到具有结构意义的局部,但不是所有概念都稳定。
7.3 消融与效率
- 多种 prompt 组合的消融表明,几何和语义概念互补;只依赖一种描述会在某些类别上退化。
- voxelization 可以在减少点数的同时保持主要精度,是将 VLM 推理接到 3D matching 的工程折中。
- 固定随机 seed 采样 anchor-query pairs 对比较很重要,尤其是 YCB-V 跨 scene 与 LINEMOD 同 scene 的采样方式不同。
8. 批判性分析
- 强项:语义先验可解释,几何 solver 可验证,且无需训练;这是当前 VLM + pose 组合中较清晰的接口设计。
- 依赖:物体名称、prompt、mask、depth 的质量会成为隐性监督;如果 VLM 对小部件不敏感,几何匹配也会失败。
- 计算代价:每个 concept 需要 saliency 生成,多 concept、多帧和多物体时成本可能高于普通 feature matcher。
- 实验边界:标准 benchmark 上的 mask 与采样设置相对受控,开放场景中的检测、分割和概念生成错误还需单独评测。
9. 对我的研究的启发
- 可以将 concept vector 与 NOCS、局部 surface descriptor 或几何 confidence 融合,构造语义—几何联合 correspondence。
- 语言概念也可用于主动观测:系统不确定时,选择能看到 handle、rim 或 connector 的视角。
- 对称物体应输出 pose equivalence class 或 posterior,而不是强迫单个旋转标签。
10. 待解决问题
- 如何自动选择对当前物体最有辨识力的 concepts?
- 如何校准 VLM saliency 的置信度并避免 prompt bias?
- 如何把 training-free 的 3D concept matching 扩展到视频、可动物体和无深度 RGB-only 场景?
11. 精读补充:从语言概念到 3D-3D 对应
11.1 Table 1 的精确结果
| 数据集 | ADD(-S) | BOP AR | 最强对比的 ADD(-S) | 论文报告的提升 |
|---|
| REAL275 | 71.5 | 60.4 | 53.5(Any6D) | +33.6% |
| Toyota-Light | 55.0 | 51.6 | 32.2(Any6D) | +59.0% |
| YCB-Video | 41.2 | 32.8 | 22.6(Horyon) | +82.3% |
| LINEMOD | 38.6 | 31.0 | 27.6(Horyon) | +39.9% |
| 四数据集平均 | 51.6 | 44.0 | — | ADD(-S) 平均 +62.8%,BOP AR 平均 +14.3% |
要注意最后一行的平均不是把所有 baseline 都放进同一训练协议;Any6D / One2Any 没有在 YCB-Video 和 LINEMOD 上完整评测,所以作者另报 REAL275 + Toyota-Light 的公平平均。LINEMOD 上 ConceptPose 的 BOP AR 31.0 低于 Horyon 的 34.4,主要原因是严重遮挡;这比笼统写“所有数据集都 SOTA”更准确。
11.2 Prompt 与 concept vector
- default prompt 让 LLM 生成常见部件名,如 handle / body;geometric prompt 进一步要求拓扑和空间位置;affordance prompt 描述可抓取、可倾倒等功能;adjective prompt 加入短外观修饰词。
- VLM 为每个 concept 产生 dense saliency;深度把二维 saliency 拉回点云,每个 3D 点因此有一个 concept vector。
- forward KL similarity 用于 query / anchor concept distribution 的比较,RANSAC 过滤错误对应,Umeyama 最终解相对 R,t。
- 这种 representation 的优点是可解释:当 pose 错时可以检查是 LLM 概念不对、VLM saliency 不对,还是 3D correspondence / RANSAC 不稳定。
11.3 工程开销与 voxelization
ConceptPose 每个物体需要多个 concept 的 saliency 推理,计算量随 concept 数量和点数增长。作者的 voxelization 消融应从两个方向读:它减少 3D matching 的点数和运行时间,同时可能丢掉小部件;如果大物体性能基本保持,说明 concept vector 的主要信息是结构级而非每个点级。
论文还提供 2000 个 anchor-query pairs / dataset 的采样设置,并公开 YCB-V、LINEMOD 生成的 Oryon-format pairs。复现时必须固定 pair seed、同场景 / 跨场景采样和 BOP target 过滤,否则平均 ADD(-S) 会产生不可忽略的方差。
11.4 作者声称与我的分析
| 作者声称 | 我的分析 |
|---|
| training-free concept vectors 比强 baseline 平均提升 62.8% | 主表支持,且四个数据集都提升 ADD(-S);但它仍使用 RGB-D 与 mask,不能解读成完全无先验。 |
| prompt 设计较鲁棒 | default / geometric / affordance / adjective 的窄幅变化支持鲁棒性,但 concept 数量与 VLM 版本仍可能影响复现。 |
| 语义能帮助跨视角对应 | 可视化显示 heatmap 与 3D axes,但应追加 concept-level precision / recall 和遮挡分组实验。 |
12. 对研究的可迁移接口
可以把 ConceptPose 的 concept vector 与 COG 的 confidence 结合:concept 一致性负责“语义上像不像同一个部件”,OT marginal 负责“这部分是否在两视图都可见”。对对称物体,建议输出 symmetry-equivalent pose set 或 posterior,而不是只让 Umeyama 输出一个旋转;对视频,则可缓存稳定 concept 并只在视角变化大时重新调用 VLM。
